Veo 3.1, le dernier modèle de génération de vidéos de Google DeepMind, a été lancé avec des promesses ambitieuses en matière de sécurité : un filtre de contenu multicouche, un tatouage SynthID et un classifieur à l’inférence qui bloquerait les contenus pour adultes et les contenus nuisibles avant même de générer le rendu. Le déploiement a été prudent, la documentation complète. Puis la communauté des tests de contenu a commencé à lancer des batteries de prompts systématiques, et les résultats ont raconté une histoire plus compliquée.
Cet article documente ce que ces tests ont révélé : les catégories de contenu précises qui ont franchi la couche de sécurité de Veo 3.1, celles qui ont été bloquées de façon fiable, et ce que les données d’incohérence signifient pour quiconque construit un flux de travail créatif autour de contenus générés par IA frôlant le contenu pour adultes. Nous documentons aussi les modèles d’image IA de PicassoIA qui évitent entièrement la loterie des filtres et offrent des résultats prévisibles.
Ce qu’est réellement Veo 3.1
Lancé à la mi-2025, Veo 3.1 est le modèle de synthèse vidéo de troisième génération de Google DeepMind. Il génère des vidéos haute fidélité et cohérentes dans le temps à partir de prompts textuels et d’images de référence, avec une génération audio native qui produit un son synchronisé sans pipeline séparé. L’architecture atteint une cohérence du mouvement, une physique réaliste de l’éclairage et des transitions de scènes complexes à des niveaux de qualité qui ont surpassé les modèles concurrents dans la plupart des évaluations indépendantes.
L’accès se fait par plusieurs canaux : la plateforme VideoFX de Google pour un usage grand public, l’intégration aux outils créateurs de YouTube, et l’API Vertex AI pour les déploiements en entreprise. Chaque canal applique la même politique de contenu, mise en œuvre par une couche de classification qui intercepte les prompts avant l’inférence et évalue les images générées avant leur livraison.
Pourquoi les gens testent les filtres de contenu
Chaque grand modèle d’IA est livré avec un filtre de contenu. Chaque filtre de contenu présente des failles. Ce n’est pas un échec de conception — c’est une réalité d’ingénierie. Les classifieurs entraînés sur des jeux de données étiquetés développent des angles morts là où l’étiquetage était ambigu, où les exemples d’entraînement étaient rares, ou là où la formulation d’un prompt tombe dans des zones grises statistiques que le modèle n’a pas rencontrées pendant son entraînement.
Les personnes qui mènent des tests de contenu systématiques comprennent des chercheurs en red team dans des établissements universitaires, des experts indépendants en sécurité et des créateurs professionnels qui ont besoin de cartes précises des limites pratiques d’un outil. Les données qui en résultent comptent pour plusieurs raisons : les équipes de sécurité s’en servent pour combler les failles, et les créateurs pour savoir ce qu’ils peuvent réaliser avec un outil donné.
Comment les tests ont été menés
Les méthodes de test documentées reposaient sur trois approches principales : des prompts directs décrivant des scénarios adultes ou suggestifs en langage clair, des prompts indirects utilisant un cadre artistique, historique ou professionnel, et des tests image vers vidéo utilisant des images sources suggestives comme images de départ de la génération.
Chaque variante de prompt a été exécutée par séries de 20 à 50 afin de tenir compte de la variation stochastique des résultats. Un seul refus ne suffit pas à établir qu’une catégorie est bloquée. Cela signifie seulement que cette formulation précise a échoué lors de cette exécution précise. Les tendances ne sont apparues qu’après plusieurs exécutions, et les résultats ont été consignés par catégorie et par variante de formulation.
Des résultats qui ont surpris les chercheurs
Le principal constat des tests systématiques : le filtre de contenu de Veo 3.1 fonctionne comme un spectre plutôt que comme un mur. Des catégories bien délimitées de contenu frôlant l’adulte ont produit des résultats constants. D’autres ont déclenché des réponses incohérentes, le même prompt produisant à la fois des refus et des générations réussies d’une exécution à l’autre, sans différence significative dans les données d’entrée.
Du contenu suggestif qui est passé
Plusieurs catégories de contenu ont franchi le classifieur avec une fiabilité élevée lors de plusieurs sessions de test :
Les scénarios éditoriaux de maillots de bain et de tenues de plage ont produit des résultats de façon constante lorsqu’ils étaient formulés avec le vocabulaire de la photographie professionnelle. Le filtre ne semble pas signaler les maillots de bain comme catégorie bloquée lorsque le contexte du prompt établit une intention éditoriale ou de mode. Les résultats comprenaient des scènes qui paraîtraient modérément explicites dans de nombreux contextes éditoriaux, en particulier en mode image vers vidéo, où une image de départ suggestive était fournie.
Le cadrage artistique a produit des résultats partiels. Les prompts invoquant les traditions de l’étude de la figure humaine, les supports de référence du dessin de modèle vivant ou les précédents artistiques classiques ont généré des résultats dans environ 40 % des exécutions. Le classifieur semble entraîné avec une certaine connaissance du contexte historique de l’art, mais la frontière entre une classification « artistique » et « adulte » est incohérente d’une exécution à l’autre.
Les scénarios adultes implicites ont été générés de façon constante. Les scénarios vidéo qui suggéraient un contenu adulte sans le montrer directement, une porte de chambre qui se referme, une scène de douche avec le sujet hors champ, des moments intimes qui progressent vers l’explicite sans y arriver, ont franchi le filtre dans la grande majorité des exécutions testées. Le classifieur temporel qui évalue les vidéos semble nettement plus faible au niveau de l’implicite qu’au niveau de la représentation directe.
Les vêtements mouillés et la mise en valeur physique dans des contextes sportifs ou de mode ont été générés sans accroc dans la plupart des tests. Les contenus où l’état des vêtements et la mise en valeur du corps paraîtraient adultes sur les réseaux sociaux sont passés lorsqu’ils étaient présentés comme de la photographie sportive ou de mode.
💡 Le schéma commun aux catégories qui ont réussi : le filtre de Veo 3.1 est calibré pour détecter le contenu explicite, pas le contenu suggestif. L’écart entre ce qui paraît adulte à un relecteur humain et ce qui déclenche le seuil du contenu explicite est considérable.
Là où Veo 3.1 a tracé la limite
Certaines catégories ont déclenché des blocages stricts quelle que soit la variante de prompt ou l’approche de cadrage :
Le contenu sexuel explicite a été bloqué quel que soit le cadrage artistique ou professionnel. Les prompts décrivant une activité sexuelle directe ont généré des refus pour chaque variante de formulation testée, y compris celles qui utilisaient un langage clinique, artistique ou historique.
Les contenus impliquant des mineurs dans tout contexte proche de l’adulte ont déclenché des refus immédiats, sans aucune exception dans les tests documentés. Cette catégorie semble être le blocage le plus solidement mis en œuvre du système.
Les scénarios non consentis décrits dans un langage direct ont été bloqués de manière constante. Les prompts nommant des personnalités publiques réelles dans des scénarios intimes ou compromettants ont eux aussi déclenché des refus, et le système semble disposer d’une détection spécifique pour cette catégorie, indépendante du filtre général pour les contenus pour adultes.
Le problème de l’incohérence des filtres
La constatation la plus importante des tests de contenu de Veo 3.1 n’est pas ce qui est passé. C’est l’incohérence d’une exécution à l’autre dans la manière dont les mêmes prompts ont été traités.
Même prompt, résultats différents
Des prompts identiques exécutés par séries de 20 ont montré des taux de refus compris entre 20 % et 60 % pour les contenus des catégories en zone grise, sans corrélation significative avec l’heure de la journée, le point de terminaison API ou toute autre variable observable. L’élément stochastique du processus de génération signifie que le classifieur de sécurité reçoit des représentations internes légèrement différentes du même prompt à chaque exécution, et que sa sortie de classification binaire varie en conséquence.
D’un point de vue d’ingénierie de la sécurité, c’est sans doute intentionnel : les filtres déterministes sont plus faciles à contourner de façon systématique que les filtres probabilistes. Du point de vue du flux de travail créatif, c’est un problème de production. On ne peut pas bâtir un pipeline de contenu fiable sur un outil qui traite la même entrée de façon différente une fois sur deux.
| Catégorie de contenu | Taux de réussite approximatif lors des tests |
|---|
| Scénarios éditoriaux de maillots de bain et de plage | ~85 % |
| Scénarios intimes implicites | ~70 % |
| Cadrage artistique et étude de la figure | ~40 % |
| Vêtements mouillés, mise en valeur sportive | ~75 % |
| Contenu adulte direct | ~0 % |
Contournements qui fonctionnent (et ceux qui ne fonctionnent pas)
La communauté des tests a documenté plusieurs approches de prompts qui ont systématiquement amélioré les taux de réussite pour les catégories de contenu suggestif :
Placer le contexte professionnel en tête améliore les taux de réussite. Les prompts qui s’ouvrent sur un cadrage professionnel (« fashion editorial photography for a luxury brand featuring... ») passent à des taux plus élevés que ceux qui décrivent d’abord le contenu visuel. Le classifieur pondère davantage les premiers tokens du prompt, donc établir le contexte professionnel avant de décrire le sujet modifie le résultat de la classification.
Le vocabulaire technique de la photographie est perçu comme de l’éditorial. Inclure des détails précis de boîtier, d’objectif et de type de pellicule (« shot on 85mm f/1.4, Kodak Portra 400 grain, editorial quality ») semble orienter la classification vers les catégories éditoriales plutôt que vers les catégories de contenu pour adultes.
Décrire les propriétés des matières plutôt que les niveaux d’exposition. Les prompts qui évoquent les caractéristiques des tissus (« sheer fabric catching backlit window light ») surpassent systématiquement les prompts qui décrivent directement l’état des corps.
Ce qui ne fonctionne pas : les schémas de prompts adversariaux, les substitutions de caractères, ou toute formulation manifestement conçue pour masquer l’intention. Le classifieur de Veo 3.1 présente une robustesse particulière face à l’ingénierie de prompts adversariale, et les tentatives de manipuler la classification par l’obfuscation déclenchent plutôt davantage de refus, et non moins.
La meilleure option : l’IA sans censure sur PicassoIA
Les données de test de Veo 3.1 mènent à la même conclusion que celle qui se dégage de tout test d’un modèle à accès restreint : si vous avez besoin de résultats constants et prévisibles pour un contenu frôlant l’adulte, sans variance liée aux filtres, les classifieurs à l’inférence sont le mauvais outil pour le travail.
PicassoIA donne accès à plusieurs modèles qui gèrent le contenu suggestif et le contenu pour adultes de bon goût sans le problème d’incohérence, sans plafond d’utilisation, sans demande d’approbation et sans filigrane.
Seedream 4 : le bon premier arrêt
Seedream 4 est le point de départ recommandé pour la génération d’images frôlant le contenu pour adultes. Le modèle de ByteDance produit des images allant jusqu’à 4K, avec une texture de peau photoréaliste, un rendu des tissus et une physique de l’éclairage. Les avantages pour ce cas d’usage sont importants :
Les résultats sont déterminés par le prompt plutôt que par le classifieur. Ce que vous décrivez est ce qui est généré. Les taux de réussite pour les maillots de bain, la lingerie, le glamour et les nus artistiques sont constants d’une session à l’autre.
Le plafond de sortie en 4K permet de générer à la résolution d’impression sans upscaling (augmentation de la résolution). La saisie d’une image de référence permet d’établir une identité visuelle, qu’il s’agisse d’un personnage, d’un style ou d’une composition, et de la reprendre tout au long d’une série de générations. Le mode de génération séquentielle produit jusqu’à 15 images liées à partir d’un seul prompt, offrant des variations sans avoir à reformuler le prompt pour chaque image.
Pour les créateurs qui gèrent la loterie des filtres de Veo 3.1, la prévisibilité de Seedream 4 est la différence la plus utile dès le départ.
Flux Dev : le photoréalisme maximal
Flux Dev de Black Forest Labs dispose de 12 milliards de paramètres, ce qui se traduit directement par une meilleure anatomie, des poses plus naturelles et une interaction plus convaincante entre les tissus et la peau que celle des modèles plus petits. Pour le contenu frôlant l’adulte, où le photoréalisme est l’exigence principale, le nombre de paramètres compte.
Le mode img2img accepte une image existante et un prompt décrivant comment la modifier, ce qui permet d’affiner facilement des résultats proches sans être tout à fait justes. Onze formats d’image vont du carré à l’ultra-panoramique, sans recadrage. Le contrôle du seed permet de figer un résultat qui fonctionne et d’itérer méthodiquement de petites variations à partir de celui-ci.
Flux Schnell : itération à grand volume
Flux Schnell produit des images photoréalistes en moins de 5 secondes par image, sans plafond de génération sur PicassoIA. Pour la phase de mise au point des prompts d’un projet de contenu, où l’on lance 30 ou 50 variations pour trouver la formulation et la composition qui fonctionnent avant de passer à des rendus de meilleure qualité, Flux Schnell absorbe cette charge sans friction ni surcoût en crédits.
La politique de génération illimitée vous permet d’effectuer autant d’itérations qu’un projet l’exige, sans surveiller un compteur de crédits. Pour les opérations de contenu à grand volume, c’est une différence opérationnelle significative par rapport à tout modèle API à accès restreint.
SDXL : la cohérence de style sur une série
SDXL prend en charge les poids LoRA personnalisés, ce qui compte pour les séries de contenu où la cohérence visuelle est requise. Chargez un LoRA entraîné sur une esthétique, un style d’éclairage ou un type de morphologie précis, et chaque génération partagera cet ADN visuel. Le pipeline de raffinement intégré ajoute une passe de netteté supplémentaire, particulièrement utile pour la texture de la peau et le détail des tissus dans les images intimes ou de style glamour.
Seedream 4 est le point d’entrée recommandé pour la génération d’images frôlant le contenu pour adultes sur PicassoIA. Les étapes suivantes donnent les meilleurs résultats.
Étape 1 : ouvrez le modèle. Rendez-vous sur picassoia.com/en/collection/text-to-image/bytedance-seedream-4. Aucune approbation de compte n’est requise.
Étape 2 : structurez votre prompt pour le photoréalisme. Seedream 4 répond mieux aux prompts qui précisent ensemble le sujet, l’environnement, l’éclairage et les caractéristiques de la caméra. Une structure qui fonctionne :
"Editorial fashion photograph of a woman in [clothing description], [environment], [specific lighting description], 85mm f/1.4, Kodak Portra 400 film grain, photorealistic skin texture, 4K"
Étape 3 : réglez la résolution. Le 2K convient bien à une diffusion web. Le 4K convient à l’impression ou à une sortie haute fidélité. Pour les réseaux sociaux, le 2K au format 16:9 couvre la plupart des besoins d’affichage.
Étape 4 : utilisez des images de référence pour la cohérence des personnages. Si vous travaillez sur une série avec un sujet constant, importez une image de référence à l’aide du paramètre image_input. Seedream 4 reprend l’identité visuelle de la référence dans l’image générée avec une grande fidélité.
Étape 5 : lancez la génération séquentielle pour les séries. Réglez sequential_image_generation sur auto et max_images sur 8-15. Le modèle produit une série liée à partir d’un seul prompt, offrant une variété de composition sans reformuler chaque image.
💡 Nommez des sources de lumière précises, pas seulement des qualités. « Volumetric morning light through gauze curtains from the left » donne de meilleurs résultats que « soft natural light ». La qualité de sortie du modèle est directement proportionnelle à la précision de votre description de l’éclairage.
D’autres conseils pour de meilleurs résultats :
- Nommez des matières précises pour les tissus. « Sheer chiffon », « wet silk » et « stretch jersey » activent de meilleurs exemples d’entraînement que des descriptions génériques de vêtements.
- Indiquez une direction de composition. « Figure occupying lower third, expansive sky background » donne au modèle des informations de mise en page qui améliorent la cohérence globale de l’image.
- Précisez le type de pellicule. « Kodak Portra 400 », « Fujifilm 400H » ou « Ilford HP5 » améliorent de façon constante le rendu des teintes de peau et réduisent la qualité clinique présente dans beaucoup de sorties générées par IA.
- Utilisez délibérément les exclusions. Décrivez ce qui ne doit pas figurer dans le cadre, soit dans le champ de prompt négatif, soit à la fin du prompt principal, avec une formulation comme « no digital effects, no CGI ».
PicassoIA face à Veo 3.1 : comparaison côte à côte
La comparaison entre Veo 3.1 et la bibliothèque de modèles de PicassoIA ne porte pas principalement sur la qualité de sortie. Veo 3.1 produit de bons résultats quand il fonctionne. La comparaison porte sur la fiabilité du flux de travail.
| Critère | Veo 3.1 | Modèles PicassoIA |
|---|
| Comportement du filtre de contenu | Stochastique, varie selon l’exécution | Déterminé par le prompt, constant |
| Taux de réussite pour le contenu suggestif | 40-85 % selon la catégorie | 95 %+ |
| Type de sortie | Clips vidéo | Images jusqu’à 4K |
| Vitesse de génération | 30-90 secondes par clip | 5-30 secondes par image |
| Coût | Crédits API requis | Gratuit, sans plafond |
| Filigrane | SynthID intégré | Aucun |
| Accès | Sur candidature | Immédiat, sans approbation |
| Prévisibilité du contenu pour adultes | Imposée par le classifieur, incohérente | Fondée sur le prompt, fiable |
La variance des taux de réussite pour le contenu suggestif signifie que bâtir un pipeline de production sur Veo 3.1 pour tout ce qui relève de la zone grise implique de prévoir un taux de rejet important. Avec un taux de réussite de 40 % pour le contenu artistique, il faut générer 2,5 fois le volume visé, puis filtrer. Compte tenu de la vitesse de génération et du coût en crédits de la vidéo via API, ce surcoût est non négligeable.
Les modèles de PicassoIA ne demandent pas ce calcul de surcoût. Générez ce dont vous avez besoin, obtenez ce que vous avez décrit.
Créez librement sur PicassoIA
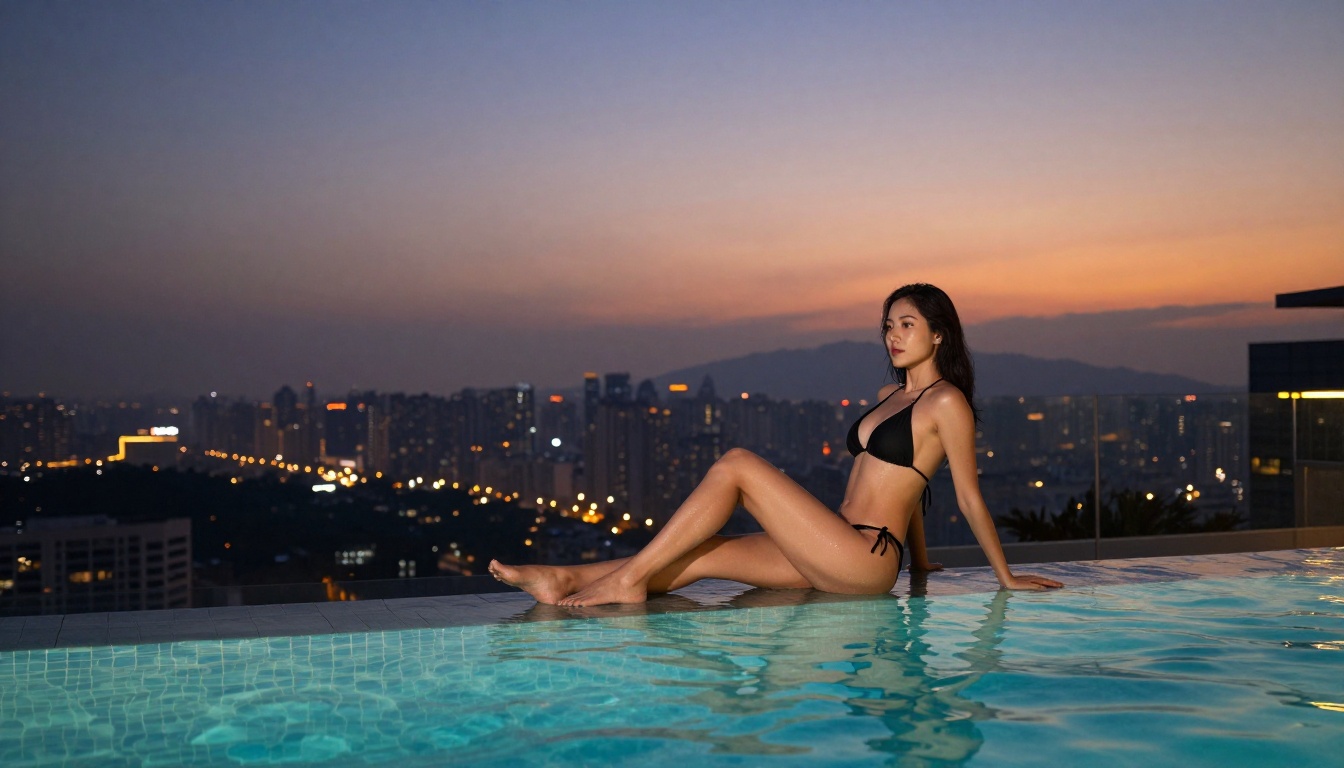
Les constats sur le filtre de contenu de Veo 3.1 valent la peine d’être lus si vous étudiez la façon dont les classifieurs à l’inférence échouent aux limites. Mais si vous construisez avec ces constats plutôt que de les examiner d’un point de vue académique, la conclusion pratique est simple : les modèles à accès restreint, dotés de classifieurs opaques, ne constituent pas le bon socle pour un travail créatif frôlant le contenu pour adultes.
Seedream 4 génère des images photoréalistes jusqu’à 4K à partir de vos prompts, sans variance liée aux filtres, sans filigranes et sans crédits. Flux Dev offre un photoréalisme à 12 milliards de paramètres avec une édition img2img complète. Flux Schnell enchaîne des itérations illimitées à grande vitesse. SDXL ajoute le contrôle de style LoRA pour un travail de série cohérent.
La bibliothèque complète de modèles est disponible sur picassoia.com/en/all-models. Aucune demande n’est nécessaire. Aucun classifieur ne décide si votre direction créative passe aujourd’hui. Ouvrez un modèle, rédigez votre prompt et générez.


