GPT Image 2 est le modèle de génération d’images le plus performant d’OpenAI à ce jour. Si vous ne l’avez pas testé sérieusement, l’écart avec ce que l’on obtenait il y a deux ans est vraiment frappant. Il ne s’agit pas d’une amélioration marginale. Le photoréalisme, le respect du prompt et la justesse de la composition ont franchi un seuil qui le rend utile pour un travail réel, et pas seulement pour l’expérimentation. Passons en revue précisément ce qu’il sait faire et ce qu’il ne sait pas faire.
Les bases : ce qui le distingue
Ce n’est pas DALL-E 3 sous un autre nom
GPT Image 2 repose sur une architecture distincte de celle de ses prédécesseurs. Là où DALL-E 3 se concentrait sur l’alignement avec le prompt, c’est-à-dire s’assurer que l’image correspond vraiment à ce que vous avez tapé, GPT Image 2 améliore à la fois l’alignement ET le réalisme perceptif. Le résultat : des images qui paraissent photographiées, et non générées.
Le modèle gère la composition multi-éléments bien mieux que les versions précédentes. Demandez-lui une scène avec des objets, des personnes et un éclairage précis, et il les place correctement les uns par rapport aux autres, au lieu de les mélanger dans un agencement invraisemblable.
Le fonctionnement du pipeline texte vers image
En coulisses, GPT Image 2 utilise une architecture basée sur la diffusion, affinée par apprentissage par renforcement à partir de retours humains (RLHF), une technique proche de celle qui a amélioré les réponses textuelles de ChatGPT. Concrètement, le modèle a été réglé pour produire des résultats que les utilisateurs préfèrent réellement, et pas seulement des résultats qui obtiennent de bons scores sur des indicateurs techniques.
Le pipeline prend votre prompt, l’encode dans une représentation sémantique, puis transforme progressivement une image bruitée en un visuel détaillé. Chaque étape de raffinement est guidée par l’intégration du texte, ce qui explique pourquoi des prompts précis et détaillés donnent des résultats nettement meilleurs que des prompts vagues.
7 choses que GPT Image 2 fait bien
La génération de portraits
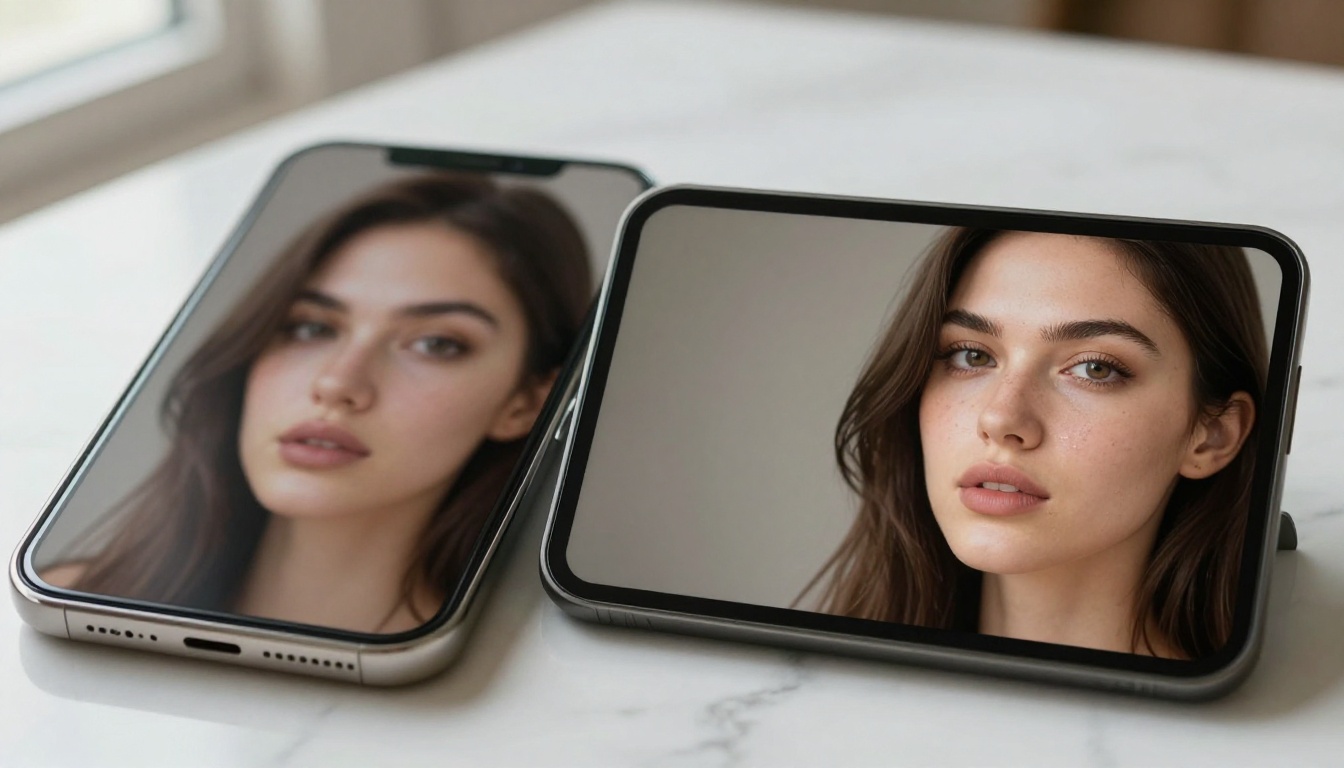
C’est là que GPT Image 2 impressionne vraiment. Les visages sont cohérents, l’éclairage est naturel et les teints réagissent avec justesse aux conditions décrites. Vous pouvez préciser l’âge, l’origine ethnique, l’émotion et la direction de la lumière, et obtenir un résultat qui ressemble à un portrait professionnel signé par un photographe compétent. Le modèle gère bien la diversité des teints, un point faible historique de la génération d’images par IA.
💡 Astuce : Décrivez explicitement la direction de la lumière. « Lumière douce de fenêtre venant de la gauche, fin d’après-midi chaud » donne de bien meilleurs résultats que « bon éclairage ». Le modèle traite l’éclairage comme un élément de premier plan de la composition.
Les micro-détails du visage sont rendus avec un réalisme qui n’était accessible qu’aux modèles spécialisés dans le portrait il y a un an. Les pores, les légères asymétries, les rides naturelles et les reflets réalistes dans les yeux contribuent tous à un résultat qui se lit comme photographié plutôt que synthétisé.
Photos de produits et visuels commerciaux
Les équipes e-commerce adoptent discrètement cet outil pour la photographie de produits à grande échelle. Précisez le matériau de la surface, le dispositif d’éclairage et le contexte, qu’il soit lifestyle ou en studio, et le résultat est régulièrement indiscernable d’une séance de prise de vue commerciale basique. Il ne remplace pas un photographe pour les visuels phares d’une campagne, mais il gère très efficacement le travail de volume : déclinaisons, options de couleur et mises en scène contextuelles.
💡 Astuce : Pour les photos de produits, précisez toujours le matériau de la surface. « Fond infini en acrylique blanc avec ombre discrète » ou « table en marbre » ou « étagère en noyer foncé » produisent des ambiances très différentes, et le modèle restitue avec précision la texture de chaque matériau.
Visuels d’architecture et d’intérieur
Les architectes et les décorateurs utilisent GPT Image 2 pour prototyper rapidement des concepts visuels avant de se lancer dans des rendus ou des maquettes physiques. Décrivez les matériaux d’une pièce, les conditions de lumière naturelle, le style du mobilier et la palette de couleurs : le résultat communique clairement l’intention de design aux clients et aux collaborateurs. Bien plus rapide qu’un rendu 3D pour les présentations en amont d’un projet.
Composition de scènes à partir de prompts complexes
Les modèles précédents ignoraient souvent certains éléments d’une scène complexe ou les plaçaient mal dans l’espace. GPT Image 2 gère les scènes à plusieurs sujets avec une logique spatiale. « Une femme lisant un livre à gauche du cadre, un chien endormi au premier plan, une bibliothèque en arrière-plan » produit des objets placés à peu près aux bons endroits, avec les bonnes proportions relatives.
Le rendu du texte dans les images
L’une des plus anciennes critiques adressées aux générateurs d’images par IA concerne le texte cassé. Des lettres incompréhensibles sur des enseignes, des menus et des étiquettes de produits, comme si elles avaient été tapées par quelqu’un qui n’avait jamais vu l’alphabet. GPT Image 2 gère de façon fiable les courtes chaînes de texte. Les étiquettes de produits de 3 à 5 mots, les vitrines, les éléments typographiques simples s’affichent correctement dans la majorité des tentatives. Les chaînes plus longues dérivent encore vers l’incohérence, mais pour les cas d’usage commerciaux les plus courants, le problème du texte est largement résolu.
💡 Astuce : Limitez les chaînes de texte à moins de 5 mots pour de meilleurs résultats. Utilisez des guillemets dans votre prompt pour marquer clairement le texte : "un auvent de boulangerie qui affiche « Fresh Daily » en lettres blanches écrites à la main".
La cohérence du style au fil d’une session
Pour les créateurs de contenu qui produisent des séries d’images, la cohérence visuelle compte énormément. GPT Image 2 conserve le style visuel, l’étalonnage des couleurs et l’apparence des personnages sur plusieurs générations, à condition d’utiliser un langage de prompt constant comme point d’ancrage. Cela le rend pratique pour les lots de contenus pour les réseaux sociaux, les séries éditoriales et la production de storyboards, où les images doivent paraître appartenir au même ensemble.
Inpainting et retouches ciblées
Au-delà de la génération à partir de zéro, GPT Image 2 prend en charge l’inpainting : vous délimitez une zone d’une image existante et décrivez ce qui doit la remplacer. Changez l’arrière-plan d’une photo de produit. Modifiez la couleur d’une chemise. Supprimez un objet parasite d’une scène. Le modèle fusionne la modification avec le contenu environnant de façon naturelle, sans donner l’impression d’un collage.
Là où il peine
Les mains et l’anatomie fine
C’est le point faible persistant des modèles de diffusion, GPT Image 2 compris. Les mains dans des angles inhabituels, les doigts qui se chevauchent et les gros plans sur les articulations sont souvent rendus incorrectement. Les doigts en trop, les jointures fusionnées et les poses anatomiquement impossibles apparaissent plus souvent qu’il ne faudrait. La solution tient à la composition : utilisez le cadrage et la mise en scène pour éviter de mettre les mains en avant. Un angle de caméra légèrement plus large, ou une pose qui cache naturellement les mains, contourne entièrement le problème.
Les longs textes dans les images
Les courtes chaînes de texte fonctionnent bien, mais si vous avez besoin d’un paragraphe lisible, d’un graphique lisible ou d’une typographie complexe sur plusieurs lignes, GPT Image 2 n’est pas l’outil adapté. Pour les visuels riches en texte, la bonne méthode consiste à générer l’image photographique de base avec le modèle, puis à ajouter le texte en surimpression dans un outil de design comme Figma ou Photoshop. Cette approche hybride produit un texte net et exact, sans lutter contre les limites intrinsèques du modèle.
Les instructions spatiales très précises
Décrire une photo de groupe de cinq personnes avec des poses nommées pour chacune et des relations spatiales précises produira un résultat plausible, mais pas fidèle au pied de la lettre. Le modèle interprète l’intention compositionnelle générale plutôt que d’exécuter une mise en page technique rigide. Pour les compositions de groupe, décrivez l’ambiance et un agencement approximatif plutôt que d’attendre un contrôle positionnel précis.
GPT Image 2 face aux meilleurs autres modèles
Le choix du bon modèle dépend fortement de votre cas d’usage précis. Voici comment GPT Image 2 se compare aux principales alternatives disponibles actuellement :
| Modèle | Idéal pour | Photoréalisme | Respect du prompt | Texte dans les images |
|---|
| GPT Image 2 | Commercial, portraits, éditorial | Excellent | Excellent | Bon |
| Flux Redux Dev | Variations d’image à partir d’une référence | Très bon | Très bon | Correct |
| Seedream 4.5 | Détail en 4K pour l’impression | Excellent | Très bon | Correct |
| Hunyuan Image 2.1 | Styles esthétiques asiatiques | Très bon | Bon | Correct |
| Qwen Image Edit Plus | Retouche photo, édition | Très bon | Très bon | Correct |
Chaque modèle a un domaine où il excelle. GPT Image 2 est en tête pour les rendus de type photographie commerciale, le travail de portrait et tout ce qui exige un respect précis du prompt. Seedream 4.5 produit un détail remarquable pour les visuels destinés à l’impression, lorsque la résolution pure est la priorité. Flux Redux Dev est le meilleur choix lorsque vous avez besoin de variations cohérentes à partir d’une image source existante. Qwen Image Edit Plus gère la retouche et les modifications ciblées mieux que la plupart des modèles.
GPT Image 2 est disponible directement sur PicassoIA, sans configuration d’API, sans gestion de crédits ni paramétrage technique.
Pas à pas
- Ouvrez la page du modèle : rendez-vous directement sur GPT Image 2 sur PicassoIA depuis la collection texte vers image.
- Rédigez votre prompt : soyez précis. Indiquez le sujet, l’environnement, la lumière, l’angle de prise de vue et le style. Plus le détail est fin, plus vous contrôlez le résultat.
- Choisissez votre format : pour les réseaux sociaux, 1:1 ou 9:16. Pour les en-têtes de site ou les présentations, 16:9. Pour les proportions photographiques classiques, 3:2.
- Lancez la génération : cliquez sur générer. Le temps de traitement va de quelques secondes à quelques minutes, selon la résolution et la charge du serveur.
- Évaluez et affinez : si le résultat ne convient pas, affinez le prompt au lieu de relancer une génération avec exactement le même texte. Modifiez une seule variable à la fois pour isoler ce qui influence le résultat, qu’il s’agisse de la lumière, du détail du sujet ou du cadrage.
- Téléchargez ou poursuivez : enregistrez le résultat directement ou envoyez-le vers un flux de travail d’inpainting ou de retouche pour l’affiner davantage.
Conseils pour de meilleurs prompts
Commencez par la lumière. La condition d’éclairage donne le ton de tout le reste, avant tout autre détail. « Heure dorée, lumière latérale chaude venant de la droite, ombres longues » ou « ciel couvert, lumière diffuse et plate, tons neutres » produisent des registres émotionnels complètement différents, même avec un sujet identique.
Utilisez le vocabulaire photographique. GPT Image 2 répond bien à la terminologie photographique. « 85 mm f/1.8, faible profondeur de champ, bokeh en arrière-plan » produira des résultats aux caractéristiques optiques précises. « Grand angle 24 mm, portrait environnemental, tout en netteté » fait de même pour un rendu différent.
Décrivez ce que vous ne voulez pas. Indiquer ce que vous ne souhaitez pas améliore souvent nettement les résultats. « Pas de texte superposé, pas de filigrane, pas d’arrière-plan encombré, pas de vignettage artificiel » élimine les artefacts courants avant qu’ils n’apparaissent.
Ancrez le style à la fin. Terminez chaque prompt par une note de style ou une émulation de pellicule : « Kodak Portra 400, grain naturel, photoréaliste, photographie brute » indique au modèle le registre esthétique à conserver pendant toute la génération.
Qui en a vraiment besoin
Créateurs de contenu et équipes réseaux sociaux
Si vous produisez des contenus visuels en volume, la génération d’images par IA change radicalement la logique de production. Une équipe de réseaux sociaux qui avait besoin d’un photographe pour chaque visuel de campagne peut désormais itérer sur des concepts en quelques heures au lieu de quelques jours. GPT Image 2 prend en charge les visuels courants, ce qui libère le budget créatif pour les prises de vue qui exigent réellement un regard humain derrière l’objectif.
Petites entreprises sans équipe créative
La petite entreprise type n’a ni photographe ni graphiste en interne. Les photos de produits sont prises avec un téléphone devant un mur blanc. Les images d’en-tête du site sont la photo de banque d’images jugée acceptable. GPT Image 2 change ce qui est possible pour les entreprises sans gros budget créatif. Une boulangerie peut générer des photos lifestyle de ses produits dans de belles cuisines. Une marque de vêtements peut créer des images de type lookbook sans réserver de mannequin ni louer de studio.
Développeurs de produits visuels
Si vous intégrez la génération d’images dans une application ou une plateforme, le fort respect du prompt de GPT Image 2 rend les résultats destinés aux utilisateurs plus prévisibles. Une qualité de sortie constante réduit la charge de support liée à un comportement du modèle très variable. La fiabilité du modèle selon les types de prompts en fait un socle solide pour les produits grand public.
Designers et directeurs artistiques
Le prototypage visuel rapide est ce qui fait la réputation de ce modèle auprès des professionnels. Un directeur artistique peut générer 20 directions conceptuelles pour une campagne avant de s’engager dans un seul tournage. La rapidité d’itération change la façon dont les briefs créatifs sont élaborés, présentés et validés. Les clients voient des directions visuelles réalistes dès le début, ce qui raccourcit nettement le cycle de révisions.
Applications concrètes dès maintenant
Les applications pratiques se multiplient déjà dans de nombreux secteurs, à grande échelle :
- Annonces immobilières : générez des visuels de pièces meublées pour des biens vides afin d’aider les acheteurs à se projeter
- Menus de restaurant : créez des photos de plats à partir de descriptions écrites, avant que les plats ne soient finalisés ou que les produits de saison ne changent
- Conception de mode : visualisez des modèles de vêtements portés par des mannequins de morphologies, de teints et dans des décors variés
- Édition : générez des en-têtes de chapitres, des illustrations de concept et des maquettes de couverture sans commander d’œuvres originales
- Tests marketing : créez plusieurs traitements visuels d’un même concept de campagne pour les tester avant de lancer la production
- Données d’entraînement : générez à grande échelle des jeux de données d’images étiquetées pour des projets de vision par ordinateur et d’apprentissage automatique
💡 À savoir : PicassoIA's Image Editor Pro vous permet de reprendre n’importe quel résultat de GPT Image 2 et de continuer à l’affiner avec d’autres outils d’IA. Générez l’image de base, puis affinez des zones précises, élargissez le cadre ou remplacez les éléments qui ne fonctionnent pas.
Commencez à créer vos propres images
La seule façon de vraiment saisir ce que produit GPT Image 2 est de lancer quelques générations vous-même. La théorie et les exemples ne mènent qu’à une certaine compréhension. Le comportement du modèle selon les différentes structures de prompts s’acquiert en pratiquant, pas en lisant.
PicassoIA vous donne accès à GPT Image 2 ainsi qu’à des dizaines d’autres modèles de référence, afin de comparer côte à côte les résultats d’un même prompt. Essayez Seedream 4.5 pour des résultats 4K à très haut niveau de détail. Utilisez Qwen Image Edit Plus lorsque vous voulez modifier et affiner une image existante plutôt que de partir de zéro. Et si vous recherchez des variations cohérentes d’une image source, Flux Redux Dev est le bon choix.
Choisissez un concept que vous voulez visualiser depuis longtemps. Rédigez un prompt détaillé en suivant les conseils ci-dessus. Regardez ce qui en ressort. La distance entre ce que vous imaginez et ce que produit le modèle s’est réduite à un point qui surprend encore les gens la première fois qu’ils s’en servent sérieusement.