Qu’est-ce qu’une passerelle MCP ? Architecture, exemples, limites de débit et options open source
Une passerelle MCP est le point d’entrée unique entre vos agents d’IA et chacun des serveurs MCP qu’ils appellent. Cet article explique le fonctionnement de l’architecture, présente trois configurations réelles, des schémas de limites de débit qui tiennent face au trafic des agents, et les passerelles open source que vous pouvez exécuter dès aujourd’hui.
Votre premier serveur MCP demande un après-midi. Votre dixième demande une revue de sécurité, trois rotations d’identifiants et un message furieux à propos d’un agent incontrôlé qui a bombardé une API interne 4 000 fois en une minute. C’est à ce moment que la plupart des équipes se mettent à chercher une passerelle MCP.
Une passerelle MCP est un proxy qui se place entre les clients d’IA (agents, applications de chat, assistants de développement) et les serveurs MCP qui exposent des outils et des données. Au lieu que chaque client se connecte directement à chaque serveur, ils se connectent tous à un point d’entrée unique et contrôlé. Ce point d’entrée gère l’authentification, le routage, les politiques, les limites de débit et la journalisation, afin que les serveurs individuels n’aient pas à le faire.
Cet article détaille ce que fait une passerelle, comment s’articule l’architecture, à quoi ressemblent des configurations réelles, comment concevoir des limites de débit qui résistent au trafic des agents, et quelles options open source valent votre temps.
Ce que fait réellement une passerelle MCP
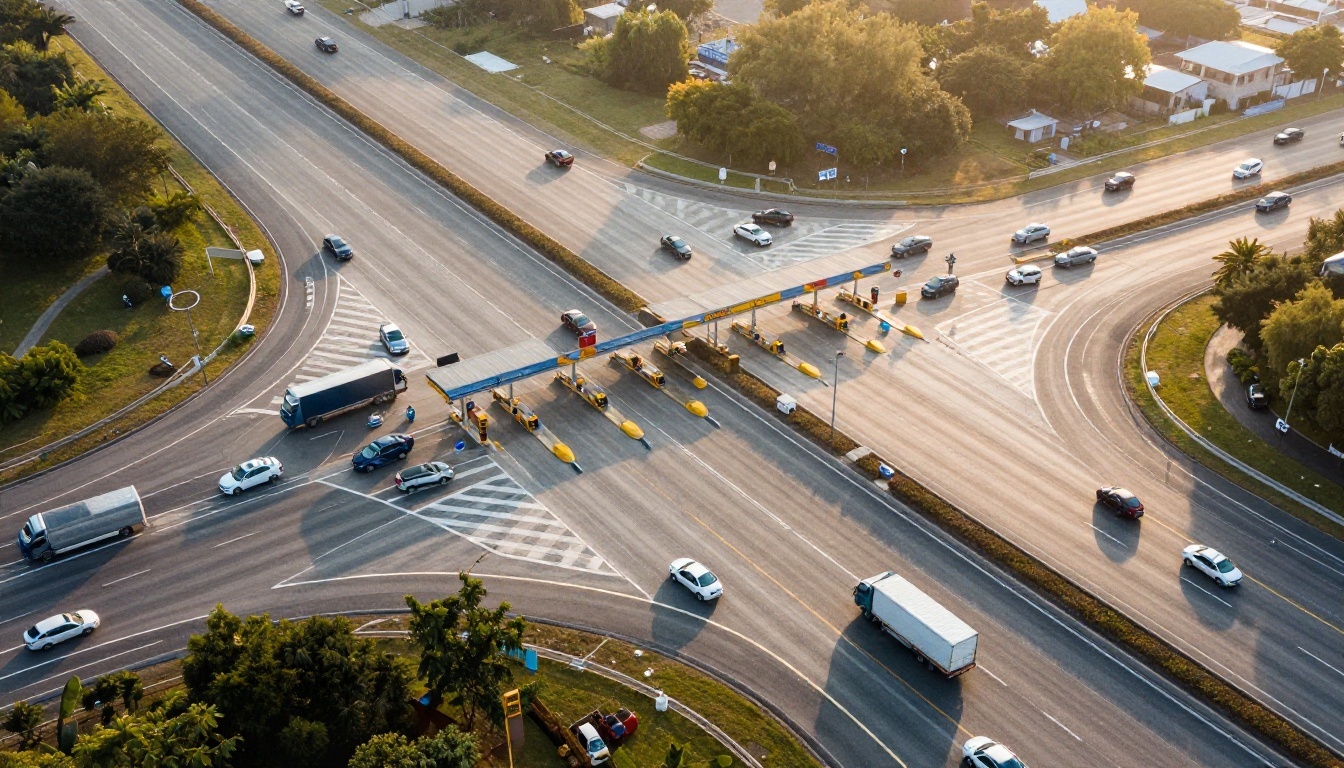
Pensez à une barrière de péage. La circulation arrive de plusieurs directions, chaque véhicule est contrôlé une fois, et le flux est régulé avant de rejoindre la route en aval. Une passerelle fait exactement la même chose pour les appels d’outils.
Le problème qu’elle résout
Le Model Context Protocol (MCP) standardise la manière dont un client LLM découvre et appelle des outils. C’est excellent pour l’interopérabilité, mais cela crée une topologie désordonnée à grande échelle. Si vous avez 8 clients et 15 serveurs, vous pouvez vous retrouver avec 120 connexions distinctes, chacune avec son propre identifiant, son propre format de journalisation et son propre mode de défaillance.
Problèmes courants sans passerelle :
Prolifération des identifiants : chaque client stocke un jeton pour chaque serveur.
Absence de piste d’audit centrale : personne ne peut dire quel agent a appelé quel outil, avec quels arguments.
Protection inégale : un serveur a des limites de débit, neuf n’en ont pas.
Intégration pénible : ajouter un serveur oblige à modifier la configuration de chaque client.
Surcharge d’outils : les agents voient des centaines de définitions d’outils et consomment leur contexte à lire des descriptions qu’ils n’utilisent jamais.
Les composants essentiels
La plupart des passerelles, quel que soit le fournisseur, combinent les mêmes briques :
Composant
Rôle
Pourquoi c’est important
Point d’entrée unique
Une seule URL MCP à laquelle les clients se connectent
Les clients n’ont besoin que d’une seule entrée de configuration
Couche d’authentification
OAuth, OIDC, jetons d’API, mTLS
L’identité est vérifiée une fois, de manière centralisée
Routeur / registre
Associe les noms d’outils aux serveurs en amont
Les serveurs peuvent être déplacés sans modifier les clients
Moteur de politiques
Autoriser ou refuser par utilisateur, outil, argument
Le moindre privilège pour les agents
Limiteur de débit
Plafonne les appels par identité, outil ou locataire
Protège les systèmes en amont et les budgets
Observabilité
Journaux, traces, métriques par appel
Débogage et conformité
Pont de transport
Convertit stdio, SSE et HTTP en flux
Les anciens serveurs fonctionnent avec les nouveaux clients
💡 Une passerelle n’est pas la même chose qu’une passerelle LLM. Une passerelle LLM relaie les appels vers les fournisseurs de modèles (complétions de chat, embeddings). Une passerelle MCP relaie les appels vers les outils et les sources de données. De nombreux produits font aujourd’hui les deux, mais les schémas de trafic sont différents.
Comment s’articule l’architecture
Le flux de requête étape par étape
Un appel d’outil typique traverse la passerelle de la manière suivante :
Le client se connecte. L’agent ouvre une session vers le point d’entrée MCP de la passerelle et présente un identifiant.
L’identité est résolue. La passerelle valide le jeton et l’associe à un utilisateur, une équipe ou un locataire.
La liste des outils est filtrée. Quand le client demande quels outils existent, la passerelle ne renvoie que ceux que cette identité peut utiliser. Cela réduit aussi le contexte que le modèle doit lire.
L’appel est autorisé. Sur tools/call, le moteur de politiques vérifie l’outil, les arguments et les conditions éventuelles, comme l’heure de la journée ou la classification des données.
Les limites sont vérifiées. Le limiteur de débit décrémente un compteur. Si le budget est épuisé, l’appel est rejeté avec une erreur claire que l’agent peut interpréter.
La requête est routée. La passerelle transmet l’appel au bon serveur en amont, en injectant l’identifiant de ce serveur afin que le client ne le voie jamais.
La réponse est renvoyée et journalisée. Le résultat remonte, avec la latence, le statut et les métadonnées de la charge utile écrits dans le journal d’audit.
Sessions sans état ou avec état
Les sessions MCP peuvent porter un état, et cela détermine la manière de faire évoluer la passerelle. HTTP en flux permet d’exécuter des requêtes sans état, qui passent à l’échelle horizontalement sans difficulté. Des fonctionnalités comme les messages initiés par le serveur, les abonnements et les appels d’outils de longue durée nécessitent souvent une affinité de session : le même client atteint toujours la même réplique de passerelle, ou l’état de session réside dans un stockage partagé.
Une règle pratique : commencez sans état, et ajoutez un stockage partagé seulement quand un outil en a réellement besoin. Les sessions collantes au niveau du répartiteur de charge sont, pour la plupart des équipes, une solution moins coûteuse.
Où elle fonctionne
Trois modes de déploiement reviennent sans cesse :
Sidecar ou processus local : une passerelle légère sur la machine du développeur qui sert de façade à quelques serveurs locaux.
Service central : un cluster de passerelles dans votre compte cloud, derrière votre fournisseur d’identité.
Instances par locataire : une passerelle par client dans un produit multi-locataires, ce qui isole le rayon d’impact au prix d’une infrastructure plus lourde.
Le pont de transport mérite une mention. Beaucoup de serveurs MCP utiles ne parlent encore que stdio, ce qui signifie qu’ils tournent comme sous-processus locaux. Une passerelle peut les encapsuler, les exécuter dans un conteneur et les exposer en HTTP, afin que des clients distants puissent les utiliser sans rien installer localement.
Exemples réels de configurations de passerelle
Configuration pour un développeur solo
Vous utilisez un assistant de développement, une application de chat et un agent en terminal. Chacun a besoin d’un serveur de système de fichiers, d’un serveur Git et d’un serveur de base de données. Sans passerelle, vous copiez les mêmes trois blocs de configuration dans trois applications.
Avec une passerelle locale, vous enregistrez les trois serveurs une seule fois, et chaque client pointe vers http://localhost:PORT/mcp. Ajoutez un nouveau serveur mardi et les trois applications le voient immédiatement. Ici, les limites de débit servent surtout de ceinture de sécurité : plafonnez l’outil de base de données à environ 30 appels par minute afin qu’un agent en boucle ne puisse pas bombarder votre base de développement.
Configuration d’équipe avec SSO
Une équipe d’ingénierie de 40 personnes partage l’accès à un outil de suivi des tickets, un wiki, un système d’intégration continue et une réplique de lecture de production. La passerelle se place derrière une authentification unique :
Les ingénieurs s’authentifient avec leur identité d’entreprise. Aucun jeton partagé.
Un mappage groupe-outil donne aux équipes support des outils wiki en lecture seule, aux développeurs les outils d’intégration continue et seul le groupe d’astreinte accède à la réplique de lecture de production.
Chaque appel est journalisé avec l’identité de la personne, et non avec un compte de service générique.
Le départ d’un collaborateur se traite par un seul interrupteur dans le fournisseur d’identité.
C’est le cas où les passerelles se rentabilisent le plus vite, car l’alternative est un tableur indiquant qui détient quel jeton.
SaaS multi-locataires
Vous livrez un produit où vos clients connectent leurs propres agents à vos outils. La passerelle fait alors partie de votre surface publique. Vous avez besoin d’une isolation par locataire, de quotas par locataire, d’un comptage d’usage pour la facturation et d’une validation stricte des arguments, car l’appelant n’est plus un employé de confiance.
Ici, le limiteur de débit remplit un double rôle de contrôle commercial : une offre gratuite peut autoriser 1 000 appels d’outils par jour, une offre payante 100 000, et les pics sont ralentis plutôt que rejetés.
💡 Quelle que soit la configuration, journalisez le nom de l’outil, l’identité de l’appelant, la latence, le statut et la taille des arguments. Soyez prudent avec la journalisation des arguments et des résultats complets, car ils contiennent souvent des données personnelles ou confidentielles.
Des limites de débit qui ont du sens
Le trafic des agents ne ressemble pas à celui d’un humain. Une personne clique sur un bouton toutes les quelques secondes. Un agent peut lancer dix appels d’outils en parallèle, réessayer sur n’importe quelle erreur et boucler jusqu’à réussir ou jusqu’à ce que quelqu’un l’arrête. Les limites de débit permettent d’éviter qu’une automatisation utile ne se transforme en déni de service contre vos propres systèmes.
Limiter par identité, pas par IP
Derrière un proxy d’entreprise, des centaines d’utilisateurs partagent une même adresse IP, et une plateforme d’agents peut changer d’IP en permanence. Les dimensions utiles sont les suivantes :
Par utilisateur ou par identité d’agent : arrête une boucle incontrôlée.
Par outil : un outil send_email mérite une limite bien plus basse que search_docs.
Par locataire ou par équipe : empêche les voisins bruyants de priver les autres de ressources.
Par serveur en amont : protège les backends fragiles qui ont leurs propres limites.
Globale : un plafond de dernier recours pour l’ensemble de la passerelle.
Une politique de départ raisonnable pourrait ressembler à ceci :
Il s’agit d’une esquisse illustrative, et non de la syntaxe d’un produit en particulier. Chaque passerelle a son propre format de configuration, mais la structure de la politique se transpose.
Limites de requêtes ou budgets de jetons
Deux grandeurs différentes peuvent être comptées :
Type de limite
Compte
Idéal pour
Basée sur les requêtes
Appels d’outils par fenêtre de temps
Protéger les backends et les API
Basée sur les jetons
Jetons LLM consommés par les résultats d’outils
Contrôler les dépenses du modèle et la taille du contexte
Concurrence
Appels en cours simultanément
Outils lents ou coûteux
Taille de la charge utile
Octets en entrée ou en sortie
Éviter les résultats géants qui saturent le contexte
Les limites basées sur les tokens comptent pour MCP d’une manière qu’elles n’ont pas avec les API classiques. Un outil qui renvoie un document de 200 000 caractères ne vous coûte rien au niveau HTTP, mais il peut engloutir une part énorme de la fenêtre de contexte du modèle et de votre facture. Certaines passerelles prennent désormais en charge des limites tenant compte des jetons, alors vérifiez-le avant de supposer que le comptage des requêtes suffit.
Où vivent les compteurs
C’est le choix de conception qui pose problème aux équipes plus tard. Les compteurs peuvent se trouver à trois endroits :
En mémoire, par réplique. Le plus rapide, avec une latence quasi nulle, mais chaque réplique compte de son côté. Avec 4 répliques et une limite de 100, un utilisateur peut en réalité faire 400 appels.
Stockage partagé, comme Redis. Précis entre les répliques, avec un petit coût de latence par appel et une dépendance de plus à faire fonctionner.
Compteurs distribués natifs de la passerelle. Même précision, mais la fonctionnalité est parfois réservée à une offre payante ou entreprise dans les projets open source.
Pour une passerelle sur un seul nœud, la mémoire suffit. Pour tout ce qui comporte plusieurs répliques et des quotas stricts, prévoyez un stockage partagé.
💡 Renvoyez un rejet lisible par une machine, accompagné d’une indication de délai avant nouvelle tentative. Un agent bien conçu peut temporiser. Une simple « erreur » pousse le modèle à réessayer immédiatement et aggrave les choses.
Les algorithmes courants incluent le token bucket (qui autorise les rafales et se remplit régulièrement), la fenêtre fixe (simple, mais qui laisse passer des rafales doubles aux bords de la fenêtre) et la fenêtre glissante (plus régulière, avec un peu plus d’état). Le seau à jetons est le choix par défaut pour les appels d’outils, car les agents sont naturellement sujets aux rafales.
Les passerelles open source à essayer
Le secteur évolue vite, et de nombreux classements « des meilleurs » sont rédigés par des éditeurs qui placent leur propre produit en tête. Considérez les noms ci-dessous comme une liste de départ, et vérifiez la licence, l’activité et l’état des fonctionnalités actuelles de chaque projet dans son dépôt avant de vous engager.
D’abord les conteneurs et Kubernetes
Docker MCP Gateway : présentée comme sous licence Apache 2.0, elle exécute chaque serveur MCP dans un conteneur isolé, avec la prise en charge des images signées et des secrets injectés. Elle est livrée avec les outils de bureau de Docker, ce qui en fait un choix naturel pour les configurations de développeurs en local.
Microsoft MCP Gateway : un reverse proxy et une couche de gestion destinés à Kubernetes, signalée sous licence MIT. Un bon choix si votre équipe plateforme travaille déjà avec des clusters.
Envoy AI Gateway : construite sur le proxy Envoy et proposant désormais le routage MCP. Si vous exploitez déjà Envoy, ajouter le routage MCP peut relever davantage d’une modification de configuration que de l’ajout d’un nouveau composant.
Style registre et fédération
IBM ContextForge : un projet sous Apache 2.0 qui joue le rôle de passerelle, de registre et de proxy, fédérant outils, agents et API derrière un seul point d’entrée MCP. Il est riche en fonctionnalités et populaire, mais le dépôt indique qu’il ne bénéficie d’aucun support officiel d’IBM, prévoyez donc votre propre maintenance.
Obot : une plateforme open source qui regroupe une passerelle, un catalogue et la gestion des accès.
Lasso : orientée sécurité, avec un accent sur l’inspection du trafic entre les agents et les outils.
Style performance et plateforme d’API
agentgateway : un projet de la Linux Foundation doté de limites de débit basées sur les jetons dans son niveau open source. Selon les informations disponibles, les limites globales inter-répliques et les contrôles de budget se trouvent dans un plan de contrôle entreprise, vérifiez donc ce point par rapport à vos besoins.
Bifrost : Apache 2.0, avec une limitation de débit en mémoire pour une surcharge très faible. Gardez en tête la réserve évoquée plus haut : les compteurs sont locaux à chaque instance.
Kong et Apache APISIX : des passerelles d’API matures qui gèrent MCP via des plugins. Si vous exploitez déjà l’une d’elles, vous bénéficiez d’une limitation de débit distribuée et d’un modèle d’exploitation familier, même si les fonctionnalités propres à MCP (filtrage au niveau des outils, gestion des sessions) peuvent être plus limitées que dans les passerelles conçues pour MCP.
Comparatif rapide
Passerelle
Idéale pour
Angle limite de débit
Points de vigilance
Docker MCP Gateway
Flux de travail locaux et conteneurs
Basique
Moins adaptée aux grandes configurations multi-locataires
Microsoft MCP Gateway
Plateformes Kubernetes
Dépend de la plateforme
Nécessite des compétences Kubernetes
Envoy AI Gateway
Équipes déjà sur Envoy
Filtres Envoy
Configuration plus complexe
IBM ContextForge
Fédération et registre
Intégré
Support communautaire uniquement
agentgateway
Limites tenant compte des jetons
Basée sur les jetons
Les limites inter-répliques peuvent être payantes
Bifrost
Surcharge faible
En mémoire
Compteurs par réplique
Kong / APISIX
Parcs d’API existants
Basée sur les plugins
Fonctionnalités MCP plus limitées
Sécurité et observabilité
Une passerelle est aussi votre meilleur endroit pour repérer les comportements étranges. Les agents lisent des descriptions d’outils rédigées par des tiers, et ces descriptions peuvent contenir des instructions cachées. Les résultats d’outils peuvent transporter du texte injecté. Un point central vous permet d’inspecter, de filtrer et d’enregistrer tout cela.
Contrôles à activer
Listes d’autorisation : n’exposez que les outils dont un rôle a besoin, plutôt que tout ce qu’un serveur propose.
Validation des arguments : rejetez les entrées mal formées ou trop larges de façon suspecte, comme un outil SQL recevant une instruction DROP.
Validation humaine pour les outils risqués : exigez une confirmation pour tout ce qui envoie, paie, supprime ou déploie.
Définitions d’outils figées : signalez quand un serveur modifie discrètement la description d’un outil que vous avez approuvé.
Injection de secrets : conservez les identifiants en amont dans la passerelle, jamais dans les configurations clientes ni dans le contexte du modèle.
Ce qu’il faut mesurer
Vous voulez des tableaux de bord pour les appels par outil, le taux d’erreur par serveur en amont, la latence p95, les rejets dus aux limites de débit et les principaux appelants. Un pic de rejets pour une seule identité signale généralement un agent en boucle. Un pic général signale généralement qu’un serveur en amont a ralenti et que les nouvelles tentatives se sont accumulées.
Comment en choisir une
Une courte liste de contrôle
Avant de choisir, répondez à ces questions :
Où fonctionnera-t-elle ? Ordinateur portable, machine virtuelle cloud, Kubernetes ou edge ?
Qui s’authentifie ? Avez-vous besoin de votre fournisseur OIDC existant, ou des jetons suffisent-ils ?
Combien de répliques ? S’il y en a plus d’une, comment les compteurs de limite de débit seront-ils partagés ?
Quels transports ? Devez-vous encapsuler des serveurs stdio ?
Qui la maintient ? Un projet adossé à une fondation ou à une entreprise active vaut mieux qu’un dépôt de week-end.
Pouvez-vous exporter les journaux ? Les données d’audit doivent circuler vers les outils que vous utilisez déjà.
Trois erreurs courantes
Tout placer derrière une seule permission uniforme. Si chaque utilisateur peut appeler chaque outil, vous avez construit un proxy coûteux, pas une passerelle.
Ignorer le problème des répliques. Les limites en mémoire paraissent parfaites dans une démonstration et laissent largement passer les dépassements en production.
Sauter la phase pilote. Déployez auprès d’une seule équipe, surveillez les journaux pendant une semaine, ajustez les limites selon l’usage réel, puis élargissez l’accès.
Un ordre de déploiement raisonnable : une passerelle unique devant deux ou trois serveurs à faible risque, puis le SSO, puis la politique au niveau des outils, puis des limites de débit ajustées à partir de chiffres réels, et enfin les outils à haut risque avec des flux d’approbation.
Testez vos agents avec de meilleurs modèles
Une passerelle n’est aussi utile que les agents qui se trouvent derrière elle, et la qualité de l’appel d’outils varie beaucoup d’un modèle à l’autre. Si vous mettez en place une configuration MCP et voulez comparer la façon dont différents LLM gèrent l’utilisation d’outils en plusieurs étapes, vous pouvez en essayer plusieurs sur Picasso IA sans créer de comptes séparés :
Claude Sonnet 5 pour les tâches de développement et de planification minutieuses
GPT 5.4 pour le raisonnement général et la rédaction
Kimi K2.6 pour les flux de travail de type agent et le code
Rédigez vos descriptions d’outils, collez un exemple de politique et demandez à chaque modèle de repérer les lacunes ou les ambiguïtés. Des descriptions courtes et précises aident les agents à choisir plus souvent le bon outil, ce qui vous fait aussi économiser votre budget de limite de débit.
Quand vous êtes prêt à aller au-delà du texte, parcourez tout ce qui est disponible sur picassoia.com/en/all-models et commencez dès aujourd’hui à expérimenter avec vos propres projets d’images, de vidéos et d’audio sur Picasso IA.