हर वह क्रिएटर जो टेक्स्ट प्रॉम्प्ट से लगातार शानदार AI इमेज पाता है, उसमें एक बात समान है: उसने विवरण लिखना छोड़कर निर्देश लिखना शुरू कर दिया। यह फ़र्क छोटा लगता है, लेकिन आपके आउटपुट की हर चीज़ बदल देता है।
ज़्यादातर लोग कुछ इस तरह टाइप करते हैं, "सूर्यास्त के समय समुद्र तट पर एक खूबसूरत महिला।" उन्हें जो मिलता है वह एक आम पोस्टकार्ड जैसा दिखता है। प्रो क्रिएटर्स जो लिखते हैं, वह किसी फ़िल्म डायरेक्टर के शॉट शीट जैसा लगता है, और नतीजे इसे साबित करते हैं।
ये 3 प्रॉम्प्ट हैक्स सिर्फ़ थ्योरी नहीं हैं। ये उन क्रिएटर्स से आए हैं जो GPT Image 2, Flux 2 Klein 9B और Wan 2.7 Image Pro जैसे मॉडल पर हर हफ़्ते दर्जनों से सैकड़ों इमेज बनाते हैं। ये काम करते हैं। और एक बार आप इन्हें इस्तेमाल करने लगेंगे, तो धुंधले विवरणों पर वापस नहीं जाएँगे।
ज़्यादातर AI प्रॉम्प्ट क्यों फ़ेल हो जाते हैं
औसत यूज़र AI इमेज जनरेटर को सर्च इंजन की तरह इस्तेमाल करता है। वह कुछ शब्द टाइप करता है और उम्मीद करता है कि मॉडल अंदाज़ा लगा ले कि उसका मतलब क्या है। मॉडल अंदाज़ा लगाता है, और उन शब्दों से मेल खाने वाली हर चीज़ का औसत निकाल देता है जो उसने कभी देखी है।
नतीजा तकनीकी रूप से सही होता है, लेकिन रचनात्मक रूप से बेजान।
विवरण का जाल
जब आप लिखते हैं "कैफ़े में बैठा एक आदमी," तो आप एक श्रेणी का वर्णन कर रहे होते हैं, किसी दृश्य का नहीं। मॉडल को हर खाली जगह भरनी पड़ती है: उसकी उम्र, उसका भाव, रोशनी, कैमरे का एंगल, वह हाथों से क्या कर रहा है, और पृष्ठभूमि तेज़ है या धुंधली। वह उन खाली जगहों को सांख्यिकीय रूप से सबसे आम जवाबों से भर देता है।
इसीलिए इतनी सारी AI इमेज एक जैसी दिखती हैं। मॉडल आलसी नहीं है। वह औसत के बारे में सटीक है।
प्रो क्या अलग करते हैं
प्रो क्रिएटर्स विवरण नहीं देते। वे निर्देश देते हैं। वे हर फ़ैसले का गैप बंद कर देते हैं, इससे पहले कि मॉडल उसे औसत में बदल दे।
वे बताते हैं: कैमरे का एंगल, लेंस की फ़ोकल लेंथ, रोशनी की दिशा, कपड़े की बनावट, सब्जेक्ट की भावनात्मक स्थिति। ऐसा वे अपनी तकनीकी जानकारी दिखाने के लिए नहीं करते, बल्कि इसलिए कि हर अनिर्दिष्ट विवरण एक ऐसा फ़ैसला है जो एक मशीन को सौंप दिया जाता है, जो डिफ़ॉल्ट रूप से औसत चुनती है।
नीचे दिए 3 हैक्स आपको हर बार इन गैप्स को व्यवस्थित तरीके से बंद करने का ढाँचा देते हैं।
हैक #1: सीन एंकर
सीन एंकर आपके प्रॉम्प्ट में एक ठोस भौतिक विवरण है, जो सब्जेक्ट और माहौल के बीच के स्थानिक संबंध को तय करता है। यह तकनीकी लगता है। व्यवहार में, यह एक वाक्यांश है जो बाकी सब कुछ अपनी जगह पर बैठा देता है।
इसके बिना कंपोज़िशन क्यों बिगड़ता है
सीन एंकर के बिना, मॉडल के पास कोई तय स्थानिक संदर्भ नहीं होता। आपका सब्जेक्ट थोड़ा केंद्र से हटकर तैर सकता है, क्षितिज अजीब ऊँचाई पर आ सकता है, पृष्ठभूमि अग्रभूमि में ऐसे घुल सकती है जो गलत लगती है, भले ही उसका नाम आसानी से न लिया जा सके।
सीन एंकर मॉडल को एक भौतिक नियम देता है जिसके चारों ओर बाकी सब कुछ व्यवस्थित हो। किसी भी प्रॉम्प्ट में आप जो सबसे ज़्यादा असर डालने वाला शब्द जोड़ सकते हैं, वह यही है।
सीन एंकर कैसे लिखें
फ़ॉर्मूला सरल है: [सब्जेक्ट] + [स्थिति] + [पर्यावरण का कोई विवरण]।
उदाहरण:
- "पत्थर के घाट के सबसे दूर वाले किनारे पर खड़ी महिला, समुद्र का क्षितिज फ़्रेम के निचले एक-तिहाई हिस्से पर"
- "मेहराबदार दरवाज़े के बाएँ हिस्से से टिका आदमी, दाएँ कंधे के पीछे दिखता आँगन"
- "चौड़ी संगमरमर की सीढ़ी की सबसे नीचे वाली सीढ़ी पर बैठा बच्चा, पीछे ऊपर की ओर जाती बाकी सीढ़ियाँ"
ध्यान दें कि हर एक उदाहरण मॉडल को सटीक बताता है कि फ़्रेम में सब्जेक्ट कहाँ है, किसी भौतिक चीज़ के सापेक्ष। यह एक फ़ैसला सही क्षितिज की जगह, पृष्ठभूमि की गहराई और कंपोज़िशन के संतुलन तक एक-दूसरे से जुड़ जाता है।
काम करने वाले सीन एंकर उदाहरण
| कमज़ोर प्रॉम्प्ट | सीन एंकर जोड़ने के बाद |
|---|
| "समुद्र तट पर महिला" | "किनारे पर खड़ी महिला, उसके पैरों के ठीक पीछे टूटती लहरें, क्षितिज निचले एक-तिहाई हिस्से पर" |
| "जंगल में आदमी" | "एक चौड़े ओक के पेड़ की जड़ से टिका आदमी, उसके बाएँ कंधे के पीछे दूर जाता जंगल का रास्ता" |
| "शहर में जोड़ा" | "सड़क की बत्तियों की मेहराबदार कतार के नीचे चलता जोड़ा, पृष्ठभूमि की ओर सिमटती कोबलस्टोन सड़क" |
💡 सबसे पहले अपना सीन एंकर लिखें, बाकी सब कुछ उसके बाद। यह कंपोज़िशन का ढाँचा है जिस पर आपका बाकी प्रॉम्प्ट खड़ा होता है।
जब आप Seedream 4.5 या Wan 2.7 Image Pro जैसे मॉडल इस्तेमाल करते हैं, जो दोनों अल्ट्रा-हाई-रेज़ोल्यूशन 4K आउटपुट सपोर्ट करते हैं, तो मज़बूत सीन एंकर और भी ज़रूरी हो जाता है। इतने रेज़ोल्यूशन पर खराब एंकर वाली कंपोज़िशन तुरंत साफ़ दिख जाती है।
हैक #2: सिनेमैटोग्राफ़र की तरह रोशनी
किसी भी AI इमेज प्रॉम्प्ट में रोशनी सबसे शक्तिशाली वातावरणीय लीवर है। यह सबसे लगातार कम इस्तेमाल होने वाली चीज़ भी है।
ज़्यादातर लोग, अगर रोशनी का ज़िक्र करते भी हैं, तो "गोल्डन आवर" या "सूर्यास्त की रोशनी" लिखकर छोड़ देते हैं। इन शब्दों का अर्थ है, लेकिन ये इतने अस्पष्ट हैं कि मॉडल को अब भी उनकी व्याख्या में भारी छूट मिलती है।
सिनेमैटोग्राफ़र "गोल्डन आवर" नहीं कहते। वे बताते हैं कि रोशनी कहाँ से आ रही है, किस कोण से सब्जेक्ट पर पड़ती है, परछाइयों पर उसका क्या असर होता है, और वह खास सतहों के साथ कैसे मेल खाती है।
लाइटिंग कीवर्ड सब कुछ क्यों बदल देते हैं
एक लाइटिंग डिस्क्रिप्टर दो काम एक साथ करता है। वह मूड तय करता है और दृश्य का भौतिकी नियम भी। जब आप "बाईं ओर से 45 डिग्री पर वॉल्यूमेट्रिक सुबह की रोशनी" कहते हैं, तो आपने मॉडल को बता दिया है:
- कलर टेम्परेचर (ठंडा से न्यूट्रल, सुबह का)
- दिशा (बाईं ओर, 45 डिग्री)
- गुणवत्ता (वॉल्यूमेट्रिक, यानी रोशनी वातावरण या धुंध में दिखती है)
- परछाईं की दिशा (दाईं ओर और थोड़ा नीचे की ओर गिरती हुई)
यह आठ शब्दों में लिए गए चार फ़ैसले हैं। मॉडल को इनमें से किसी का भी अंदाज़ा नहीं लगाना पड़ता।
प्रो सबसे ज़्यादा इस्तेमाल करने वाले 5 लाइटिंग डिस्क्रिप्टर
ये खास वाक्यांश हैं जो हाई-आउटपुट क्रिएटर प्रॉम्प्ट में सबसे ज़्यादा दिखते हैं, साथ में यह कि हर एक असल में क्या करता है:
| डिस्क्रिप्टर | यह क्या करता है |
|---|
volumetric morning light from the left | वातावरणीय धुंध, लंबी क्षैतिज परछाइयाँ, ठंडे-गर्म रंग का संक्रमण बनाता है |
Rembrandt lighting, single key source upper left | परछाईं वाले गाल पर रोशनी के त्रिकोण वाला क्लासिक पोर्ट्रेट पैटर्न, नाटकीय गहराई |
overcast flat fill light, no harsh shadows | समान, नरम, बिना दिशा वाली रोशनी, विवरण-प्रधान सब्जेक्ट के लिए आदर्श |
rim lighting from behind, separating subject from background | सब्जेक्ट के चारों ओर चमकदार रेखा, सिल्हूट और अलगाव पर ज़ोर देती है |
practical window light right, warm amber late afternoon | असली इंटीरियर दृश्य की रोशनी, सतहों पर धूप की क्षैतिज पट्टियाँ |
अपनी रोशनी में बनावट जोड़ना
इस हैक का सबसे उन्नत रूप लाइट डिस्क्रिप्टर को उस सामग्री के साथ जोड़ना है जिस पर वह पड़ती है। यही तकनीकी रूप से सही रेंडर को उस रेंडर से अलग करता है जो फ़ोटो खींची हुई लगता है।
तुलना करें:
- कमज़ोर: "सुनहरी रोशनी"
- मज़बूत: "दोपहर बाद की सुनहरी रोशनी उसकी लिनन जैकेट के बुने हुए कैनवस पर तिरछी पड़ती हुई, हर धागा अलग चमकता हुआ"
दूसरा संस्करण मॉडल को एक बनावट की समस्या हल करने पर मजबूर करता है। नतीजा फ़िल्म पर खींची गई तस्वीर जैसा दिखता है, सॉफ़्टवेयर से बनी चीज़ जैसा नहीं।
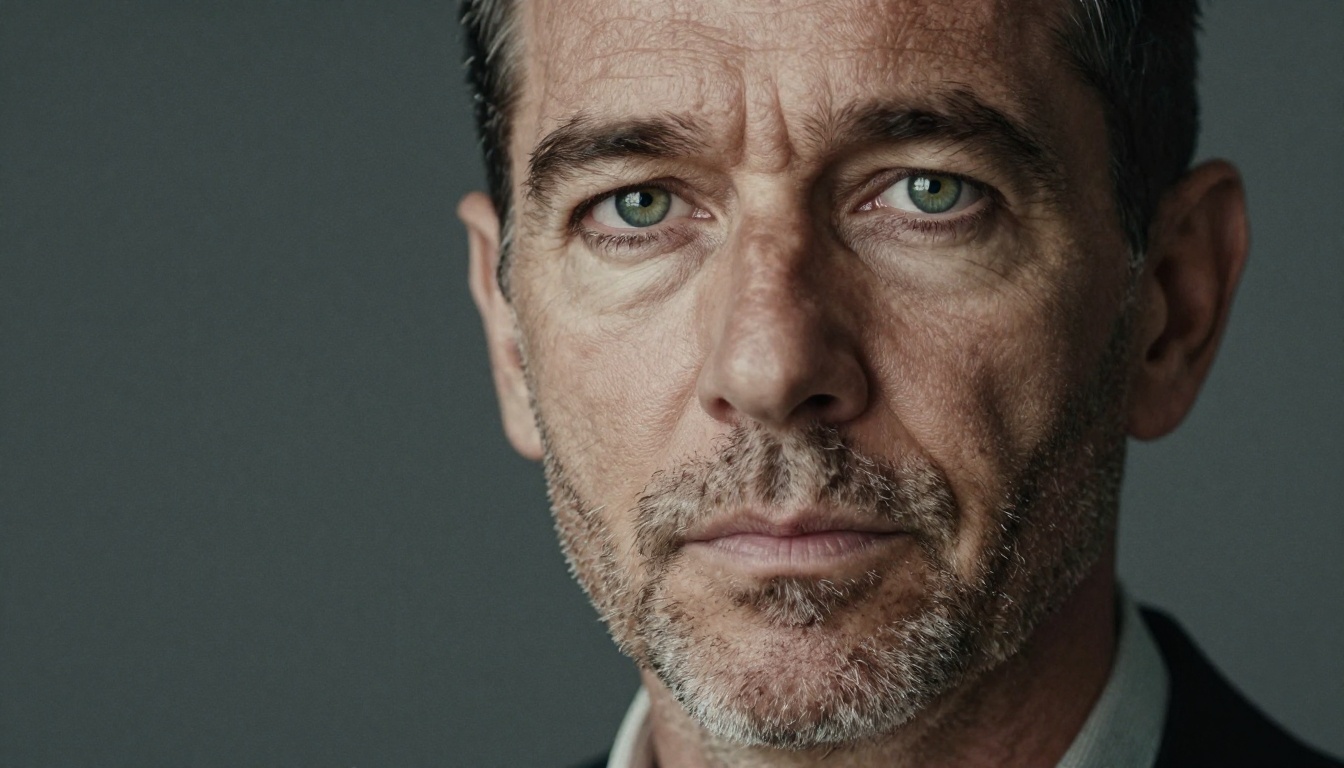
💡 हर लाइटिंग डिस्क्रिप्टर के साथ एक सतह का विवरण जोड़ें। "खुरदुरी ईंट की दीवार पर तिरछी पड़ती गर्म एम्बर रोशनी" मॉडल को रोशनी का स्रोत और उसे रेंडर करने के लिए एक सामग्री, दोनों देती है।
GPT Image 2 और Hunyuan Image 2.1 जैसे मॉडल जटिल लाइटिंग निर्देशों को उच्च सटीकता से संभालते हैं। दोनों को बड़े फ़ोटोग्राफ़िक डेटासेट पर प्रशिक्षित किया गया है और वे सिनेमैटोग्राफ़िक भाषा का प्रभावशाली सटीकता से जवाब देते हैं।
हैक #3: Subject-Action-Context फ़ॉर्मूला
तीसरा हैक प्रॉम्प्ट की संरचना के बारे में है। ज़्यादातर लोग प्रॉम्प्ट को विशेषणों की सूची की तरह लिखते हैं। प्रो उन्हें कहानी के टुकड़े की तरह लिखते हैं।
Subject-Action-Context फ़ॉर्मूला, या SAC, आपके प्रॉम्प्ट को उसी तरह संरचित करता है जिस तरह एक फ़ोटो असल में कंपोज़ होती है: कौन क्या कर रहा है, और ठीक इसी पल में वह कहाँ है।
SAC फ़ॉर्मूला का विश्लेषण
Subject: छवि का फ़ोकस कौन या क्या है। उम्र, शारीरिक विवरण, कपड़े की बनावट और भावनात्मक स्थिति के बारे में साफ़-साफ़ बताएँ।
Action: सब्जेक्ट अभी क्या कर रहा है। एक्शन पोज़, ऊर्जा के स्तर और अक्सर कंपोज़िशन के तनाव को तय करता है।
Context: माहौल, रोशनी, कैमरे का एंगल, लेंस का चुनाव और सहायक दृश्य विवरण।
व्यवहार में यह फ़ॉर्मूला इस तरह दिखता है:
[Specific Subject] + [Precise Action] + [Detailed Context]
ज़्यादातर लोग प्रॉम्प्ट गलत क्रम में लिखते हैं। वे जगह से शुरू करते हैं, फिर सब्जेक्ट जोड़ते हैं, और एक्शन को बिल्कुल भूल जाते हैं। SAC आपको एक चेकलिस्ट देता है, जो यह भी बताती है कि अच्छी फ़ोटोग्राफ़ी कैसे वर्णित की जाती है।
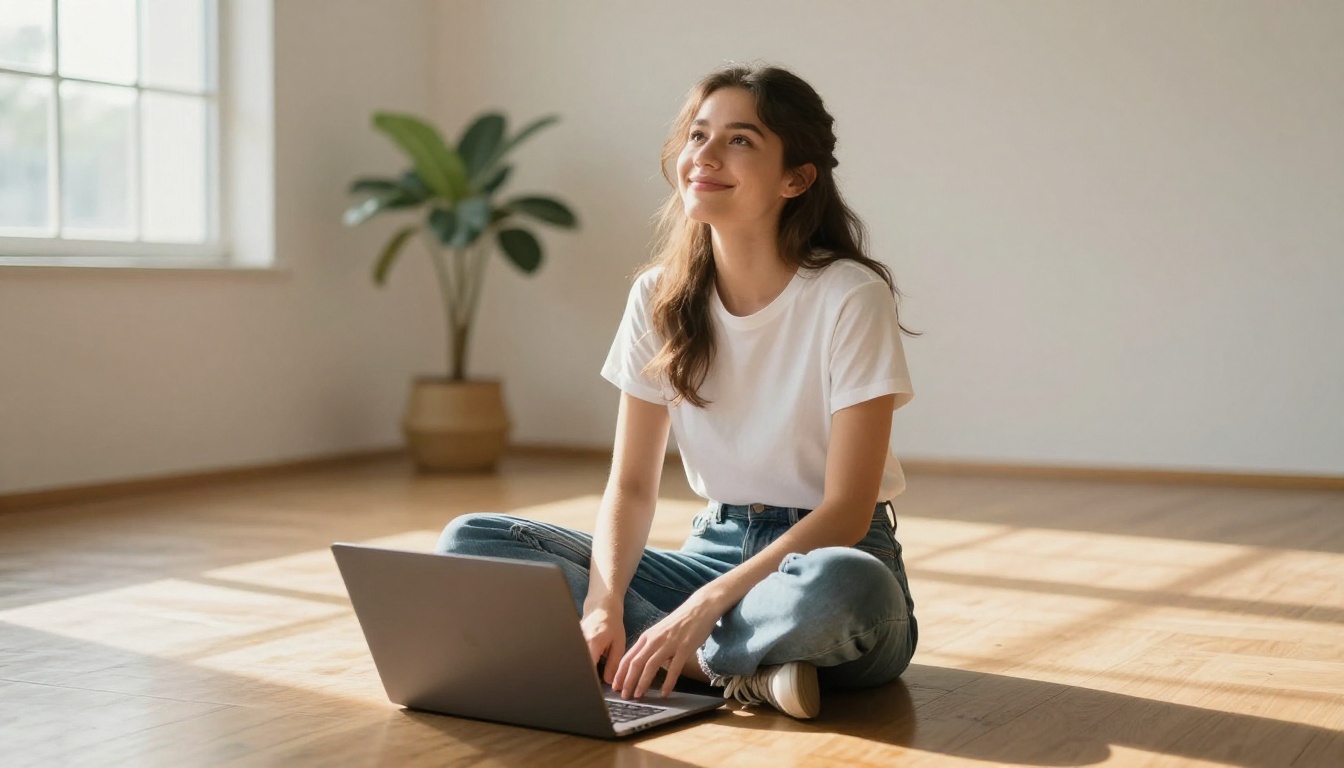
पहले और बाद में: SAC का असर
यहाँ दिखाया गया है कि एक ही इमेज SAC के साथ और उसके बिना लिखे जाने पर कैसी दिखती है:
SAC के बिना:
"रात में टोक्यो के एक बाज़ार में एक महिला"
SAC के साथ:
"काली बारिश वाली जैकेट पहने 30 के आसपास की एक जापानी महिला, जिसके हाथ में ताज़ी सब्ज़ियों की बाँस की टोकरी है [Subject], एक विक्रेता की लालटेनों को देखने के लिए कदम के बीच रुकी हुई, एक हाथ से चेहरे पर गिरती बारिश को रोकती हुई [Action], बारिश से चिकनी कोबलस्टोन वाली बाज़ार की गली, शाम के धुंधलके में, नूडल के ठेलों से उठती भाप, ऊपर लटकती कागज़ की लालटेनें, 24mm वाइड एंगल, f/4, Fuji Velvia कलर प्रोफ़ाइल [Context]"
SAC वाला संस्करण लगभग हर फ़ैसला हटा देता है जो मॉडल अपने आप लेता। नतीजा कोई तुक्के से मिला परिणाम नहीं है। यह निर्देशित परिणाम है।
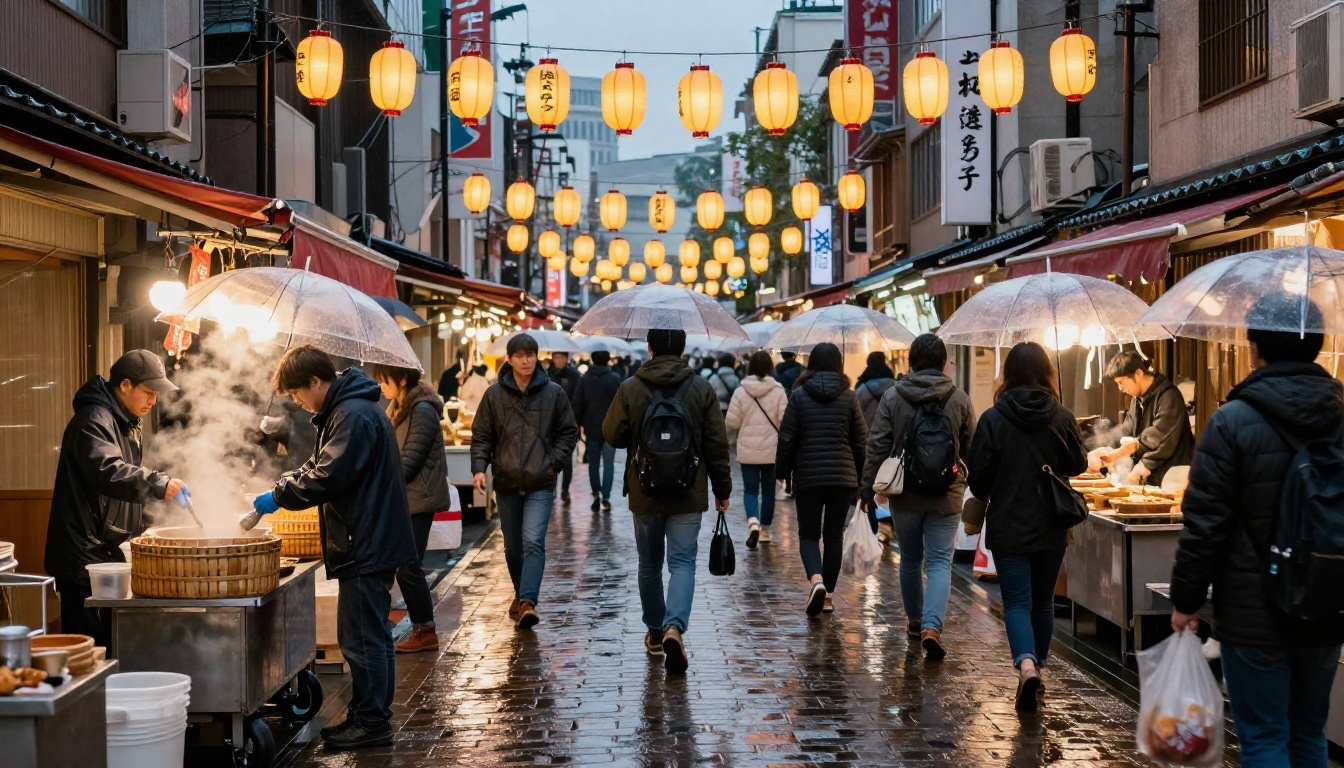
अलग-अलग मॉडल पर SAC लागू करना
PicassoIA पर अलग-अलग मॉडल SAC पर थोड़ी अलग प्रतिक्रिया देते हैं, जिसे जानना उपयोगी है:
| मॉडल | SAC ट्यूनिंग नोट |
|---|
| GPT Image 2 | प्राकृतिक भाषा पर बहुत अच्छी प्रतिक्रिया। SAC संरचना में पूरे वाक्य अच्छे काम करते हैं |
| Flux 2 Klein 9B | SAC आधार के बाद कॉमा से अलग तकनीकी डिस्क्रिप्टर पर अच्छी प्रतिक्रिया |
| Flux 2 Klein 4B | तेज़ जनरेशन। SAC को छोटा रखें, Subject और Action को प्राथमिकता दें |
| Wan 2.7 Image Pro | वातावरणीय Context में उत्कृष्ट, SAC के C पर ज़्यादा ज़ोर दें |
| Seedream 4.5 | मज़बूत सौंदर्य व्याख्या, Subject के विवरण का सबसे ज़्यादा वज़न होता है |
💡 अपना SAC प्रॉम्प्ट पहले बिना किसी स्टाइल मॉडिफ़ायर के आज़माएँ। देखें कि सिर्फ़ उसकी संरचना पर क्या बनता है। फिर बनावट और रोशनी की परतें जोड़ें ताकि वह आपकी सटीक कल्पना की ओर बढ़े।
कमज़ोर बनाम मज़बूत: पूरी प्रॉम्प्ट तुलना
यहाँ देखें कि सभी 3 हैक्स मिलकर एक असली पहले-और-बाद के उदाहरण में कैसे काम करते हैं:
कमज़ोर प्रॉम्प्ट (ज़्यादातर लोग जो लिखते हैं):
"सूर्यास्त के समय शहर में हँसते दो दोस्त"
मज़बूत प्रॉम्प्ट (सभी 3 हैक्स लागू):
सीन एंकर: "छत की टेरेस पर खड़ी 20 के आखिरी वर्षों की दो महिलाएँ, दूर की पृष्ठभूमि में शहर की स्काईलाइन हल्की धुंधली"
लाइटिंग: "दाईं ओर से दोपहर बाद की रिम लाइटिंग, गर्म सुनहरी धूप दोनों आकृतियों को उनके पीछे की बोके स्काईलाइन से अलग करती हुई"
SAC: "एक सूरजमुखी रंग के लिनन सुंड्रेस में, एक टेराकोटा रैप टॉप में, दोनों बातचीत के बीच हँसती हुई, सिर थोड़ा एक-दूसरे की ओर झुके हुए, एक के हाथ में गिलास पर संघनन वाला ठंडा पेय, 85mm f/1.8, Kodak Portra 400, 8K फ़ोटोरियलिस्टिक RAW फ़ोटोग्राफ़ी"
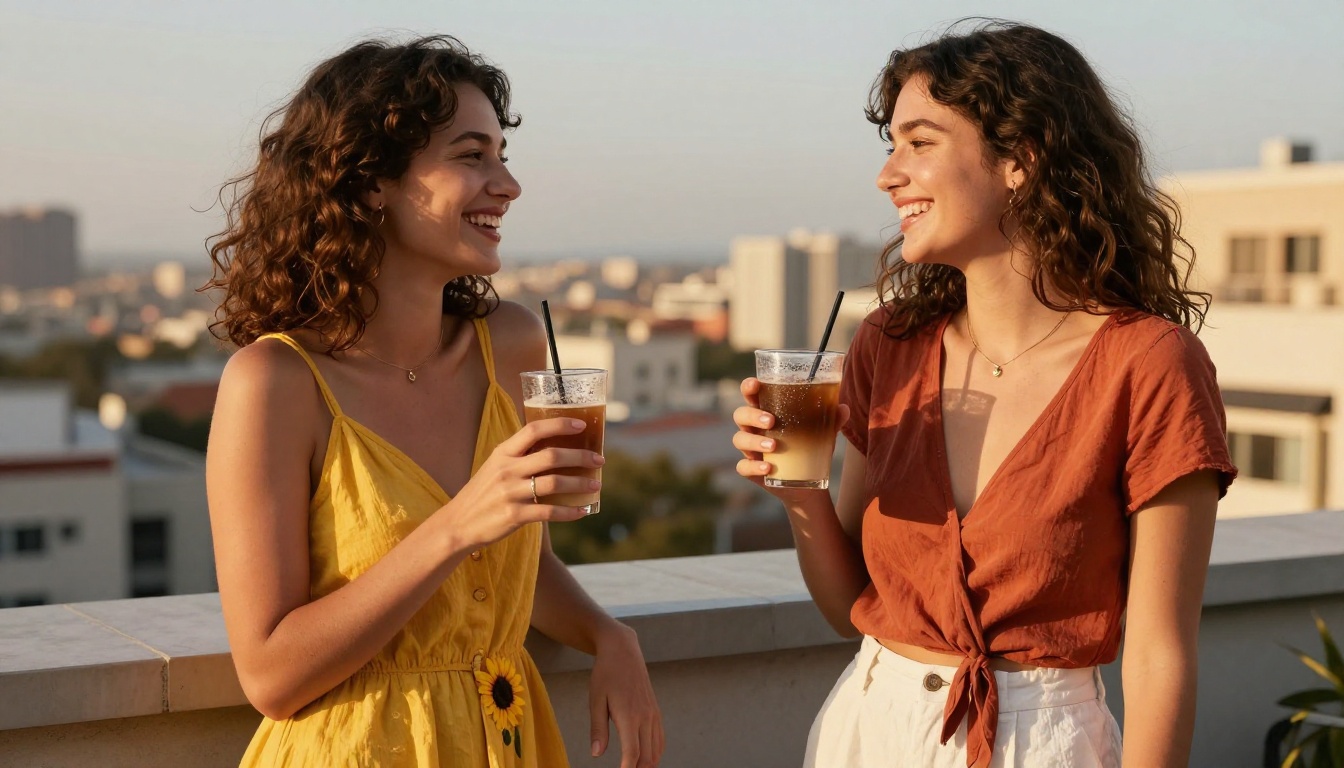
मज़बूत प्रॉम्प्ट का नतीजा सिर्फ़ बेहतर नहीं है। वह पूरी तरह अलग श्रेणी की इमेज है।
PicassoIA मॉडल पर ये हैक्स कैसे इस्तेमाल करें
सभी 3 हैक्स हर टेक्स्ट-टू-इमेज मॉडल पर काम करते हैं, लेकिन PicassoIA पर अलग-अलग मॉडल की खूबियाँ अलग-अलग हैं।
प्राकृतिक भाषा प्रॉम्प्ट के लिए GPT Image 2
GPT Image 2 समृद्ध, वाक्य-संरचना वाले प्रॉम्प्ट को प्रभावशाली स्थिरता के साथ संभालता है। प्राकृतिक भाषा में लिखे सीन एंकर पर यह खास तौर पर अच्छा है और सब्जेक्ट विवरण में भावनात्मक संदर्भ पर अच्छी प्रतिक्रिया देता है। अगर आप अभी इन हैक्स को आज़माना शुरू कर रहे हैं, तो GPT Image 2 एक माफ़ करने वाला और बेहद सक्षम विकल्प है।
स्टाइलाइज़्ड सटीकता के लिए Flux 2 Klein
Flux 2 Klein 9B तकनीकी सटीकता को पुरस्कृत करता है। जब आप बनावट विवरण के साथ लाइटिंग हैक लागू करते हैं, तब यह सबसे अच्छा चमकता है। LoRA आर्किटेक्चर उन स्टाइलों के अनुरूप ढलता है जिन्हें आप अपने प्रॉम्प्ट के डिस्क्रिप्टर से परिभाषित करते हैं, यानी लाइटिंग और बनावट के निर्देश बहुत सटीकता से समझे जाते हैं।
Flux 2 Klein 4B इसका तेज़ साथी है। जब आप पूरी डिटेल वाले जनरेशन रन पर जाने से पहले सीन एंकर से कंपोज़िशन को जल्दी-जल्दी बदल रहे हों, तब यह आदर्श है।
4K वातावरणीय दृश्यों के लिए Wan 2.7 Image Pro
Wan 2.7 Image Pro 4K आउटपुट के लिए बना है, जिससे यह आपके SAC Context ब्लॉक की गुणवत्ता के प्रति खास तौर पर संवेदनशील है। Context वाले हिस्से के वातावरणीय और स्थापत्य विवरण इस रेज़ोल्यूशन पर असाधारण तीखेपन के साथ रेंडर होते हैं, इसलिए वहाँ आप जितने विशिष्ट होंगे, नतीजा उतना ही बेहतर होगा।
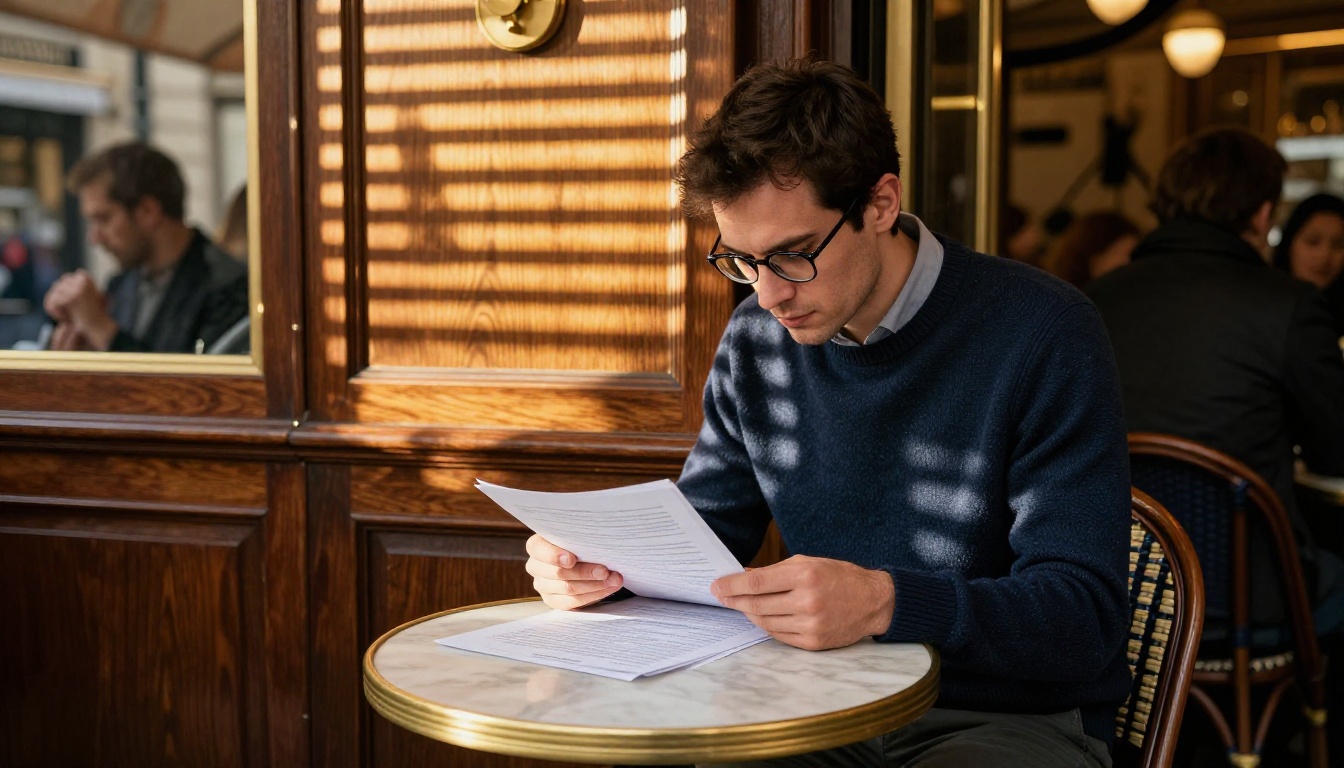
अभी से बेहतर प्रॉम्प्ट लिखना शुरू करें
इन 3 हैक्स का फ़र्क सच में महसूस करने का एकमात्र तरीका यह है कि उन्हें अपने मौजूदा प्रॉम्प्ट के मुकाबले उन्हें आमने-सामने रखकर देखें। PicassoIA पर कोई भी मॉडल खोलें, अपना सामान्य प्रॉम्प्ट लिखें, फिर उसे सीन एंकर, एक खास लाइटिंग डिस्क्रिप्टर और SAC संरचना लागू करके दोबारा लिखें।
दोनों आउटपुट के बीच का अंतर प्रॉम्प्ट लिखने का तरीका बदलने में किसी भी मात्रा की पढ़ाई से ज़्यादा काम करेगा।
PicassoIA पर 91 से ज़्यादा टेक्स्ट-टू-इमेज मॉडल उपलब्ध हैं, जिनमें GPT Image 2, Flux 2 Klein सीरीज़, Seedream 4.5 और Hunyuan Image 2.1 शामिल हैं। इनमें से हर एक अच्छी तरह संरचित प्रॉम्प्ट पर अस्पष्ट विवरणों की तुलना में बेहतर प्रतिक्रिया देता है। ये हैक्स आपको वह संरचना देते हैं।
रचनात्मक दृष्टि आपकी है। आज ही इसके साथ प्रयोग शुरू करें।


