मानव चेहरा शायद दिमाग़ द्वारा प्रोसेस की जाने वाली सबसे जटिल दृश्य वस्तु है। कुछ ही मिलीसेकंड में आप बता सकते हैं कि कोई थका हुआ है, झूठ बोल रहा है, या रोने की कगार पर है। आप खराब रोशनी में भीड़भाड़ वाली सड़क पर भी अपने दोस्त को पहचान लेते हैं। जन्म के दिन से ही आपको अरबों चेहरों पर प्रशिक्षित किया गया है।
AI को यही चीज़ शून्य से शुरू करके कुछ ही दिनों में सीखनी होती है, और उसके पास केवल संख्याएँ होती हैं।
जो एक असंभव शॉर्टकट जैसा लगता है, उसने ऐसे नतीजे दिए हैं जो सिंथेटिक और असली के बीच की रेखा सचमुच धुंधली कर देते हैं। Flux Pro और Stable Diffusion 3.5 Large जैसे मॉडल अब ऐसे पोर्ट्रेट बना सकते हैं जिन्हें देखकर प्रशिक्षित फ़ोटोग्राफ़रों को भी फ़र्क पहचानने में मुश्किल होती है। लेकिन एक गणितीय फ़ंक्शन नाक बनाना कैसे सीखता है? न्यूरल नेटवर्क कैसे समझता है कि आँखें जोड़ों में आती हैं, या कि पूरे मानव चेहरे पर रोशनी लगातार एक जैसा व्यवहार करती है?
यह लेख बताता है कि यह सब असल में कैसे होता है, पहले कच्चे पिक्सल से लेकर तैयार पोर्ट्रेट तक।
AI असल में क्या देखता है
चेहरे नहीं, संख्याएँ
सबसे पहले यह समझना ज़रूरी है कि AI मॉडल को "चेहरे" की कोई अवधारणा नहीं होती। जब वह कोई इमेज प्रोसेस करता है, तो उसे पिक्सल का एक ग्रिड दिखता है। हर पिक्सल तीन संख्याओं से बना होता है, जो 0 से 255 के पैमाने पर लाल, हरे और नीले रंग की तीव्रता बताती हैं। 512x512 की इमेज एक मैट्रिक्स में व्यवस्थित 786,432 संख्याएँ होती हैं।
उस डेटा में कोई नाक नहीं है। कोई भावना नहीं है। कोई पहचान नहीं है। बस संख्याओं की एक बहुत लंबी सूची है।
AI फ़ेस जनरेशन की पूरी चुनौती यह है कि न्यूरल नेटवर्क उन संख्याओं में मौजूद सांख्यिकीय पैटर्न सीखे, जो उन विशेषताओं से मेल खाते हैं जिन्हें एक इंसान चेहरे के रूप में पहचानेगा। नाक हमेशा आँखों और मुँह के बीच दिखती है। एक ही चेहरे पर त्वचा का रंग एक सीमित दायरे में बदलता है। यथार्थवादी ढंग से रोशनी किए गए पोर्ट्रेट में रोशनी हमेशा एक ही दिशा से आती दिखती है।
ये सांख्यिकीय नियमितताएँ हैं। न्यूरल नेटवर्क का काम इन्हें बार-बार के दोहराव से सीखना है, ठीक वैसे जैसे एक बच्चा सैकड़ों कुत्ते देखने के बाद समझ जाता है कि चार पैर और फ़र का मतलब आमतौर पर "कुत्ता" होता है।
मानव चेहरे के पीछे का गणित
इस सीखने की गणितीय रीढ़ एक प्रक्रिया है जिसे बैकप्रॉपगेशन कहते हैं। जब मॉडल कोई अनुमान लगाता है (पिक्सल मानों का एक सेट आउटपुट करता है), तो नतीजे की तुलना उस चीज़ से की जाती है जैसा "असली" चेहरा दिखता है, और त्रुटि की गणना होती है। यह त्रुटि संकेत नेटवर्क में पीछे की ओर बहता है और लाखों आंतरिक पैरामीटरों को उस दिशा में बहुत थोड़ा-सा खिसकाता है जिससे बेहतर नतीजा मिलता।
यह प्रक्रिया लाखों चेहरे वाली इमेज़ों पर अरबों बार दोहराई जाती है, और नेटवर्क मानव चेहरे की ज्यामिति को आत्मसात करने लगता है। ऐसा इसलिए नहीं कि किसी ने उसे बताया कि चेहरा क्या होता है। बल्कि इसलिए कि डेटा के पैटर्नों ने "चेहरा" को संख्याओं का सबसे संभावित विन्यास बना दिया।
ट्रेनिंग डेटा आउटपुट को कैसे आकार देता है
एक कक्षा के रूप में लाखों चेहरे
किसी भी AI फ़ेस मॉडल की गुणवत्ता लगभग पूरी तरह उसके ट्रेनिंग डेटा की गुणवत्ता और मात्रा से तय होती है। बड़े पैमाने के मॉडल दसियों लाख फ़ोटोग्राफ़ वाले डेटासेट पर प्रशिक्षित होते हैं: स्टॉक फ़ोटो, Creative Commons इमेज, चुनिंदा वेब डेटा। अकादमिक चेहरा-अनुसंधान में इस्तेमाल होने वाले कुछ डेटासेट में सैकड़ों मिलियन इमेज होती हैं।
प्रशिक्षण के बाद मॉडल इनमें से कोई भी इमेज दोबारा नहीं देखता। वह जो बनाए रखता है, वह किसी खास चेहरे की याद नहीं, बल्कि इस बात का संपीड़ित सांख्यिकीय मॉडल है कि चेहरे कैसे दिखते हैं। यह संपीड़ित प्रतिनिधित्व उसमें रहता है जिसे शोधकर्ता लेटेंट स्पेस कहते हैं: एक अमूर्त बहु-आयामी निर्देशांक प्रणाली, जहाँ मिलते-जुलते चेहरे एक साथ गुच्छे बनाते हैं, और एक निर्देशांक से दूसरे की ओर बढ़ने पर अनुमानित चेहरा-परिवर्तन होते हैं।
व्यवहार में लेटेंट स्पेस कैसे काम करता है: अगर आप लेटेंट स्पेस में भूरे बालों वाली एक युवा महिला का प्रतिनिधित्व करने वाला बिंदु लें और उसे किसी खास दिशा में खिसकाएँ, तो वह धीरे-धीरे किसी बड़ी उम्र के चेहरे की ओर खिसक सकता है। दूसरी दिशा में बढ़ें तो बालों का रंग बदलता है। तीसरी दिशा में बढ़ें तो चेहरे पर रोशनी गर्म से ठंडी हो जाती है। इस स्पेस की ज्यामिति उन सभी चेहरा-गुणों को दर्ज करती है जिन्हें मॉडल ने अपने ट्रेनिंग डेटा से सीखा है।
जब डेटा पक्षपातपूर्ण हो तो क्या होता है
अगर ट्रेनिंग डेटा किसी एक जनसांख्यिकीय समूह की ओर भारी झुका हो, तो मॉडल उस समूह को दूसरों से ज़्यादा सटीकता से रेंडर करना सीख लेता है। शुरुआती GAN-आधारित मॉडल, जो मुख्यतः हल्की त्वचा वाले सब्जेक्ट्स पर प्रशिक्षित थे, गहरे त्वचा-रंग बनाते समय उल्लेखनीय रूप से कमज़ोर नतीजे देते थे। त्वचा की बनावट, मेलेनिन का प्रकाश बिखेरने का तरीका, आँखों और होंठों के आसपास के खास टोन ग्रेडिएंट: ये सब सीखे गए वितरण में कम प्रतिनिधित्व वाले थे।
समाधान अधिक विविध ट्रेनिंग डेटा और अधिक सोच-समझकर डेटासेट क्यूरेशन है। Flux 1.1 Pro Ultra और Imagen 4 Ultra जैसे आधुनिक मॉडलों ने इस दिशा में काफ़ी प्रगति की है, और पिछली पीढ़ियों की तुलना में मानव विविधता की कहीं व्यापक रेंज में फ़ोटोरियलिस्टिक नतीजे दिए हैं।
GANs: दो नेटवर्क एक-दूसरे से लड़ते हुए
2010 के दशक के बड़े हिस्से और 2020 के दशक की शुरुआत तक AI फ़ेस जनरेशन की प्रमुख आर्किटेक्चर Generative Adversarial Network थी, जिसे संक्षेप में GAN कहते हैं। इसकी अवधारणा, जिसे Ian Goodfellow ने 2014 में पेश किया था, बेहद चतुराई से टकराव पर आधारित है।
जनरेटर का काम
जनरेटर एक न्यूरल नेटवर्क है जो रैंडम नॉइज़ से शुरू करता है और ऐसी इमेज बनाने की कोशिश करता है जो ट्रेनिंग सेट से आई लगे। फ़ेस-जनरेशन के संदर्भ में, वह केवल संख्याओं के एक रैंडम वेक्टर से एक विश्वसनीय मानव चेहरा बनाने की कोशिश करता है।
प्रशिक्षण के शुरुआती चरणों में वह बुरी तरह विफल होता है। उसके आउटपुट पिघले और धुंधले नॉइज़ जैसे दिखते हैं, जो मोटे तौर पर अंडाकार आकार में व्यवस्थित होते हैं। किसी चेहरे से उनका कोई मेल नहीं होता। लेकिन उसका एक शिक्षक है।
डिस्क्रिमिनेटर की भूमिका
डिस्क्रिमिनेटर एक दूसरा न्यूरल नेटवर्क है, जिसे असली फ़ोटो और जनरेटर द्वारा बनाई गई नकली फ़ोटो के बीच फ़र्क करना सिखाया जाता है। उसे असली ट्रेनिंग इमेज और सिंथेटिक आउटपुट का मिश्रण मिलता है, और वह उन्हें वर्गीकृत करना सीखता है।
यहाँ मुख्य गतिशीलता यह है: जनरेटर का पूरा लक्ष्य डिस्क्रिमिनेटर को धोखा देना है। डिस्क्रिमिनेटर का लक्ष्य धोखा न खाना है। जैसे-जैसे दोनों नेटवर्क एक साथ बेहतर होते हैं, वे एक-दूसरे को ऊँचे प्रदर्शन की ओर धकेलते हैं। जनरेटर लगातार यथार्थवादी चेहरे बनाता है, क्योंकि लगातार बेहतर होते डिस्क्रिमिनेटर को धोखा देने का एकमात्र तरीका लगातार बेहतर नकली चीज़ें बनाना है।
यह प्रतिकूल ट्रेनिंग लूप, जो लाखों इटरेशन में चलता है, वही तरीका है जिससे StyleGAN जैसे सिस्टम ऐसे पोर्ट्रेट बनाना सीख गए जिन्होंने अपने रिलीज़ के समय दुनिया को चौंका दिया था।
| GAN घटक | भूमिका | विफलता का तरीका |
|---|
| जनरेटर | नॉइज़ से नकली इमेज बनाता है | मोड कोलैप्स: केवल कुछ ही चेहरे के प्रकार बनाता है |
| डिस्क्रिमिनेटर | असली बनाम नकली को वर्गीकृत करता है | ओवरफ़िटिंग: ट्रेनिंग इमेज को रट लेता है |
| ट्रेनिंग लूप | दोनों नेटवर्क एक साथ बेहतर होते हैं | अस्थिरता: एक नेटवर्क दूसरे पर हावी हो जाता है |
डिफ्यूज़न मॉडलों ने सब कुछ बदल दिया
लगभग 2021 से 2022 तक चेहरा-संश्लेषण पर GAN का दबदबा रहा, जब एक अलग आर्किटेक्चर ने चौंकाने वाले रूप से बेहतर नतीजे देना शुरू किया: डिफ्यूज़न मॉडल।
नॉइज़ से चेहरे तक
डिफ्यूज़न प्रक्रिया उस तरह से उलटी चलती है जैसी आप शायद सोचें। शून्य से चेहरा बनाने के लिए मॉडल को प्रशिक्षित करने के बजाय, डिफ्यूज़न मॉडल को नॉइज़ हटाना सिखाता है।
प्रशिक्षण के दौरान, असली चेहरे वाली इमेज में व्यवस्थित रूप से कई चरणों में रैंडम गाऊसी नॉइज़ जोड़ा जाता है, जिससे वह बिगड़ती है। मॉडल हर चरण पर इस नॉइज़ का अनुमान लगाना और हटाना सीखता है, और मूल इमेज को बहाल करता है। हज़ारों ट्रेनिंग इटरेशन के बाद, मॉडल इस डीनॉइज़िंग कार्य में असाधारण रूप से अच्छा हो जाता है।
इनफ़रेंस के समय प्रक्रिया उलटी चलती है: शुद्ध रैंडम नॉइज़ से शुरू करें, डीनॉइज़िंग मॉडल को बार-बार लागू करें, और अराजकता से धीरे-धीरे एक सुसंगत इमेज उभरती है। टेक्स्ट प्रॉम्प्ट यह तय करने में मदद करता है कि डीनॉइज़िंग लेटेंट स्पेस में किस दिशा में चले, और उभरती इमेज को किसी और विन्यास के बजाय "लाल बालों और नीली आँखों वाली महिला का फ़ोटोरियलिस्टिक पोर्ट्रेट" की ओर धकेलता है।
चेहरों के लिए डिफ्यूज़न GANs से बेहतर क्यों है
| पहलू | GAN | डिफ्यूज़न मॉडल |
|---|
| इमेज विविधता | मोड कोलैप्स से सीमित | उच्च: पूरे सीखे गए वितरण से सैंपल लेता है |
| ट्रेनिंग स्थिरता | कुख्यात रूप से अस्थिर | अधिक पूर्वानुमेय, दोहराने योग्य |
| फ़ोटोरियलिज़्म | मज़बूत, पर आर्टिफ़ैक्ट आम | बेहतर सूक्ष्म विवरण और बनावट |
| प्रॉम्प्ट नियंत्रण | अलग टेक्स्ट एन्कोडर चाहिए | टेक्स्ट गाइडेंस अंतर्निहित |
| चेहरे की शरीर-रचना की सटीकता | टूटी हुई ज्यामिति बना सकता है | अधिक सुसंगत द्विपक्षीय समरूपता |
मुख्य अंतर्दृष्टि: डिफ्यूज़न मॉडल केवल यह नहीं सीखते कि चेहरे कैसे दिखते हैं। वे सभी संभव चेहरों का प्रायिकता वितरण सीखते हैं, जो इस बात से भारित होता है कि हर विन्यास सांख्यिकीय रूप से कितना "असली" है। यही कारण है कि Flux Dev जैसे मॉडल एक ही प्रॉम्प्ट से भी विविध, दोहराव-रहित नतीजे देते हैं: हर जनरेशन उसी सीखे गए वितरण से एक नया सैंपल होता है।
वे कठिन हिस्से जिन्हें AI अब भी गलत करता है
हाथ, दाँत और छोटे विवरण
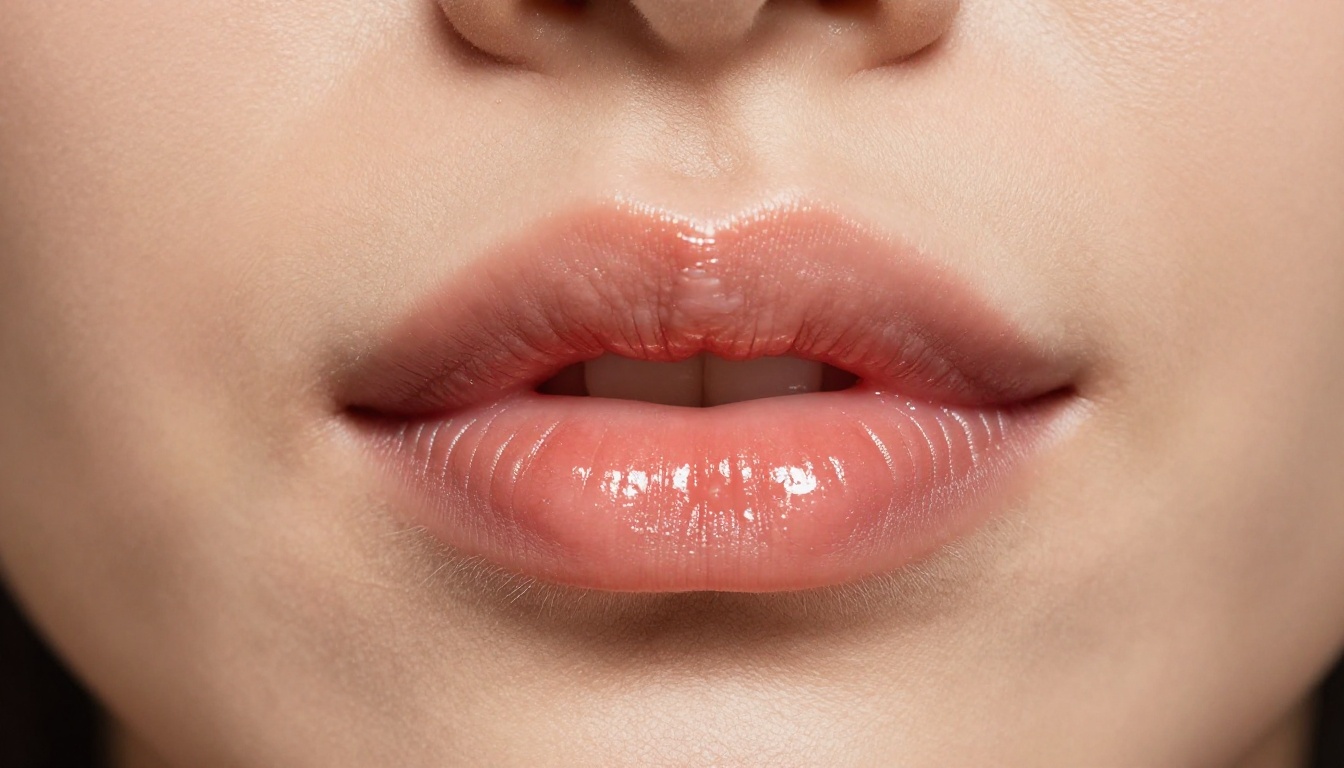
उल्लेखनीय प्रगति के बावजूद, AI फ़ेस जनरेशन में लगातार कुछ कमज़ोरियाँ बनी हुई हैं। खुले मुँह के अंदर के दाँत कुख्यात रूप से कठिन हैं: मॉडल को ऐसी ज्यामितीय रूप से सुसंगत, अलग-अलग आकार वाली वस्तुएँ बनानी होती हैं जो त्रि-आयामी स्थान में जबड़े की वक्रता का पालन करें। शुरुआती मॉडल लगातार धुंधले, पिघले या गलत तरीके से गुणित दाँत बनाते थे।
कान की बालियाँ और छोटे गहने इससे मिलती-जुलती चुनौती पेश करते हैं। ये छोटी, सममित वस्तुएँ हैं जिन्हें चेहरे के दोनों ओर बिल्कुल तय बिंदुओं पर जोड़े में होना चाहिए। ज़रूरी स्थानिक तर्क छोटे पैमाने पर अक्सर टूट जाता है, जिससे बेमेल या विकृत एक्सेसरी बनते हैं।
हाथ, जो स्वयं चेहरे का हिस्सा नहीं हैं, AI इमेज में अब भी सबसे मशहूर विफलता का उदाहरण बने हुए हैं। कारण वही है: उच्च ज्यामितीय जटिलता, छोटा पैमाना, और दर्जनों जोड़दार हिस्सों में सटीक शारीरिक सुसंगति की ज़रूरत।
आँखें जो पूरी तरह मेल नहीं खातीं
मानव आँख एक अत्यंत जटिल संरचना है। आइरिस, पुतली और स्क्लेरा की व्यापक शरीर-रचना के अलावा, कैचलाइट कहलाने वाले प्रकाश-प्रतिबिंब हैं, पलक के किनारों का सटीक आकार है, और सबसे महत्वपूर्ण बात यह कि दोनों आँखों को एक ही दिशा में देखना होता है, और उनके आइरिस का आकार भी मेल खाना चाहिए।
शुरुआती मॉडल अक्सर ऐसी आँखें बनाते थे जो थोड़ी अलग दिशाओं में देखती थीं, या जिनके आइरिस के रंग या आकार बेमेल होते थे। यह अपने सबसे खास रूप में अनकैनी वैली इफ़ेक्ट है: देखने वाला यह बता पाए कि क्या गड़बड़ है, उससे पहले ही चेहरा "गड़बड़" लगने लगता है।
आधुनिक मॉडलों में इसमें नाटकीय सुधार हुआ है। Realistic Vision v5.1 और Seedream 4 जैसे मौजूदा अगुआ अधिकांश प्रॉम्प्ट विन्यासों में लगातार सुसंगत, शारीरिक रूप से मेल खाती आँखें देते हैं, जिनमें जटिल दृष्टि-दिशाएँ और आधी बंद पलकें भी शामिल हैं।
प्रॉम्प्ट चेहरे को कैसे आकार देता है
डिफ्यूज़न मॉडल में टेक्स्ट प्रॉम्प्ट कोई सजावट नहीं है। यह डीनॉइज़िंग प्रक्रिया के लिए सीधा निर्देश है, जो तय करता है कि आउटपुट लेटेंट स्पेस के किन क्षेत्रों से बनाया जाए। एक भूलने योग्य नतीजे और एक शानदार पोर्ट्रेट के बीच का फ़र्क अक्सर इस बात पर पूरी तरह निर्भर करता है कि प्रॉम्प्ट उस चीज़ का कितनी सटीकता से वर्णन करता है जिसे फ़ोटोग्राफ़र शटर दबाने से पहले सेट करता।
विशिष्टता सब कुछ बदल देती है
अस्पष्ट प्रॉम्प्ट सामान्य चेहरे देते हैं। विशिष्ट प्रॉम्प्ट विशिष्ट चेहरे देते हैं।
इन दो प्रॉम्प्ट की तुलना करें:
- अस्पष्ट: "एक महिला का पोर्ट्रेट"
- विशिष्ट: "उम्र 30 के दशक के आख़िरी सालों की, जैतूनी त्वचा और गहरी भूरी आँखों वाली एक महिला का क्लोज़-अप पोर्ट्रेट, हल्की हँसी की रेखाओं के साथ, 85mm लेंस से गोल्डन आफ़्टरनून रोशनी में शूट किया गया, Kodak Portra फ़िल्म ग्रेन, कैमरे की बाईं ओर से Rembrandt लाइटिंग"
दूसरा प्रॉम्प्ट केवल विषय का वर्णन नहीं करता। वह रोशनी, कैमरा सेटअप, फ़िल्म स्टॉक और भावनात्मक मूड का भी वर्णन करता है। चूँकि मॉडल ने इन सभी विशेषताओं वाली लाखों असली फ़ोटो से सीखा है, इसलिए हर अतिरिक्त विशिष्ट विवरण उस लेटेंट स्पेस के क्षेत्र को संकुचित करता है जिससे सैंपल लिया जा रहा है, और एक अधिक सुसंगत, सोच-समझकर बनाया गया नतीजा देता है।
नेगेटिव प्रॉम्प्ट की भूमिका
अधिकांश आधुनिक फ़ेस जनरेशन मॉडल नेगेटिव प्रॉम्प्ट स्वीकार करते हैं: ऐसा टेक्स्ट जो बताता है कि आप क्या नहीं चाहते। फ़ेस जनरेशन के लिए आम प्रविष्टियों में शामिल हैं:
blurry, out of focus नरम या धुंधली चेहरे की विशेषताओं को कम करता हैdeformed, asymmetrical शारीरिक त्रुटियों को कम करता हैplastic, smooth, artificial skin त्वचा की प्राकृतिक बनावट को बनाए रखता हैwatermark, text ऊपर से चिपकाए गए तत्वों को हटाता हैextra teeth, mismatched eyes विशेष शारीरिक विफलताओं को निशाना बनाता है
कुशलता से इस्तेमाल किए जाने पर नेगेटिव प्रॉम्प्ट सकारात्मक प्रॉम्प्ट जितने ही शक्तिशाली होते हैं। वे संभावनाओं को हटाते कम हैं, और उन गुणों से जुड़े लेटेंट स्पेस के क्षेत्रों से प्रायिकता का भार दूर ज़्यादा खिसकाते हैं।
अभी फ़ोटोरियलिस्टिक चेहरे बनाना
PicassoIA आपको सबसे मज़बूत उपलब्ध फ़ेस-जनरेशन मॉडलों तक सीधी पहुँच देता है, बिना लोकल सेटअप और बिना हार्डवेयर की ज़रूरत के। जिन डिफ्यूज़न आर्किटेक्चर का इस्तेमाल पेशेवर स्टूडियो करते हैं, वे ब्राउज़र टैब में उपलब्ध हैं।
सही मॉडल चुनना
आपके लक्ष्य के अनुसार अलग-अलग मॉडलों की फ़ेस जनरेशन में अलग ताकत है:
| मॉडल | सबसे अच्छा किसके लिए | आउटपुट शैली |
|---|
| Flux Pro | फ़ोटोरियलिस्टिक पोर्ट्रेट, जटिल प्रॉम्प्ट | अति-यथार्थवादी त्वचा और रोशनी |
| Flux 1.1 Pro Ultra | 4MP हाई-रिज़ॉल्यूशन चेहरे का विवरण | स्टूडियो-गुणवत्ता की बारीक बनावट |
| Imagen 4 Ultra | प्राकृतिक त्वचा-रंग, रोशनी की सटीकता | फ़ोटोग्राफ़िक प्रामाणिकता |
| Realistic Vision v5.1 | सिनेमैटिक पोर्ट्रेट शैली, फ़िल्म लुक | प्राकृतिक फ़िल्म फ़ोटोग्राफ़ी सौंदर्य |
| Seedream 4 | 4K विवरण, विविध चेहरे के प्रकार | तीखा, जीवंत, उच्च रिज़ॉल्यूशन |
| Flux Schnell | तेज़ इटरेशन, प्रॉम्प्ट परीक्षण | रियल-टाइम गति, मज़बूत गुणवत्ता |
ऐसे प्रॉम्प्ट लिखना जो सच में काम करें
लगातार मज़बूत फ़ेस जनरेशन के लिए इस संरचना का पालन करें:
- सब्जेक्ट: उम्र का दायरा, नस्ल, बालों का रंग, आँखों का रंग, कोई भी पहचान-योग्य विशेषता
- अभिव्यक्ति: सटीक और भावनात्मक, सामान्य नहीं ("आँखों के हल्के सिकुड़न के साथ सूक्ष्म सच्ची मुस्कान" न कि केवल "मुस्कुराते हुए")
- रोशनी: दिशा और गुणवत्ता ("कैमरे की बाईं ओर से वॉल्यूमेट्रिक सुबह की रोशनी, ऑक्टाबॉक्स ब्यूटी लाइटिंग, गोल्डन आवर बैकलाइट")
- कैमरा विवरण: फ़ोकल लेंथ और एपर्चर ("85mm f/1.4", "100mm मैक्रो f/2.8")
- फ़िल्म या कलर ग्रेडिंग: Kodak Portra 400, Fujifilm PRO Neg Hi, गर्म टोन, ठंडी छायाएँ
- गुणवत्ता मॉडिफ़ायर: RAW 8K, फ़ोटोरियलिस्टिक, प्राकृतिक फ़िल्म ग्रेन, त्वचा के रोमकूप की बनावट
प्रॉम्प्ट टिप: आपका प्रॉम्प्ट जितना किसी पेशेवर फ़ोटोग्राफ़र को दिए गए ब्रीफ़ जैसा लगेगा, नतीजा उतना ही फ़ोटोरियलिस्टिक होगा। सोचें "इस शॉट को सेट पर मैं कैसे निर्देशित करूँगा?" न कि "मैं एक तस्वीर का वर्णन कैसे करूँगा?" मॉडल ने असली फ़ोटोग्राफ़ी से सीखा है। उसकी भाषा बोलें।
इमेज के पीछे का डेटा
AI फ़ेस जनरेशन कोई जादू नहीं है। यह विशाल पैमाने पर पैटर्न मिलान है, जो दशकों के शोध से परिष्कृत गणितीय आर्किटेक्चर के भीतर चलता है। मॉडल द्वारा बनाया गया हर पोर्ट्रेट तकनीकी अर्थ में ट्रेनिंग डेटा में देखे गए पैटर्नों से होकर एक इंटरपोलेशन है, जिसे डीनॉइज़िंग प्रक्रिया प्रॉम्प्ट में वर्णित खास विन्यास की ओर निर्देशित करती है।
जो चीज़ इसे जादू जैसा महसूस कराती है, वह है पैमाना: आत्मसात किए गए पैटर्नों की अपार संख्या, वह सटीकता जिससे मॉडल लेटेंट स्पेस में रास्ता खोजता है, और वे असंख्य छोटे विवरण जिस निष्ठा से रेंडर होते हैं और जो मानव चेहरे को जीवंत बनाते हैं।
त्वचा के रोमकूप। स्वाभाविक मुस्कान की असमानता। रोशनी का गालों की हड्डी के चारों ओर लिपटने का खास तरीका। निचले होंठ की ठुड्डी पर पड़ने वाली हल्की छाया। वह सटीक कोण जिस पर आइरिस कैचलाइट पकड़ता है। इनमें से कोई भी विशेषता किसी ने मॉडल में स्पष्ट रूप से प्रोग्राम नहीं की। ये उभरी हैं, क्योंकि मॉडल को इतने उदाहरण दिखाए गए कि उसने इन्हें अपेक्षित करना सीखा, और फिर इन्हें बनाना।
यह समझना इस बात को बदल देता है कि आप इन टूल्स का इस्तेमाल कैसे करते हैं। आप किसी रैंडम इमेज मशीन में निर्देश नहीं टाइप कर रहे। आप एक ऐसी प्रणाली को निर्देशांक दे रहे हैं जिसने मानव पोर्ट्रेट-कला की पूरी दृश्य भाषा आत्मसात कर ली है। आप जितनी सटीकता से उन निर्देशांकों का वर्णन करेंगे, वह उन तक उतनी ही सटीकता से पहुँच सकेगा।
इसे अमल में लाएँ
इस लेख का हर चेहरा उन्हीं मॉडलों से बना है जो अभी आपके लिए उपलब्ध हैं। वही लेटेंट स्पेस। वही डीनॉइज़िंग प्रक्रियाएँ। वही आर्किटेक्चर, उसी डेटा पर प्रशिक्षित।
एक सामान्य नतीजे और एक ऐसे पोर्ट्रेट में फ़र्क, जो लोगों को स्क्रॉल करते हुए रोक दे, लगभग पूरी तरह इस पर निर्भर करता है कि आप जो चाहते हैं उसका वर्णन कैसे करते हैं। रोशनी की दिशा। लेंस का चुनाव। फ़िल्म स्टॉक। एक सटीक रूप से वर्णित चेहरे पर सटीक अभिव्यक्ति। अब आप जानते हैं कि यह प्रक्रिया मशीनी स्तर पर कैसे काम करती है, यानी आप ठीक-ठीक जानते हैं कि कौन-से लीवर खींचने हैं।
PicassoIA पर Flux Pro, Imagen 4 Ultra, या Seedream 4 खोलें और इस ज्ञान को काम में लगाएँ। प्रॉम्प्ट को किसी फ़ोटोग्राफ़र के ब्रीफ़ की तरह लिखें। अपने नेगेटिव प्रॉम्प्ट जोड़ें। मॉडल को अपने स्टाइल के लक्ष्य के अनुसार समायोजित करें।
जो चेहरा आपके मन में है, वह पहले से ही लेटेंट स्पेस में कहीं मौजूद है। बस आपको वहाँ तक रास्ता खोजना है।


