किसी AI कैरेक्टर को एक बार सही दिखा लेना भी संतोषजनक होता है। लेकिन उसी कैरेक्टर को 20 अलग-अलग सीन, पोज़ और लाइटिंग में बिल्कुल एक जैसा रखना वह जगह है जहाँ ज़्यादातर लोग अटक जाते हैं। चेहरा बदल जाता है। बालों का रंग बदल जाता है। एक इमेज से दूसरी इमेज में जॉलाइन नरम या तीखी हो जाती है। अगर आपने कभी घंटों एक कैरेक्टर दोबारा बनाने की कोशिश की और अंत में एक दर्जन ऐसे लोग मिले जो बस एक-दूसरे से मिलते-जुलते थे, तो यह गाइड आपके लिए है।
AI कैरेक्टर क्यों बदलते रहते हैं
मूल समस्या मॉडल नहीं है। यह एंट्रॉपी है। AI इमेज जनरेटर स्वभाव से प्रोबेबिलिस्टिक होते हैं, यानी हर जनरेशन में रैंडमनेस शामिल होती है। एक ही प्रॉम्प्ट से भी आप दो बार एक जैसे आउटपुट शायद ही कभी पाएँगे। यही रैंडमनेस AI आर्ट को विविधता देती है, लेकिन यही कैरेक्टर कंसिस्टेंसी को भी नष्ट करती है।
रैंडमनेस की समस्या
जब भी आप जनरेट दबाते हैं, मॉडल एक प्रोबेबिलिटी डिस्ट्रीब्यूशन से सैंपल लेता है। स्पष्ट एंकर के बिना उसे याद नहीं रहता कि आपका कैरेक्टर पहले कैसा दिखता था। उसे यह याद नहीं रहता कि आपके कैरेक्टर की नाक तीखी है या आँखें गहरी धँसी हुई हैं। उसे सिर्फ़ वही पता होता है जो आपके शब्द बताते हैं, और प्राकृतिक भाषा अपने आप में अस्पष्ट होती है।
"भूरे बालों और हरी आँखों वाली एक महिला" जैसा प्रॉम्प्ट लाखों संभावित लोगों का वर्णन करता है। हर बार मॉडल उनमें से एक अलग व्यक्ति चुन लेता है।
कंसिस्टेंसी क्या तोड़ता है
कंसिस्टेंसी बिगाड़ने वाली सबसे आम चीज़ों का ब्योरा यह है:
| समस्या | ऐसा क्यों होता है | समाधान |
|---|
| चेहरे का आकार बदलता है | अस्पष्ट चेहरे के वर्णन | हड्डियों की संरचना के साफ़ विवरण जोड़ें |
| बालों का शेड बदलता है | रंग के नाम व्यक्तिपरक होते हैं | विशिष्ट शब्द इस्तेमाल करें ("chestnut brown") |
| शरीर का अनुपात खिसकता है | कद या बनावट का कोई एंकर नहीं | बनावट साफ़-साफ़ बताएँ |
| स्किन टोन खिसकता है | लाइटिंग से दिखने वाला टोन बदल जाता है | लाइटिंग लॉक करें और अंडरटोन बताएँ |
| आँखों का आकार असंगत है | सामान्य आँख के वर्णन | आकार और झुकाव बताएँ |
कैरेक्टर रेफ़रेंस शीट की विधि
प्रोफ़ेशनल कैरेक्टर डिज़ाइनर दशकों से रेफ़रेंस शीट इस्तेमाल करते आए हैं। AI जनरेशन में यह अवधारणा सीधे लागू होती है। एक भी सीन इमेज जनरेट करने से पहले आप एक कैरेक्टर बाइबल बनाते हैं: आपके कैरेक्टर की हर शारीरिक विशेषता का एक लॉक किया हुआ वर्णन।
अपनी कैरेक्टर बाइबल बनाएँ
इसे अपने कैरेक्टर का DNA समझें। हर ऐसी विशेषता जो एक जैसी रहनी चाहिए, उसे इतनी बारीकी से लिखना होगा कि मॉडल उससे हट न सके। अस्पष्ट वर्णन मॉडल को रचनात्मक छूट देते हैं। सटीक वर्णन उसे बाँध देते हैं।
जितना ज़्यादा विवरण आप देंगे, मॉडल के पास अपनी तरफ़ से कुछ बनाने की उतनी कम जगह होगी।
क्या शामिल करें
एक ठोस कैरेक्टर बाइबल इन विशेषताओं को कवर करती है:
शारीरिक संरचना:
- चेहरे का आकार (oval, heart, square, oblong)
- जॉलाइन की परिभाषा (नरम, तीखी, मज़बूत, अंदर धँसी हुई ठोड़ी)
- गालों की हड्डियों की ऊँचाई (ऊँची, सपाट, चौड़ी)
- माथे की चौड़ाई और ऊँचाई
- नाक के पुल की चौड़ाई और नोक का आकार
- होंठों की भराई और cupid's bow की परिभाषा
रंग:
- एक विवरण के साथ सटीक बालों का रंग ("dark auburn, not burgundy, not brown, specifically warm red-brown")
- विवरण के साथ आँखों का रंग ("pale grey-green with a dark outer ring")
- स्किन अंडरटोन ("warm peachy undertone, light tan, no pink")
विशिष्ट पहचान:
- तिल, मस्से, beauty marks और उनकी जगह
- भौंहों का आकार और घनत्व
- कोई भी असमानता या अनोखी विशेषता
💡 लक्ष्य ऐसा प्रॉम्प्ट बनाना है जिससे सिर्फ़ एक ही व्यक्ति दुनिया में मेल खा सके। अगर आपका कैरेक्टर वर्णन 1,000 अलग-अलग लोगों पर लागू हो सकता है, तो वह अभी काफ़ी साफ़ नहीं है।
सीड लॉकिंग और प्रॉम्प्ट एंकरिंग
कैरेक्टर बाइबल बन जाने के बाद सीड आपका दूसरा सबसे शक्तिशाली टूल बन जाते हैं। सीड एक नंबर है जो AI जनरेशन प्रक्रिया के शुरुआती बिंदु को नियंत्रित करता है। एक ही प्रॉम्प्ट के साथ एक ही सीड इस्तेमाल करने पर एक ही आउटपुट मिलता है। सीड को थोड़ा सा भी बदलें, तो पूरी तरह अलग नतीजा आता है।
सीड कैसे काम करते हैं
सीड को नक्शे पर निर्देशांक समझें। मॉडल का "क्रिएटिव स्पेस" बहुत बड़ा होता है, और सीड उसे बताता है कि शुरू कहाँ से करना है। प्रॉम्प्ट तय करता है कि उस शुरुआती बिंदु से वह किस दिशा में जाएगा। वही निर्देशांक, वही दिशा, यानी हर बार एक ही मंज़िल।
इसीलिए एक ही सेशन में विज़ुअल कंसिस्टेंसी का सबसे तेज़ रास्ता सीड लॉक करना है। अपने कैरेक्टर को एक बार जनरेट करें। एक आउटपुट चुनें जो आपको पसंद हो। सीड नंबर लिख लें। अब आपके पास एक दोहराने योग्य एंकर है।
टाइट कैरेक्टर प्रॉम्प्ट लिखना
अगर आपका प्रॉम्प्ट ढीला है, तो सीड लॉकिंग भी एक हद तक ही काम आएगी। एक टाइट कैरेक्टर प्रॉम्प्ट में ये गुण होते हैं:
- विशिष्टता सामान्यता से बेहतर है - "hooded almond-shaped brown eyes" "brown eyes" से बेहतर है
- नेगेटिव प्रॉम्प्ट मायने रखते हैं - जो नहीं चाहिए उसे साफ़ तौर पर बाहर रखें ("not wide nose, not curly hair")
- कैमरा फ़्रेमिंग एक जैसी रखें - जब भी आपको एक ही चेहरा चाहिए, वही लेंस और एंगल इस्तेमाल करें
- लाइटिंग की दिशा एक जैसी रखें - "soft light from the left, slight shadow on right cheek" को सभी शॉट्स में दोहराएँ
💡 सीन बदलते समय कैरेक्टर प्रॉम्प्ट बिल्कुल वैसा ही रखें। सिर्फ़ वातावरण, बैकग्राउंड और कपड़े बदलें। चेहरे के वर्णन को कभी दोबारा न लिखें।
पहचान खोए बिना अपने कैरेक्टर को एनिमेट करना
एक जैसे कैरेक्टर की स्टिल इमेज जनरेट करना एक चुनौती है। लेकिन उस कैरेक्टर को बिना उसकी पहचान खोए वीडियो में बदलना एक अलग ही स्तर की बात है। यहीं इमेज-टू-वीडियो टूल ज़रूरी हो जाते हैं।
इमेज-टू-वीडियो वर्कफ़्लो
एक जैसे कैरेक्टर को एनिमेट करने का सबसे भरोसेमंद तरीका लॉक की हुई स्टिल इमेज से शुरू करना है। आप अपनी मंज़ूर की गई कैरेक्टर स्टिल जनरेट करते हैं, फिर उस इमेज को सीधे इमेज-टू-वीडियो मॉडल में डालते हैं। वीडियो जनरेशन आपकी इमेज को विज़ुअल रेफ़रेंस के रूप में इस्तेमाल करता है, यानी आपके कैरेक्टर का चेहरा, बाल और अनुपात पहले से तय होते हैं। मॉडल को बस वही एनिमेट करना होता है जो आपने दिया।
टेक्स्ट-टू-वीडियो प्रॉम्प्ट में शुरू से कैरेक्टर का वर्णन करने की तुलना में यह कहीं ज़्यादा भरोसेमंद है।
वर्कफ़्लो:
- कैरेक्टर की स्टिल इमेज जनरेट करें और मंज़ूर करें
- इमेज-टू-वीडियो टूल पर अपलोड करें
- सिर्फ़ एक्शन का मोशन प्रॉम्प्ट लिखें (कैरेक्टर का नहीं)
- आउटपुट देखें और ज़रूरत हो तो दोहराएँ
Wan 2.7 I2V और Wan 2.6 I2V जैसे मॉडल इसके लिए ख़ास तौर पर अच्छे हैं, क्योंकि ये स्रोत इमेज से चेहरे की एकरूपता बनाए रखते हैं और साथ ही सहज, प्राकृतिक मोशन जनरेट करते हैं।
कैरेक्टर एनिमेशन के लिए सबसे अच्छे टूल
ऊँची पहचान-निष्ठा वाले पूरे कैरेक्टर एनिमेशन के लिए, Kling Avatar v2 उपलब्ध सबसे मज़बूत विकल्पों में से एक है। यह एक रेफ़रेंस चेहरा लेकर ऐसा वीडियो बनाता है जिसमें वह चेहरा पूरे मोशन में पहचानने लायक एक जैसा रहता है।
ByteDance का DreamActor M2.0 आपको स्रोत इमेज के स्पष्ट रेफ़रेंस के साथ किसी भी कैरेक्टर को एनिमेट करने देता है। हाव-भाव, सिर की हरकतों और एक्सप्रेशन में बदलाव के दौरान कैरेक्टर अपना रूप बनाए रखता है।
लंबे फ़ॉर्म वाले वीडियो के लिए, जहाँ कैमरा मूवमेंट और सीन ट्रांज़िशन मायने रखते हैं, Kling v3 Video सिनेमैटिक आउटपुट देता है और शॉट-दर-शॉट रेफ़रेंस कैरेक्टर को विज़ुअली सुसंगत रखता है।
| टूल | सबसे अच्छा किसके लिए | पहचान-निष्ठा |
|---|
| Wan 2.7 I2V | प्राकृतिक मूवमेंट, इमेज-आधारित | ऊँची |
| Kling Avatar v2 | चेहरा-लॉक कैरेक्टर वीडियो | बहुत ऊँची |
| DreamActor M2.0 | पूरे शरीर का कैरेक्टर एनिमेशन | ऊँची |
| Kling v3 Video | सिनेमैटिक मल्टी-सीन आउटपुट | ऊँची |
अपस्केलिंग से कैरेक्टर तेज़ दिखता है
कैरेक्टर कंसिस्टेंसी का सबसे अनदेखा हिस्सा रिज़ोल्यूशन की कंसिस्टेंसी है। जब एक इमेज को अपस्केल किया जाए और दूसरी को नहीं, तो शॉट्स के बीच दिखने वाले डिटेल का स्तर बदल जाता है। चेहरा बिल्कुल एक जैसा होने पर भी इससे विज़ुअल असंगति पैदा हो जाती है।
कब अपस्केल करें
एक साथ इस्तेमाल करने से पहले हर कैरेक्टर पोर्ट्रेट को एक ही टार्गेट रिज़ोल्यूशन पर अपस्केल करें। इससे आपकी पूरी कैरेक्टर एसेट लाइब्रेरी में स्किन टेक्सचर, बालों के डिटेल और शार्पनेस एक जैसे रहते हैं।
Crystal Upscaler ख़ास तौर पर पोर्ट्रेट अपस्केलिंग के लिए ट्यून किया गया है। यह चेहरे के डिटेल बढ़ाता है, बिना ऐसे आर्टिफ़िशियल शार्पनिंग आर्टिफ़ैक्ट डाले जो आपके कैरेक्टर का रूप बदल दे। 4x तक सामान्य इमेज अपस्केलिंग के लिए, Real ESRGAN और Google Upscaler क्लोज़-अप और पूरे शरीर वाले शॉट्स दोनों को साफ़ तरीके से संभालते हैं।
💡 वीडियो या कंपोज़िट सीन में इस्तेमाल करने से पहले सभी कैरेक्टर इमेज को एक ही रिज़ोल्यूशन पर बैच-अपस्केल करें। मेल न खाने वाले रिज़ोल्यूशन दर्शकों को तुरंत दिख जाते हैं।
लिपसिंक के साथ बोलते कैरेक्टर
एक कंसिस्टेंट कैरेक्टर तैयार होने के बाद, उसे बोलते हुए दिखाना अगला स्वाभाविक कदम है। लिपसिंक टूल आपके कैरेक्टर वीडियो को एक ऑडियो ट्रैक के साथ होंठों की हरकतों से मिलाते हैं। AI क्रिएटर्स इसी तरह बिना कोई फ़ुटेज रिकॉर्ड किए टॉकिंग अवतार कंटेंट बनाते हैं।
यहाँ सबसे अहम बात यह है कि शुरुआत एक उच्च-गुणवत्ता और उच्च-कंसिस्टेंसी वाले कैरेक्टर वीडियो से हो। धुंधला या असंगत स्रोत धुंधला और असंगत लिपसिंक आउटपुट देगा।
Omni Human 1.5 ख़ास तौर पर एक स्टिल फ़ोटो को पूरे टॉकिंग वीडियो में एनिमेट करने के लिए बनाया गया है। यह आपकी कैरेक्टर इमेज ले सकता है, ऑडियो-संचालित एनिमेशन लागू कर सकता है और एक यथार्थवादी लिप-सिंक्ड आउटपुट दे सकता है। Lipsync 2 Pro के साथ मिलाकर, सटीक ऑडियो एलाइनमेंट के लिए, आप ऐसा टॉकिंग कैरेक्टर कंटेंट बना सकते हैं जो करीबी जाँच में भी टिके।
AI कैरेक्टर के लिए लिपसिंक वर्कफ़्लो:
- कंसिस्टेंट कैरेक्टर की स्टिल जनरेट करें
- इमेज-टू-वीडियो टूल से एनिमेट करें (Wan 2.7 I2V या Kling Avatar v2)
- वीडियो को वॉइस ऑडियो के साथ Omni Human 1.5 में डालें
- अंतिम सिंक की सटीकता के लिए Lipsync 2 Pro लगाएँ
3 गलतियाँ जो कंसिस्टेंसी खत्म कर देती हैं
थ्योरी जानने वाले क्रिएटर्स भी इन जालों में फँस जाते हैं:
गलती 1: हर सीन के लिए कैरेक्टर प्रॉम्प्ट दोबारा लिखना
हर बार जब आप अपना कैरेक्टर वर्णन बदलते हैं, तो ड्रिफ़्ट को न्योता देते हैं। "chestnut brown hair" को "dark brown hair" से बदलने भर से भी आउटपुट खिसक जाएगा। अपने प्रॉम्प्ट का कैरेक्टर वाला हिस्सा फ़्रीज़ रखें। हर बार उसे कॉपी-पेस्ट करें।
गलती 2: एक ही कैरेक्टर के शॉट्स के बीच सीड बदलना
अगर आपको कोई सीड मिल गया है जो आपके कैरेक्टर को सटीक रूप से दिखाता है, तो उसे एक पवित्र नंबर मानें। एक दस्तावेज़ रखें जिसमें आपके कैरेक्टर का नाम, उसका रेफ़रेंस सीड और उसका लॉक किया हुआ प्रॉम्प्ट हो। सीड सिर्फ़ तभी बदलें जब आपको जानबूझकर अलग रूप चाहिए।
गलती 3: अलग-अलग रिज़ोल्यूशन पर जनरेट करना
512x512 पर जनरेट करके फिर अपस्केल किया गया कैरेक्टर उस कैरेक्टर से अलग दिखता है जिसे मूल रूप से 1024x1024 पर जनरेट किया गया हो। शुरुआती जनरेशन रिज़ोल्यूशन इस बात को प्रभावित करता है कि मॉडल डिटेल कैसे बाँटता है। एक रिज़ोल्यूशन चुनें और पूरी कैरेक्टर लाइब्रेरी में उसी पर टिके रहें।
💡 हर कैरेक्टर के लिए एक ही "मास्टर जनरेशन फ़ाइल" रखें: सीड नंबर, सटीक प्रॉम्प्ट टेक्स्ट, रिज़ोल्यूशन, मॉडल वर्ज़न और मंज़ूर रेफ़रेंस इमेज। इसे एक क्रिएटिव अनुबंध की तरह संभालें।
एक जैसे शरीर के अनुपात के लिए पोज़ कंट्रोल
सबसे शक्तिशाली कंसिस्टेंसी तरीकों में से एक पोज़-नियंत्रित जनरेशन है। टेक्स्ट में पोज़ का वर्णन करने के बजाय (जो अस्पष्ट होता है), आप एक स्केलेटन या डेप्थ मैप देते हैं जिसे मॉडल को फ़ॉलो करना होता है। इससे आपका कैरेक्टर ठीक उसी स्थिति में रहता है जिसकी आपको ज़रूरत है, और मॉडल आपके वर्णन की ढीली व्याख्या नहीं करता।
पोज़ कंट्रोल मॉडल को पोज़ के हिसाब से शरीर को धीरे से बदलने से भी रोकता है, और यही उन छिपे तरीकों में से एक है जिनसे कैरेक्टर का अनुपात इमेज-दर-इमेज खिसकता है। लॉक किए गए कैरेक्टर प्रॉम्प्ट और सीड के साथ मिलाने पर, पोज़-नियंत्रित जनरेशन मौजूदा AI टूल्स के साथ सबसे अधिक कंसिस्टेंट परिणाम देता है।
जो क्रिएटर्स एक ही कैरेक्टर को अलग-अलग पोज़ में इमेज की सीरीज़ में बना रहे हैं, उनके लिए प्रॉम्प्ट लॉकिंग में महारत हासिल करने के बाद यह अकेली सबसे प्रभावी तकनीक है।
आपका पहला कंसिस्टेंट कैरेक्टर
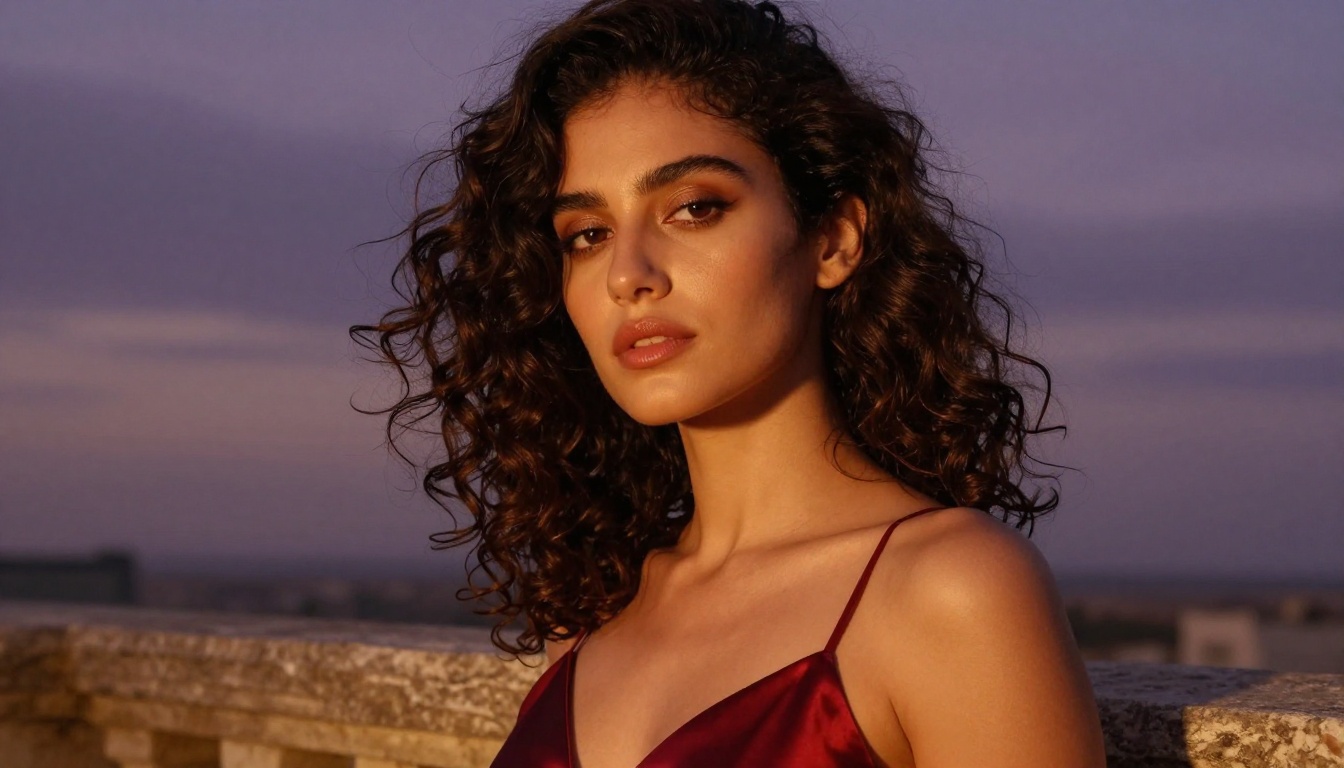
कैरेक्टर कंसिस्टेंसी कोई जादू नहीं है। यह एक पद्धति है। बड़े पैमाने पर कंसिस्टेंट AI कैरेक्टर बनाने वाले क्रिएटर्स आपके पास मौजूद मॉडल से बेहतर मॉडल इस्तेमाल नहीं कर रहे। वे डॉक्यूमेंटेशन, प्रॉम्प्ट की संरचना और वर्कफ़्लो में ज़्यादा अनुशासित हैं।
पूरा सिस्टम एक ही जगह पर यहाँ है:
- कुछ भी जनरेट करने से पहले एक विस्तृत कैरेक्टर बाइबल लिखें
- एक दस्तावेज़ किए गए सीड का इस्तेमाल करके रेफ़रेंस स्टिल जनरेट करें
- अपने प्रॉम्प्ट का कैरेक्टर वाला हिस्सा लॉक करें और उसे कभी दोबारा न लिखें
- मंज़ूर स्टिल से एनिमेट करने के लिए Wan 2.7 I2V जैसे इमेज-टू-वीडियो टूल इस्तेमाल करें
- Crystal Upscaler से सभी एसेट्स को एक ही रिज़ोल्यूशन पर अपस्केल करें
- Omni Human 1.5 से आवाज़ और लिपसिंक जोड़ें
एक कंसिस्टेंट AI कैरेक्टर को जनरेट करने, एनिमेट करने, अपस्केल करने और आवाज़ देने का पूरा टूलचेन एक ही प्लेटफ़ॉर्म पर मौजूद है। अपनी कैरेक्टर रेफ़रेंस इमेज जनरेट करके शुरुआत करें, फिर वर्कफ़्लो का हर चरण पूरा करें। सही सेटअप के साथ, आप बिना कैमरा उठाए पहचानने योग्य, एक जैसे AI कैरेक्टर्स की पूरी कास्ट बना सकते हैं।
PicassoIA पर अपना कैरेक्टर बनाकर देखें और जानें कि एक अनुशासित प्रॉम्प्ट आपको कितनी दूर तक ले जाता है।


