एक फ़ोटो। बस इतना ही। एक अनसेंसर्ड AI वीडियो बनाने के लिए इतना काफ़ी है, जो चलता है, साँस लेता है और ऐसा दिखता है मानो किसी प्रोफ़ेशनल कैमरे से शूट किया गया हो। इमेज-टू-वीडियो AI कंटेंट बनाना पहले कभी इतना आसान नहीं था, और अगर आप जानते हैं कि कौन-से मॉडल चुनने हैं और उन्हें सही तरीके से प्रॉम्प्ट कैसे देना है, तो आपके नतीजे असली फ़ुटेज से अलग नहीं दिखेंगे।
यह केवल सैद्धांतिक बात नहीं है। हज़ारों क्रिएटर पहले से ही रोज़ाना यही कर रहे हैं, पोर्ट्रेट फ़ोटो, ग्लैमर शॉट और आर्टिस्टिक इमेज को सहज, सिनेमाई AI वीडियो क्लिप में बदल रहे हैं। यह प्रक्रिया ज़्यादातर लोगों की उम्मीद से कहीं ज़्यादा तेज़ है, और सही तरीका अपनाने पर क्वालिटी सचमुच प्रभावशाली होती है।
यह ठीक-ठीक ऐसे काम करता है।
इमेज-टू-वीडियो AI असल में क्या करता है
स्थिर फ़ोटो से मोशन क्लिप तक
जब आप किसी फ़ोटो को इमेज-टू-वीडियो AI मॉडल में डालते हैं, तो सिस्टम इमेज को केवल साधारण तरीके से "एनिमेट" नहीं करता। मॉडल स्पेशियल कंपोज़िशन का विश्लेषण करता है: सब्जेक्ट कहाँ है, सीन की गहराई कितनी है, रोशनी किस दिशा से आ रही है, और कपड़ों, बालों व आसपास के माहौल की संभावित भौतिकी क्या है। फिर वह इन सीमाओं के भीतर असली दुनिया जैसी गति का पालन करते हुए फ़्रेम का एक क्रम तैयार करता है।
नतीजा एक छोटा वीडियो क्लिप होता है, आम तौर पर 2 से 8 सेकंड लंबा, जिसमें आपकी मूल फ़ोटो का सब्जेक्ट स्वाभाविक रूप से हिलने लगता है। बालों में हवा से लहर आती है। आँखें झपकती हैं या बगल में देखती हैं। धड़ साँस लेता है। पानी में लहरें उठती हैं। कपड़े लहराते हैं। मूल फ़ोटो में जो गति की जानकारी निहित थी पर दिखाई नहीं देती थी, AI उसे भर देता है।
Seedance 2.0 और LTX-2.3-Pro जैसे आधुनिक इमेज-टू-वीडियो मॉडल यह काम उल्लेखनीय सटीकता से करते हैं। वे सब्जेक्ट के चेहरे की पहचान और शरीर के अनुपात को बनाए रखते हैं और साथ ही सहज, भौतिक रूप से सुसंगत गति जोड़ते हैं।
शुरू करने के लिए एक फ़ोटो क्यों काफ़ी है
पहले के जेनरेशन मॉडल को कई रेफ़रेंस इमेज, सटीक मास्क और जटिल सेटअप वर्कफ़्लो चाहिए थे। आज के शीर्ष इमेज-टू-वीडियो मॉडल को केवल एक इनपुट इमेज चाहिए। AI उसी एक फ़्रेम से पूरी 3D सीन ज्यामिति का अनुमान लगा लेता है।
आपके आउटपुट की गुणवत्ता इस पर कहीं ज़्यादा निर्भर करती है कि आपकी इनपुट फ़ोटो और मोशन प्रॉम्प्ट कितने अच्छे हैं, बजाय इसके कि कितनी सोर्स इमेज हैं। एक अच्छी तरह रोशन, हाई-रेज़ोल्यूशन पोर्ट्रेट तीन धुंधली, खराब कंपोज़ की गई फ़ोटो से बेहतर नतीजे देगा।
💡 प्रो टिप: आँखों की सीध में और प्राकृतिक रोशनी में ली गई फ़ोटो, जिसमें सब्जेक्ट फ़्रेम का ज़्यादातर हिस्सा भरता हो, मॉडल को सबसे ज़्यादा जानकारी देती है। अत्यधिक कोणों या भारी कंप्रेशन आर्टिफ़ैक्ट वाली फ़ोटो से बचें।
सही फ़ोटो चुनना
एक परफ़ेक्ट सोर्स इमेज की पहचान
AI वीडियो जनरेशन के लिए सभी फ़ोटो एक जैसे अच्छे नहीं होते। मॉडल को गहराई, रोशनी और गति की दिशा के बारे में आत्मविश्वास से फ़ैसले लेने के लिए पर्याप्त दृश्य जानकारी चाहिए। निम्नलिखित गुणों वाली फ़ोटो लगातार बेहतर आउटपुट देती हैं:
- सब्जेक्ट का बैकग्राउंड से साफ़ अलगाव (मॉडल को पता होना चाहिए कि क्या चलना चाहिए और क्या स्थिर रहना चाहिए)
- प्राकृतिक, दिशात्मक रोशनी जो किसी प्रकाश स्रोत का संकेत दे (फ़्लैट स्टूडियो लाइटिंग से सपाट, बेजान एनिमेशन बन सकता है)
- मूल फ़ोटो में कम से कम मोशन ब्लर (धुंधले इनपुट मोशन सिंथेसिस को भ्रमित करते हैं)
- उच्च रेज़ोल्यूशन (सबसे छोटी भुजा पर कम से कम 1024px) ताकि बारीक डिटेल साफ़ रहे
- दिखाई देने वाली बॉडी लैंग्वेज जो एक स्वाभाविक पोज़ का संकेत दे जो चलने ही वाला हो
ग्लैमर शॉट, प्रोफ़ेशनल पोर्ट्रेट, बीच फ़ोटो और लाइफ़स्टाइल इमेज बहुत अच्छा प्रदर्शन करती हैं। मॉडल विज़ुअल समृद्धि पर अच्छी प्रतिक्रिया देता है।
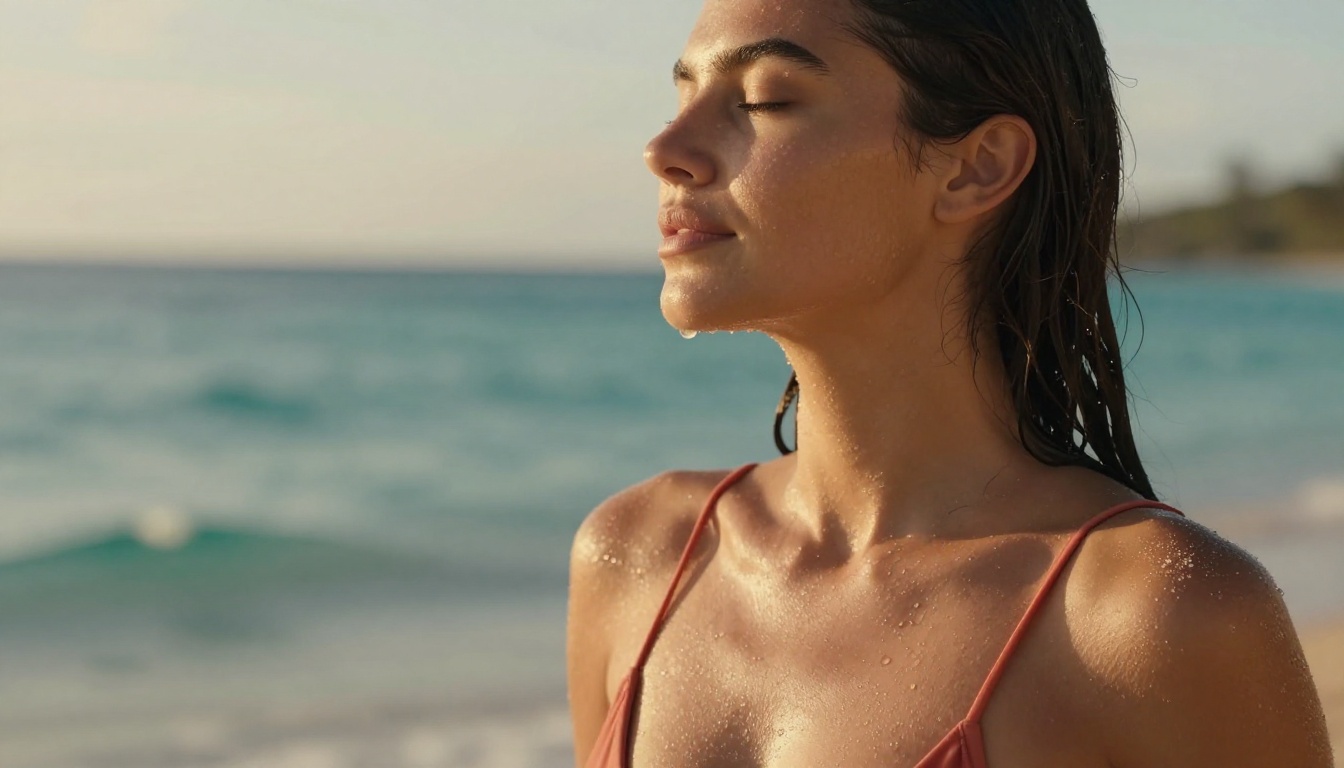
3 गलतियाँ जो आपके नतीजे बिगाड़ देती हैं
गलती 1: बहुत ज़्यादा फ़िल्टर या प्रोसेस की गई इमेज इस्तेमाल करना। Instagram-style कड़े फ़िल्टर, ज़रूरत से ज़्यादा शार्पनिंग या भारी स्किन स्मूदनिंग वह प्राकृतिक टेक्सचर डेटा हटा देते हैं जिसकी AI को ज़रूरत होती है। मॉडल रोम-छिद्रों, बारीक बालों और कपड़े के टेक्सचर को गहराई के संकेत के रूप में पढ़ता है। इन्हें हटा दें तो मोशन प्लास्टिक जैसा और नकली लगता है।
गलती 2: ऐसी फ़ोटो चुनना जिसका बैकग्राउंड बहुत जटिल हो। सब्जेक्ट के पीछे का भीड़भाड़ वाला, व्यस्त बैकग्राउंड मॉडल को यह कठिन फ़ैसला लेने पर मजबूर करता है कि क्या चलेगा और क्या स्थिर रहेगा। एक साफ़, थोड़ा धुंधला बैकग्राउंड (जैसे वाइड एपर्चर से आने वाला प्राकृतिक बोकेह) नतीजों को काफ़ी बेहतर बनाता है।
गलती 3: सब्जेक्ट की नज़र की दिशा को नज़रअंदाज़ करना। अगर आपका सब्जेक्ट पूरी तरह तटस्थ भाव के साथ सीधे कैमरे में देख रहा है, तो मॉडल के पास संभावित गति की दिशा के लिए बहुत कम आधार होता है। सिर का हल्का झुकाव, एक तरफ़ देखती नज़र, या किसी कोण पर घुमा हुआ शरीर AI को एक प्रक्षेपवक्र देता है जिस पर वह काम कर सके।
| फ़ोटो गुणवत्ता कारक | आउटपुट पर असर |
|---|
| प्राकृतिक रोशनी की दिशा | अधिक: छाया की गति और गहराई तय करती है |
| बैकग्राउंड की सादगी | अधिक: किनारों पर आर्टिफ़ैक्ट रोकती है |
| इमेज रेज़ोल्यूशन | मध्यम: बारीक डिटेल की सुरक्षा पर असर |
| सब्जेक्ट का भाव | मध्यम: चेहरे की गति के जेनरेशन का मार्गदर्शन |
| कैमरा कोण | मध्यम: पैरलैक्स सिमुलेशन तय करता है |
इसके लिए सर्वश्रेष्ठ AI मॉडल
इमेज स्वीकार करने वाले टेक्स्ट-टू-वीडियो मॉडल
नाम भ्रमित कर सकते हैं: तकनीकी रूप से ये "टेक्स्ट-टू-वीडियो" मॉडल हैं, लेकिन सबसे अच्छे मॉडल आपके टेक्स्ट प्रॉम्प्ट के साथ एक अतिरिक्त कंडीशनिंग इनपुट के रूप में इमेज भी स्वीकार करते हैं। इमेज शुरुआती फ़्रेम तय करती है, और प्रॉम्प्ट गति का वर्णन करता है।
PicassoIA पर उपलब्ध शीर्ष प्रदर्शन करने वाले मॉडल ये हैं:
Seedance 2.0 इस समय उपलब्ध सबसे मज़बूत इमेज-टू-वीडियो मॉडलों में से एक है। यह बारीक कपड़े की गति और बालों की भौतिकी को बहुत अच्छी तरह संभालता है। नेटिव ऑडियो क्षमता का मतलब है कि यह जेनरेट होने वाली गति के साथ परिवेश की आवाज़ भी सिंक कर सकता है। ग्लैमर और पोर्ट्रेट कंटेंट के लिए यही पहला मॉडल आज़माएँ।
Seedance 2.0 Fast इसका स्पीड-ऑप्टिमाइज़्ड वर्ज़न है। आउटपुट की गुणवत्ता थोड़ी कम होती है, लेकिन जेनरेशन का समय काफ़ी घट जाता है। पूरी गुणवत्ता वाले रन से पहले कई प्रॉम्प्ट वेरिएशन आज़माने के लिए आदर्श।
Gen-4.5 by Runway सब्जेक्ट की निरंतरता में उत्कृष्ट है। यह वीडियो फ़्रेम में चेहरे की पहचान बनाए रखने में खास तौर पर मज़बूत है, जो पोर्ट्रेट या क्लोज़-अप फ़ोटो के साथ काम करते समय बेहद ज़रूरी है, जहाँ चेहरे की डिटेल मायने रखती है।
LTX-2.3-Pro गति की रफ़्तार और स्टाइल पर बेहतरीन नियंत्रण देता है। इसकी प्रॉम्प्ट के पालन की क्षमता खास तौर पर मज़बूत है, यानी आप जो वर्णन करते हैं, वह आउटपुट में वास्तव में होने की संभावना ज़्यादा होती है।
Grok Imagine Video डायनामिक मोशन सीक्वेंस के लिए खास तौर पर मज़बूत है। अगर आपको सूक्ष्म, प्राकृतिक एनिमेशन की बजाय ज़्यादा नाटकीय गति चाहिए, तो यह मॉडल उसे अच्छी तरह संभालता है।
आउटपुट गुणवत्ता की तुलना
अलग-अलग मॉडलों की अलग-अलग ताक़तें हैं। इसे इस तरह समझें:
व्यावहारिक वर्कफ़्लो: अपना प्रॉम्प्ट जाँचने के लिए Seedance 2.0 Fast से शुरू करें, फिर अंतिम आउटपुट के लिए Seedance 2.0 या Gen-4.5 पर जाएँ।
काम करने वाले मोशन प्रॉम्प्ट कैसे लिखें
एक अच्छे मोशन प्रॉम्प्ट की बनावट
आपका मोशन प्रॉम्प्ट इस बात का वर्णन है कि वीडियो में क्या होता है। मॉडल इरादे नहीं पढ़ता, वह निर्देश पढ़ता है। कमज़ोर और मज़बूत प्रॉम्प्ट में अक्सर फ़र्क तीन बातों से आता है: विशिष्टता, भौतिक आधार और मूड।
एक कमज़ोर प्रॉम्प्ट: "woman moving"
एक मज़बूत प्रॉम्प्ट: "woman slowly turns her head from left to right, a warm breeze gently lifts her hair, fabric shifts softly with the movement, eyes close briefly then reopen, soft golden light shifts on her skin"
मज़बूत संस्करण मॉडल को बिल्कुल बताता है कि कौन-से शरीर के अंग चलते हैं, किस दिशा में, किस रफ़्तार से, और कौन-से परिवेश के कारक सिमुलेट करने हैं। हर अतिरिक्त डिटेल एक निर्देश है।
मज़बूत मोशन प्रॉम्प्ट के मुख्य तत्व:
- दिशा: बताएँ कि चीज़ें किस तरफ़ चलती हैं (बाएँ से दाएँ, ऊपर की ओर, कैमरे की ओर)
- रफ़्तार: विशिष्ट विशेषण इस्तेमाल करें ("धीरे", "नरमी से", "तेज़ी से")
- शरीर के अंग: ठीक-ठीक बताएँ कि क्या चलता है (बाल, आँखें, कंधे, कपड़ा)
- परिवेश: आसपास की गति शामिल करें (हवा, रोशनी का बदलाव, पानी की लहर)
- अवधि का एहसास: "धीरे-धीरे" या "हल्का" जैसे शब्द टेम्पो तय करते हैं
नतीजे देने वाले प्रॉम्प्ट के उदाहरण
पोर्ट्रेट और ग्लैमर कंटेंट के लिए ये प्रॉम्प्ट स्ट्रक्चर लगातार उच्च-गुणवत्ता वाले नतीजे देते हैं:
सूक्ष्म, प्राकृतिक गति के लिए:
"Subject breathes naturally, chest rising and falling, eyes blink slowly twice, a gentle breeze moves hair slightly to the right, fabric shifts softly"
अधिक डायनामिक गति के लिए:
"Subject slowly raises one hand to brush hair back from shoulder, turns head slightly toward camera, lips part in a subtle smile, warm light catches the movement"
माहौल और परिवेश के लिए:
"Warm sunlight shifts slightly as clouds pass, dappled light plays across skin and fabric, background foliage sways gently in a soft breeze, subject's gaze moves slowly from distance to camera"
💡 टिप: ऐसे प्रॉम्प्ट से बचें जो असंभव भौतिकी का वर्णन करें या सब्जेक्ट के मूल रूप में बदलाव माँगें। मॉडल आपकी फ़ोटो को एनिमेट कर रहा है, कोई नया किरदार नहीं बना रहा।
PicassoIA पर अपना वीडियो कैसे बनाएँ
चरण 1: अपनी इमेज अपलोड करें
PicassoIA खोलें और ऊपर सूचीबद्ध किसी भी इमेज-टू-वीडियो मॉडल पर जाएँ। हर मॉडल पेज पर एक इमेज अपलोड क्षेत्र होता है, जिस पर आम तौर पर "Input Image" या "Reference Image" लिखा होता है। अपनी फ़ोटो अपलोड करने के लिए क्लिक करें या सीधे खींचकर डालें।
प्लेटफ़ॉर्म JPG, PNG और WEBP फ़ॉर्मेट स्वीकार करता है। सबसे अच्छे नतीजों के लिए उपलब्ध सबसे उच्च रेज़ोल्यूशन पर अपलोड करें। मॉडल इसे आंतरिक रूप से रीसाइज़ करेगा, लेकिन ज़्यादा जानकारी से शुरुआत करना हमेशा बेहतर है।
चरण 2: प्रॉम्प्ट और पैरामीटर सेट करें
अपनी इमेज अपलोड करने के बाद टेक्स्ट फ़ील्ड में अपना मोशन प्रॉम्प्ट लिखें। ऊपर बताई गई बनावट का इस्तेमाल करें: दिशा, रफ़्तार, शरीर के अंग, परिवेश।
समायोजित करने योग्य मुख्य पैरामीटर:
- अवधि: 4 से 5 सेकंड से शुरू करें। लंबी क्लिप को सुसंगत रखना कठिन होता है।
- मोशन स्केल: अगर मॉडल यह विकल्प देता है, तो इसे मध्यम रखें। ज़्यादा मोशन स्केल वार्पिंग आर्टिफ़ैक्ट पैदा कर सकता है।
- सीड: अगर कोई नतीजा पसंद आए पर उसे और सुधारना हो, तो सीड नंबर नोट करें और संशोधित प्रॉम्प्ट के साथ दोबारा इस्तेमाल करें।
- CFG स्केल (अगर उपलब्ध हो): ज़्यादा मान आउटपुट को प्रॉम्प्ट का ज़्यादा सख़्ती से पालन करवाते हैं। 7 से 9 के आसपास अच्छी शुरुआती रेंज है।
चरण 3: जेनरेट करें और समीक्षा करें
जेनरेट पर क्लिक करें और इंतज़ार करें। जेनरेशन का समय मॉडल और सर्वर लोड के अनुसार बदलता है, आम तौर पर 30 सेकंड से 3 मिनट तक।
आपका वीडियो आने पर इन गुणवत्ता संकेतकों की जाँच करें:
- किनारों की निरंतरता: क्या पूरी क्लिप में सब्जेक्ट के किनारे साफ़ रहते हैं, या धुंधले होकर झिलमिलाते हैं?
- चेहरे की स्थिरता: क्या सब्जेक्ट का चेहरा अपनी पहचान और भाव सही तरीके से बनाए रखता है?
- भौतिक विश्वसनीयता: क्या कपड़े, बाल और परिवेश की गति प्राकृतिक नियमों का पालन करती है?
- टेम्पोरल कोहेरेंस: क्या वीडियो फ़्रेम-दर-फ़्रेम सहजता से चलता है, या अचानक झटके आते हैं?
अगर आउटपुट में कोई समस्या है, तो प्रॉम्प्ट समायोजित करें और दोबारा जेनरेट करें। आम तौर पर मज़बूत नतीजा खोजने के लिए दो या तीन प्रयास काफ़ी होते हैं।
सहज, असली-जैसी गति कैसे पाएँ
सबसे ज़रूरी सेटिंग्स
प्रॉम्प्ट के अलावा कुछ खास पैरामीटर चुनाव आउटपुट की गुणवत्ता को काफ़ी प्रभावित करते हैं:
नेगेटिव प्रॉम्प्ट: ज़्यादातर मॉडल नेगेटिव प्रॉम्प्ट फ़ील्ड स्वीकार करते हैं। इसका इस्तेमाल करें। इसे इससे भरें: "distortion, morphing, warping, flickering, artifacts, blurry face, extra limbs, unnatural movement" इससे मॉडल को साफ़ निर्देश मिलता है कि किन चीज़ों से बचना है।
आस्पेक्ट रेशियो: अपनी इनपुट इमेज के आस्पेक्ट रेशियो से बिल्कुल मेल खाएँ। बेमेल होने पर मॉडल को क्रॉप या लेटरबॉक्स करना पड़ता है, जिससे काली पट्टियाँ या अवांछित क्रॉपिंग आ जाती हैं।
वीडियो की लंबाई: गुणवत्ता के लिए छोटी लंबाई लगभग हमेशा बेहतर होती है। एक परफ़ेक्ट 4 सेकंड की क्लिप एक गड़बड़ 8 सेकंड की क्लिप से बेहतर है।
गाइडेंस स्ट्रेंथ (इमेज कंडीशनिंग): यह नियंत्रित करता है कि आउटपुट आपकी मूल फ़ोटो से कितना नज़दीकी रहता है। इसे 0.8 और 1.0 के बीच रखें। कम मान मॉडल को आपकी मूल इमेज से दूर भटकने देते हैं, जो शायद ही कभी अच्छा नतीजा देता है।
आम आउटपुट समस्याओं को ठीक करना
समस्या: सब्जेक्ट का चेहरा बदलता या विकृत होता है
समाधान: इमेज कंडीशनिंग स्ट्रेंथ बढ़ाएँ। पॉज़िटिव प्रॉम्प्ट में "consistent face, stable identity" जोड़ें। नेगेटिव प्रॉम्प्ट में "morphing, distorted face" जोड़ें।
समस्या: बैकग्राउंड वहाँ हिलता या झिलमिलाता है जहाँ नहीं होना चाहिए
समाधान: पॉज़िटिव प्रॉम्प्ट में "static background, stable environment" जोड़ें। अगर समस्या बनी रहे तो सरल बैकग्राउंड वाली फ़ोटो इस्तेमाल करें।
समस्या: गति बहुत तेज़ या झटकेदार है
समाधान: प्रॉम्प्ट में "slow motion, gentle, gradual, smooth movement" जोड़ें। अगर उपलब्ध हो तो मोशन स्केल पैरामीटर घटाएँ।
समस्या: AI ने वह गति जोड़ दी जो आप नहीं चाहते थे
समाधान: किसी पिछले पसंदीदा जेनरेशन का सीड इस्तेमाल करें और प्रॉम्प्ट की अस्पष्टता घटाएँ। साफ़-साफ़ बताएँ कि क्या चलता है और क्या नहीं।
समस्या: वीडियो की क्वालिटी मूल फ़ोटो से कम दिखती है
समाधान: यह सामान्य है। AI वीडियो जेनरेशन टेम्पोरल कोहेरेंस के लिए डिटेल को कंप्रेस करता है। तीखापन वापस लाने के लिए जेनरेशन के बाद वीडियो अपस्केलर इस्तेमाल करें।
💡 टिप: हर जेनरेशन सहेजें, असफल वाले भी। यह जानना कि कोई आउटपुट क्यों विफल हुआ, आपको जल्दी बेहतर प्रॉम्प्ट लिखने में मदद करता है।
जेनरेशन के बाद: अपने वीडियो का क्या करें
अपनी क्लिप डाउनलोड करना और सहेजना
PicassoIA आपका वीडियो जेनरेट करता है और उसे सीधे डाउनलोड के लिए उपलब्ध कराता है। जेनरेशन के तुरंत बाद अपना वीडियो सहेज लें। प्लेटफ़ॉर्म आम तौर पर जनरेट किया गया कंटेंट सीमित समय तक ही रखते हैं।
अपने वीडियो को ऐसे वर्णनात्मक फ़ाइल नामों से सहेजें जिनमें मॉडल का नाम और मुख्य प्रॉम्प्ट तत्व हों। यह उबाऊ लगता है, लेकिन जब आपके पास दर्जनों क्लिप हों और आप किसी खास स्टाइल को दोबारा बनाना चाहें, तो यह बेहद काम का होता है।
अपनी सोर्स फ़ोटो को उनके आउटपुट वीडियो के साथ व्यवस्थित रखें। ठीक उसी इनपुट फ़ोटो पर लौटकर परिष्कृत प्रॉम्प्ट के साथ दोबारा जेनरेट कर पाना किसी भी एक आउटपुट से ज़्यादा कीमती है।
बेहतर गुणवत्ता के लिए अपस्केलिंग
कच्चे AI वीडियो आउटपुट को, चाहे वे सबसे अच्छे मॉडल से ही क्यों न आए हों, पोस्ट-प्रोसेसिंग अपस्केलिंग से फ़ायदा होता है। PicassoIA पर उपलब्ध AI वीडियो एन्हांसमेंट मॉडल आपकी क्लिप का प्रभावी रेज़ोल्यूशन दोगुना या चार गुना कर सकते हैं, खोया हुआ तीखापन लौटा सकते हैं, कंप्रेशन आर्टिफ़ैक्ट घटा सकते हैं और टेम्पोरल असंगतियों को चिकना कर सकते हैं।
वर्कफ़्लो: क्लिप को स्टैंडर्ड रेज़ोल्यूशन पर जेनरेट करें, फिर अंतिम गुणवत्ता पास के लिए उसे AI वीडियो एन्हांसमेंट मॉडल से चलाएँ। आउटपुट की गुणवत्ता में फ़र्क काफ़ी बड़ा होता है। जो क्लिप 720p पर अच्छी लगती है, वह उचित अपस्केलिंग के बाद 4K पर शानदार बन सकती है।
यह दो-चरणीय तरीका, पहले जेनरेट करना और फिर एन्हांस करना, वह तरीका है जिससे प्रोफ़ेशनल क्रिएटर ऐसे नतीजे पाते हैं जो AI आउटपुट जैसे नहीं दिखते।
ये AI मॉडल असल में किसमें अच्छे हैं
जहाँ नतीजे सबसे अच्छे दिखते हैं
सिंगल-फ़ोटो AI वीडियो जेनरेशन के सबसे मज़बूत उपयोग ये हैं:
- पोर्ट्रेट और ब्यूटी कंटेंट: क्लोज़-अप पोर्ट्रेट में सूक्ष्म, प्राकृतिक गति बेहद विश्वसनीय लगती है। बालों की हरकत, साँस लेना, पलकें झपकाना और बारीक भाव मौजूदा मॉडलों का सबसे अच्छा दायरा यही है।
- फ़ैशन और लाइफ़स्टाइल: फ़ैशन संदर्भ में कपड़े की गति उन चीज़ों में से है जो ये मॉडल असाधारण रूप से अच्छी तरह करते हैं। प्राकृतिक हवा के सिमुलेशन के साथ बाहरी माहौल में रेशम, शिफ़ॉन और लिनन लगभग फ़ोटोरियलिस्टिक नतीजे देते हैं।
- बाहर की प्राकृतिक सेटिंग: जब बैकग्राउंड में पानी, पत्तियों और वायुमंडलीय रोशनी जैसे प्राकृतिक रूप से एनिमेटेड तत्व हों, तो मॉडल अच्छा प्रदर्शन करते हैं।
- गोल्डन आवर और सूर्यास्त की रोशनी: मैजिक आवर की गर्म, दिशात्मक रोशनी AI मोशन सिंथेसिस पर खास तौर पर अच्छी प्रतिक्रिया देती है, क्योंकि मज़बूत रोशनी की दिशा मॉडल को साफ़ संकेत देती है।
जिन असली सीमाओं को जानना ज़रूरी है
जो अभी अच्छी तरह काम नहीं करता:
- इंटरैक्शन वाले जटिल बहु-व्यक्ति दृश्य
- तेज़, नाटकीय पूरे-शरीर वाली एथलेटिक गति
- बहुत लंबी क्लिप (8 सेकंड से आगे जाने पर ज़्यादातर मॉडल में गुणवत्ता काफ़ी गिर जाती है)
- उंगलियों की बारीक हरकत वाले हाथों के अत्यधिक क्लोज़-अप
- संवाद के साथ सटीक लिप सिंक की ज़रूरत वाला कंटेंट
तकनीक तेज़ी से आगे बढ़ रही है। 12 महीने पहले जो असंभव था, वह अब सामान्य है। लेकिन मौजूदा सीमाओं को जानने से आपको ऐसे शॉट की योजना बनाने में मदद मिलती है जो सफल होंगे, बजाय उन नतीजों के पीछे भागने के जिनके लिए तकनीक अभी तैयार नहीं है।
सिंगल-फ़ोटो फ़ॉर्मेट इसी वजह से शक्तिशाली है कि यह इनपुट पर आपका नियंत्रण रखता है। आप कंपोज़िशन, रोशनी, सब्जेक्ट और मूड चुनते हैं। AI एनिमेशन की परत संभालता है। रचनात्मक नियंत्रण का यह बँटवारा मानव और AI, दोनों की ताक़तों का अच्छा उपयोग करता है।
आज ही बनाना शुरू करें
यह संभव है, यह जानने और सचमुच नतीजे बनाने के बीच का फ़ासला एक ही चीज़ से तय होता है: आज़माना। आपके पास मौजूद कोई भी पोर्ट्रेट या लाइफ़स्टाइल फ़ोटो चुनें, ऊपर बताए स्ट्रक्चर से एक साफ़ मोशन प्रॉम्प्ट लिखें और PicassoIA पर Seedance 2.0 या Gen-4.5 से चलाएँ।
पहला नतीजा शायद परफ़ेक्ट न हो। दूसरा बेहतर होगा। तीसरे प्रयास तक आपको अंदाज़ा हो जाएगा कि आपके खास तरह के कंटेंट पर अलग-अलग प्रॉम्प्ट और सेटिंग्स कैसे प्रतिक्रिया देते हैं।
PicassoIA आपको मौजूदा इमेज-टू-वीडियो AI मॉडलों की पूरी रेंज देता है, तेज़ प्रयोग के लिए Seedance 2.0 Fast से लेकर गुणवत्ता पर केंद्रित LTX-2.3-Pro और Grok Imagine Video तक, सब एक ही जगह, बिना प्लेटफ़ॉर्म बदले या API कीज़ संभाले।
एक फ़ोटो। यहीं से शुरुआत होती है।


