MiniMax Speech 2.8 HD से मुफ़्त वॉइस जनरेशन कैसे करें
MiniMax Speech 2.8 HD का विस्तृत गाइड, वह न्यूरल टेक्स्ट-टू-स्पीच मॉडल जो 17 भाषाओं और 300+ प्री-सेट वॉइस में स्टूडियो-ग्रेड ऑडियो बनाता है। देखें कि PicassoIA पर इसे मुफ़्त में कैसे एक्सेस करें, इमोशन कंट्रोल कैसे सेट करें, अपनी आवाज़ कैसे क्लोन करें और पॉडकास्ट, ऑडियोबुक और वीडियो डबिंग के लिए प्रोफ़ेशनल नैरेशन कैसे तैयार करें।
अगर आपने वीडियो, पॉडकास्ट या ऑडियोबुक के लिए वॉइसओवर बनाने की कोशिश की है, तो आप जानते हैं कि एक ठीक-ठाक AI आवाज़ और इंसानी लगने वाली आवाज़ के बीच कितना फ़ासला होता है। MiniMax Speech 2.8 HD इस फ़ासले को ऐसे पाटता है जैसा ज़्यादातर प्रतिस्पर्धी मॉडल अब तक नहीं कर पाए हैं। यह 17 भाषाओं में स्टूडियो-ग्रेड ऑडियो क्वालिटी देता है, इसकी वॉइस लाइब्रेरी में 300 से ज़्यादा अलग-अलग वॉइस हैं, और आप इसे बिना कुछ लोकल इंस्टॉल किए PicassoIA के ज़रिए मुफ़्त में इस्तेमाल कर सकते हैं।
यह आर्टिकल बताता है कि यह मॉडल असल में क्या करता है, आज ही वॉइस जनरेट करना कैसे शुरू करें, और प्लेटफ़ॉर्म पर दूसरे टॉप-टियर टेक्स्ट-टू-स्पीच विकल्पों के मुकाबले यह कहाँ आता है।
MiniMax Speech 2.8 HD असल में क्या करता है
MiniMax Speech 2.8 HD एक हाई-डेफ़िनिशन टेक्स्ट-टू-स्पीच मॉडल है, जो प्रोफ़ेशनल ऑडियो आउटपुट के लिए बनाया गया है। AI वॉइस टूल्स की पिछली पीढ़ियों से अलग, जो साफ़ तौर पर रोबोटिक लय वाली आवाज़ें बनाते थे, Speech 2.8 HD एक न्यूरल आर्किटेक्चर इस्तेमाल करता है जो प्राकृतिक प्रोसडी, साँस लेने के पैटर्न और भावनात्मक उतार-चढ़ाव को बारीकी से मॉडल करता है।
नाम में मौजूद "HD" ऑडियो आउटपुट के रिज़ॉल्यूशन को दर्शाता है। मॉडल हाई बिटरेट पर स्पीच जनरेट करता है और कंप्रेशन आर्टिफ़ैक्ट्स बहुत कम होते हैं। यह बात तब बहुत मायने रखती है जब आप ऐसा कंटेंट बना रहे हों जिसमें ऑडियो की क्वालिटी ही प्रोडक्ट हो, कोई सजावट भर नहीं।
300-वॉइस लाइब्रेरी
सबसे तुरंत काम आने वाली खूबियों में से एक इसकी वॉइस लाइब्रेरी का आकार है। Speech 2.8 HD आपको 300 से ज़्यादा प्री-सेट वॉइस देता है, जो इन चीज़ों की विस्तृत रेंज को कवर करती हैं:
उम्र की रेंज: बच्चों की आवाज़ों से लेकर बुज़ुर्ग वक्ताओं तक
लिंग: पुरुष, महिला और न्यूट्रल प्रस्तुति
एक्सेंट और बोली की विविधताएँ: अमेरिकी अंग्रेज़ी, ब्रिटिश अंग्रेज़ी, ऑस्ट्रेलियाई और अन्य
हर प्री-सेट वॉइस एक पूरी तरह प्रशिक्षित वॉइस आइडेंटिटी है, न कि किसी एक बेस वॉइस का सिर्फ़ पिच-शिफ़्ट किया हुआ रूप। यह फ़र्क प्लेबैक के पहले सेकंड से ही सुनाई देता है।
17-भाषा सपोर्ट
यह मॉडल 17 भाषाओं में टेक्स्ट-टू-स्पीच सिंथेसिस सपोर्ट करता है, जिससे बिना टूल बदले अंतरराष्ट्रीय कंटेंट बनाना सचमुच व्यावहारिक हो जाता है।
भाषा
क्वालिटी टियर
अंग्रेज़ी
Studio HD
Spanish
Studio HD
French
Studio HD
German
Studio HD
Japanese
Studio HD
Korean
Studio HD
Chinese (Mandarin)
Studio HD
Portuguese
Studio HD
अरबी
हाई
Italian
High
Russian
High
Dutch
High
Polish
High
Turkish
High
Hindi
High
Indonesian
Standard
Vietnamese
Standard
टॉप-टियर भाषाएँ ऐसा आउटपुट देती हैं जिसे ध्यान से सुनने पर किसी मूल वक्ता की आवाज़ से अलग पहचानना सचमुच मुश्किल होता है।
मुफ़्त में कैसे एक्सेस करें
PicassoIA के ज़रिए
आप MiniMax Speech 2.8 HD को सीधे PicassoIA के वेब इंटरफ़ेस से एक्सेस करते हैं। API सेटअप, SDK इंस्टॉलेशन या शुरू करने के लिए बिलिंग अकाउंट की ज़रूरत नहीं है। यह मॉडल टेक्स्ट-टू-स्पीच कलेक्शन में उपलब्ध है और सीधे आपके ब्राउज़र में लोड हो जाता है।
वर्कफ़्लो सीधा है:
PicassoIA पर मॉडल पेज खोलें
इनपुट फ़ील्ड में अपना टेक्स्ट लिखें
प्री-सेट लाइब्रेरी से एक वॉइस चुनें
स्पीड, पिच और इमोशन पैरामीटर एडजस्ट करें
जनरेट पर क्लिक करें
अपनी ऑडियो फ़ाइल डाउनलोड करें
फ़्री टियर में क्या शामिल है
PicassoIA का फ़्री टियर आपको शुरुआती टेस्टिंग और नियमित उपयोग के लिए बिना पेड सब्सक्रिप्शन के Speech 2.8 HD से ऑडियो जनरेट करने देता है। शुरुआत से ही आपको पूरी वॉइस लाइब्रेरी और सभी भाषा विकल्पों तक पहुँच मिलती है। भारी प्रोडक्शन वर्कफ़्लो पर जनरेशन की सीमाएँ लागू होती हैं, लेकिन वॉइस टेस्ट करने, छोटे क्लिप बनाने और किसी प्रोजेक्ट के लिए क्वालिटी जाँचने के लिए फ़्री एक्सेस पूरी तरह काम का है।
💡 टिप: किसी एक को चुनने से पहले फ़्री टियर पर पाँच-छह अलग-अलग वॉइस को अपनी असली स्क्रिप्ट पर टेस्ट करें। टेक्स्ट-टू-स्पीच प्रोडक्शन में वॉइस का चुनाव ही क्वालिटी का सबसे बड़ा लीवर है।
चरण-दर-चरण इसे कैसे इस्तेमाल करें
चरण 1: अपनी वॉइस चुनें
मॉडल पेज पर वॉइस चुनने वाला इंटरफ़ेस आपको भाषा, लिंग और वोकल कैरेक्टर के हिसाब से फ़िल्टर करने देता है। ज़्यादातर इस्तेमाल के लिए सबसे कारगर तरीका यह है कि अपनी टार्गेट भाषा के सुझाए गए डिफ़ॉल्ट से शुरू करें, फिर तीन से पाँच विकल्पों को आज़माएँ।
इन बातों पर ध्यान दें:
बेसलाइन गर्मजोशी: क्या वॉइस ठंडी लगती है या अपनापन देती है?
कैडेंस स्टाइल: क्या यह नैरेटिव, डायलॉग या एनाउंसमेंट-स्टाइल कंटेंट के लिए ठीक है?
एक्सेंट की स्पष्टता: अंतरराष्ट्रीय दर्शकों के लिए, ज़्यादातर मामलों में एक्सेंट की तटस्थता क्षेत्रीय प्रामाणिकता से ज़्यादा मायने रखती है
चरण 2: इमोशन और स्पीड सेट करें
Speech 2.8 HD वॉइस चुनने से आगे भी कई पैरामीटर देता है:
स्पीड कंट्रोल: यह 0.5x (धीमी, सोची-समझी) से 2.0x (तेज़) तक है। नैरेशन के लिए 0.95x से 1.05x सबसे प्राकृतिक आउटपुट देता है। बातचीत वाले कंटेंट के लिए 1.3x से ऊपर की स्पीड जल्दबाज़ी वाली लगने लगती है, हालाँकि तेज़ पढ़े जाने वाले डिस्क्लेमर सेक्शन के लिए यह अच्छा काम करती है।
इमोशन टैगिंग: मॉडल इनपुट टेक्स्ट में सीधे एम्बेड किए गए स्पष्ट इमोशन मॉडिफ़ायर को सपोर्ट करता है। आप सेक्शन को ऐसे इमोशन स्टेट्स से टैग कर सकते हैं:
[Excited] "We just hit our first million users!"
[Calm] "Here's how it happened over the past eighteen months."
यह प्रोसडी, ऊर्जा के स्तर और पेसिंग को ऐसे तरीकों से प्रभावित करता है जो मशीनी नहीं बल्कि असली लगते हैं।
पिच एडजस्टमेंट: बारीक पिच कंट्रोल से आप वॉइस को उसके कुल चरित्र को बदले बिना थोड़ा ऊपर या नीचे रख सकते हैं। यह तब काम आता है जब आपको ऐसी वॉइस चाहिए जो संगीत या साउंड इफ़ेक्ट्स के साथ मिक्स में आराम से बैठे।
चरण 3: जनरेट और डाउनलोड करें
पैरामीटर सेट होने के बाद जनरेशन तेज़ होती है। 500 शब्दों की स्क्रिप्ट आम तौर पर दो से चार सेकंड में प्रोसेस हो जाती है। आपके चुनाव के अनुसार आउटपुट MP3 या WAV में डाउनलोड होता है। जिस फ़ाइल को आप DAW में आगे एडिट करने वाले हैं, उसके लिए WAV बेहतर है। पॉडकास्ट फ़ीड या वीडियो एम्बेडिंग में सीधे डिलीवरी के लिए MP3 ठीक काम करता है।
💡 Tip: लंबी स्क्रिप्ट को 200 से 300 शब्दों के सेक्शन में तोड़ें। इससे एडिटिंग पर ज़्यादा नियंत्रण मिलता है और पूरे टुकड़े को दोबारा प्रोसेस किए बिना किसी खास हिस्से को दोबारा जनरेट करना कहीं आसान हो जाता है।
वॉइस क्वालिटी बनाम प्रतिस्पर्धी मॉडल
असली सवाल यह नहीं है कि Speech 2.8 HD अच्छा है या नहीं। सवाल यह है कि PicassoIA पर अभी उपलब्ध दूसरे मॉडलों के मुकाबले यह कहाँ खड़ा है।
Speech 2.8 HD कच्चे ऑडियो फ़िडेलिटी और वॉइस विविधता में आगे है। ElevenLabs v3 की भाषा कवरेज ज़्यादा विस्तृत है और इमोशनल एक्टिंग में यह उत्कृष्ट है। Speech 2.8 Turbo तब सही चुनाव है जब आपको तेज़ टर्नअराउंड चाहिए और थोड़ा क्वालिटी समझौता स्वीकार्य हो।
Speech 2.8 HD के सबसे अच्छे इस्तेमाल
पॉडकास्ट और नैरेशन
पॉडकास्ट के इंट्रो और आउट्रो सेगमेंट, स्पॉन्सरशिप रीड्स, या पूरी तरह AI-नैरेटेड शो के लिए, Speech 2.8 HD ऐसा ऑडियो देता है जो हेडफ़ोन पर सुनने में भी टिकता है। यहाँ मॉडल की दो खूबियाँ सबसे ज़्यादा मायने रखती हैं: ब्रेथ सिमुलेशन और प्राकृतिक विराम की जगह, और दोनों ही मज़बूत हैं।
300-वॉइस लाइब्रेरी का मतलब है कि आप एक शो के लिए एक स्थिर "कैरेक्टर" चुन सकते हैं और हर एपिसोड में बिना किसी बदलाव के वही वॉइस आइडेंटिटी बनाए रख सकते हैं। सेशन एक में चुनी गई वॉइस सेशन पचास में भी बिल्कुल वैसी ही सुनाई देती है। यह गारंटी महीनों की रिकॉर्डिंग में इंसानी वॉइस आर्टिस्ट कभी नहीं दे सकते।
वीडियो डबिंग और लोकलाइज़ेशन
कई भाषाओं में वीडियो कंटेंट बनाने के लिए पारंपरिक रूप से हर लोकेल के लिए मूल भाषा बोलने वाले वॉइस आर्टिस्ट रखने पड़ते हैं। Speech 2.8 HD की मल्टीलिंगुअल क्षमता आपको एक ही सोर्स स्क्रिप्ट से एक ही सेशन में लोकलाइज़्ड वॉइसओवर जनरेट करने देती है। MiniMax Voice Cloning के साथ मिलाकर, आप किसी वीडियो के सभी भाषा संस्करणों में एक ही वॉइस कैरेक्टर बनाए रख सकते हैं।
💡 Tip: वीडियो डबिंग के लिए 0.9x स्पीड पर जनरेट करें, फिर अपने वीडियो एडिटर में टाइमिंग एडजस्ट करें। इससे एडिट पॉइंट्स पर क्वालिटी बिगड़े बिना सिलेबल्स को खींचने की गुंजाइश मिलती है।
ऑडियोबुक
ऑडियोबुक प्रोडक्शन में घंटों के कंटेंट में स्थिरता चाहिए। इंसानी नैरेटर्स के सेशन-दर-सेशन लहजे, ऊर्जा और वोकल थकान में प्राकृतिक बदलाव आते हैं। Speech 2.8 HD से बना AI नैरेशन सेशन की लंबाई चाहे जो हो, पूरी तरह एक-सा रहता है। सुबह 9 बजे जनरेट किया गया चैप्टर और तीन हफ़्ते बाद आधी रात को जनरेट किया गया चैप्टर, दोनों का कैरेक्टर बिल्कुल एक-सा सुनाई देता है।
फ़िक्शन के लिए, इमोशन टैगिंग सिस्टम कैरेक्टर्स के बीच सार्थक अंतर बनाने देता है। आप पूरी तरह अलग वॉइस प्रीसेट पर गए बिना डायलॉग के लिए इमोशनल रजिस्टर बदल सकते हैं।
कॉर्पोरेट और ई-लर्निंग कंटेंट
ट्रेनिंग वीडियो, प्रोडक्ट डेमो और ई-लर्निंग मॉड्यूल्स को ऐसी न्यूट्रल, आधिकारिक वॉइस से फ़ायदा होता है जो ध्यान भटकाए बिना जानकारी पहुँचाए। Speech 2.8 HD में इस इस्तेमाल के लिए कुछ प्रीसेट हैं, जिनमें पुरुष और महिला दोनों वॉइस गर्मजोशी भरे और सुलभ से लेकर औपचारिक और सटीक प्रोफ़ेशनल रजिस्टर तक की रेंज में हैं।
अपनी आवाज़ क्लोन करें
वॉइस क्लोनिंग कैसे काम करती है
MiniMax Voice Cloning एक कंपैनियन मॉडल है जो आपको अपने ऑडियो सैंपल्स से एक कस्टम वॉइस आइडेंटिटी बनाने देता है। आप एक रेफ़रेंस रिकॉर्डिंग देते हैं, मॉडल आपके वोकल फ़िंगरप्रिंट को निकालता है, और फिर आप Speech 2.8 HD इंजन के ज़रिए उस क्लोन की गई वॉइस को किसी भी टेक्स्ट से चला सकते हैं।
व्यावहारिक ज़रूरतें बहुत कम हैं:
रिकॉर्डिंग की लंबाई: एक काम का क्लोन बनाने के लिए साफ़ ऑडियो के कम से कम 30 से 60 सेकंड काफ़ी हैं। लंबे सैंपल से सटीकता बेहतर होती है।
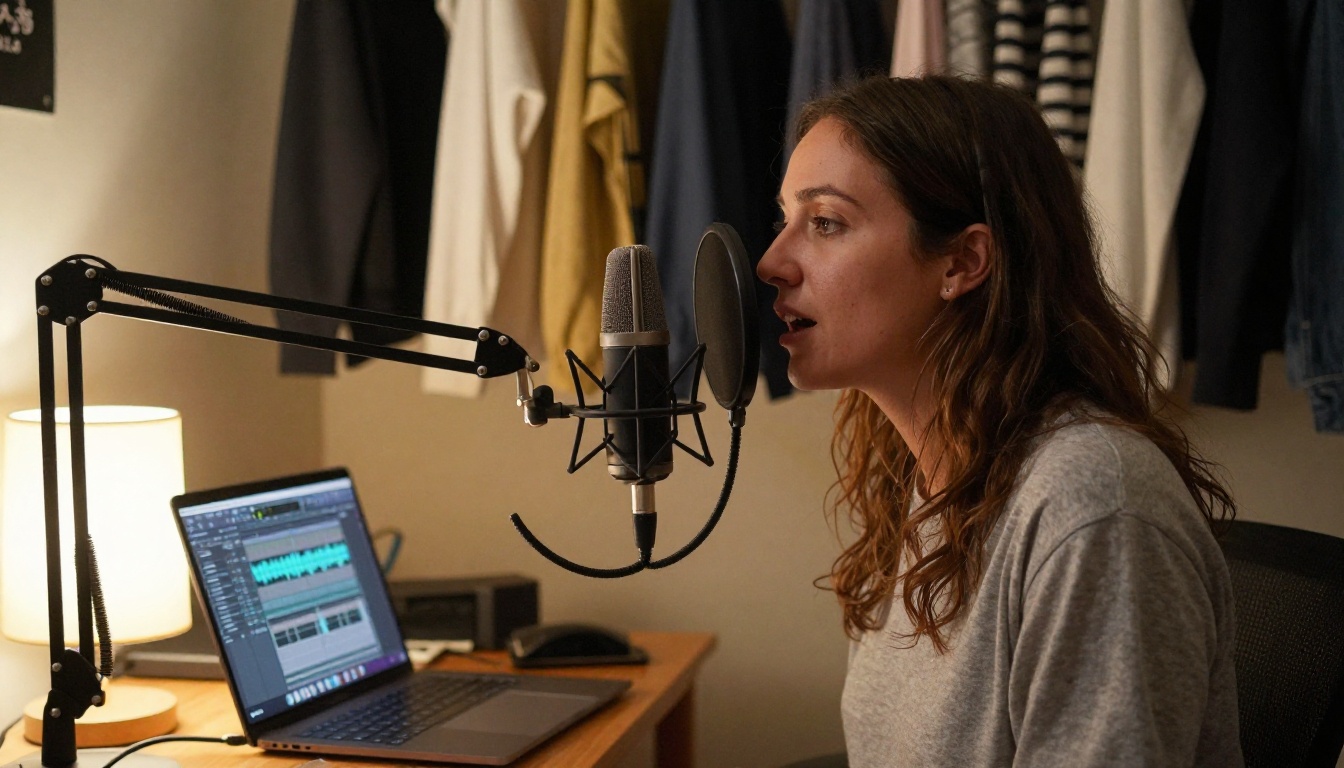
रिकॉर्डिंग का माहौल: बैकग्राउंड नॉइज़ क्लोन की क्वालिटी को काफ़ी बिगाड़ देता है। ट्रीटेड कमरा, या टँगे कपड़ों से भरी अलमारी भी, खुले कमरे से बेहतर नतीजे देती है।
डिलीवरी स्टाइल: जिस स्टाइल में आप चाहते हैं कि क्लोन बोले, उसी स्टाइल में रिकॉर्ड करें। न्यूट्रल स्क्रिप्ट पढ़ने से जो प्रोफ़ाइल बनती है, वह कैज़ुअल बातचीत रिकॉर्ड करने से बनने वाली प्रोफ़ाइल से अलग होती है।
क्लोन होने के बाद वॉइस Speech 2.8 HD इंटरफ़ेस में एक कस्टम प्रीसेट के रूप में उपलब्ध हो जाती है। आउटपुट क्वालिटी HD मॉडल जैसी ही होती है, इसलिए आपकी क्लोन की गई वॉइस को भी प्री-बिल्ट लाइब्रेरी प्रीसेट जैसी ही ऑडियो फ़िडेलिटी मिलती है।
वॉइस क्लोनिंग के स्पष्ट फ़ायदे पर्सनल ब्रांड की स्थिरता के लिए हैं, लेकिन यह ऐसे इस्तेमाल भी कवर करती है जैसे:
यात्रा के दौरान या जब आपकी असली आवाज़ उपलब्ध न हो, तब अपनी आवाज़ में कंटेंट बनाना
अपने मूल वीडियो कंटेंट को अपनी वॉइस आइडेंटिटी बनाए रखते हुए दूसरी भाषाओं में डब करना
अलग-अलग रिकॉर्डिंग सेशन के बिना लिखे हुए कंटेंट के सुलभ ऑडियो संस्करण बनाना
दूसरे स्पीच मॉडल जिन्हें आज़माना चाहिए
Speech 2.8 HD MiniMax लाइनअप में सबसे उच्च फ़िडेलिटी वाला विकल्प है, लेकिन प्लेटफ़ॉर्म पर कई और मॉडल हैं जो अलग-अलग ज़रूरतों के लिए फ़िट बैठते हैं।
MiniMax Speech 2.6 HD: पिछली पीढ़ी का HD मॉडल। इसकी क्वालिटी की ऊपरी सीमा 2.8 HD से थोड़ी कम है, फिर भी यह उत्कृष्ट है। अगर 2.6 लाइब्रेरी की कोई खास प्री-सेट वॉइस 2.8 में नहीं आई है, तो इसे इस्तेमाल करना उपयोगी है।
Resemble AI Chatterbox: इमोशनल रेंज और वॉइस एक्टिंग के इस्तेमाल में मज़बूत। इसकी ताकतें अलग हैं, जो Speech 2.8 HD को दोहराने के बजाय उसका पूरक बनती हैं।
Inworld Realtime TTS 2: रियल-टाइम एप्लिकेशन के लिए बना है, जहाँ 100 मिलीसेकंड से कम लेटेंसी मायने रखती है, जैसे इंटरैक्टिव कैरेक्टर या लाइव एप्लिकेशन। यह बैच नैरेशन के लिए नहीं बना, लेकिन अपने खास इस्तेमाल के लिए उत्कृष्ट है।
Gemini 3.1 Flash TTS: 70+ भाषाओं में 30 वॉइस के साथ, प्लेटफ़ॉर्म पर इसकी भाषा कवरेज सबसे विस्तृत है। क्वालिटी उच्च है, हालाँकि वह ऊँचाई नहीं जो Speech 2.8 HD छूता है।
PicassoIA पर हर मॉडल का एक लाइव टेस्ट पेज है, जहाँ आप यह तय करने से पहले जनरेशन चलाकर देख सकते हैं कि कौन-सा मॉडल आपके प्रोजेक्ट के लिए सही है। व्यावहारिक तरीका यह है कि किसी प्रोडक्शन वॉइस को चुनने से पहले एक ही 50 शब्दों के टेस्ट पैराग्राफ़ को तीन या चार मॉडल पर चलाएँ। लय और गर्मजोशी के छोटे-छोटे फ़र्क़ एक वाक्य में मामूली लगते हैं, लेकिन 10,000 शब्दों की ऑडियोबुक या 20 एपिसोड के पॉडकास्ट सीज़न जैसे बड़े पैमाने पर वे काफ़ी मायने रखने लगते हैं।
अपनी वॉइस प्रोडक्शन को और आगे ले जाएँ
MiniMax Speech 2.8 HD इस समय उपलब्ध सबसे सक्षम मुफ़्त टेक्स्ट-टू-स्पीच विकल्पों में से एक है, और यह एक ऐसे प्लेटफ़ॉर्म के भीतर है जो क्रिएटिव और प्रोफ़ेशनल ऑडियो प्रोडक्शन को बड़े पैमाने पर ध्यान में रखकर बना है।
अगर आप नियमित रूप से कंटेंट बनाते हैं, तो प्राथमिक नैरेशन के लिए Speech 2.8 HD, ब्रांड-वॉइस की स्थिरता के लिए Voice Cloning, और PicassoIA के व्यापक ऑडियो टूल्स का सेट मिलकर बिना अलग-अलग टूल सब्सक्रिप्शन के पूरी प्रोडक्शन पाइपलाइन कवर करते हैं। अगर आपको मौजूदा ऑडियो को वापस एडिट करने योग्य टेक्स्ट में बदलना है, तो प्लेटफ़ॉर्म अपने speech-to-text मॉडल्स से ट्रांसक्रिप्शन भी करता है।
शुरुआत मॉडल पेज से करें। प्लेसहोल्डर पैराग्राफ़ की जगह अपने असली कंटेंट के साथ जनरेशन चलाएँ, और नतीजों की क्वालिटी को खुद अपनी बात कहने दें। वॉइस चुनाव और इमोशन पैरामीटर एडजस्ट करने में पाँच मिनट लगते हैं और नतीजा बहुत बदल देते हैं। अंत में आपको वह स्टूडियो-क्वालिटी नैरेशन मिलता है जिसके लिए कुछ साल पहले प्रोफ़ेशनल रिकॉर्डिंग सेशन और वॉइस आर्टिस्ट की ज़रूरत पड़ती थी।
आप MiniMax Speech 2.8 HD और PicassoIA के टेक्स्ट-टू-स्पीच कलेक्शन के बाकी सभी वॉइस मॉडल को picassoia.com/en/all-models पर एक्सेस कर सकते हैं। मुफ़्त एक्सेस मौजूद है, वॉइस लाइब्रेरी तैयार है, और प्रोफ़ेशनल-ग्रेड नैरेशन बस एक टेक्स्ट बॉक्स की दूरी पर है।