Como usar o MiniMax Speech 2.8 HD para geração de voz gratuita
Um passo a passo detalhado do MiniMax Speech 2.8 HD, o modelo neural de texto para fala que produz áudio de qualidade de estúdio em 17 idiomas e mais de 300 vozes predefinidas. Veja como acessá-lo gratuitamente no PicassoIA, configurar controles de emoção, clonar sua própria voz e produzir narração profissional para podcasts, audiobooks e dublagem de vídeos.
Se você já passou algum tempo tentando gerar narrações para vídeos, podcasts ou audiobooks, sabe a diferença entre uma voz de IA aceitável e uma que de fato soa humana. O MiniMax Speech 2.8 HD fecha essa distância de um jeito que a maioria dos modelos concorrentes ainda não conseguiu. Ele entrega áudio de qualidade de estúdio em 17 idiomas, com uma biblioteca de vozes que ultrapassa 300 vozes distintas, e você pode acessá-lo gratuitamente pelo PicassoIA sem instalar nada localmente.
Este artigo mostra exatamente o que o modelo faz, como começar a gerar vozes hoje e onde ele se encaixa em comparação com outras opções de texto para fala de ponta disponíveis na plataforma.
O que o MiniMax Speech 2.8 HD realmente faz
O MiniMax Speech 2.8 HD é um modelo de texto para fala de alta definição criado para saída de áudio profissional. Diferente das gerações anteriores de ferramentas de voz por IA, que produziam cadências claramente robóticas, o Speech 2.8 HD usa uma arquitetura neural que modela a prosódia natural, os padrões de respiração e a inflexão emocional em um nível granular.
O "HD" no nome reflete a resolução do áudio de saída. O modelo gera a fala em alta taxa de bits, com artefatos de compressão mínimos, o que importa muito quando você produz conteúdo em que a qualidade do áudio é o próprio produto, e não um acessório.
A biblioteca de 300 vozes
Um dos recursos mais práticos e de uso imediato é o tamanho da biblioteca de vozes. O Speech 2.8 HD dá acesso a mais de 300 vozes predefinidas, cobrindo uma ampla variedade de:
Faixas etárias: de vozes infantis a falantes idosos
Gêneros: apresentações masculinas, femininas e neutras
Variações de sotaque e dialeto: inglês americano, inglês britânico, australiano e outros
Cada voz predefinida é uma identidade vocal totalmente treinada, e não um simples ajuste de tom a partir de uma única voz base. Essa diferença se percebe desde o primeiro segundo de reprodução.
Suporte a 17 idiomas
O modelo oferece síntese de texto para fala em 17 idiomas, o que o torna realmente útil para a produção de conteúdo internacional sem trocar de ferramenta.
Idioma
Nível de qualidade
Inglês
Estúdio HD
Espanhol
Estúdio HD
Francês
Estúdio HD
Alemão
Estúdio HD
Japonês
Estúdio HD
Coreano
Estúdio HD
Chinês (mandarim)
Estúdio HD
Português
Estúdio HD
Árabe
Alto
Italiano
Alto
Russo
Alto
Holandês
Alto
Polonês
Alto
Turco
Alto
Hindi
Alto
Indonésio
Padrão
Vietnamita
Padrão
Os idiomas de nível mais alto produzem uma saída que é genuinamente difícil de distinguir de um falante nativo humano, quando ouvida com atenção.
Como acessar gratuitamente
Pelo PicassoIA
Você acessa o MiniMax Speech 2.8 HD diretamente pela interface web do PicassoIA. Não é preciso configurar chave de API, instalar SDK nem ter uma conta de cobrança para começar. O modelo está disponível na coleção de texto para fala e carrega direto no seu navegador.
O fluxo de trabalho é simples:
Acesse a página do modelo no PicassoIA
Digite seu texto no campo de entrada
Selecione uma voz na biblioteca predefinida
Ajuste os parâmetros de velocidade, tom e emoção
Clique em gerar
Baixe seu arquivo de áudio
O que o plano gratuito cobre
O plano gratuito do PicassoIA permite gerar áudio com o Speech 2.8 HD sem uma assinatura paga, tanto para testes iniciais quanto para uso regular. Você tem acesso à biblioteca completa de vozes e a todas as opções de idioma desde o início. Há limites de geração para fluxos de produção mais pesados, mas, para testar vozes, produzir clipes curtos e avaliar a qualidade para um projeto, o acesso gratuito é totalmente funcional.
💡 Dica: Use o plano gratuito para testar cinco ou seis vozes diferentes com o seu roteiro real antes de escolher uma. A seleção de voz é o fator de maior impacto na qualidade da produção de texto para fala.
Como usar passo a passo
Passo 1: escolha sua voz
A interface de seleção de voz na página do modelo permite filtrar por idioma, gênero e caráter vocal. Na maioria dos casos, a abordagem mais eficiente é começar pelas sugestões padrão para o seu idioma de destino e, depois, testar de três a cinco alternativas.
Preste atenção a:
Calor vocal básico: a voz soa fria ou acessível?
Estilo de cadência: ela combina com conteúdo narrativo, de diálogo ou de anúncio?
Clareza do sotaque: para públicos internacionais, a neutralidade do sotaque importa mais do que a autenticidade regional na maioria dos casos
Passo 2: configure emoção e velocidade
O Speech 2.8 HD expõe vários parâmetros além da simples seleção de voz:
Controle de velocidade: vai de 0,5x (lenta, deliberada) a 2,0x (rápida). Para narração, de 0,95x a 1,05x tende a produzir a saída mais natural. Acima de 1,3x começa a soar apressada em conteúdo conversacional, embora funcione bem em seções de avisos legais rápidos.
Marcação de emoção: o modelo aceita modificadores explícitos de emoção incorporados ao texto de entrada. Você pode marcar seções com estados emocionais como:
[Excited] "We just hit our first million users!"
[Calm] "Here's how it happened over the past eighteen months."
Isso afeta a prosódia, o nível de energia e o ritmo de um jeito que soa genuíno, e não mecânico.
Ajuste de tom: o controle fino de tom permite posicionar a voz um pouco mais alta ou mais baixa sem mudar seu caráter geral. Isso é útil quando você quer uma voz que se encaixe bem na mixagem junto com música ou efeitos sonoros.
Passo 3: gere e baixe
Com os parâmetros definidos, a geração é rápida. Um roteiro de 500 palavras costuma ser processado em dois a quatro segundos. O arquivo é baixado em MP3 ou WAV, conforme sua escolha. O WAV é a melhor opção para qualquer arquivo que você pretenda editar depois em um DAW. O MP3 funciona bem para entrega direta em feeds de podcast ou incorporação em vídeos.
💡 Dica: Divida roteiros longos em seções de 200 a 300 palavras. Isso dá mais controle de edição e facilita muito regenerar trechos específicos sem reprocessar o texto inteiro.
Qualidade de voz comparada com modelos concorrentes
A questão prática não é se o Speech 2.8 HD é bom. É onde ele se posiciona em relação a outros modelos que você pode acessar agora no PicassoIA.
O Speech 2.8 HD vence em fidelidade bruta de áudio e variedade de vozes. O ElevenLabs v3 tem cobertura de idiomas mais ampla e se destaca na atuação emocional. O Speech 2.8 Turbo é a escolha certa quando você precisa de um prazo de entrega mais curto e pode aceitar uma pequena contrapartida na qualidade.
Melhores casos de uso para o Speech 2.8 HD
Podcasts e narração
Para segmentos de abertura e encerramento de podcasts, leituras de patrocínio ou programas totalmente narrados por IA, o Speech 2.8 HD produz áudio que se sustenta na escuta com fones de ouvido. A simulação de respiração do modelo e a colocação natural de pausas são os dois recursos que mais importam aqui, e ambos são fortes.
A biblioteca de 300 vozes permite escolher um "personagem" consistente para um programa e manter essa identidade vocal em todos os episódios, sem variação. A voz que você escolhe na primeira sessão soa idêntica na quinquagésima, algo que atores de voz humanos não conseguem garantir ao longo de meses de gravação.
Dublagem de vídeo e localização
Produzir conteúdo em vídeo em vários idiomas normalmente exige contratar atores de voz nativos para cada localidade. A capacidade multilíngue do Speech 2.8 HD permite gerar narrações localizadas a partir do mesmo roteiro-base em uma única sessão. Combinado com MiniMax Voice Cloning, você pode manter o mesmo caráter vocal em todas as versões de idioma de um vídeo.
💡 Dica: Para dublagem de vídeo, gere a 0,9x de velocidade e depois ajuste o tempo no seu editor de vídeo. Isso dá margem para esticar sílabas nos pontos de corte sem perda de qualidade.
Audiobooks
A produção de audiobooks exige consistência ao longo de horas de conteúdo. Narradores humanos apresentam variação natural de tom, energia e cansaço vocal de uma sessão para outra. A narração gerada por IA pelo Speech 2.8 HD é perfeitamente consistente, independentemente da duração da sessão. Um capítulo gerado às 9h soa idêntico em caráter a outro gerado à meia-noite, três semanas depois.
Para ficção, o sistema de marcação de emoção permite uma diferenciação significativa de personagens. Você pode mudar o registro emocional dos diálogos sem trocar por uma predefinição de voz totalmente diferente.
Conteúdo corporativo e de e-learning
Vídeos de treinamento, demonstrações de produtos e módulos de e-learning se beneficiam de vozes neutras e autoritativas, que transmitem informação sem distrair. O Speech 2.8 HD tem várias predefinições especialmente adequadas a esse caso de uso, cobrindo vozes masculinas e femininas em uma gama de registros profissionais, do caloroso e acessível ao formal e preciso.
Clone sua própria voz
Como funciona a clonagem de voz
O MiniMax Voice Cloning é um modelo complementar que permite criar uma identidade vocal personalizada a partir das suas próprias amostras de áudio. Você fornece uma gravação de referência, o modelo extrai sua impressão vocal e, depois, pode conduzir essa voz clonada com qualquer texto por meio do mecanismo Speech 2.8 HD.
Os requisitos práticos são mínimos:
Duração da gravação: um mínimo de 30 a 60 segundos de áudio limpo basta para um clone funcional. Amostras mais longas melhoram a precisão.
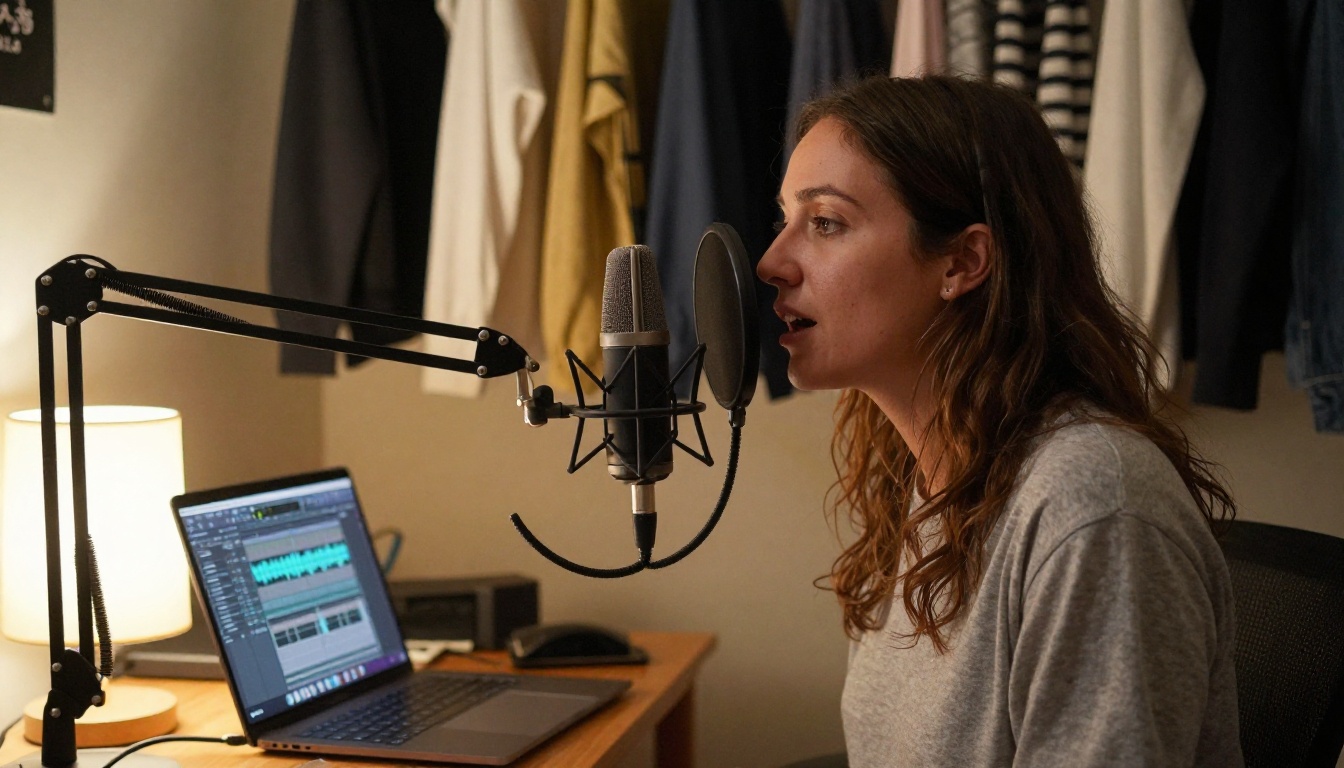
Ambiente de gravação: ruído de fundo degrada muito a qualidade do clone. Um cômodo tratado ou até um armário forrado com roupas penduradas produz resultados melhores do que um cômodo aberto.
Estilo de entrega: grave no mesmo estilo que você quer que o clone reproduza. Ler um roteiro neutro gera um perfil diferente do que gravar uma fala casual e conversacional.
Depois de clonada, a voz fica disponível na interface do Speech 2.8 HD como uma predefinição personalizada. A qualidade de saída corresponde à do modelo HD, então sua voz clonada tem a mesma fidelidade de áudio das predefinições da biblioteca pré-construída.
A clonagem de voz tem aplicações óbvias para a consistência de marca pessoal, mas também atende a casos como:
Produzir conteúdo com a sua própria voz quando você está viajando ou quando sua voz física não está disponível
Dublar seus vídeos originais para outros idiomas preservando sua identidade vocal
Criar versões em áudio acessíveis de conteúdo escrito sem sessões de gravação individuais
Outros modelos de fala que valem a pena testar
O Speech 2.8 HD é a opção de maior fidelidade da linha MiniMax, mas a plataforma oferece vários outros modelos que atendem a requisitos diferentes.
MiniMax Speech 2.6 HD: a geração HD anterior. Um teto de qualidade um pouco mais baixo que o do 2.8 HD, mas ainda excelente. Vale a pena usar se você encontrar uma voz predefinida específica da biblioteca 2.6 que não foi mantida na 2.8.
Resemble AI Chatterbox: forte em variedade emocional e em aplicações de atuação de voz. Um perfil de pontos fortes diferente, que complementa o Speech 2.8 HD em vez de duplicá-lo.
Inworld Realtime TTS 2: criado para aplicações em tempo real em que a latência abaixo de 100 ms importa, como personagens interativos ou aplicações ao vivo. Não foi projetado para narração em lote, mas é excelente para o seu caso de uso específico.
Gemini 3.1 Flash TTS: 30 vozes em mais de 70 idiomas, o que lhe dá a cobertura de idiomas mais ampla da plataforma. A qualidade é alta, embora não chegue ao teto que o Speech 2.8 HD alcança.
Cada modelo tem uma página de teste ao vivo no PicassoIA, onde você pode executar uma geração antes de decidir qual se encaixa no seu projeto. A abordagem prática é rodar o mesmo parágrafo de teste de 50 palavras em três ou quatro candidatos antes de se comprometer com uma voz de produção. Pequenas diferenças de cadência e calor que parecem insignificantes em uma única frase se tornam relevantes em escala, num audiobook de 10.000 palavras ou numa temporada de podcast com 20 episódios.
Leve sua produção de voz adiante
O MiniMax Speech 2.8 HD é uma das opções de texto para fala gratuitas mais capazes disponíveis agora, e fica dentro de uma plataforma criada para produção de áudio criativa e profissional em escala.
Se você produz conteúdo com regularidade, a combinação do Speech 2.8 HD para a narração principal, da Clonagem de voz para a consistência da voz da marca e do conjunto mais amplo de ferramentas de áudio do PicassoIA cobre todo o fluxo de produção sem exigir assinaturas de ferramentas separadas. A plataforma também faz transcrição por meio de seus modelos de fala para texto, caso você precise converter áudio existente de volta em texto editável.
O ponto de partida é a página do modelo. Execute uma geração com o seu conteúdo real, e não com um parágrafo de exemplo, e deixe a qualidade da saída falar por si. Ajustar a seleção de voz e os parâmetros de emoção leva cinco minutos e muda o resultado de forma drástica. O que você recebe no final é uma narração de qualidade de estúdio que, há alguns anos, exigiria uma sessão de gravação profissional e um ator de voz.
Você pode acessar o MiniMax Speech 2.8 HD e todos os outros modelos de voz da coleção de texto para fala do PicassoIA em picassoia.com/en/all-models. O acesso gratuito está disponível, a biblioteca de vozes está pronta, e uma narração de nível profissional fica a uma caixa de texto de distância.