आपके पास एक संदेश है। एक प्रोडक्ट है जिसे पेश करना है। एक कोर्स है जिसे बेचना है। पहले आपके और एक पॉलिश्ड प्रेज़ेंटर वीडियो के बीच सिर्फ़ एक कैमरा, एक स्टूडियो, अच्छी लाइटिंग और घंटों की एडिटिंग खड़ी होती थी। अब इनमें से कुछ भी ज़रूरी नहीं है।
AI प्रेज़ेंटर टेक्नोलॉजी आपको एक ही फ़ोटो लेने, उसे वॉइस रिकॉर्डिंग या टाइप की गई स्क्रिप्ट के साथ जोड़ने और एक रियलिस्टिक इंसान का वीडियो बनाने देती है जो आपका संदेश दे रहा हो। होंठ हिलते हैं। चेहरा प्रतिक्रिया देता है। टाइमिंग ऑडियो से लगभग फ़्रेम-स्तर की सटीकता के साथ मेल खाती है। जिस काम में पूरा प्रोडक्शन दिन लगता था, वह अब मिनटों में हो जाता है।
यह आर्टिकल बताता है कि यह कैसे काम करता है, कौन से मॉडल सबसे अच्छे नतीजे देते हैं, और आप आज से अपने AI प्रेज़ेंटर वीडियो कैसे बनाना शुरू कर सकते हैं।
AI प्रेज़ेंटर असल में क्या है
AI प्रेज़ेंटर एक ऐसा वीडियो है जिसमें कोई रियलिस्टिक इंसानी चेहरा कैमरे पर बोलता है, और वह चेहरा और आवाज़ किसी इंसान द्वारा रिकॉर्ड किए जाने के बजाय AI द्वारा जनरेट या एनिमेट किए गए होते हैं। नतीजा एक आम टॉकिंग-हेड वीडियो जैसा दिखता है, लेकिन इसके लिए कोई भौतिक शूट करना नहीं पड़ता।
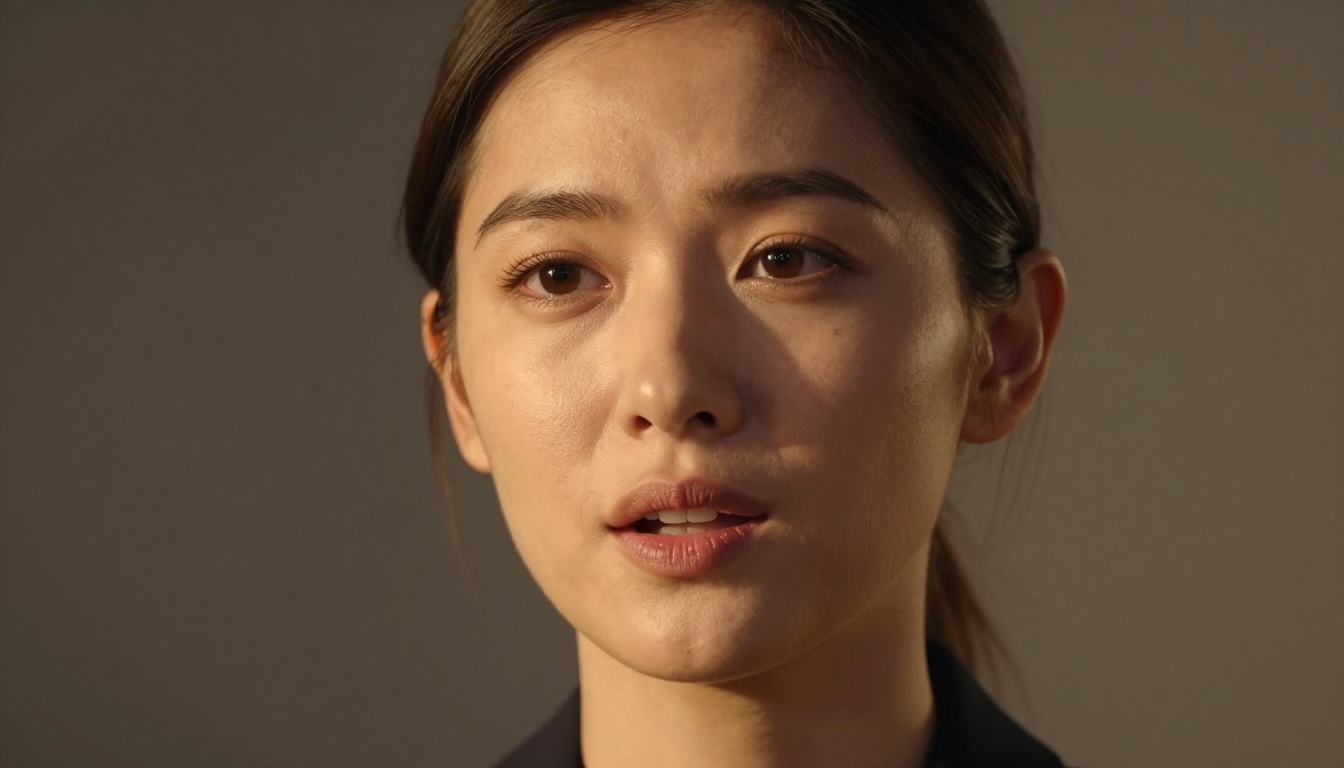
इसके दो अलग तरीके हैं, और सही टूल चुनते समय इनका फ़र्क जानना ज़रूरी है।
फ़ोटो-से-वीडियो एनिमेशन
आप एक स्टिल इमेज (पोर्ट्रेट, हेडशॉट, या AI से बनी फ़ोटो भी) देते हैं और मॉडल उस चेहरे को किसी ऑडियो ट्रैक से मेल खाने के लिए एनिमेट करता है। नतीजा एक ऐसा वीडियो होता है जिसमें फ़ोटो वाला व्यक्ति बोलता हुआ दिखता है। यह सबसे लोकप्रिय तरीका है, क्योंकि इसमें सिर्फ़ एक इमेज और एक ऑडियो फ़ाइल चाहिए।
फ़ुल अवतार जनरेशन
कुछ टूल फ़ोटो को एनिमेट करने के बजाय शुरुआत से एक अवतार बनाते हैं और उसे आपकी स्क्रिप्ट बोलते हुए रेंडर करते हैं। आप उसकी दिखावट, आवाज़ और सेटिंग तय करते हैं। Avatar IV by HeyGen ठीक इसी काम के लिए बना है। यह एक फ़ोटो से पूरी तरह रेंडर किया गया वर्चुअल प्रेज़ेंटर बनाता है, जिसकी पहचान आपके हर वीडियो में एक जैसी रहती है।
दोनों तरीके टॉकिंग-हेड वीडियो ही बनाते हैं। फ़र्क इस बात में है कि चेहरा कहाँ से आता है, और आप कौन सा तरीका चुनेंगे यह इस पर निर्भर करता है कि आपके मन में पहले से कोई खास चेहरा है या आप उसे शुरू से बनाना चाहते हैं।
क्रिएटर्स AI प्रेज़ेंटर की ओर क्यों जा रहे हैं
इसके व्यावहारिक कारण सीधे-सादे हैं, लेकिन प्रोडक्शन की रुकावट हटाने से जो बड़ा बदलाव आता है, उसे साफ़ तौर पर समझना उपयोगी है।
कैमरा नहीं चाहिए, रीशूट नहीं
सिर्फ़ एक पोर्ट्रेट फ़ोटो ही ज़रूरी इनपुट है। तीन साल पुराना अच्छा हेडशॉट भी बखूबी काम करता है। AI से बना चेहरा भी काम करता है। प्रेज़ेंटर को न आना पड़ता है, न डायलॉग याद करने पड़ते हैं, न किसी शब्द के भूल जाने पर दोबारा रिकॉर्ड करना पड़ता है। जब स्क्रिप्ट बदलती है, तो आप ऑडियो बदलकर दोबारा जनरेट करते हैं। चेहरा बिल्कुल वैसा ही रहता है।
हर भाषा में प्रोडक्शन
यहीं AI प्रेज़ेंटर टूल्स पारंपरिक प्रोडक्शन से सचमुच आगे निकलते हैं। Video Translate by HeyGen किसी मौजूदा वीडियो को लेकर उसे 150+ भाषाओं में री-डब करता है और होंठों की हरकत को नए अनुवादित ऑडियो से अपने-आप सिंक कर देता है। एक ही रिकॉर्डेड वीडियो बिना किसी अतिरिक्त शूटिंग के एक ग्लोबल कैंपेन बन जाता है।
बिना अनुपातिक लागत के स्केल
पारंपरिक वीडियो प्रोडक्शन लीनियर तरीके से स्केल होता है: ज़्यादा वीडियो का मतलब ज़्यादा स्टूडियो टाइम, ज़्यादा प्रेज़ेंटर फ़ीस और ज़्यादा एडिटिंग घंटे। AI प्रेज़ेंटर प्रोडक्शन इस तरह स्केल नहीं होता। एक बार आपका वर्कफ़्लो सेट हो जाए, तो 50 प्रेज़ेंटर वीडियो बनाने में लगभग उतनी ही प्रति-यूनिट मेहनत लगती है जितनी 5 बनाने में। हाई-वॉल्यूम कंटेंट ऑपरेशन (ई-लर्निंग प्लेटफ़ॉर्म, प्रोडक्ट कैटलॉग, सोशल मीडिया टीमें) के लिए यह फ़र्क बहुत मायने रखता है।
हर बार एक जैसा आउटपुट
इंसानी प्रेज़ेंटर के भी ख़राब दिन होते हैं। AI प्रेज़ेंटर के नहीं होते। हर वीडियो में एक जैसी एनर्जी, एक जैसा फ़्रेमिंग और एक जैसी डिलीवरी की रफ़्तार होती है। एक बड़ी कंटेंट लाइब्रेरी में ब्रांड की एकरूपता के लिए इस भरोसेमंदी की असली कीमत है। आज बने वीडियो में प्रेज़ेंटर वैसा ही दिखता है जैसा छह महीने बाद बने वीडियो में।
ध्यान देने वाली बात: AI प्रेज़ेंटर स्क्रिप्टेड, डायरेक्ट-टू-कैमरा कंटेंट के लिए सबसे अच्छा काम करते हैं। जिस कंटेंट में असली फ़िज़िकल परफ़ॉर्मेंस, इम्प्रोवाइज़ेशन या रियल-टाइम ऑडियंस इंटरैक्शन चाहिए, उसके लिए अब भी एक असली इंसान ही बेहतर है।
वे मॉडल जो सचमुच नतीजे देते हैं
सभी लिपसिंक और अवतार टूल्स एक जैसी क्वालिटी नहीं देते। कुछ तेज़ होते हैं पर थोड़े खुरदुरे। कुछ धीमे होते हैं पर लगभग ब्रॉडकास्ट-क्वालिटी आउटपुट देते हैं। अभी उपलब्ध मुख्य विकल्पों का ब्योरा यहाँ है।
लिपसिंक टूल्स: किसी भी चेहरे को एनिमेट करें
ये मॉडल किसी मौजूदा इमेज या वीडियो को लेते हैं और होंठों की हरकत को ऑडियो ट्रैक से सिंक करते हैं। पूरे वीडियो में चेहरा आपकी सोर्स फ़ोटो से मेल खाता रहता है।
अवतार और कैरेक्टर एनिमेशन टूल्स
ये आगे जाते हैं, पूरी तरह एनिमेटेड कैरेक्टर बनाते हैं या लंबे वीडियो सीक्वेंस में एक्सप्रेसिव मोशन जनरेट करते हैं।
- Dreamactor M2.0 किसी भी कैरेक्टर को डिटेल्ड बॉडी मोशन के साथ एनिमेट करता है, जब आप स्टैटिक टॉकिंग हेड से आगे की मूवमेंट चाहते हैं तब काम आता है।
- Kling Avatar v2 किसी भी चेहरे को नेचुरल माइक्रो-एक्सप्रेशन और हेड मूवमेंट वाले वीडियो प्रेज़ेंटर में बदलता है।
- Video Agent by HeyGen एक टेक्स्ट प्रॉम्प्ट लेता है और वॉइसओवर, बी-रोल कट और ट्रांज़िशन के साथ एक पॉलिश्ड AI प्रेज़ेंटर वीडियो बनाता है। यह उन चुनिंदा टूल्स में से है जो सिर्फ़ चेहरे का एनिमेशन नहीं, बल्कि पूरा वीडियो स्ट्रक्चर संभालते हैं।
- Avatar IV आपको एक ही फ़ोटो से कस्टम टॉकिंग अवतार बनाने देता है, जो एक जैसी ब्रांडेड प्रेज़ेंटर पहचान बनाने के लिए आदर्श है।
PicassoIA पर Omni Human 1.5 कैसे इस्तेमाल करें
ByteDance का Omni Human 1.5 अभी उपलब्ध सबसे सक्षम फ़ोटो-से-वीडियो लिपसिंक मॉडलों में से एक है। यह किसी ऑडियो ट्रैक से मेल खाती एक स्टिल इमेज से रियलिस्टिक चेहरे का एनिमेशन बनाता है। शुरू से लेकर एक्सपोर्ट किए गए वीडियो तक का पूरा वर्कफ़्लो यहाँ है।
स्टेप 1: अपना पोर्ट्रेट तैयार करें
आपकी सोर्स फ़ोटो को इन मापदंडों पर खरा उतरना चाहिए:
- सामने से या हल्के कोण वाला पोर्ट्रेट जिसमें चेहरा साफ़ दिखे
- पूरे चेहरे पर एक जैसी लाइटिंग, एक तरफ़ भारी छाया न हो
- कम से कम 512x512 पिक्सल (ज़्यादा रिज़ॉल्यूशन से एनिमेशन आउटपुट ज़्यादा शार्प होता है)
- बेहतर लैंडमार्क डिटेक्शन के लिए चेहरा फ़्रेम के कम से कम 40% हिस्से में हो
अगर आपके पास कोई सही पोर्ट्रेट नहीं है, तो पहले PicassoIA के किसी भी टेक्स्ट-टू-इमेज मॉडल से एक बनाएँ। न्यूट्रल लाइटिंग और सादे बैकग्राउंड वाला AI-जनरेटेड चेहरा मॉडल के लिए आदर्श इनपुट कंडीशन देता है।
स्टेप 2: अपना ऑडियो तैयार करें
वॉइस ट्रैक के लिए आपके पास दो विकल्प हैं:
- अपनी आवाज़ रिकॉर्ड करें: एक शांत कमरे में अच्छे माइक्रोफ़ोन से की गई साफ़ रिकॉर्डिंग अच्छा काम करती है। ऐसे कमरों से बचें जिनकी सख़्त दीवारें गूँज पैदा करती हैं। MP3 या WAV में एक्सपोर्ट करें।
- टेक्स्ट-टू-स्पीच से जनरेट करें: PicassoIA ऐसे टेक्स्ट-टू-स्पीच मॉडल देता है जो आपकी लिखी स्क्रिप्ट को प्राकृतिक लगने वाली आवाज़ में बदलते हैं। इसका मतलब है कि आपका पूरा वर्कफ़्लो एक ही जगह रहता है और रिवीज़न तुरंत हो जाते हैं।
एक ज़रूरी बात: सिर्फ़ वॉइस ट्रैक ही अपलोड करें। जो ऑडियो फ़ाइल आप अपलोड करते हैं उसमें बैकग्राउंड म्यूज़िक न रखें। मॉडल मुँह की एनिमेशन चलाने के लिए पूरी वेवफ़ॉर्म पढ़ता है, और म्यूज़िक की फ़्रीक्वेंसी गलत मुँह के आकार पैदा करेंगी।
स्टेप 3: मॉडल चलाएँ
- PicassoIA पर Omni Human 1.5 खोलें
- अपनी पोर्ट्रेट फ़ोटो इमेज इनपुट फ़ील्ड में अपलोड करें
- अपनी साफ़ वॉइस ऑडियो फ़ाइल अपलोड करें
- नेचुरल मूवमेंट के लिए मोशन इंटेंसिटी 0.5 रखें; ज़्यादा एक्सप्रेसिव एनिमेशन और ज़्यादा दिखने वाली हेड मूवमेंट के लिए 0.7 करें
- सोशल क्लिप के लिए आउटपुट रिज़ॉल्यूशन 720p, या प्रोफेशनल डिलीवरेबल के लिए 1080p रखें
- जनरेट करें
ऑडियो की लंबाई के हिसाब से प्रोसेसिंग में लगभग 60 से 120 सेकंड लगते हैं।
स्टेप 4: रिव्यू और सुधार करें
आउटपुट देखें और इन बातों की जाँच करें:
- पूरे ऑडियो में मुँह की हरकतें व्यंजन और स्वरों से सही मेल खाएँ
- वाक्यों के बीच स्वाभाविक पलकें झपकना और हल्की हेड माइक्रो-मूवमेंट
- जबड़े, बालों की रेखा या गर्दन के आसपास कोई डिस्टॉर्शन आर्टिफ़ैक्ट न हो
अगर कुछ खास अक्षरों पर सिंक थोड़ा गड़बड़ लगे, तो अलग सीड वैल्यू के साथ दोबारा जनरेट करें। अगर मुँह की हरकत कड़ी या मशीन जैसी लगे, तो मोशन पैरामीटर बढ़ाएँ। 90 सेकंड से लंबी स्क्रिप्ट के लिए ऑडियो को 30-सेकंड के हिस्सों में बाँटें, हर हिस्से को अलग-अलग जनरेट करें, फिर किसी भी स्टैंडर्ड वीडियो एडिटर में क्लिप जोड़ दें।
टिप: सबसे नेचुरल नतीजों के लिए ऐसा ऑडियो चुनें जिसमें बोलने वाला वाक्यों के बीच थोड़ा रुकता हो। वे स्वाभाविक साँस के ठहराव मॉडल को वाक्यांशों के बीच साफ़ सीमाएँ देते हैं और कुल सिंक क्वालिटी बेहतर बनाते हैं।
अपने प्रेज़ेंटर के लिए सही आवाज़ चुनें
एक रियलिस्टिक AI प्रेज़ेंटर वीडियो उतना ही विश्वसनीय होता है जितनी उसके पीछे की आवाज़। चेहरे का एनिमेशन ऑडियो वेवफ़ॉर्म से चलता है, इसलिए नेचुरल लगने वाली आवाज़ सपाट और रोबोटिक आवाज़ से बेहतर होंठ-मूवमेंट देती है।
PicassoIA के टेक्स्ट-टू-स्पीच मॉडल लिखी स्क्रिप्ट को नेचुरल पेसिंग और इनफ़्लेक्शन वाली इंसानी आवाज़ में बदलते हैं। अपनी आवाज़ रिकॉर्ड करने की तुलना में इसका फ़ायदा यह है कि आप बिना कुछ दोबारा रिकॉर्ड किए स्क्रिप्ट पर काम कर सकते हैं और सेकंडों में ऑडियो फिर से जनरेट कर सकते हैं। एक वाक्य बदलें, आवाज़ दोबारा जनरेट करें, लिपसिंक दोबारा चलाएँ। पूरा रिवीज़न साइकल दो मिनट से कम लेता है और पिछले काम को कोई नुकसान नहीं पहुँचाता।
इंटरनेशनल कंटेंट के लिए, Video Translate किसी भी लिपसिंक वर्कफ़्लो के साथ शानदार तरीके से जुड़ता है। एक बार आपके पास अंग्रेज़ी प्रेज़ेंटर वीडियो हो जाए, तो ट्रांसलेशन टूल उसे किसी दूसरी भाषा में री-डब करता है और होंठों की हरकत को नए ऑडियो से अपने-आप फिर से सिंक करता है। एक प्रोडक्शन वर्कफ़्लो आपकी हर ज़रूरी मार्केट तक पहुँचता है, बिना अतिरिक्त शूटिंग के।
हाई-वॉल्यूम क्रिएटर्स के लिए एक उपयोगी कॉम्बिनेशन: तेज़ ड्राफ़्ट रिव्यू के लिए Lipsync Speed का इस्तेमाल करें, जहाँ आप स्क्रिप्ट और पेसिंग जाँचते हैं, फिर प्रकाशित वर्ज़न के लिए अंतिम संस्करण को Lipsync Precision या Lipsync 2 Pro से दोबारा चलाएँ। इससे जनरेशन क्रेडिट बचते हैं और अंत में भी पॉलिश्ड आउटपुट मिलता है।
असली दुनिया के उपयोग
AI प्रेज़ेंटर वीडियो कंटेंट फ़ॉर्मेट की एक विस्तृत रेंज में काम करते हैं। ये वे स्थितियाँ हैं जहाँ ये सबसे ज़्यादा व्यावहारिक फ़ायदा देते हैं।
प्रोडक्ट डेमो और मार्केटिंग वीडियो
एक स्पोक्सपर्सन प्रोडक्ट का परिचय देता है, फ़ीचर्स समझाता है और कॉल टू एक्शन देता है। इस फ़ॉर्मेट का पारंपरिक प्रोडक्शन एक प्रेज़ेंटर, एक स्टूडियो और एक कैमरा ऑपरेटर बुक करने की माँग करता है। AI प्रेज़ेंटर के साथ आप स्क्रिप्ट लिखते हैं, चेहरा चुनते हैं और 10 मिनट के अंदर वीडियो तैयार हो जाता है। जब प्रोडक्ट अपडेट होता है, तो आप स्क्रिप्ट अपडेट करते हैं और सिर्फ़ बदले हुए सेगमेंट दोबारा जनरेट करते हैं।
ई-लर्निंग और कॉर्पोरेट ट्रेनिंग
ऑनलाइन कोर्स को हर मॉड्यूल में एक जैसे प्रेज़ेंटर चेहरे से बहुत फ़ायदा होता है। जिन कोर्सों में कंटेंट अपडेट होने पर प्रेज़ेंटर को हर बार दोबारा रिकॉर्ड करना पड़ता था, उन्हें अब सिर्फ़ एक ऑडियो सेगमेंट जनरेट करके और लिपसिंक दोबारा चलाकर रिवाइज़ किया जा सकता है। 12 महीनों में रिकॉर्ड किए गए 40 मॉड्यूल वाले कोर्स में एक ही इंस्ट्रक्टर हर जगह एक जैसा दिखे, यह सिर्फ़ AI प्रेज़ेंटर से ही संभव है।
शॉर्ट-फ़ॉर्म सोशल मीडिया
सोशल प्लेटफ़ॉर्म के छोटे वीडियो में आम तौर पर बोलता हुआ चेहरा चाहिए होता है। AI प्रेज़ेंटर टूल्स किसी भी स्क्रिप्ट से मिनटों में एक टॉकिंग-हेड क्लिप बनाते हैं। कई सोशल अकाउंट्स संभालने वाली या रोज़ पोस्ट करने वाली टीमों के लिए इसका मतलब है कि प्रेज़ेंटर-आधारित कंटेंट एक ऐसी मात्रा में मिलता है जो पारंपरिक रिकॉर्डिंग शेड्यूल से असंभव होती।
ध्यान देने वाली बात: Lipsync 2 अपनी तेज़ प्रोसेसिंग और 60 सेकंड से छोटी क्लिप पर साफ़ आउटपुट के कारण शॉर्ट-फ़ॉर्म वीडियो के लिए अच्छा है।
बड़े पैमाने पर मल्टीलिंगुअल कंटेंट
हर टारगेट भाषा में वीडियो के अलग-अलग वर्ज़न शूट करने के बजाय, आप एक बार प्रोड्यूस करते हैं और लिपसिंक टूल्स से उसे लोकलाइज़ करते हैं। Video Translate ट्रांसलेशन और री-सिंक दोनों अपने-आप संभालता है। एक ही प्रेज़ेंटर वीडियो बिना किसी अतिरिक्त प्रोडक्शन लागत के 10 क्षेत्रीय मार्केट्स में चल सकता है।
आउटपुट क्वालिटी को क्या प्रभावित करता है
हर AI प्रेज़ेंटर वीडियो पहली कोशिश में पॉलिश्ड नहीं निकलता। ये कारक नतीजे पर सीधा असर डालते हैं:
सोर्स फ़ोटो की क्वालिटी
- ज़्यादा रिज़ॉल्यूशन वाली फ़ोटो से ज़्यादा शार्प और डिटेल्ड एनिमेशन बनता है
- चेहरे पर एक जैसी लाइटिंग से एनिमेटेड आउटपुट में शैडो आर्टिफ़ैक्ट से बचाव होता है
- तेज़ साइड-लाइटिंग, भारी स्टाइलाइज़्ड फ़िल्टर, या ऐसी फ़ोटो से बचें जिनमें चेहरा आंशिक रूप से ढका हो
ऑडियो की स्पष्टता
- बिना बैकग्राउंड नॉइज़ वाली साफ़ वॉइस रिकॉर्डिंग से बेहतर होंठ-सिंक मिलता है
- नेचुरल लगने वाली आवाज़ें (अच्छे टेक्स्ट-टू-स्पीच या अच्छे माइक्रोफ़ोन से) ज़्यादा ऑर्गेनिक चेहरे की हरकत देती हैं
- वाक्यों के बीच छोटे नेचुरल ठहराव मॉडल को साँस लेने और मुँह को सही तरह रीसेट करने में मदद करते हैं
मॉडल का चुनाव
- तेज़ मॉडल स्पीड के बदले थोड़ी सटीकता छोड़ते हैं; उन्हें ड्राफ़्ट और सोशल कंटेंट के लिए इस्तेमाल करें जहाँ लगभग परफ़ेक्ट सिंक ज़रूरी न हो
- Lipsync Precision और Lipsync 2 Pro जैसे प्रिसिज़न मॉडल फ़ाइनल प्रोफेशनल डिलीवरेबल के लिए अतिरिक्त प्रोसेसिंग समय के लायक हैं
स्क्रिप्ट की बनावट
- छोटी, सेगमेंटेड स्क्रिप्ट लंबी एकल ऑडियो फ़ाइलों से ज़्यादा एकसार नतीजे देती हैं
- नेचुरल वाक्य-लय और साफ़ उच्चारण वाली स्क्रिप्ट रन-ऑन वाक्यों या भारी तकनीकी शब्दावली से बेहतर मुँह एनिमेशन देती हैं
पहली बार में लोगों की 3 आम गलतियाँ
कम क्वालिटी या स्टाइलाइज़्ड सोर्स फ़ोटो इस्तेमाल करना। बहुत ज़्यादा फ़िल्टर वाली फ़ोटो या कम रिज़ॉल्यूशन का हेडशॉट धुंधला, आर्टिफ़ैक्ट से भरा एनिमेशन देता है। सबसे साफ़ और सबसे नेचुरल पोर्ट्रेट से शुरू करें। अगर वह उपलब्ध न हो, तो PicassoIA के किसी भी इमेज मॉडल से एक फ़ोटोरियलिस्टिक चेहरा जनरेट करें।
ऐसा ऑडियो देना जिसमें बैकग्राउंड म्यूज़िक हो। कुछ यूज़र लिपसिंक टूल में अपलोड की गई ऑडियो फ़ाइल में बैकग्राउंड म्यूज़िक या एम्बिएंट साउंड रख देते हैं। मॉडल मुँह की एनिमेशन चलाने के लिए सिर्फ़ वॉइस फ़्रीक्वेंसी नहीं, बल्कि पूरी ऑडियो वेवफ़ॉर्म का विश्लेषण करता है। बैकग्राउंड म्यूज़िक विश्लेषण को भ्रमित करता है और गलत मुँह के आकार बनाता है। सिर्फ़ साफ़ वॉइस ट्रैक दें।
पहले आउटपुट को फ़ाइनल मान लेना। हर जनरेशन में कुछ अंतर होता है। असामान्य व्यंजन समूह या तेज़ बोली जाने वाली डिलीवरी कभी-कभी किसी खास शब्द पर थोड़े अप्राकृतिक मुँह के आकार बना देती है। अलग सीड वैल्यू के साथ दोबारा जनरेट करने, या स्क्रिप्ट का एक वाक्य फिर से लिखने से ज़्यादातर मामले एक या दो प्रयासों में ठीक हो जाते हैं।
आज ही अपना पहला प्रेज़ेंटर वीडियो बनाएँ
AI प्रेज़ेंटर वीडियो का वर्कफ़्लो यह है: चेहरा चुनें, आवाज़ दें, लिपसिंक मॉडल चलाएँ। बस इतना ही। किसी तकनीकी पृष्ठभूमि, स्पेशलिस्ट सॉफ़्टवेयर या प्रोडक्शन उपकरण की ज़रूरत नहीं।
शुरू करने का सबसे तेज़ तरीका PicassoIA पर Omni Human 1.5 है। एक पोर्ट्रेट अपलोड करें, 30 सेकंड की स्क्रिप्ट रिकॉर्ड करें, और देखें कि मॉडल क्या बनाता है। वह पहला आउटपुट आपको दिखा देगा कि आज क्या संभव है।
आगे बढ़ने के लिए, किसी भी टेक्स्ट-टू-इमेज मॉडल से बने AI चेहरे को PicassoIA के टेक्स्ट-टू-स्पीच टूल्स की आवाज़ और अपनी स्क्रिप्ट के साथ जोड़ें। हर तत्व AI-जनरेटेड है, एक ही जगह बना है, और प्रकाशन के लिए तैयार है। किसी भी चरण पर असली दुनिया के इनपुट की ज़रूरत नहीं।
कई भाषाओं में कंटेंट बनाने वाली टीमों के लिए, Video Translate को Lipsync Speed के साथ जोड़ें और बड़े पैमाने पर लोकलाइज़ करें। एक वर्कफ़्लो, कई मार्केट्स, बिना अतिरिक्त शूटिंग के।
मॉडल इतने तेज़ हैं कि इटरेशन की लागत लगभग शून्य है। अलग-अलग चेहरे, अलग-अलग आवाज़ें, अलग-अलग मोशन इंटेंसिटी सेटिंग्स आज़माएँ। कुछ ही जनरेशन में आपको वह संयोजन मिल जाएगा जो आपके कंटेंट और दर्शकों पर फ़िट बैठता है, और उसके बाद आपका हर वीडियो तेज़ी से बनेगा।
PicassoIA इन सभी टूल्स को एक ही प्लेटफ़ॉर्म पर लाता है: चेहरा जनरेट करने से लेकर टेक्स्ट-टू-स्पीच, लिपसिंक और वीडियो ट्रांसलेशन तक। अगर प्रोडक्शन बहुत जटिल या महँगा लगने के कारण आप अपने वीडियो में प्रेज़ेंटर जोड़ना टालते रहे हैं, तो अब वह रुकावट नहीं रही।


