आपके सपोर्ट एजेंट ने अभी एक ग्राहक को बताया कि रिफ़ंड की अवधि 30 दिन है। पिछले महीने पॉलिसी बदलकर 14 दिन हो गई थी। एक घंटे बाद, दूसरे एजेंट से असल में रिफ़ंड जारी करने को कहा गया, तो उसने रिफ़ंड कैसे काम करते हैं, इस पर एक विनम्र पैराग्राफ़ लिख दिया। एक एजेंट के पास जानकारी नहीं थी। दूसरे के पास हाथ नहीं थे। ये दोनों विफलताएँ MCP बनाम RAG की पूरी बहस के पीछे हैं, और इन्हीं की वजह से टीमें इस पर बहस करती हैं कि किसे अपनाएँ, जबकि ईमानदार जवाब इस पर निर्भर है कि उनकी कमी कौन सी है।
यह लेख MCP और RAG के बीच अंतर को सरल भाषा में समझाता है, लागत, लेटेंसी, सुरक्षा और सटीकता के आधार पर दोनों की तुलना करता है, और आपके AI एजेंट्स के लिए चुनाव करने का एक आसान तरीका देता है। संक्षेप में: RAG मॉडल को पढ़ने के लिए तथ्य देता है। MCP उसे इस्तेमाल करने के लिए टूल्स देता है। ज़्यादातर प्रोडक्शन एजेंट्स को दोनों की ज़रूरत पड़ती है, और दिलचस्प हिस्सा यह है कि इन्हें साथ कैसे जोड़ा जाए।
RAG असल में क्या करता है
Retrieval-augmented generation, यानी RAG, को Facebook AI Research के 2020 के एक शोध पत्र (Lewis et al.) में पेश किया गया था। इसका विचार आसानी से समझाया जा सकता है। मॉडल के जवाब देने से पहले एक रिट्रीवल स्टेप बाहरी स्रोत में प्रासंगिक अंश ढूँढता है और उन्हें प्रॉम्प्ट में डाल देता है। फिर मॉडल सिर्फ़ उसी ट्रेनिंग पर निर्भर रहने के बजाय इन्हीं अंशों के आधार पर जवाब देता है।
एक ऐसे लाइब्रेरियन की कल्पना करें जो आपके लिखना शुरू करने से पहले तीन प्रासंगिक किताबें ले आता है। लिखने का काम आप ही करते हैं, पर अब सही पन्ने आपके सामने खुले होते हैं।
रिट्रीवल कैसे काम करता है, चरण दर चरण
एक सामान्य RAG पाइपलाइन दो चरणों में चलती है।
इंडेक्सिंग, जो पहले से कर ली जाती है:
- अपने स्रोत इकट्ठा करें: PDF, वेब पेज, सपोर्ट टिकट, प्रोडक्ट डॉक्स।
- उन्हें chunks में बाँटें, आमतौर पर हर एक कुछ सौ टोकन का।
- हर chunk को एक embedding में बदलें, यानी एक वेक्टर जो उसका अर्थ पकड़ता है।
- वेक्टर्स को मूल टेक्स्ट के साथ एक vector database में स्टोर करें।
क्वेरी के समय, हर सवाल पर:
- उपयोगकर्ता के सवाल को उसी embedding मॉडल से embed करें।
- सबसे नज़दीकी chunks के लिए semantic search चलाएँ, जिसे अक्सर exact-match search (BM25) के साथ मिलाया जाता है, ताकि प्रोडक्ट के नाम और एरर कोड भी मिल सकें।
- चाहें तो एक छोटे, ज़्यादा तेज़ मॉडल से परिणामों को rerank करें।
- शीर्ष chunks को प्रॉम्प्ट में डालें और आदर्श रूप से citations के साथ जवाब जनरेट करें।
💡 क्लासिक RAG में मॉडल कभी यह तय नहीं करता कि कुछ खोजना है। आपका कोड रिट्रीव करता है, और मॉडल पढ़ता है। इसी वजह से RAG अनुमानित रहता है, टेस्ट करना सस्ता होता है और डीबग करना आसान होता है।
RAG कहाँ चमकता है
- निजी जानकारी। इंटरनल विकी, कॉन्ट्रैक्ट और मैनुअल कभी ट्रेनिंग डेटा में नहीं थे। RAG बिना कुछ दोबारा ट्रेन किए उन्हें मॉडल के सामने रख देता है।
- ग्राउंडेड जवाब। जब मॉडल किसी रिट्रीव किए गए अंश का हवाला देता है, तो हैलुसिनेशन घटते हैं और उपयोगकर्ता स्रोत जाँच सकते हैं।
- सस्ते अपडेट। किसी एक बदले हुए दस्तावेज़ को दोबारा इंडेक्स करें, और अगला जवाब उसे दिखाएगा।
- विशाल कॉर्पोरा। लाखों पेज कभी किसी कॉन्टेक्स्ट विंडो में नहीं आएँगे, लेकिन एक रिट्रीवर मिलीसेकंड में सही दस पैराग्राफ़ निकाल सकता है।
- Citations। हर जवाब किसी दस्तावेज़ की ओर इशारा कर सकता है, जो कानूनी, मेडिकल और सपोर्ट सेटिंग्स में मायने रखता है।
RAG कहाँ टूटता है
RAG एक केवल-पढ़ने वाला पैटर्न है, और इसकी गुणवत्ता इसके रिट्रीवल स्टेप तक सीमित है। अगर सही chunk रिट्रीव नहीं हुआ, तो मॉडल उसका इस्तेमाल नहीं कर सकता, और आम तौर पर नतीजा एक आत्मविश्वास भरा गलत जवाब होता है।
आम विफलता के बिंदु:
- खराब chunking। दो chunks में बँटी एक प्राइसिंग टेबल अपना अर्थ खो देती है।
- पुराने इंडेक्स। इंडेक्स उतना ही ताज़ा होता है जितना उसका आख़िरी इनजेशन रन।
- एग्रीगेशन वाले सवाल। "पिछले हफ़्ते हमने कितने टिकट बंद किए?" के लिए गणना चाहिए, तीन मिलते-जुलते पैराग्राफ़ नहीं।
- मल्टी-हॉप सवाल। जब जवाब के लिए चार दस्तावेज़ों के तथ्य चाहिए, तो top-k रिट्रीवल अक्सर सिर्फ़ दो ही ढूँढ पाता है।
- कोई कार्रवाई नहीं। RAG बता सकता है कि ऑर्डर कैसे कैंसल करें। वह उसे कैंसल नहीं कर सकता।
MCP असल में क्या करता है
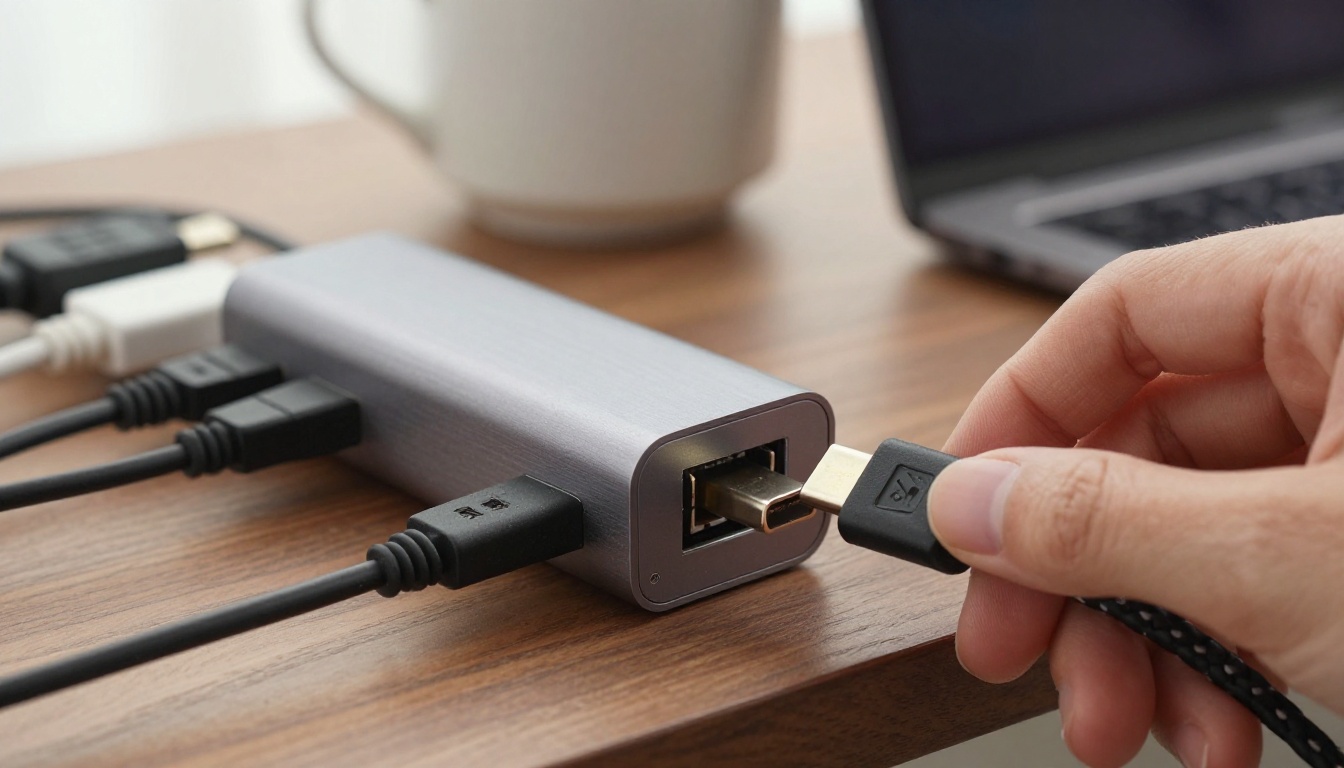
Model Context Protocol (MCP) एक ओपन स्टैंडर्ड है, जिसे Anthropic ने नवंबर 2024 में पेश किया था। यह AI एप्लिकेशन को बाहरी टूल्स और डेटा से जोड़ने का एक साझा तरीका तय करता है। लोग इसे अक्सर AI ऐप्स के लिए USB-C पोर्ट कहते हैं, और यह तुलना सही बैठती है: MCP से पहले, हर ऐप और सेवा की हर जोड़ी को एक कस्टम इंटीग्रेशन चाहिए था। MCP के साथ आप एक सर्वर बनाते हैं, और कोई भी संगत क्लाइंट उसे इस्तेमाल कर सकता है।
प्रोटोकॉल सरल शब्दों में
इसमें तीन भूमिकाएँ होती हैं:
- Host: वह AI ऐप जिससे उपयोगकर्ता बात करता है, जैसे चैट ऐप या कोड एडिटर।
- Client: होस्ट के अंदर का कनेक्शन मैनेजर। एक क्लाइंट एक ही सर्वर से बात करता है।
- Server: एक छोटा प्रोग्राम जो क्षमताएँ उपलब्ध कराता है, डेटाबेस क्वेरी से लेकर इमेज जनरेटर तक।
मैसेज JSON-RPC 2.0 में जाते हैं। लोकल सर्वर आमतौर पर stdio पर बात करते हैं, और रिमोट सर्वर HTTP इस्तेमाल करते हैं। एजेंट सर्वर से पूछता है कि उसके पास क्या है, मॉडल तय करता है कि क्या कॉल करना है, और सर्वर एक स्ट्रक्चर्ड परिणाम लौटाता है।
Tools, Resources और Prompts
एक MCP सर्वर तीन तरह की चीज़ें उपलब्ध करा सकता है:
| Primitive | यह क्या है | इसे कौन नियंत्रित करता है | उदाहरण |
|---|
| Tools | वे फ़ंक्शन जिन्हें मॉडल कॉल कर सकता है | मॉडल | create_issue, query_orders, generate_image |
| Resources | केवल-पढ़ने योग्य डेटा जिसे ऐप अटैच कर सके | एप्लिकेशन | एक फ़ाइल, डेटाबेस रिकॉर्ड, एक लॉग |
| Prompts | दोबारा इस्तेमाल होने वाले टेम्पलेट | उपयोगकर्ता | एक "इस pull request की समीक्षा करें" वर्कफ़्लो |
ज़्यादातर काम Tools में होता है। यही टूल्स मॉडल को बोलने वाली चीज़ से करने वाली चीज़ में बदल देते हैं।
MCP कहाँ कम पड़ता है
MCP एक कनेक्शन स्टैंडर्ड है, नॉलेज सिस्टम नहीं। यह तय नहीं करता कि क्या प्रासंगिक है, और यह मॉडल को आपके डेटा के बारे में स्मार्ट नहीं बनाता।
- कोई बिल्ट-इन रिट्रीवल नहीं। अगर आपका टूल
search_docs है, तो उसके पीछे किसी को एक सर्च इंजन बनाना ही पड़ा होगा।
- टूल डेफ़िनिशन कॉन्टेक्स्ट विंडो की बड़ी जगह घेर लेते हैं। हर टूल का नाम, विवरण और स्कीमा मॉडल को भेजा जाता है। एक दर्जन सर्वर जोड़ें, तो उपयोगकर्ता के एक शब्द बोलने से पहले ही हज़ारों टोकन ख़र्च हो जाते हैं, जबकि टूल चुनने में गड़बड़ी और बढ़ जाती है।
- हर कॉल एक और मॉडल टर्न है। पाँच चरणों के काम में कई राउंड ट्रिप लगते हैं, और उनके साथ लेटेंसी और लागत भी।
- बड़ी अटैक सतह। जो टूल लिख, भेज या मिटा सकता है, उसे धोखे से वही करवाया भी जा सकता है।
MCP बनाम RAG आमने-सामने
इन्हें अलग करने का सबसे साफ़ तरीका: RAG मॉडल को टेक्स्ट खिलाने का एक पैटर्न है। MCP मॉडल को सिस्टम से जोड़ने का एक प्रोटोकॉल है। ये अलग-अलग परतों पर काम करते हैं, इसलिए "बनाम" शब्द थोड़ा भ्रामक है। आप MCP के ऊपर RAG भी बना सकते हैं, जैसा आगे दिखेगा।
| कारक | RAG | MCP |
|---|
| यह क्या है | एक रिट्रीवल पैटर्न | एक ओपन कनेक्शन प्रोटोकॉल |
| मुख्य काम | मॉडल को जानकारी देना | मॉडल को क्षमताएँ देना |
| दिशा | केवल पढ़ना | पढ़ना और लिखना |
| डेटा की ताज़गी | आख़िरी इंडेक्स रन जितना ताज़ा | कॉल के समय लाइव |
| कौन तय करता है | आमतौर पर आपकी पाइपलाइन | मॉडल टूल चुनता है |
| आम विफलता | गलत या गायब chunk | गलत टूल, खराब आर्गुमेंट, इंजेक्शन |
| सेटअप का प्रयास | इनजेशन, chunking, embeddings, मूल्यांकन | सर्वर लिखना या अपनाना, टूल परिभाषित करना, अनुमतियाँ सेट करना |
| सबसे अच्छा आउटपुट | citations वाला ग्राउंडेड जवाब | पूरी हुई कार्रवाई या लाइव मान |
लेटेंसी और लागत
एक RAG सवाल की लागत एक रिट्रीवल कॉल प्लस एक लंबी मॉडल कॉल होती है। ढाँचा तय रहता है, इसलिए लेटेंसी और खर्च का अनुमान लगाना आसान है।
एक MCP कार्य की लागत हर टूल कॉल के लिए एक मॉडल टर्न, साथ में टूल डेफ़िनिशन पर ख़र्च हुए टोकन होती है। एक साधारण लुकअप में दो टर्न लग सकते हैं। रिट्राई वाले उलझे कार्य में दस तक लग सकते हैं। प्रॉम्प्ट कैशिंग स्कीमा के ओवरहेड को कम करती है, लेकिन MCP एजेंट की लागत सवालों की संख्या से नहीं, चरणों की संख्या से बढ़ती है।
सुरक्षा जोखिम
दोनों तरीकों में एक ख़तरनाक समस्या साझा है: प्रॉम्प्ट इंजेक्शन। किसी रिट्रीव किए गए दस्तावेज़ में छिपे निर्देश हो सकते हैं, और टूल के परिणाम में भी। RAG में नुकसान आम तौर पर एक ग़लत जवाब होता है। MCP में वही चाल एक कार्रवाई शुरू करा सकती है।
- हर सर्वर को न्यूनतम अधिकार दें, जहाँ संभव हो वहाँ केवल-पढ़ने वाला।
- लिखने, भुगतान और मिटाने के लिए मानव अनुमोदन अनिवार्य करें।
- केवल भरोसेमंद सर्वर इंस्टॉल करें, और टूल के विवरण को अविश्वसनीय टेक्स्ट मानें।
- हर टूल कॉल लॉग करें, ताकि आप जाँच सकें कि एजेंट ने क्या किया।
💡 अगर कोई अजनबी आपकी नॉलेज बेस में या किसी टूल के आउटपुट में टेक्स्ट डाल सकता है, तो मान लें कि वह टेक्स्ट एक दिन आपके एजेंट को आदेश देने की कोशिश करेगा।
AI एजेंट्स के लिए कौन सा बेहतर है
एजेंट्स के लिए, यानी ऐसे सिस्टम जो योजना बनाते हैं और कार्य करते हैं, MCP ज़्यादा बुनियादी हिस्सा है। जो एजेंट कुछ छू ही नहीं सकता, वह बस एक अच्छे नाम वाला चैटबॉट है। लेकिन "हमारी कंपनी क्या जानती है?" के सवाल का बेहतर जवाब RAG है। उपयोगी सवाल यह नहीं कि "कौन सा बेहतर है", बल्कि यह है कि "मेरी कमी कौन सी है?"
RAG कब चुनें
- जवाब बड़े टेक्स्ट भंडार में हो, जो धीरे-धीरे बदलता है।
- उपयोगकर्ताओं को citations चाहिए जिन्हें वे जाँच सकें।
- आप हर सवाल पर एक अनुमानित मॉडल कॉल चाहते हैं।
- असिस्टेंट ज़्यादातर जवाब देने का काम करता है, कार्रवाई का नहीं। हेल्प सेंटर बॉट इसका क्लासिक उदाहरण है।
MCP कब चुनें
- एजेंट को लाइव डेटा चाहिए: स्टॉक लेवल, कीमतें, टिकट की स्थिति, कैलेंडर स्लॉट।
- एजेंट को कार्रवाई करनी है: बनाना, अपडेट करना, भेजना, बुक करना या जनरेट करना।
- डेटा ऐसे सिस्टम के पीछे है जिसका API है, जैसे CRM, डेटाबेस या कैलेंडर।
- एजेंट को माँग पर मीडिया बनाना है, जैसे कोई इमेज या छोटा वीडियो।
आम कामों के लिए एक त्वरित निर्णय तालिका:
| काम | बेहतर विकल्प |
|---|
| 5,000 इंटरनल PDF से सवालों के जवाब देना | RAG |
| किसी ऑर्डर की स्थिति जाँचना | MCP |
| पॉलिसी देखना, फिर टिकट अपडेट करना | दोनों |
| माँग पर प्रोडक्ट फ़ोटो जनरेट करना | MCP |
| पुरानी सपोर्ट बातचीत खोजना | RAG |
| एक 40 पेज के कॉन्ट्रैक्ट का सारांश बनाना | कोई नहीं, बस लंबी कॉन्टेक्स्ट विंडो इस्तेमाल करें |
दोनों को साथ इस्तेमाल करना
प्रोडक्शन एजेंट्स शायद ही किसी एक पक्ष को चुनते हैं। वे काम बाँट लेते हैं: RAG नियम और पृष्ठभूमि देता है, MCP तथ्य और कार्रवाइयाँ देता है।
एक हाइब्रिड पैटर्न जो काम करता है
मान लीजिए ग्राहक लिखता है, "मुझसे दो बार चार्ज लिया गया। क्या आप इसे ठीक कर सकते हैं?" एक अच्छी तरह बना एजेंट इसे ऐसे संभालता है:
- RAG: रिफ़ंड और डुप्लिकेट चार्ज की पॉलिसी रिट्रीव करें।
- MCP: ग्राहक के असली चार्ज पढ़ने के लिए बिलिंग टूल कॉल करें।
- रीज़निंग: डुप्लिकेट की पुष्टि करें और उसे पॉलिसी से मिलाएँ।
- MCP: रिफ़ंड टूल कॉल करें, एक तय रकम से ऊपर मानव अनुमोदन के साथ।
- MCP: टिकट पर एक नोट लिखें, ताकि अगला व्यक्ति देख सके कि क्या हुआ।
इनमें से कोई भी तरीका अकेले यह नहीं कर सकता। RAG पॉलिसी दोहराकर रुक जाता। MCP चार्ज देख लेता, पर उसे नहीं पता होता कि पॉलिसी क्या अनुमति देती है।
RAG को MCP टूल के रूप में
अब ज़्यादा से ज़्यादा टीमें रिट्रीवल को ही एक टूल की तरह उपलब्ध करा रही हैं, कुछ ऐसे: search_knowledge_base(query)। इसे अक्सर agentic RAG कहा जाता है। कई वेक्टर डेटाबेस विक्रेता पहले से MCP सर्वर प्रकाशित कर चुके हैं, इसलिए जोड़ना छोटा काम है।
फ़ायदा असली है। एजेंट छोटी बातचीत के लिए रिट्रीवल छोड़ देता है, कमज़ोर क्वेरी को दोबारा लिखता है, और पहली खोज बेकार निकले तो दूसरी खोज चलाता है। कीमत यह है कि मॉडल कॉल बढ़ते हैं, और अब टूल के विवरण की गुणवत्ता बहुत मायने रखती है। एक अस्पष्ट विवरण का मतलब है कि एजेंट या तो कभी नहीं खोजता, या हर चीज़ खोजता है।
💡 एक सरल शॉर्टकट: अगर मॉडल को किसी तथ्य का अनुमान लगाना पड़ेगा, तो रिट्रीवल जोड़ें। अगर उसे कहना पड़ेगा "मैं यह नहीं कर सकता", तो टूल जोड़ें।
एक असली उदाहरण: मीडिया जनरेशन
रिट्रीवल कोई इमेज नहीं बना सकता। वह केवल पहले से मौजूद टेक्स्ट ला सकता है। जिस एजेंट को रनटाइम पर एक तस्वीर या वीडियो बनाना है, उसे एक टूल चाहिए, और इसलिए मीडिया जनरेशन MCP का एक क्लासिक काम है।
PicassoIA इसी तरह काम करता है। इसका डेवलपर API https://api.picassoia.com/v1 पर है और Bearer token इस्तेमाल करता है। वही चार मॉडल API के ज़रिए और Claude में PicassoIA कनेक्टर जैसे MCP कनेक्शनों के ज़रिए भी उपलब्ध हैं:
काम एसिंक्रोनस होते हैं: एजेंट एक prediction बनाता है, फिर उसके पूरा होने तक पोल करता है। एक अकाउंट 5 एक साथ चलने वाले predictions चला सकता है, जो सभी API और MCP कनेक्शनों में साझा होते हैं, इसलिए व्यस्त एजेंट को अपनी रिक्वेस्ट कतार में लगानी चाहिए।
अब तस्वीर में RAG भी जोड़ें। इमेज टूल कॉल करने से पहले एजेंट आपके ब्रांड नोट्स रिट्रीव करता है, जैसे पैलेट, लेंस की शैली और वे विषय जिनसे बचना है, और उन्हें प्रॉम्प्ट में जोड़ता है। RAG अनुरोध को आकार देता है, MCP उसे पूरा करता है।
रीज़निंग परत के लिए, PicassoIA कई लार्ज लैंग्वेज मॉडल सूचीबद्ध करता है जिन्हें आप उसी जगह टेस्ट कर सकते हैं, जिनमें Claude Sonnet 5, GPT 5.6 Sol, Gemini 3.5 Flash और Kimi K2.6 शामिल हैं।
4 गलतियाँ जो टीमें बार-बार करती हैं
- लाइव डेटा के लिए RAG इस्तेमाल करना। कल की इन्वेंटरी का इंडेक्स पूरे भरोसे से वह स्टॉक बताएगा जो आज सुबह बिक चुका है। अगर वैल्यू हर घंटे बदलती है, तो सोर्स से टूल के ज़रिए क्वेरी करें।
- हर MCP सर्वर जोड़ देना जो आपको मिले। कॉन्टेक्स्ट में पचास टूल का मतलब धीमा, महँगा और कम सटीक टूल चयन है। उन तीन से शुरू करें जिनकी आपके काम को ज़रूरत है, और एक-एक करके जोड़ें।
- मूल्यांकन छोड़ देना। 30 से 50 असली सवालों का टेस्ट सेट बनाएँ। RAG के लिए मापें कि सही chunk रिट्रीव हुआ या नहीं। MCP के लिए मापें कि सही टूल वैध आर्गुमेंट्स के साथ चुना गया या नहीं। आँकड़ों के बिना हर बदलाव एक अनुमान है।
- बाहर के टेक्स्ट पर भरोसा करना। रिट्रीव किए गए अंश और टूल के परिणाम डेटा हैं, कभी निर्देश नहीं। उन्हें अपने सिस्टम प्रॉम्प्ट से साफ़ तौर पर अलग रखें, और हर लिखने वाले काम पर अनुमोदन लगाएँ।
PicassoIA पर आज़माएँ
जानकारी और कार्रवाई के फ़र्क को महसूस करने का सबसे तेज़ तरीका है एजेंट को एक टूल दें और देखें कि क्या बदलता है। एक साधारण चैटबॉट से प्रोडक्ट फ़ोटो माँगें, तो आपको उसका विवरण मिलेगा। उसे किसी इमेज मॉडल से जोड़ें, तो आपको फ़ोटो मिलेगी।
PicassoIA खोलें और खुद आज़माएँ:
फिर एजेंट को उन्हीं मॉडलों से जोड़ें और उसे जनरेट करने का काम करने दें। एक छोटा काम चुनें, जैसे सोशल पोस्ट लिखना और उसकी इमेज बनाना, और देखें कि उसे कितने कम चरण लगते हैं। यह एक प्रयोग MCP और RAG के बारे में तुलना-लेख पढ़ने में एक और हफ़्ता लगाने से ज़्यादा सिखा देगा।


