आपने अपने गेम के विलेन, पॉडकास्ट के मैस्कॉट या बच्चे की सोने से पहले की कहानी के लिए डायलॉग की एक लाइन टाइप की, और डिफ़ॉल्ट रोबोट वॉइस उसे किसी बैंक की घोषणा की तरह पढ़ गई। यही फ़र्क है सादे टेक्स्ट टू स्पीच और टेक्स्ट टू कैरेक्टर वॉइस में। पहला शब्द पढ़ता है, दूसरा उन्हें निभाता है, एक खास कैरेक्टर की पर्सनैलिटी, मूड और लय के साथ।
अच्छी खबर यह है कि अब वहाँ पहुँचने के लिए स्टूडियो, एक्टर्स की टीम या बड़े बजट की ज़रूरत नहीं है। कई मुफ़्त ऑनलाइन टूल अब आपको एक प्रीसेट पर्सनैलिटी चुनने, सादी भाषा में वॉइस का वर्णन करने, या अनुमति के साथ एक छोटी क्लिप से वॉइस क्लोन करने देते हैं। इनके पीछे की सेटिंग्स (भावना, गति, पिच, विराम, रैंडमनेस) तय करती हैं कि नतीजा जीवंत लगेगा या सपाट।
यह आर्टिकल समझाता है कि कैरेक्टर वॉइस जनरेशन असल में क्या है, कौन से टूल आपका समय लायक हैं, हर वॉइस सेटिंग नतीजे को कैसे बदलती है, और तीन ऐसे उदाहरण जिन्हें आप कॉपी कर सकते हैं। नीचे दी गई हर चीज़ PicassoIA की टेक्स्ट टू स्पीच कलेक्शन पर आज़माई जा सकती है।
टेक्स्ट टू कैरेक्टर वॉइस का मतलब क्या है
स्टैंडर्ड टेक्स्ट टू स्पीच का लक्ष्य तटस्थ स्पष्टता होता है। कैरेक्टर वॉइस जनरेशन का लक्ष्य पहचान है। आप चाहते हैं कि नाम लिए जाने से पहले ही श्रोता को पता चल जाए कि कौन बोल रहा है।
नैरेशन बनाम कैरेक्टर स्पीच
नैरेशन स्थिर होता है। पेसिंग एक-सी रहती है, भावना हल्की रहती है, और वॉइस पीछे रहती है, आगे नहीं आती। कैरेक्टर स्पीच इसके उलट होती है: वह अपनी खासियतों को खुलकर अपनाती है। एक खुरदुरी आवाज़ वाला रिटायर्ड नाविक धीरे बोलता है और लंबे विराम लेता है। एक हाइपरएक्टिव साइडकिक जल्दी-जल्दी बोलता है, पिच पर उछलता है और शब्दों में अटकता है।
जो टूल दोनों संभाल सके, उसमें तीन चीज़ें होनी चाहिए:
- अलग टिम्बर वाली वॉइस, जैसे गहरी, हवादार, नाक से निकली या गर्म।
- डिलीवरी के कंट्रोल, जैसे भावना, गति और पिच।
- पर्याप्त टेक्स्ट संवेदनशीलता, ताकि वह विराम चिह्नों, बड़े अक्षरों और स्टेज डायरेक्शन पर प्रतिक्रिया दे सके।
इसका उपयोग कौन करता है
इसके दर्शक जितने लोग सोचते हैं, उससे कहीं ज़्यादा हैं।
| उपयोग का मामला | वॉइस को क्या चाहिए |
|---|
| इंडी गेम्स और विज़ुअल नॉवेल | कई अलग-अलग वॉइस, सैकड़ों लाइनों में एक-सी |
| YouTube और शॉर्ट वीडियो | जल्दी तैयार होना, अभिव्यंजक डिलीवरी |
| ऑडियोबुक और सोने की कहानियाँ | गर्मजोशी, साफ़ पेसिंग, हर कैरेक्टर की अलग वॉइस |
| भाषा सिखाना | साफ़ उच्चारण, कई भाषाएँ |
| पॉडकास्ट और मascot | पहचानी जा सकने वाली सिग्नेचर वॉइस |
| एक्टर्स के लिए प्रोटोटाइप स्क्रिप्ट | कास्टिंग से पहले डायलॉग परखने के लिए तेज़ ड्राफ़्ट |
💡 टिप: अगर आपको ड्राफ़्ट के लिए सिर्फ़ एक वॉइस चाहिए, तो स्पीड परफ़ेक्शन से ज़्यादा मायने रखती है। पाँच टेक बनाएँ, सबसे अच्छा चुनें और आगे बढ़ें।
आज़माने लायक मुफ़्त ऑनलाइन टूल
हर टूल कैरेक्टर को अच्छी तरह नहीं संभालता। कुछ कॉल सेंटर और ऑडियोबुक के लिए बने हैं। कुछ अभिव्यंजक रेंज को ध्यान में रखकर बनाए गए हैं। PicassoIA पर टेक्स्ट टू स्पीच कैटेगरी में दोनों तरह के टूल हैं, और कुछ कैरेक्टर के काम में खास तौर पर अलग दिखते हैं।
प्रीसेट वॉइस लाइब्रेरी
सबसे तेज़ रास्ता है एक तैयार वॉइस चुनना। Gemini 3.1 Flash TTS 70 से ज़्यादा भाषाओं में लगभग 30 वॉइस देता है, जो तब काम आता है जब आपको अलग-अलग बोलने वालों की कास्ट चाहिए। Qwen3 TTS नौ प्रीसेट स्पीकर देता है (Aiden, Dylan, Eric, Ono_anna, Ryan, Serena, Sohee, Uncle_fu और Vivian), जिनके लहजे, टोन और जेंडर अलग-अलग हैं।
तेज़ और लो-लेटेंसी आउटपुट के लिए Inworld फ़ैमिली देखने लायक है: TTS 1.5 Mini और TTS 1.5 Max दोनों 15 भाषाओं में काम करते हैं, जबकि Realtime TTS 2 तेज़ रिस्पॉन्स के साथ स्वाभाविक वॉइसओवर के लिए बना है। Grok Text To Speech एक और तुरंत काम करने वाला विकल्प है, जब आपको बस कोई लाइन बोलवानी हो।
विवरण से वॉइस डिज़ाइन
यहीं टेक्स्ट टू कैरेक्टर वॉइस सबसे मज़ेदार हो जाता है। सूची में से चुनने की बजाय आप व्यक्ति का वर्णन करते हैं। Qwen3 TTS में voice design मोड है, जो "A warm, friendly female voice with a slight British accent" जैसा एक सादा वाक्य लेकर शून्य से मेल खाती वॉइस बनाता है। इसके लिए किसी सैंपल ऑडियो की ज़रूरत नहीं होती।
अच्छे विवरणों में एक पैटर्न होता है:
- उम्र और जेंडर का आभास: "एक बूढ़ा आदमी", "एक किशोर लड़की"।
- टेक्सचर: "खरखरी", "साँसों से भरी", "चमकदार"।
- पेस और मूड: "धीरे बोलता है, थका हुआ लेकिन दयालु"।
- लहजा या क्षेत्र, अगर वह मायने रखता है।
छोटी क्लिप से क्लोनिंग
क्लोनिंग रेफ़रेंस ऑडियो से किसी असली वॉइस की आवाज़ कॉपी करती है। Chatterbox कुछ सेकंड के रेफ़रेंस ऑडियो से स्पीकर को दोबारा बनाता है और इसमें एक इमोशन स्लाइडर है। इसके आउटपुट में एक अश्रव्य वॉटरमार्क भी होता है, ताकि वे ट्रेस किए जा सकें। MiniMax Voice Cloning कस्टम वॉइस बनाता है, जिन्हें बाद में MiniMax स्पीच मॉडल में दोबारा इस्तेमाल किया जा सकता है। Chatterbox Turbo और Chatterbox Pro इसके सहोदर वर्ज़न हैं, अगर आपको तेज़ या ज़्यादा पॉलिश्ड आउटपुट चाहिए।
⚠️ सिर्फ़ उन्हीं वॉइस को क्लोन करें जिनके आप मालिक हैं या जिनके इस्तेमाल की आपके पास लिखित अनुमति है। अपनी ही एक छोटी क्लिप, किसी ऐसे हायर्ड एक्टर की आवाज़ जिसने सहमति दी हो, या आपकी बनाई हुई वॉइस, सुरक्षित रास्ता है।
त्वरित तुलना
| टूल | सबसे अच्छा किसके लिए | खास फ़ीचर |
|---|
| Qwen3 TTS | नए कैरेक्टर गढ़ने के लिए | एक ही जगह प्रीसेट, क्लोन और वॉइस डिज़ाइन मोड |
| Chatterbox | अभिव्यंजक एक्टिंग | एक्सेजरेशन और पेस स्लाइडर |
| Speech 2.8 HD | कंट्रोल के साथ पॉलिश्ड नैरेशन | दस इमोशन, पिच, स्पीड, पॉज़ मार्कर |
| Gemini 3.1 Flash TTS | बड़ी कास्ट, कई भाषाएँ | लगभग 30 वॉइस, 70+ भाषाएँ |
| ElevenLabs v3 | स्वाभाविक वॉइसओवर | अभिव्यंजक, स्वाभाविक डिलीवरी |
| Play Dialog | बातचीत | डायलॉग ऑडियो के लिए बना |
वॉइस सेटिंग्स जो सब कुछ बदल देती हैं
दो लोग एक ही टूल और एक ही स्क्रिप्ट इस्तेमाल करके बहुत अलग नतीजे पा सकते हैं। फ़र्क लगभग हमेशा सेटिंग्स में होता है। यहाँ बताया गया है कि हर एक असल में क्या करती है।
भावना और एक्सेजरेशन
इमोशन कंट्रोल दो तरह के होते हैं। कुछ मॉडल आपको लेबल देते हैं। Speech 2.8 HD आपको happy, sad, angry, fearful, disgusted, surprised, calm और neutral जैसे विकल्पों में से चुनने देता है, या इसे auto पर छोड़ दें ताकि मॉडल खुद चुने। कुछ मॉडल स्लाइडर देते हैं। Chatterbox में exaggeration वैल्यू तटस्थ डिलीवरी के लिए 0.5 पर रहती है, और मॉडल चेतावनी देता है कि अत्यधिक वैल्यू अस्थिर हो सकती हैं।
एक व्यावहारिक नियम: तटस्थ से शुरू करें, एक कदम आगे बढ़ाएँ और सुनें। विलेन को शायद ही कभी अधिकतम गुस्से की ज़रूरत होती है। नियंत्रित, शांत धमकी अक्सर चिल्लाने से ज़्यादा डरावनी लगती है।
गति और पिच
गति और पिच कैरेक्टरों को अलग करने के दो सबसे तेज़ तरीके हैं।
- गति: Speech 2.8 HD में गति सामान्य का 0.5 से 2.0 गुना तक होती है। थके हुए बुज़ुर्ग के लिए 0.8 और उत्साही बच्चे के लिए 1.15 इस्तेमाल करें।
- पिच: वही मॉडल पिच को किसी भी दिशा में 12 सेमीटोन तक बदल सकता है। अक्सर दो या तीन सेमीटोन काफ़ी होते हैं। किनारों तक धकेलेंगे तो वॉइस प्रोसेस्ड सुनाई देने लगती है।
- वॉल्यूम: रेंज 0 से 10 तक है, डिफ़ॉल्ट 1.0 है। फुसफुसाहट के लिए इसे कम रखें और लाउडनेस बाद में अपने एडिटर में ठीक करें।
विराम और विराम चिह्न
विराम ज़्यादातर लोगों की सोच से ज़्यादा व्यक्तित्व लाते हैं। Speech 2.8 HD टेक्स्ट में <#0.5#> जैसे मार्कर स्वीकार करता है, जो आधे सेकंड की खामोशी डालते हैं। जिन टूल में मार्कर नहीं होते, वहाँ विराम चिह्न यही काम करते हैं:
- कॉमा एक छोटी साँस देता है।
- एलिप्सिस झिझक या बात अधूरी छोड़ने का संकेत देते हैं।
- छोटे वाक्य रूखे लगते हैं। लंबे वाक्य बहते हुए लगते हैं।
- कुछ मॉडल में बड़े अक्षर ज़ोर जोड़ सकते हैं।
किसी भी स्लाइडर को छूने से पहले लाइन दोबारा लिखकर देखें। इसमें कोई खर्च नहीं होता, और अक्सर यह बेहतर काम करता है।
टेम्परेचर और एकरूपता
टेम्परेचर तय करता है कि आउटपुट कितना अनुमानित होगा। Chatterbox का डिफ़ॉल्ट 0.8 है। कम वैल्यू ज़्यादा दोहराने योग्य डिलीवरी देती हैं, जो उस गेम कैरेक्टर के लिए चाहिए जिसे पचास लाइनों में एक-सा सुनाई देना है। ज़्यादा वैल्यू विविधता जोड़ती हैं, जो किसी जीवंत टेक को ढूँढने के लिए उपयोगी है। एक फ़िक्स्ड सीड आपको वह नतीजा दोबारा बनाने देता है जो आपको पसंद आया था।
| सेटिंग | कम वैल्यू | ज़्यादा वैल्यू | अच्छा शुरुआती बिंदु |
|---|
| Exaggeration (Chatterbox) | सपाट, शांत | नाटकीय, अस्थिर | 0.5 |
| Temperature (Chatterbox) | दोहराने योग्य | विविध | 0.8 |
| Speed (Speech 2.8 HD) | धीमी, भारी | तेज़, घबराई हुई | 1.0 |
| Pitch (Speech 2.8 HD) | गहरी | चमकदार | 0 |
| Emotion (Speech 2.8 HD) | तटस्थ | खास मूड | Auto |
कॉपी करने लायक कैरेक्टर वॉइस उदाहरण
सिद्धांत ठीक है, लेकिन आप शायद ऐसी लाइनें चाहते हैं जिन्हें सीधे पेस्ट किया जा सके। यहाँ तीन कैरेक्टर रेसिपी हैं। अपने स्वाद के हिसाब से बदलें।
रूखा मेंटर
टेक्स्ट: "बैठ जा, बच्चे। मैंने आपके खाए गरम खानों से भी ज़्यादा लड़ाइयाँ हारी हैं... और फिर भी यहीं हूँ।"
- Voice design प्रॉम्प्ट (Qwen3 TTS): "एक बड़ी उम्र का आदमी, भारी और खरखरी आवाज़ में, धीरे बोलता है और उसमें सूखा हास्य है।"
- सेटिंग्स: गति लगभग 0.85, पिच दो सेमीटोन नीचे, भावना calm।
- यह क्यों काम करता है: एलिप्सिस पंचलाइन से पहले का ठहराव बनाता है, और धीमी गति लाइन को वज़नदार बनाती है।
घबराया हुआ साइडकिक
टेक्स्ट: "ठीक है, ठीक है, ठीक है। कोई घबराना मत। मैं घबरा नहीं रहा। आप मुझे ऐसे क्यों देख रहे हैं?"
- Voice design प्रॉम्प्ट: "एक जवान आदमी, थोड़ी ऊँची पिच में, तेज़ और साँस फूलती हुई आवाज़ में बोलता है, हमेशा थोड़ा चिंतित।"
- सेटिंग्स: गति लगभग 1.15, पिच दो सेमीटोन ऊपर, भावना fearful या surprised।
- यह क्यों काम करता है: दोहराए गए छोटे वाक्य मॉडल को जल्दबाज़ी करने और अटकने की जगह देते हैं, और यही बेचैनी जैसा पढ़ा जाता है।
गर्मजोशी भरा कहानीकार
टेक्स्ट: "एक समय की बात है, एक ऐसे गाँव में जहाँ रात को नदी गाती थी, एक बहुत छोटी लोमड़ी रहती थी।"
- प्रीसेट तरीका: एक गर्म प्रीसेट वॉइस चुनें, गति लगभग 0.9 रखें, भावना calm करें, और "रात को" के बाद आधा सेकंड का विराम जोड़ें।
- यह क्यों काम करता है: सबसे मज़बूत छवि के बाद का विराम बच्चों को उसकी कल्पना करने का समय देता है।
💡 टिप: हर कैरेक्टर को एक तटस्थ लाइन और एक भावनात्मक लाइन से परखें। अगर दोनों एक ही व्यक्ति जैसी लगें, तो वॉइस एकरूप है। अगर नहीं, तो पूरी स्क्रिप्ट जनरेट करने से पहले वॉइस ठीक करें।
एक सरल वर्कफ़्लो जो काम करता है
बेतरतीब प्रयोग समय बर्बाद करते हैं। एक छोटी रूटीन आपकी कास्ट को पहली लाइन से आख़िरी लाइन तक अलग रखती है।
वॉइस शीट लिखें
कोई भी टूल खोलने से पहले, हर कैरेक्टर के लिए तीन पंक्तियाँ लिखें:
- वे कौन हैं: उम्र, पृष्ठभूमि, मूड।
- वे कैसे सुनाई देते हैं: गति, पिच, टेक्सचर, लहजा।
- वे कभी क्या नहीं करते: एक मेंटर जो कभी चिल्लाता नहीं, एक साइडकिक जो कभी धीमे नहीं बोलता।
यह शीट अपनी स्क्रिप्ट के बगल में रखें। जब कोई जनरेट की गई लाइन अटपटी लगे, तो शीट बताती है कि कौन सी सेटिंग बदलनी है।
एक वाक्य से परखें
हर कैरेक्टर के लिए एक ही वाक्य जनरेट करें और उसे हेडफ़ोन और फ़ोन के स्पीकर, दोनों पर सुनें। कई दर्शक और खिलाड़ी नतीजा छोटे स्पीकरों पर सुनेंगे, इसलिए जो वॉइस स्टूडियो हेडफ़ोन पर शानदार लगती है, वह फ़ोन पर बिखर सकती है।
जब टेस्ट लाइन सही लगे, तो सेटिंग्स लॉक कर दें। उन्हें लिख लें, अगर टूल सीड देता है तो उसे नोट कर लें, और उसी सेशन में बाकी स्क्रिप्ट जनरेट करें। बड़ी कास्ट वाले प्रोजेक्ट्स के लिए यह खास तौर पर मददगार है, जैसे नीचे दी गई इंडी गेम टीम के लिए।
अपने प्रोजेक्ट के लिए एक्सपोर्ट करें
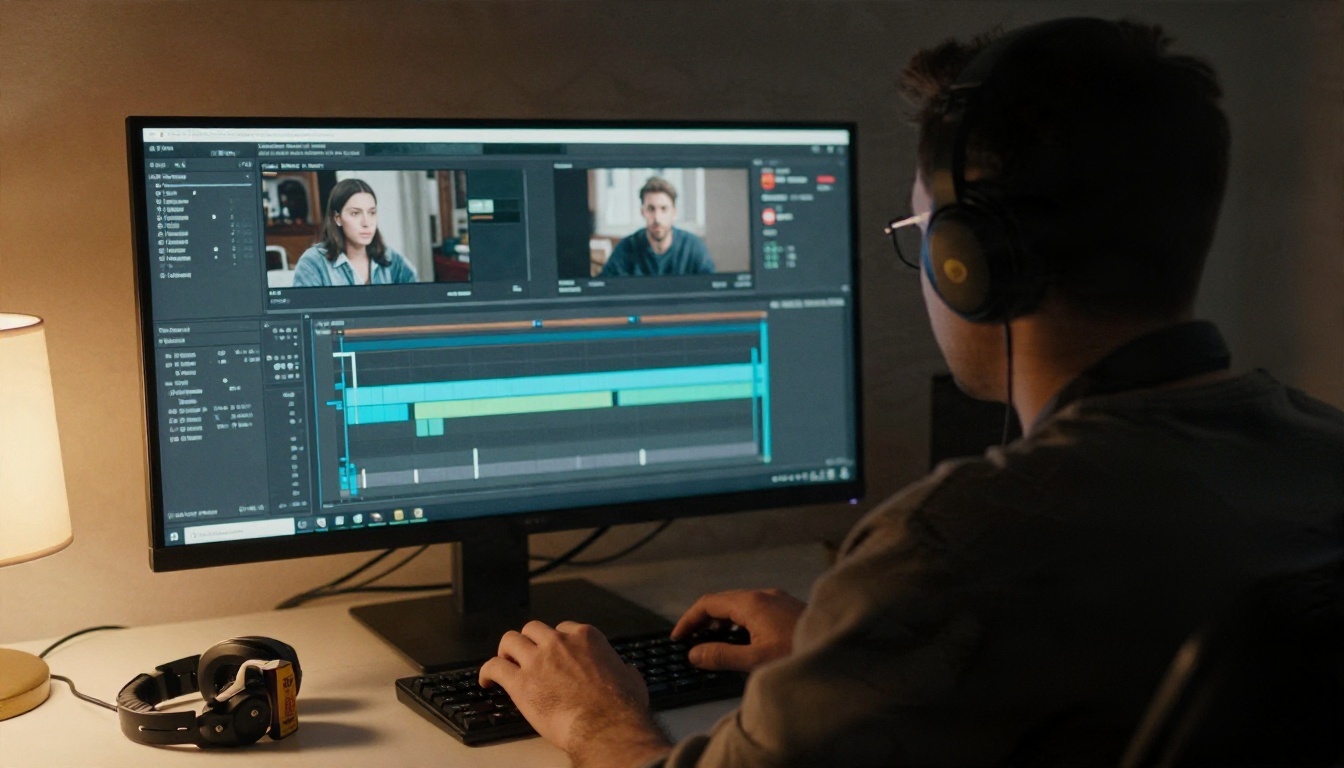
जब ऑडियो अगले चरण में जाता है, तब फ़ॉर्मेट मायने रखता है। Speech 2.8 HD 256 kbps तक MP3 एक्सपोर्ट कर सकता है, साथ ही WAV, FLAC या PCM भी, जब आपको एडिटिंग के लिए लॉसलेस फ़ाइलें चाहिए। जिस चीज़ को आगे प्रोसेस करना है उसके लिए WAV या FLAC चुनें, और जल्दी शेयर करने के लिए MP3। अगर आपका प्रोजेक्ट वीडियो है, तो जनरेट की गई लाइनों को टाइमलाइन पर रखकर तस्वीर से सिंक भी कर सकते हैं।
बचने वाली आम गलतियाँ
ज़्यादातर कमज़ोर कैरेक्टर वॉइस एक ही तरह की कुछ गलतियों से आती हैं।
भावना को बहुत आगे धकेलना
अधिकतम गुस्सा, अधिकतम खुशी और अधिकतम उदासी, तीनों नाटकीय और कभी-कभी टूटे हुए लगते हैं। असली लोग खुद को रोकते हैं। इमोशन स्लाइडर को बीच के आसपास रखें और बाकी काम शब्दों को करने दें।
लिखे हुए टेक्स्ट को नज़रअंदाज़ करना
फीकी लाइन किसी भी वॉइस के पढ़ने पर फीकी ही रहती है। संक्षिप्त रूप (contractions), बीच में रुकावट, अधूरे विचार और छोटे टुकड़े जोड़ें। पहले लाइन ज़ोर से खुद पढ़कर देखें। अगर आप अटकते हैं, तो मॉडल भी शायद अटकेगा।
सबके लिए एक ही वॉइस इस्तेमाल करना
भले ही आपके पास सिर्फ़ एक नैरेटर वॉइस हो, आप गति और पिच बदलकर कैरेक्टरों को अलग कर सकते हैं। दो-तीन सेमीटोन और 10 से 15 प्रतिशत की गति का बदलाव किसी दूसरे व्यक्ति का आभास देने के लिए काफ़ी है। कक्षाओं और पढ़ाई के लिए, यह दो बोलने वालों के बीच बातचीत का मॉडल बनाने का तेज़ तरीका है, जैसे भाषा सिखाने के सत्र में।
⚠️ भाषा की जाँच: अगर आपकी स्क्रिप्ट अंग्रेज़ी में नहीं है, तो उपलब्ध होने पर भाषा विकल्प सेट करें। Speech 2.8 HD में 40 से ज़्यादा भाषाओं के लिए language boost सेटिंग है, और Qwen3 TTS आपको दस भाषाओं में से चुनने देता है या auto पर छोड़ने देता है।
अपनी कैरेक्टर वॉइस आज़माएँ
अब आपके पास पूरी तस्वीर है: काम के लिए सही टूल चुनें, एक छोटी वॉइस शीट लिखें, भावना, गति, पिच और विराम को एक-एक कदम करके ट्यून करें, और पूरी स्क्रिप्ट जनरेट करने से पहले एक लाइन से परखें।
शुरुआत करने का एक आसान तरीका यह है। Qwen3 TTS खोलें, voice design पर जाएँ, और एक वाक्य में एक कैरेक्टर का वर्णन करें। फिर वही लाइन Chatterbox में एक अलग exaggeration वैल्यू के साथ आज़माएँ, और Speech 2.8 HD में पिच और गति बदलकर। एक ही वाक्य के तीन वर्ज़न सुनना आपके कान को किसी भी चेकलिस्ट से ज़्यादा सिखाएगा।
जब आप बड़े पैमाने पर काम करने के लिए तैयार हों, तो picassoia.com/en/all-models पर हर उपलब्ध वॉइस मॉडल ब्राउज़ करें। एक लाइन टाइप करें, उसे एक पर्सनैलिटी दें, और कुछ ही सेकंड में अपने कैरेक्टर को बोलते हुए सुनें।


