अनिमे और इलस्ट्रेशन वाला AI शुरुआती धुंधले और असंगत आउटपुट से काफ़ी आगे निकल चुका है। आज समर्पित फ़ाइन-ट्यून्ड मॉडल और LoRA एडाप्टर ऐसा एनिमे-स्टाइल आर्टवर्क बनाते हैं जो हाथ से बनाए गए इलस्ट्रेशन को टक्कर देता है, और कुछ मामलों में वह उससे भी बेहतर होता है जो ज़्यादातर शौकिया आर्टिस्ट घंटों में बना पाते हैं। सवाल अब यह नहीं है कि क्या AI एनिमे बना सकता है, बल्कि यह है कि कौन-सा मॉडल इसे सबसे अच्छा करता है।
इस विश्लेषण में अभी उपलब्ध अनिमे और इलस्ट्रेशन के टॉप AI मॉडल शामिल हैं: तुरंत फ़ोटो-से-एनिमे कन्वर्टर से लेकर टेक्स्ट-आधारित कैरेक्टर क्रिएटर और कस्टम LoRA ट्रेनर तक। इनमें से सभी सीधे PicassoIA पर उपलब्ध हैं, इसके लिए किसी लोकल GPU या जटिल सेटअप की ज़रूरत नहीं है।
अनिमे जनरेशन इतना कठिन क्यों है जितना दिखता है
ज़्यादातर सामान्य-उद्देश्य इमेज मॉडल अनिमे के साथ जूझते हैं, क्योंकि अनिमे एक बहुत विशिष्ट विज़ुअल भाषा है। इसके अपने नियम हैं: प्रोपोर्शन, शेडिंग, लाइन की मोटाई, आँखों का डिज़ाइन और कलर पैलेट। जो मॉडल मुख्य रूप से सामान्य फ़ोटोग्राफ़ी या रियलिस्टिक आर्ट पर ट्रेन हुआ हो, वह क्यूरेटेड अनिमे डेटासेट पर अलग से फ़ाइन-ट्यूनिंग के बिना इन नियमों का भरोसेमंद पालन नहीं कर सकता।
जब आप आउटपुट को साथ-साथ रखकर देखते हैं तो यह अंतर साफ़ दिखता है। किसी सामान्य मॉडल से "नीले बालों वाली अनिमे लड़की" बनाने को कहें, तो अक्सर जो बनता है वह असली अनिमे आर्ट से ज़्यादा एक स्टाइलाइज़्ड पेंटिंग जैसा लगता है। आँखों के प्रोपोर्शन गड़बड़ होते हैं, सेल शेडिंग नहीं होती और लाइनवर्क में वह तीखापन नहीं होता जो इस स्टाइल की पहचान है। समर्पित अनिमे मॉडल में यह समस्या नहीं होती, क्योंकि उन्हें खास तौर पर उन विज़ुअल कन्वेंशन को पहचानने और दोहराने के लिए ट्रेन किया गया है।
स्टाइल कंसिस्टेंसी की समस्या
अनिमे AI की सबसे बड़ी चुनौती स्टाइल कंसिस्टेंसी है। एक प्रभावशाली इमेज बनाना अपेक्षाकृत आसान है। लेकिन दस इमेज में एक ही कैरेक्टर को वैसा ही दिखाना, यानी वही चेहरा, बालों का डिज़ाइन और कलर पैलेट, वह जगह है जहाँ ज़्यादातर मॉडल पूरी तरह बिखर जाते हैं।
इसीलिए अनिमे के लिए खास तौर पर बने मॉडल, या अनिमे-केंद्रित LoRA से अनुकूलित मॉडल, इस काम में सामान्य मॉडलों से बेहतर प्रदर्शन करते हैं। उन्होंने विज़ुअल शब्दावली को इतनी गहराई से आत्मसात किया है कि वे अलग-अलग प्रॉम्प्ट और बदलते दृश्यों में भी उसे बनाए रख पाते हैं। अगर आप विज़ुअल नॉवेल, वेबटून या कोई ऐसा प्रोजेक्ट बना रहे हैं जिसमें एक ही कैरेक्टर कई स्थितियों में दिखे, तो मॉडल चुनते समय स्टाइल कंसिस्टेंसी सबसे अहम पैमाना है।
अच्छे अनिमे AI में असल में क्या होना चाहिए
| क्वालिटी फ़ैक्टर | क्या देखें |
|---|
| लाइन क्लैरिटी | एक जैसी मोटाई के साथ तीखे, साफ़ किनारे |
| आँखों की रेंडरिंग | विस्तृत आइरिस, सही बढ़ा-चढ़ाकर बनाए गए प्रोपोर्शन |
| बालों की स्टाइलाइज़ेशन | दिशा के अनुसार समूहित, बहते हुए स्ट्रैंड और कलर बैंडिंग |
| कलर पैलेट | इस जॉनर के लिए विशिष्ट, संतृप्त और उच्च-कंट्रास्ट रंग |
| प्रॉम्प्ट एडहेरेंस | टेक्स्ट विवरण का विज़ुअल आउटपुट में सटीक अनुवाद |
| स्पीड | कैरेक्टर डिज़ाइन के काम में तेज़ इटरेशन मायने रखता है |
| रिज़ॉल्यूशन | कपड़ों के पैटर्न और एक्सेसरी की बारीकियों के लिए पर्याप्त डिटेल |
💡 सबसे सक्षम अनिमे मॉडल क्यूरेटेड डेटासेट पर फ़ाइन-ट्यून किए गए हैं, या ऐसे LoRA से अनुकूलित हैं जो शोनेन एक्शन, शोजो रोमांस, इसेकाई फ़ैंटेसी या चिबी आर्ट जैसे खास सब-स्टाइल को लक्ष्य करते हैं। बिना ऐसी ट्रेनिंग वाले सामान्य मॉडल शायद ही उनकी बराबरी कर पाते हैं।
फ़ोटो से एनिमे: सबसे तेज़ रास्ता
अगर आपके पास किसी व्यक्ति की फ़ोटो, कोई कैरेक्टर रेफ़रेंस, या यहाँ तक कि कोई लैंडस्केप है, तो एनिमे आर्ट तक पहुँचने का सबसे तेज़ रास्ता फ़ोटो-से-एनिमे कन्वर्ज़न मॉडल है। ये मॉडल आपकी सोर्स इमेज लेकर उसे एनिमे विज़ुअल स्टाइल में दोबारा रेंडर करते हैं, और मूल कम्पोज़िशन व सब्जेक्ट की पहचान बनाए रखते हैं। शुरू करने के लिए किसी प्रॉम्प्ट इंजीनियरिंग की ज़रूरत नहीं है।
Qwen Image Edit Plus LoRA फ़ोटो टू एनिमे
PicassoIA पर Qwen Image Edit Plus LoRA Photo to Anime मॉडल इस वर्कफ़्लो के लिए सबसे सीधे टूल्स में से एक है। यह एक असली फ़ोटो इनपुट के रूप में लेता है और एक एनिमे-स्टाइल कन्वर्ज़न लागू करता है, जो खास तौर पर चेहरे की संरचना और मुख्य डिटेल बचाए रखने के लिए ट्रेन किया गया है, और साथ ही विज़ुअल विशेषताओं को एनिमे आर्ट की ओर ढालता है।
जो चीज़ इसे सामान्य स्टाइल-ट्रांसफ़र टूल्स से अलग करती है, वह है LoRA फ़ाइन-ट्यूनिंग। इसे सिर्फ़ यह प्रॉम्प्ट देकर "इसे एनिमे जैसा बनाओ" नहीं कहा गया, बल्कि असली फ़ोटो और उनके एनिमे समकक्षों के वास्तविक संबंध पर ट्रेन किया गया है। नतीजा कहीं ज़्यादा सुसंगत आउटपुट होता है, जहाँ प्रोपोर्शन सही रहते हैं, आँखें ठीक से स्टाइलाइज़ होती हैं, और बैकग्राउंड इलस्ट्रेटेड एनिमे वातावरण की सपाट, ग्राफ़िक दिखावट के अनुरूप ढल जाते हैं।
इस मॉडल के सबसे अच्छे उपयोग:
- सोशल मीडिया के लिए असली पोर्ट्रेट को एनिमे अवतार में बदलना
- गेम डेवलपमेंट के लिए कैरेक्टर रेफ़रेंस फ़ोटो के एनिमे वर्ज़न बनाना
- फ़ोटोग्राफ़ी से विज़ुअल नॉवेल कैरेक्टर एसेट्स बनाना
- प्रामाणिक एनिमे सौंदर्य वाली प्रोफ़ाइल पिक्चर बनाना
- निजी फ़ोटो को स्टाइलाइज़्ड इलस्ट्रेटेड पोर्ट्रेट में बदलना
इनपुट फ़ोटो के हिसाब से नतीजे कैसे बदलते हैं
आपके आउटपुट की क्वालिटी काफ़ी हद तक इनपुट इमेज की क्वालिटी और कम्पोज़िशन पर निर्भर करती है। यहाँ वे चीज़ें हैं जो लगातार सबसे अच्छे नतीजे देती हैं:
- चेहरा साफ़ दिखे: सामने से या 3/4 कोण की ऐसी तस्वीरें जिनमें चेहरा बिना किसी रुकावट के हो, मॉडल को सबसे ज़्यादा जानकारी देती हैं
- अच्छी रोशनी: समान और फैली हुई रोशनी मॉडल को स्टाइलाइज़ करने से पहले चेहरे की ज्यामिति सटीक पढ़ने देती है
- सरल बैकग्राउंड: सादे या हल्के धुंधले बैकग्राउंड बिना कम्पोज़िशनल आर्टिफ़ैक्ट लाए साफ़ कन्वर्ट होते हैं
- उच्च रिज़ॉल्यूशन इनपुट: ज़्यादा पिक्सल डेटा का मतलब है एनिमे स्टाइलाइज़ेशन के दौरान ज़्यादा डिटेल बची रहना
- तटस्थ भाव: हल्के भाव शुरुआती पास में अत्यधिक भावों की तुलना में ज़्यादा साफ़ कन्वर्ट होते हैं
💡 पहली जाँच के लिए सॉफ़्ट प्राकृतिक खिड़की की रोशनी वाला पोर्ट्रेट आज़माएँ। इन हालात में मॉडल स्किन टोन और चेहरे की ज्यामिति सबसे अच्छी तरह संभालता है, जिससे इटरेट करने से पहले एक मज़बूत बेसलाइन बन जाती है।
टेक्स्ट-टू-एनिमे बनाने के लिए सर्वश्रेष्ठ मॉडल
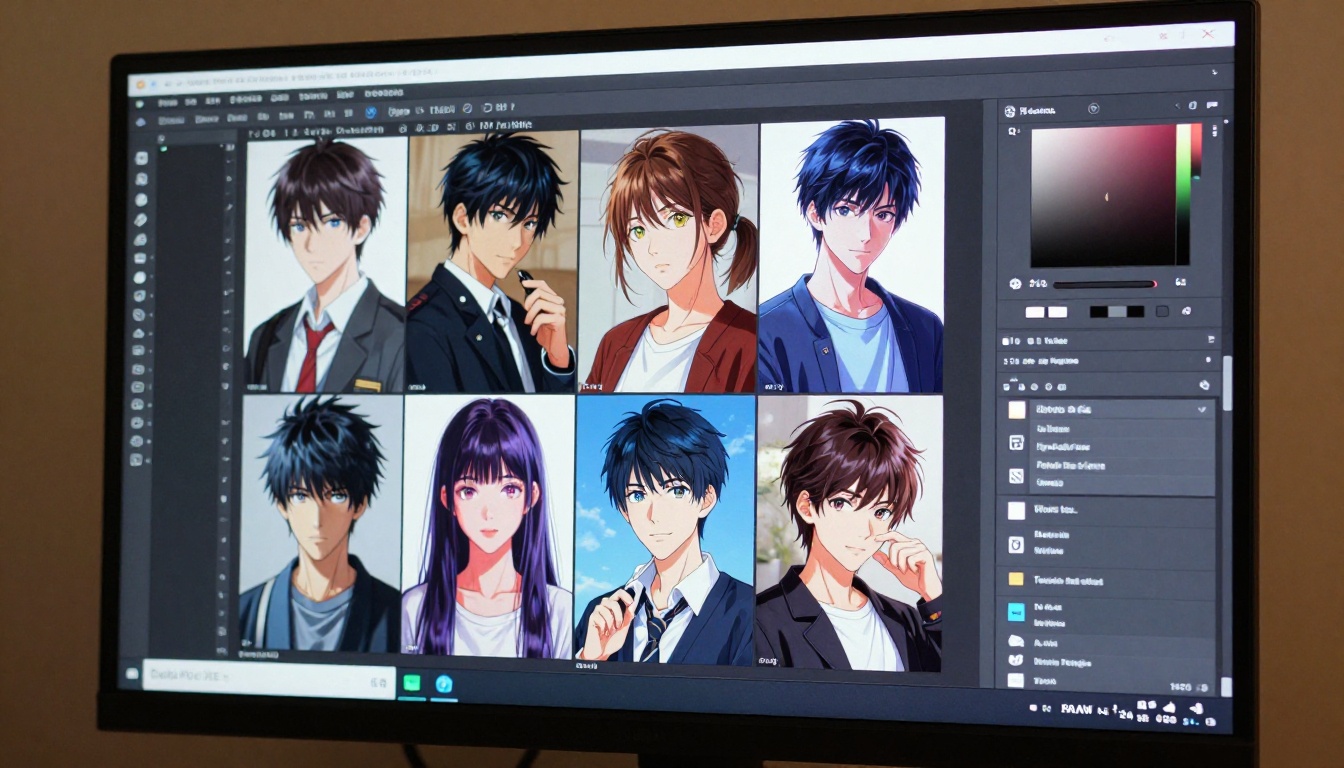
जब आप मौजूदा फ़ोटो बदलने के बजाय टेक्स्ट प्रॉम्प्ट से पूरी तरह शुरू से अनिमे कैरेक्टर बनाना चाहते हैं, तब आपको मज़बूत प्रॉम्प्ट एडहेरेंस और अनिमे-विशिष्ट विज़ुअल ट्रेनिंग वाले मॉडल चाहिए। नीचे दिए गए तीन मॉडल तेज़ आइडिएशन से लेकर हाई-रिज़ॉल्यूशन फ़ाइनल आउटपुट तक का दायरा कवर करते हैं।
एकसमान स्टाइल वैरिएशन के लिए Flux Redux Dev
Flux Redux Dev मुख्य रूप से एक इमेज वैरिएशन मॉडल है, लेकिन अनिमे कैरेक्टर डिज़ाइन के काम में यह असाधारण रूप से उपयोगी है। वर्कफ़्लो सीधा है: अपने कैरेक्टर के डिज़ाइन वाली एक मज़बूत बेस इमेज बनाएँ, फिर Flux Redux Dev से उसी कैरेक्टर के अलग-अलग पोज़, भाव, रोशनी और दृश्य संदर्भों में वैरिएशन बनाएँ, और विज़ुअल कंसिस्टेंसी बनाए रखें।
इलस्ट्रेशन वर्कफ़्लो के लिए यह सीधे उस कैरेक्टर कंसिस्टेंसी की समस्या को हल करता है जो ज़्यादातर अनिमे AI प्रोजेक्ट्स को परेशान करती है। आप कैरेक्टर को एक बार स्थापित करते हैं, फिर उसी विज़ुअल आधार पर नए वैरिएशन बनाते हैं। मॉडल मुख्य विज़ुअल पहचान (चेहरा, बाल, पोशाक) बनाए रखता है और आपकी ज़रूरत के अनुसार आसपास का संदर्भ बदलता है।
अनिमे के साथ Flux Redux Dev के लिए व्यावहारिक सुझाव:
- वैरिएशन में सबसे अच्छी कंसिस्टेंसी के लिए बेस इमेज सरल और उच्च-कंट्रास्ट रखें
- कैरेक्टर डिज़ाइन तय करने के बाद पोज़ वैरिएशन के लिए इसका उपयोग करें
- उन कैरेक्टर के साथ विशेष रूप से अच्छा काम करता है जिनके बालों के अनोखे रंग, असामान्य पोशाक या मज़बूत सिल्हूट हों
- वैरिएशन को किसी खास सौंदर्य दिशा में ले जाने के लिए इसे लिखित स्टाइल प्रॉम्प्ट के साथ मिलाएँ
स्पीड और कस्टम स्टाइल के लिए Flux Schnell LoRA
Flux Schnell LoRA Flux परिवार की स्पीड-केंद्रित एंट्री है, और इसका LoRA एडाप्टर सपोर्ट इसे अनिमे वर्क के लिए खास तौर पर शक्तिशाली बनाता है। खास अनिमे स्टाइल पर ट्रेन किए गए LoRA एडाप्टर, चाहे वे moe एस्थेटिक्स हों, शोनेन एक्शन सीक्वेंस हों या सॉफ़्ट वॉटरकलर इलस्ट्रेशन, लोड किए जा सकते हैं ताकि मॉडल का डिफ़ॉल्ट आउटपुट उस सौंदर्य की ओर खिसक जाए।
यहाँ सबसे बड़ा फ़ायदा इटरेशन स्पीड है। कैरेक्टर डिज़ाइनर आम तौर पर किसी रचनात्मक दिशा तय करने से पहले 20 से 50 वैरिएशन बनाते हैं। Flux Schnell LoRA की तेज़ जनरेशन गति आपको उस आइडिएशन चरण को घंटों के बजाय मिनटों में पार करने देती है, और अनिमे वर्क के लिए ज़रूरी LoRA-आधारित स्टाइल सटीकता भी नहीं छूटती।
4K कैरेक्टर डिटेल के लिए Seedream 4.5
ByteDance का Seedream 4.5 हाई-रिज़ॉल्यूशन कैरेक्टर आर्ट के लिए बनाया गया एक टेक्स्ट-टू-इमेज मॉडल है। जब आपको कपड़ों, एक्सेसरी, चेहरे की विशेषताओं और बैकग्राउंड वातावरण में बारीक डिटेल के साथ 4K आउटपुट चाहिए, तो यह मॉडल अनिमे से मिलते-जुलते प्रॉम्प्ट स्टाइल की विस्तृत रेंज में लगातार नतीजे देता है।
इलस्ट्रेशन के काम को खास तौर पर अतिरिक्त रिज़ॉल्यूशन से फ़ायदा होता है, क्योंकि ज़्यादा पिक्सल काउंट पर लाइनवर्क और कपड़े के पैटर्न कहीं बेहतर दिखते हैं। एक विस्तृत किमोनो, जटिल कवच या परतों वाली स्कूल यूनिफ़ॉर्म 4K पर मानक 1080p आउटपुट की तुलना में कहीं ज़्यादा कारीगरी दिखाती है।
💡 जब आपको प्रिंट-तैयार इलस्ट्रेशन क्वालिटी चाहिए तब Seedream 4.5 का उपयोग करें। 4K आउटपुट बारीक बालों के स्ट्रैंड, जटिल पोशाक पैटर्न और पर्यावरण की बैकग्राउंड डिटेल को कम रिज़ॉल्यूशन वाले विकल्पों से कहीं बेहतर संभालता है। यह अंतिम प्रोडक्शन एसेट्स के लिए सही विकल्प है, तेज़ आइडिएशन के लिए नहीं।
अनिमे से आगे के इलस्ट्रेशन स्टाइल
हर इलस्ट्रेशन प्रोजेक्ट क्लासिक जापानी अनिमे सौंदर्य को लक्ष्य नहीं करता। वेबटून स्टाइल, यूरोपीय ग्राफ़िक नॉवेल आर्ट, गेम्स के लिए कॉन्सेप्ट आर्ट और फ़ैंटेसी इलस्ट्रेशन, ये सब अपनी अलग विज़ुअल व्याकरण में काम करते हैं। PicassoIA पर कई मॉडल इन व्यापक इलस्ट्रेशन श्रेणियों को प्रभावशाली नतीजों के साथ संभालते हैं।
गैर-AI सौंदर्य के लिए Flux Krea Dev
AI इलस्ट्रेशन की एक लगातार समस्या वह है जिसे प्रैक्टिशनर "AI लुक" कहते हैं: एक अजीब-सी चिकनाई, थोड़े अधिक संतृप्त रंग और कम्पोज़िशन के ऐसे पैटर्न जिन्हें प्रशिक्षित आँखें तुरंत मशीन-निर्मित के रूप में पहचान लेती हैं। Flux Krea Dev को खास तौर पर इसी समस्या को हल करने के लिए विकसित किया गया था।
Flux Krea Dev ऐसी इमेज बनाता है जो किसी इंसान इलस्ट्रेटर के असली रचनात्मक काम जैसी लगती हैं। जिन प्रोजेक्ट्स में AI मूल को कम स्पष्ट रखना है, या जहाँ आपको ज़्यादा जैविक, हाथ से गढ़ी हुई सौंदर्य दृष्टि चाहिए, वहाँ यह मॉडल ऐसे नतीजे देता है जो मानव छोर के ज़्यादा करीब बैठते हैं। यह उन कॉन्सेप्ट आर्ट के लिए खास तौर पर असरदार है जिन्हें किसी असली कलाकार के स्केचबुक से आए हुए लगना चाहिए।
समृद्ध रंगों वाले इलस्ट्रेशन के लिए Hunyuan Image 2.1
Tencent का Hunyuan Image 2.1 रंग-समृद्ध इलस्ट्रेशन के काम में उत्कृष्ट है। इसकी ट्रेनिंग लगातार जीवंत, संतृप्त पैलेट और मज़बूत कम्पोज़िशनल चुनाव देती है। फ़ैंटेसी इलस्ट्रेशन, एडवेंचर सीन की कम्पोज़िशन और ऐसे कैरेक्टर आर्ट के लिए, जहाँ फ़ोटोरियलिज़्म से ज़्यादा विज़ुअल असर मायने रखता है, Hunyuan Image 2.1 भरोसेमंद रूप से मज़बूत है।
2K आउटपुट रिज़ॉल्यूशन ज़्यादातर इलस्ट्रेशन उपयोगों के लिए जनरेशन स्पीड और डिटेल क्वालिटी के बीच एक व्यावहारिक संतुलन बिंदु है, जो इसे उन इलस्ट्रेटरों के लिए एक ठोस रोज़मर्रा का मॉडल बनाता है जो आवर्ती प्रोजेक्ट्स पर काम कर रहे हैं।
जटिल सीन प्रॉम्प्ट के लिए GPT Image 2
GPT Image 2 इलस्ट्रेशन के काम में असाधारण प्रॉम्प्ट समझ लाता है। जब आपके पास जटिल, बहु-तत्व वाले सीन विवरण हों जिनमें कैरेक्टर की जगह, परिवेश की डिटेल, रोशनी की स्थिति और मूड एक साथ निर्दिष्ट हों, तो यह मॉडल अंतिम कम्पोज़िशन में सभी बताए गए तत्वों को सही जगह रखने में ज़्यादा भरोसेमंद है।
कॉन्सेप्ट आर्ट के लिए, जहाँ ब्रीफ़ में सीन निर्माण की खास ज़रूरतें हों, वहाँ यह सटीकता बेहद मायने रखती है। आपका समय मॉडल से लड़ने में कम और आउटपुट को परिष्कृत करने में ज़्यादा लगता है।
कस्टम अनिमे LoRA बनाना
तैयार मॉडल अनिमे और इलस्ट्रेशन की ज़्यादातर ज़रूरतें पूरी कर देते हैं, लेकिन सबसे शक्तिशाली वर्कफ़्लो तब बनते हैं जब आप अपने कैरेक्टर डिज़ाइन या पसंदीदा आर्ट स्टाइल पर कस्टम LoRA मॉडल ट्रेन करते हैं। यहीं AI आर्ट टूल के उपयोग से आगे बढ़कर असली रचनात्मक स्वामित्व तक पहुँचता है।
स्टाइल क्लोनिंग के लिए P Image Trainer
PicassoIA पर P Image Trainer आपको अपने खुद के इमेज डेटासेट से कस्टम LoRA ट्रेन करने देता है। अनिमे क्रिएटर्स के लिए इसका मतलब है ट्रेनर को अपने मूल कैरेक्टर वाली इमेज का सेट देना, और ऐसा मॉडल पाना जो उस खास कैरेक्टर को किसी भी दृश्य या पोज़ में भरोसेमंद तरीके से बनाए।
ट्रेनिंग वर्कफ़्लो सीधा है:
- अपने कैरेक्टर या लक्ष्य आर्ट स्टाइल की 15 से 30 इमेज तैयार करें
- हर इमेज को वर्णनात्मक टेक्स्ट से कैप्शन दें (ट्रेनर इन्हें विज़ुअल-टेक्स्ट एसोसिएशन के लिए इस्तेमाल करता है)
- अपने चुने हुए स्टेप काउंट और लर्निंग रेट के साथ ट्रेनिंग जॉब चलाएँ
- किसी भी संगत बेस मॉडल पर परिणामी LoRA लागू करें, ताकि कैरेक्टर-विशिष्ट जनरेशन हो सके
पेशेवर कैरेक्टर डिज़ाइनर और वेबटून आर्टिस्ट इसी तरह AI का उपयोग करते हैं, ताकि प्रोडक्शन पाइपलाइन तेज़ हों और वे अपने मूल डिज़ाइनों पर रचनात्मक स्वामित्व न खोएँ। कैरेक्टर आपका ही रहता है। AI सिर्फ़ रेंडरिंग का भारी काम संभालता है।
फ़ाइन-ट्यूनिंग के लिए Flux 2 Klein LoRA
Flux 2 Klein 9B Base LoRA बड़े पैरामीटर काउंट पर LoRA फ़ाइन-ट्यूनिंग के लिए बेस आर्किटेक्चर देता है। 9B वर्ज़न छोटे मॉडलों की तुलना में जटिल स्टाइल जानकारी ज़्यादा सटीकता से संभालता है, इसलिए जब आपके लक्ष्य अनिमे स्टाइल में जटिल डिटेल हों, या जब आप किसी बहुत खास आर्टिस्ट की विज़ुअल पहचान को उच्च निष्ठा के साथ पकड़ना चाहते हों, तब यही सही चुनाव है।
हल्की फ़ाइन-ट्यूनिंग या तेज़ इटरेशन चक्रों के लिए, Flux 2 Klein 4B Base LoRA आउटपुट क्वालिटी और जनरेशन स्पीड के बीच एक व्यावहारिक संतुलन देता है, जो ज़्यादातर कैरेक्टर डिज़ाइन प्रोजेक्ट्स के लिए ठीक रहता है।
सही LoRA बेस चुनना:
| LoRA बेस | सबसे अच्छा किसके लिए | ट्रेनिंग समय |
|---|
| Flux 2 Klein 9B | विस्तृत स्टाइल कैप्चर, सटीक कैरेक्टर पहचान | लंबा |
| Flux 2 Klein 4B | त्वरित स्टाइल टेस्ट, व्यापक सौंदर्य ट्रेनिंग | तेज़ |
त्वरित तुलना: 8 मॉडल एक साथ
💡 अगर आपके पास रेफ़रेंस फ़ोटो है तो Qwen Photo to Anime से शुरू करें। अगर आप टेक्स्ट प्रॉम्प्ट से बना रहे हैं तो Seedream 4.5 से शुरू करें। जब आपको ऐसा मॉडल चाहिए जो आपके खास कैरेक्टर को जाने, तब P Image Trainer की ओर जाएँ।
PicassoIA पर फ़ोटो-से-एनिमे कैसे इस्तेमाल करें
Qwen Image Edit Plus LoRA Photo to Anime मॉडल PicassoIA पर एनिमे आर्ट के लिए सबसे आसान प्रवेश बिंदु है। यहाँ सटीक चरण-दर-चरण प्रक्रिया है:
चरण 1: मॉडल खोलें
PicassoIA पर Qwen Image Edit Plus LoRA Photo to Anime पर जाएँ। आपको इमेज अपलोड पैनल और टेक्स्ट प्रॉम्प्ट इनपुट फ़ील्ड साथ-साथ दिखेंगे।
चरण 2: अपनी सोर्स फ़ोटो अपलोड करें
एक साफ़ पोर्ट्रेट या कैरेक्टर फ़ोटो इस्तेमाल करें। स्पष्ट चेहरे की विशेषताओं वाली सामने की तस्वीरें सबसे अच्छा काम करती हैं। न्यूनतम अनुशंसित रिज़ॉल्यूशन 512x512 पिक्सल है; ज़्यादा रिज़ॉल्यूशन वाले इनपुट मॉडल को स्टाइलाइज़ेशन के दौरान बचाने के लिए ज़्यादा चेहरे की जानकारी देते हैं।
चरण 3: अपना स्टाइल प्रॉम्प्ट लिखें
एनिमे स्टाइल आउटपुट को दिशा देने के लिए एक वर्णनात्मक प्रॉम्प्ट जोड़ें। ऐसे उदाहरण जो अच्छे काम करते हैं:
"anime style portrait, vibrant colors, detailed expressive eyes, soft cel shading""manga character illustration, clean line art, expressive features, pastel color tones""shojo anime style, large detailed eyes, soft watercolor palette, gentle lighting""shonen action style, bold linework, high contrast, dynamic expression"
चरण 4: अपने जनरेशन पैरामीटर सेट करें
- गाइडेंस स्केल: ऊँचे मान (7 से 9) आपके टेक्स्ट प्रॉम्प्ट को ज़्यादा वज़न देते हैं और आउटपुट को वर्णित स्टाइल की ओर ज़्यादा ज़ोर से धकेलते हैं। कम मान (4 से 6) मॉडल को सोर्स इमेज का ज़्यादा करीब से पालन करने देते हैं, जिससे चेहरे की समानता बेहतर बची रहती है।
- स्टेप्स: 20 से 30 स्टेप ज़्यादातर इनपुट फ़ोटो के लिए क्वालिटी और स्पीड का सबसे अच्छा अनुपात देते हैं।
चरण 5: जनरेट करें और परिष्कृत करें
पहली जनरेशन चलाएँ, आउटपुट देखें, फिर जो सुधार चाहिए उसके आधार पर अपना प्रॉम्प्ट परिष्कृत करें। bokeh background, soft rim lighting, vibrant saturated palette, या cel shading with sharp shadows जैसे विशिष्ट स्टाइल डिस्क्रिप्टर जोड़ना अक्सर बिना किसी और बदलाव के नतीजे को काफ़ी तीखा कर देता है।
💡 अगर चेहरा मूल फ़ोटो से समानता खोने लगे, तो गाइडेंस स्केल को 1 से 2 पॉइंट घटाएँ और स्टेप काउंट 30 या 35 तक बढ़ाएँ। इससे मॉडल को स्टाइलाइज़ेशन के दौरान चेहरे की संरचना बचाने की ज़्यादा गुंजाइश मिलती है, और एनिमे सौंदर्य फिर भी लागू रहता है।
चरण 6: Super Resolution से अपस्केल करें
एक संतोषजनक एनिमे आउटपुट मिलने के बाद, उसे PicassoIA के Super Resolution टूल्स से गुज़ारें और 4K तक अपस्केल करें। एनिमे स्टाइलाइज़ेशन के बाद 4x अपस्केलिंग का संयोजन एक साधारण सोर्स फ़ोटो से लगातार प्रिंट-तैयार, पेशेवर क्वालिटी के नतीजे देता है।
अपना खुद का एनिमे आर्ट बनाना शुरू करें
इस लेख में शामिल हर मॉडल अभी PicassoIA पर उपलब्ध है। किसी लोकल GPU इंस्टॉलेशन, जटिल कॉन्फ़िगरेशन या घंटों तकनीकी दस्तावेज़ पढ़ने की ज़रूरत नहीं है। ये मॉडल किसी भी डिवाइस से ब्राउज़र में इस्तेमाल के लिए तैयार हैं।
अगर आपके पास शुरू करने के लिए रेफ़रेंस फ़ोटो है, तो सबसे तेज़ रास्ता Qwen Photo to Anime है। अगर आप पूरी तरह टेक्स्ट प्रॉम्प्ट से बना रहे हैं, तो मज़बूत प्रॉम्प्ट सटीकता और 4K आउटपुट क्वालिटी के संयोजन के लिए Seedream 4.5 से शुरू करें। ऐसे पेशेवर प्रोडक्शन वर्कफ़्लो के लिए, जिनमें एक कस्टम कैरेक्टर कई इमेज में लगातार दिखना चाहिए, P Image Trainer को Flux 2 Klein 9B Base LoRA के साथ मिलाने से बड़े पैमाने पर उस कैरेक्टर की विज़ुअल पहचान पर पूरा रचनात्मक स्वामित्व मिलता है।
जो लोग AI की विशिष्ट छाप के बिना मानव-निर्मित इलस्ट्रेशन की जैविक दिखावट चाहते हैं, उनके लिए Flux Krea Dev पहले आज़माने लायक है। और जब किसी प्रोजेक्ट में लगातार कैरेक्टर वैरिएशन चाहिए, तो Flux Redux Dev और Flux Redux Schnell आपकी इटरेशन ज़रूरतों के हिसाब से दो स्पीड विकल्प देते हैं।
AI से पेशेवर स्तर का अनिमे और इलस्ट्रेशन आर्ट बनाने की बाधा लगभग शून्य हो गई है। जिसके लिए पहले विशेष कलाकारों की टीम या महीनों की पढ़ाई चाहिए थी, अब उसके लिए एक अच्छा तैयार प्रॉम्प्ट और सही मॉडल चुनना काफ़ी है। PicassoIA एक ही प्लेटफ़ॉर्म पर 90 से ज़्यादा टेक्स्ट-टू-इमेज मॉडल देता है, जिनमें यहाँ कवर किए गए सभी अनिमे-केंद्रित टूल्स शामिल हैं। कोई एक चुनें, अपना पहला प्रॉम्प्ट लिखें और देखें कि आज आप क्या बना सकते हैं।


