Imagen क्या करता है और इसे कब इस्तेमाल करें (और कब कोई दूसरा टूल बेहतर है)
Google का Imagen मॉडल टेक्स्ट प्रॉम्प्ट से हैरान कर देने वाली फ़ोटोरियलिस्टिक इमेज बनाता है, लेकिन ज़्यादातर लोग इसकी असली ताकत और यह नहीं जानते कि कब दूसरे टूल काम को बेहतर ढंग से करते हैं। यहाँ साफ़-साफ़ समझाया गया है कि Imagen क्या करता है, यह कैसे काम करता है, Flux, Midjourney और Stable Diffusion से इसकी तुलना कैसी है, और वे स्थितियाँ कौन-सी हैं जहाँ यह सचमुच आगे निकल जाता है।
अगर आप AI इमेज जनरेशन के बारे में थोड़ा भी पढ़ते-देखते रहे हैं, तो आपने "Imagen" का नाम Midjourney और Stable Diffusion के साथ ज़रूर सुना होगा, बिना किसी के यह समझाए कि यह असल में अलग कैसे है। Google का Imagen सिर्फ़ एक और टेक्स्ट-टू-इमेज मॉडल नहीं है। यह भाषा को पिक्सल में बदलने का एक बुनियादी रूप से अलग तरीका अपनाता है, और इसकी आर्किटेक्चर इसे कुछ खास वर्कफ़्लो में ठोस और मापे जा सकने वाले फ़ायदे देती है। लेकिन उन्हीं चुनावों के साथ असली सीमाएँ भी आती हैं, जिनकी वजह से कई इस्तेमाल के मामलों में यह सही विकल्प नहीं रहता। यह ब्रेकडाउन बताता है कि Imagen क्या करता है, यह कैसे काम करता है, यह कहाँ अपनी साख कमाता है, और कहाँ आपको किसी और चीज़ की ओर जाना चाहिए।
Imagen असल में क्या है
Imagen Google का टेक्स्ट-टू-इमेज AI मॉडल है, जिसे Google Brain टीम ने विकसित किया और मई 2022 में पहली बार सार्वजनिक रूप से पेश किया गया। फ़ोटोरियलिस्टिक मानव चेहरों और जटिल प्रॉम्प्ट को फ़ॉलो करने में इसके प्रदर्शन ने उस समय ओपन-सोर्स दुनिया से इसे तुरंत अलग कर दिया। लेकिन यह जो अलग तरीके से करता है, वह केवल ट्रेनिंग डेटा या मॉडल के आकार का मामला नहीं है। इसकी मुख्य आर्किटेक्चर दो अलग समस्याओं को अलग करती है: यह समझना कि आपने क्या माँगा है, और फिर उसका जवाब देने वाली इमेज बनाना।
इसके केंद्र में लैंग्वेज मॉडल
ज़्यादातर डिफ़्यूज़न-आधारित इमेज जनरेटर प्रॉम्प्ट को विज़ुअल प्रतिनिधित्व से जोड़ने के लिए CLIP का इस्तेमाल करते हैं, जिसे इमेज और टेक्स्ट पर एक साथ ट्रेन किया गया है। Imagen एक अलग रास्ता अपनाता है। यह T5-XXL इस्तेमाल करता है, जो 11 बिलियन पैरामीटर वाला एक बड़ा फ़्रोज़न लैंग्वेज मॉडल है और जिसे सिर्फ़ टेक्स्ट पर ट्रेन किया गया है। इसके ट्रेनिंग डेटा में कोई इमेज नहीं है। सिर्फ़ टेक्स्ट।
व्यवहार में यह मायने रखता है। T5-XXL भाषा की संरचना, स्थानिक संबंधों और अवधारणात्मक पदानुक्रमों को CLIP से कहीं ज़्यादा गहराई से समझता है। जब आप कोई जटिल व्यवस्था बताने वाला प्रॉम्प्ट लिखते हैं ("नीले नोटबुक के बाईं ओर रखा एक सिरेमिक मग, जिसकी परछाई ऊपर-दाईं ओर पड़ रही है"), तो Imagen का टेक्स्ट एन्कोडर उसे इतनी गहरी समझ के साथ प्रोसेस करता है कि इमेज जनरेशन पिछले CLIP-आधारित तरीकों की तुलना में ज़्यादा सटीकता से उसका पालन करती है।
टेक्स्ट से पिक्सल तक, चरण दर चरण
जैसे ही T5-XXL एक टेक्स्ट एम्बेडिंग बनाता है, डिफ़्यूज़न मॉडल की एक कैस्केड प्रक्रिया शुरू हो जाती है। पहला मॉडल एक छोटी 64x64 बेस इमेज बनाता है। फिर दो क्रमिक सुपर-रेज़ोल्यूशन डिफ़्यूज़न मॉडल उसे अपस्केल करते हैं: पहले 256x256 तक, फिर अंतिम आउटपुट रेज़ोल्यूशन तक। हर अपस्केलिंग चरण अपने-आप में एक सीखा हुआ मॉडल है, जो मौजूदा पिक्सल को इंटरपोलेट करने के बजाय असली डिटेल जोड़ता है। अंतिम इमेज की बारीक टेक्सचर, चेहरे की विशेषताएँ और मटीरियल रेंडरिंग हर रेज़ोल्यूशन परत पर संश्लेषित की गई थीं, किसी कम-रेज़ोल्यूशन बेस से खींची नहीं गई थीं।
Imagen 2 (दिसंबर 2023 में जारी) और Imagen 3 (2024) ने इसी कैस्केड आर्किटेक्चर पर बेहतर ट्रेनिंग, बेहतर प्रॉम्प्ट एडहेरेंस और तेज़ जनरेशन समय के साथ काम किया। हर जनरेशन ने कमज़ोरियों का अंतर कुछ कम किया, और पोर्ट्रेट की फ़िडेलिटी और कंपोज़िशन की सटीकता में अपनी ताकत और बढ़ाई।
जहाँ Imagen सचमुच चमकता है
सभी फ़ोटोरियलिस्टिक AI इमेज जनरेटर एक ही तरह के कामों में सबसे अच्छा प्रदर्शन नहीं करते। Imagen के कुछ खास परिदृश्य हैं, जहाँ यह बड़े ब्रांड नाम वाले टूल्स से लगातार बेहतर साबित होता है।
जाँच के दबाव में टिकने वाली पोर्ट्रेट क्वालिटी
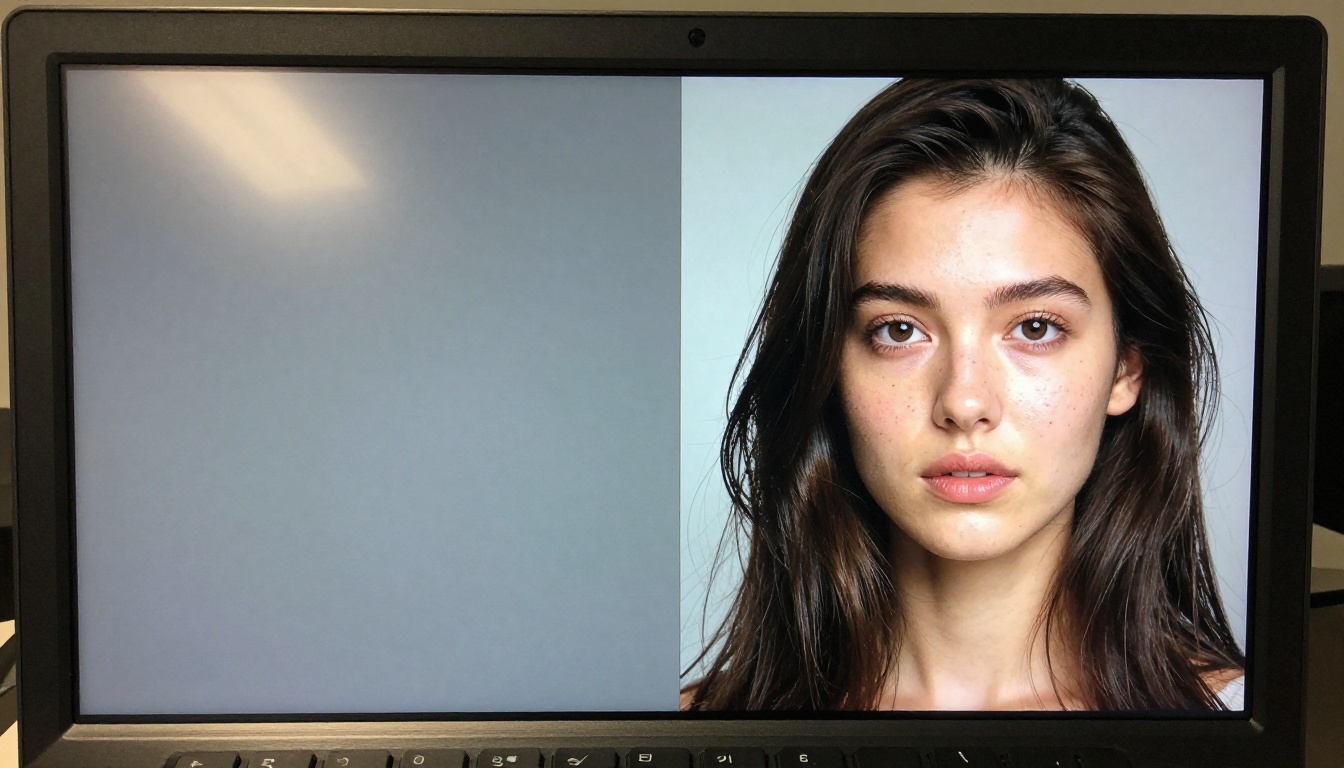
विश्वसनीय मानव चेहरे बनाना डिफ़्यूज़न-आधारित इमेज जनरेशन की सबसे कठिन समस्याओं में से एक रहा है। शरीर-रचना की गड़बड़ियाँ, अजीब लगने वाली त्वचा की रेंडरिंग और रोशनी की असंगतियाँ आम विफलताएँ हैं। Imagen का T5-आधारित लैंग्वेज बैकबोन और कैस्केड आर्किटेक्चर ऐसे चेहरे बनाते हैं जो फ़ोटो जैसे लगते हैं, और ऐसी स्थिरता के साथ, जिसे ज़्यादातर ओपन-सोर्स सिस्टम में सावधानी से फ़ाइन-ट्यूनिंग किए बिना दोहराना मुश्किल है। त्वचा के रोम-छिद्र, कान की कार्टिलेज में सबसर्फ़ेस स्कैटरिंग, असली आँखों की सूक्ष्म ज्यामिति: ये डिटेल Imagen के आउटपुट में उन पोस्ट-प्रोसेसिंग के बिना आ जाते हैं, जो वैसे ही प्रॉम्प्ट के लिए दूसरे सिस्टम में अक्सर ज़रूरी होती है।
💡 उपयोग पर नोट: किसी खास असली व्यक्ति की इमेज उनकी अनुमति के बिना बनाना Google की कंटेंट पॉलिसी का उल्लंघन है। Imagen की पोर्ट्रेट ताकत असली लोगों की समानता के बजाय यथार्थवादी काल्पनिक व्यक्तियों को बनाने पर लागू होती है।
टेक्स्ट रेंडरिंग जो सचमुच काम करती है
यह Imagen की ज़्यादातर प्रतिस्पर्धियों पर सबसे स्पष्ट तकनीकी बढ़त है। डिफ़्यूज़न मॉडल लंबे समय से जेनरेट की गई इमेज के अंदर पढ़ने योग्य टेक्स्ट बनाने में संघर्ष करते रहे हैं। Stable Diffusion अक्सर उलझे हुए अक्षर बनाता है। Midjourney में सुधार दिखा है, लेकिन जटिल कंपोज़िशन में अब भी टाइपोग्राफ़िक गलतियाँ होती हैं। Imagen इमेज के भीतर के टेक्स्ट को काफ़ी ज़्यादा सटीकता से संभालता है। प्रोडक्ट लेबल, पढ़ने योग्य दुकानों के साइनबोर्ड, टाइपोग्राफ़िक पोस्टर के तत्व: ये Imagen में दूसरे विकल्पों की तुलना में कहीं ज़्यादा भरोसे से सही रेंडर होते हैं। ऐसे किसी भी वर्कफ़्लो के लिए, जहाँ इमेज के अंदर के शब्द सही होने ही चाहिए, यह फ़ायदा तुरंत और व्यावहारिक है।
कमर्शियल और प्रोडक्ट फ़ोटोग्राफ़ी
बड़े पैमाने पर प्रोडक्ट इमेज बनाने वाली ई-कॉमर्स टीमों ने Imagen के आउटपुट की स्थिरता को उपयोगी पाया है। अलग-अलग कैटेगरी में सही मटीरियल रेंडरिंग, जैसे काँच पर स्पेक्युलर हाइलाइट, कपड़े पर उचित खुरदरापन और हार्डवेयर पर धात्विक चमक, बड़े बैच में भरोसे से बनी रहती है। जब 200 प्रोडक्ट इमेज में आउटपुट की एकरूपता उतनी ही मायने रखती है जितनी किसी एक इमेज की क्वालिटी, तब Imagen की पूर्वानुमेयता उन फ़ाइन-ट्यून किए गए ओपन-सोर्स मॉडलों पर एक वास्तविक ऑपरेशनल बढ़त है, जो आउटपुट के बीच बहक सकते हैं।
असली कमज़ोरियाँ
Imagen की कोई भी ईमानदार समीक्षा उन हिस्सों को छोड़ नहीं सकती जहाँ यह कम पड़ता है।
बंद वेट्स, कोई फ़ाइन-ट्यूनिंग नहीं
Imagen एक प्रोप्राइटरी मॉडल है। Google ने इसके वेट्स सार्वजनिक रूप से जारी नहीं किए हैं। आप इसे अपने डेटासेट पर फ़ाइन-ट्यून नहीं कर सकते, किसी खास विज़ुअल स्टाइल के लिए LoRA ट्रेन नहीं कर सकते, और इसे लोकल मशीन पर नहीं चला सकते। किसी प्रोडक्ट या ब्रांड की एकसमान विज़ुअल पहचान बनाने वाले क्रिएटर्स के लिए यह एक कठोर आर्किटेक्चरल सीमा है। कस्टम LoRA के साथ Flux Redux Dev, या SDXL-आधारित फ़ाइन-ट्यून, वह स्टाइल कंट्रोल देते हैं जो Imagen की बंद प्रणाली दे ही नहीं सकती।
सेफ़्टी फ़िल्टर जिनका असली क्रिएटिव असर है
Google की कंटेंट पॉलिसी मॉडल स्तर पर लागू होती है। वे ओपन-सोर्स विकल्पों से ज़्यादा सख्त हैं। इसका असर उन क्रिएटिव वर्कफ़्लो में घर्षण के रूप में दिखता है जिनमें गहरे विषय, कामुक संकेत वाला कंटेंट, या Google के सेफ़्टी क्लासिफ़ायर को ट्रिगर करने वाली कोई भी चीज़ शामिल है। सख्त कंटेंट ज़रूरतों वाली एंटरप्राइज़ टीमें इसे सराहेंगी। आस-पास के क्रिएटिव क्षेत्र में काम करने वाले स्वतंत्र क्रिएटर्स को ऐसे इनकार मिलेंगे जो ओपन मॉडल्स के साथ नहीं होते।
API एक्सेस में असली झंझट
Stable Diffusion की तरह, जो एक कंज़्यूमर GPU पर चलता है, Imagen Google Cloud के Vertex AI API के पीछे है। एक भी इमेज बनाने से पहले आपको Google Cloud अकाउंट, प्रोजेक्ट सेटअप, सर्विस अकाउंट क्रेडेंशियल, चालू APIs और बिलिंग अकाउंट चाहिए। तेज़ प्रयोग के लिए यह सेटअप लागत असली है। ऐसे प्लेटफ़ॉर्म, जहाँ आप प्रॉम्प्ट लिखकर तुरंत जनरेट कर सकते हैं, इस झंझट को पूरी तरह हटा देते हैं।
Imagen बनाम प्रतिस्पर्धा
टूल
फ़ोटोरियलिज़्म
इमेज में टेक्स्ट
फ़ाइन-ट्यूनिंग
ओपन-सोर्स
एक्सेस
Imagen 3
उत्कृष्ट
बहुत अच्छा
कोई नहीं
नहीं
पेड API
Midjourney v6
अच्छा
ठीक-ठाक
कोई नहीं
नहीं
सब्सक्रिप्शन
Stable Diffusion XL
अच्छा
ठीक-ठाक
उत्कृष्ट
हाँ
मुफ़्त/खुद होस्ट करें
Flux Dev
बहुत अच्छा
अच्छा
अच्छा
आंशिक रूप से
मुफ़्त/API
DALL-E 3
बहुत अच्छा
बहुत अच्छा
कोई नहीं
नहीं
पेड API
💡 इस टेबल को कैसे पढ़ें: "उत्कृष्ट" का मतलब है अपनी श्रेणी में सर्वश्रेष्ठ। "अच्छा" का मतलब है प्रोफ़ेशनल-ग्रेड आउटपुट। अंतर सबसे ज़्यादा प्रोडक्शन वॉल्यूम पर और खास इस्तेमाल की ज़रूरतों के लिए मायने रखते हैं। कभी-कभार की कैज़ुअल जनरेशन के लिए, इन टूल्स के बीच का फ़र्क बेंचमार्क तुलनाओं में दिखने वाले फ़र्क से छोटा है।
Imagen कब इस्तेमाल करें
जिन स्थितियों में यह अपनी जगह कमाता है
बड़ी मात्रा में फ़ोटोरियलिस्टिक लोग। पोर्ट्रेट-शैली की दर्जनों या सैकड़ों यथार्थवादी इमेज एकसमान क्वालिटी के साथ बनाना वही जगह है जहाँ Imagen की आर्किटेक्चर काम आती है। बड़े बैच में आउटपुट की स्थिरता दूसरे सिस्टम में सावधान प्रॉम्प्टिंग और मैनुअल पोस्ट-सिलेक्शन के बिना इस स्थिरता को हासिल करना मुश्किल है।
टेक्स्ट की सटीकता से समझौता नहीं। लेबल, साइनबोर्ड, कंपोज़िशन में टाइपोग्राफ़िक तत्व: अगर इमेज के अंदर के शब्द सही होने ही चाहिए, तो आज उपलब्ध ज़्यादातर विकल्पों की तुलना में Imagen सुरक्षित चुनाव है।
Google Cloud इकोसिस्टम का इंटीग्रेशन। जो टीमें पहले से Vertex AI, BigQuery और Google के MLOps इन्फ़्रास्ट्रक्चर में हैं, उनके लिए इंटीग्रेशन का रास्ता छोटा है। मौजूदा Google Cloud पाइपलाइन में Imagen जोड़ना एक सीधा API कनेक्शन है।
अनुपालन-संवेदनशील वातावरण। रेगुलेटेड इंडस्ट्री या सख्त कंटेंट गवर्नेंस वाले संगठनों को Imagen की अंतर्निहित सेफ़्टी लेयर बाधा नहीं, बल्कि ऑपरेशनल रूप से उपयोगी लगती है। जो वही फ़िल्टर कुछ क्रिएटिव यूज़र्स को परेशान करते हैं, वे हेल्थकेयर, फ़ाइनेंस और कानूनी संदर्भों में अनुपालन का भरोसा देते हैं।
जिन स्थितियों में कोई दूसरा टूल जीतता है
आपको स्टाइल कंट्रोल चाहिए। कोई LoRA सपोर्ट नहीं, कोई फ़ाइन-ट्यूनिंग नहीं, कोई कस्टम विज़ुअल पहचान एम्बेड करने की सुविधा नहीं, यानी Imagen किसी खास ब्रांडेड सौंदर्य को लगातार नहीं दे सकता। स्टाइल-स्थिर आउटपुट के लिए प्रशिक्षित LoRA के साथ Flux Redux Dev अधिक व्यावहारिक समाधान है।
बजट की सीमाएँ असली हैं। API के ज़रिए Imagen से हर इमेज बनाने पर पैसे लगते हैं। PicassoIA के टेक्स्ट-टू-इमेज टूल्स तुलनीय फ़ोटोरियलिस्टिक जनरेशन देते हैं, जिसमें प्रति इमेज का खर्च काफ़ी कम है और संभालने के लिए कोई अकाउंट इन्फ़्रास्ट्रक्चर नहीं है।
तेज़ इटरेशन मायने रखता है। Imagen का API सेटअप तेज़ क्रिएटिव प्रोटोटाइपिंग में घर्षण पैदा करता है। ऐसा प्लेटफ़ॉर्म, जहाँ आप क्रेडेंशियल मैनेज किए बिना प्रॉम्प्ट लिखकर परिणाम देख सकें, एक्सप्लोरेशन के चरण को काफ़ी तेज़ कर देता है।
आपको फ़ोटोग्राफ़िक के बजाय आर्टिस्टिक आउटपुट चाहिए। Imagen फ़ोटोरियलिज़्म के लिए बना है। स्टाइलाइज़्ड इलस्ट्रेशन, कॉन्सेप्ट आर्ट, पेंटरली रेंडरिंग: इनके लिए समर्पित स्टाइलिस्टिक मॉडल बेहतर काम करते हैं और सेफ़्टी फ़िल्टर के इनकार भी कम मिलते हैं।
Imagen तक कैसे पहुँचें
Google Cloud Vertex AI
Imagen Google Cloud के Vertex AI API के ज़रिए एक्सेस किया जाता है। सेटअप के लिए Google Cloud प्रोजेक्ट, बिलिंग अकाउंट, चालू Vertex AI API, और उचित IAM अनुमतियों वाला एक सर्विस अकाउंट चाहिए। Google Python, Node.js और Java में SDK देता है। एक न्यूनतम Python कॉल कुछ ऐसी दिखती है:
from vertexai.preview.vision_models import ImageGenerationModel

model = ImageGenerationModel.from_pretrained("imagegeneration@006")
images = model.generate_images(
    prompt="a ceramic coffee mug on a birch wood table, morning window light, photorealistic",
    number_of_images=1
)
images[0].save("output.jpg")
API प्रति रिक्वेस्ट इमेज की संख्या, आस्पेक्ट रेशियो, रिप्रोड्यूसिबिलिटी के लिए सीड वैल्यू और सेफ़्टी फ़िल्टर की सख्ती जैसे पैरामीटर स्वीकार करता है। प्रोडक्शन उपयोग के लिए Imagen 3 इस समय सुझाया गया वर्ज़न है।
कीमत की असली तस्वीर
2025 के अनुसार, Vertex AI पर Imagen की कीमत रेज़ोल्यूशन और मॉडल वर्ज़न के आधार पर लगभग $0.02 से $0.04 प्रति इमेज है। कभी-कभार के उपयोग के लिए यह ठीक है। प्रोडक्शन स्तर पर, हर महीने 10,000 इमेज का मतलब स्टोरेज, कंप्यूट या दूसरे इन्फ़्रास्ट्रक्चर खर्च से पहले ही $200 से $400 की लागत है। सुलभ प्लेटफ़ॉर्म पर ओपन-सोर्स विकल्प प्रति इमेज यह लागत खत्म कर देते हैं, हालाँकि आउटपुट की कुछ एकरूपता की कीमत पर।
2027 में फ़ोटोरियलिज़्म कैसा दिखता है
जब से Imagen पहली बार आया, फ़ोटोरियलिज़्म का पैमाना काफ़ी आगे बढ़ चुका है। 2022 में जो चीज़ इसे अलग करती थी, उस तक अब कई विकसित विकल्प पहुँच चुके हैं। पिछले दो वर्षों में पोर्ट्रेट फ़िडेलिटी और मटीरियल रेंडरिंग में Imagen की बढ़त काफ़ी कम हुई है।
Flux, PicassoIA के इमेज जनरेशन प्लेटफ़ॉर्म पर उपलब्ध, ऐसे आउटपुट देता है जिनकी नैचुरलिस्टिक क्वालिटी फ़ोटोरियलिज़्म के ज़्यादातर उपयोगों में Imagen को टक्कर देती है। Flux Redux Dev पोर्ट्रेट-शैली की इमेज और जटिल कंपोज़िशन में खास तौर पर मज़बूत है, और इसके लिए किसी Google Cloud एक्सेस या प्रति-इमेज बिलिंग की ज़रूरत नहीं है।
Imagen में जो वास्तव में अलग बना हुआ है, वह है टेक्स्ट रेंडरिंग की सटीकता और एंटरप्राइज़ इंटीग्रेशन की कहानी। ये असली फ़ायदे हैं, जिन्हें प्रतिस्पर्धी ओपन-सोर्स टूल्स पूरी तरह पाट नहीं पाए हैं। फ़ोटोरियलिज़्म की बाकी श्रेणी के लिए, चुनाव इस पर ज़्यादा निर्भर करता है कि आपका वर्कफ़्लो, बजट और इटरेशन की रफ़्तार कैसी है, बजाय इसके कि कौन-सा मॉडल किसी सैद्धांतिक क्वालिटी बेंचमार्क में जीतता है।
💡 व्यावहारिक नियम: अगर आपका वर्कफ़्लो पहले से Google Cloud पर चलता है और आपको इमेज के अंदर सटीक टेक्स्ट चाहिए, तो Imagen अपनी जगह कमाता है। अगर आप Google इकोसिस्टम के बाहर बना रहे हैं और प्रॉम्प्ट की सटीकता के साथ प्रयोग का समय और बजट रखते हैं, तो आधुनिक Flux मॉडल कम ऑपरेशनल लागत पर ज़्यादातर फ़ोटोरियलिज़्म ज़रूरतें पूरी करते हैं।
अभी फ़ोटोरियलिस्टिक इमेज बनाना शुरू करें
टेक्स्ट से उच्च-क्वालिटी फ़ोटोरियलिस्टिक इमेज बनाने के लिए आपको Google Cloud अकाउंट, Vertex AI सेटअप या बिलिंग अकाउंट की ज़रूरत नहीं है।
PicassoIA के टेक्स्ट-टू-इमेज टूल्स में Flux Redux Dev सहित मॉडल सीधे आपके ब्राउज़र में मिलते हैं। एक विस्तृत प्रॉम्प्ट लिखें, रोशनी, कंपोज़िशन और सब्जेक्ट तय करें, और जनरेट करें। कोई क्रेडेंशियल नहीं, कोई इन्फ़्रास्ट्रक्चर सेटअप नहीं, और ट्रैक करने के लिए कोई प्रति-इमेज बिलिंग नहीं।
PicassoIA Image Editor Pro इनपेंटिंग, आउटपेंटिंग और इमेज-टू-इमेज वर्कफ़्लो जोड़ता है, जिससे आप हर बार शुरुआत से करने के बजाय नतीजों पर काम कर सकते हैं। अगर आपकी रेफ़रेंस इमेज करीब है पर पूरी तरह सही नहीं, तो ये टूल्स उस अंतर को भर देते हैं।
Google के बंद API जो देता है और सुलभ प्लेटफ़ॉर्म आज जो दे रहे हैं, उनके बीच का फ़ासला लोगों की उम्मीद से कहीं ज़्यादा करीबी है। जिस फ़ोटोरियलिस्टिक क्वालिटी ने Imagen को उल्लेखनीय बनाया था, वह अब ऐसे टूल्स में उपलब्ध है जिन तक आप अभी ब्राउज़र में पहुँच सकते हैं, बिना क्लाउड अकाउंट के। किसी साफ़ प्रॉम्प्ट से शुरू करें, रोशनी और टेक्सचर के बारे में सटीक रहें, और आउटपुट की क्वालिटी खुद बता देगी कि फ़ोटोरियलिस्टिक AI जनरेशन इतना व्यावहारिक क्यों बन गया है।