Produzir conteúdo de nível profissional costumava exigir uma equipe inteira. Um videomaker, um designer de som, um artista gráfico, um dublador. Hoje, uma única pessoa com as ferramentas certas de IA consegue produzir tudo do zero em uma tarde. A distância entre o que um criador solo e um estúdio conseguem entregar nunca foi tão pequena, e ela continua diminuindo.
O desafio é saber quais ferramentas realmente valem o seu tempo. O mercado de IA está saturado de produtos que geram demonstrações impressionantes, mas falham em fluxos de trabalho reais. A seguir, uma análise focada nas 7 capacidades que todo criador sério deveria estar usando, com modelos específicos, aplicações reais e observações honestas sobre onde cada uma entrega resultados.
A geração de texto para imagem é a base do trabalho criativo com IA. Você escreve um prompt descrevendo o que quer, e um modelo produz uma imagem fotorrealista ou estilizada em segundos. A velocidade, a variedade e a qualidade disponíveis hoje são notáveis em comparação com o que era possível há apenas três anos.
O que os modelos realmente fazem
Um modelo de texto para imagem lê o seu prompt e sintetiza uma imagem prevendo distribuições de pixels com base em bilhões de exemplos de treinamento. A qualidade do resultado depende da arquitetura do modelo, dos dados de treinamento e de quão precisamente você escreve o prompt. Os modelos atuais lidam com cenas complexas, iluminação consistente, proporções corretas e texturas finas de materiais com uma confiabilidade impressionante.
A faixa prática é mais ampla do que a maioria dos criadores imagina. Você pode produzir retratos fotorrealistas indistinguíveis de um ensaio de estúdio, visualizações arquitetônicas com perspectiva correta, maquetes de produtos que atendem a padrões comerciais e ilustrações conceituais para apresentações ou propostas.
Por que os criadores montam fluxos de trabalho em torno dela
- Miniaturas que consistentemente superam as alternativas de banco de imagens
- Visuais para redes sociais gerados conforme as especificações exatas da marca em minutos
- Concept art para produções de vídeo, propostas para clientes e planejamento de campanhas
- Maquetes de produtos sem sessões de fotografia caras
- Variações de criativos para anúncios em escala, testando várias abordagens visuais a baixo custo
Na PicassoIA, mais de 90 modelos de texto para imagem estão acessíveis a partir de uma única interface, cobrindo desde retratos fotorrealistas até renderização arquitetônica e estilizações controladas. Você pode iterar por vários modelos com o mesmo prompt para encontrar o que se encaixa no seu briefing específico. Explore a coleção completa em picassoia.com/en/all-models.
💡 Dica de prompt: Especificidade multiplica a qualidade. "Uma mulher sorrindo ao ar livre" produz um resultado genérico aceitável. "Uma mulher rindo, luz lateral de hora dourada, 85mm f/1.8, multidão de festival de verão com fundo em bokeh suave, tons de Kodak Portra 400, textura natural da pele" produz algo utilizável em contexto profissional. Quanto mais você descreve a fotografia, mais o modelo se comporta como uma câmera.
| Caso de uso | Detalhe de prompt necessário | Qualidade do resultado |
|---|
| Miniaturas para redes sociais | Médio | Excelente |
| Maquetes de produtos | Alto | Excelente |
| Esboços conceituais | Baixo-médio | Bom |
| Fotografia de retratos | Alto | Excelente |
| Renderizações arquitetônicas | Muito alto | Muito bom |
O vídeo é o formato de conteúdo dominante em todas as plataformas, e a geração de vídeo com IA agora está genuinamente pronta para produção. Já passamos da era dos clipes com falhas e de aparência esquisita, que logo parecem artificiais. Os modelos de 2027 produzem resultados suaves e cinematográficos a partir de prompts de texto ou de imagens estáticas, que se sustentam em contextos profissionais.
Do texto ao clipe finalizado
Os modelos de texto para vídeo estendem a síntese de imagens ao longo do tempo. Cada quadro precisa ser temporalmente consistente com o anterior, o que é computacionalmente mais difícil e explica por que a qualidade dos modelos de vídeo ficou um pouco atrás dos modelos de imagem. A distância diminuiu rapidamente, e a geração atual é utilizável para trabalhos comerciais.
Os modelos que vale conhecer
Seedance 2.0 da ByteDance gera vídeo com áudio nativo integrado. Movimento e som sincronizados em uma única passagem de geração simplificam bastante a pós-produção para criadores que precisam de entregas rápidas de conteúdo para redes sociais.
Veo 3.1 da Google produz saída em 1080p com forte coerência temporal. Ele lida bem com prompts de movimento de câmera, incluindo travellings para frente, panorâmicas e planos de acompanhamento, o que o torna a opção mais forte para conteúdo narrativo e cinematográfico.
Kling v3 produz resultados cinematográficos com forte consistência de movimento de personagens. A variante Kling v3 Motion Control adiciona direção precisa sobre o movimento do corpo e os caminhos da câmera para criadores que precisam de controle rigoroso da ação.
LTX 2.3 Pro gera saída em resolução 4K, o que importa para conteúdo destinado a telas grandes ou para filmagens que precisam ser recortadas e reenquadradas na pós-produção.
Pixverse v6 lida com cenas de movimento complexas, incluindo dinâmica de multidões, efeitos ambientais e interações entre vários personagens, com saída de áudio sincronizado incluída.
💡 Dica de fluxo de trabalho: Use a geração de imagem para vídeo quando precisar de controle sobre o primeiro quadro. Gere primeiro sua imagem de origem com um modelo de texto para imagem e depois envie-a para o Wan 2.7 I2V para animá-la. Essa abordagem híbrida lhe dá precisão visual e coerência de movimento.
Para que os criadores usam vídeo com IA:
- Clipes curtos para Reels, Shorts e TikTok
- Imagens de cobertura (B-roll) para inserir em produções do YouTube
- Sequências de demonstração de produtos
- Conteúdo narrativo animado e séries de histórias
- Produção de vídeos de marca sem uma equipe de filmagem
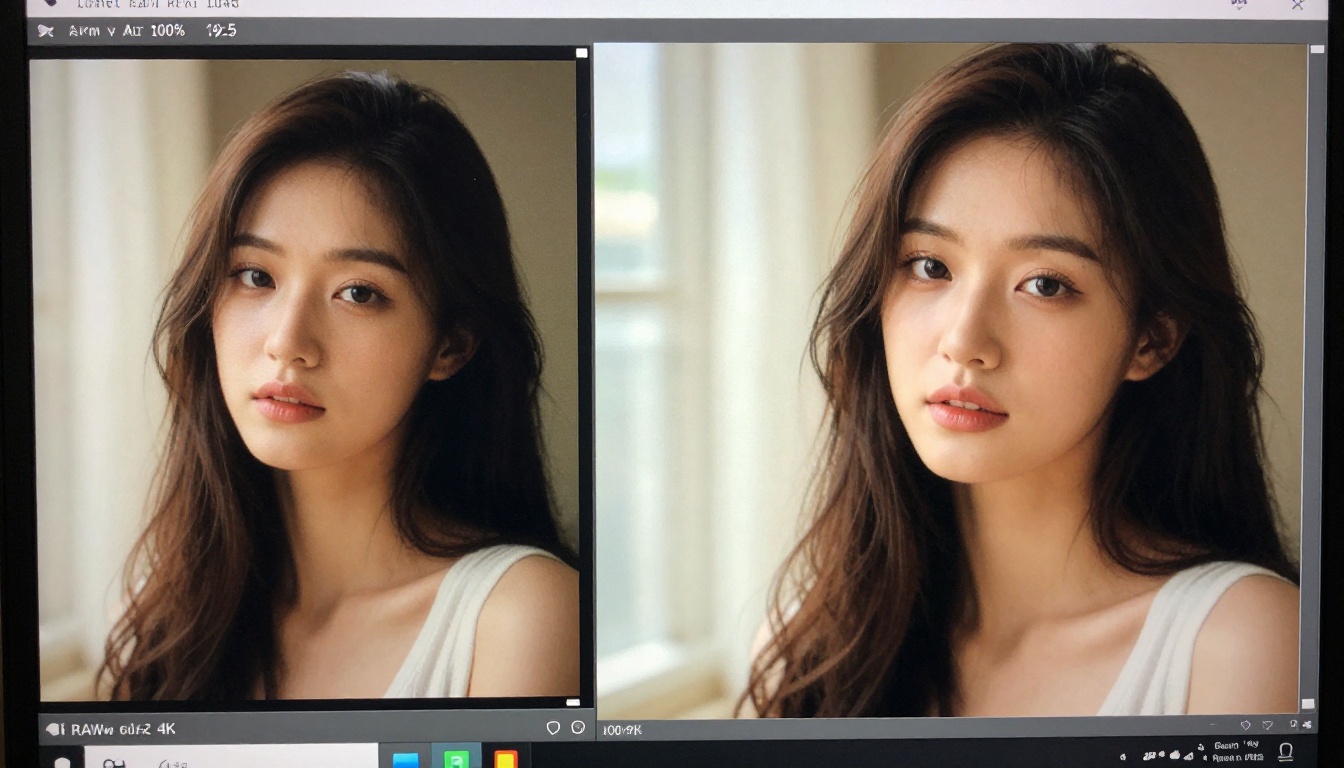
Você tem um ótimo material de origem que foi captado em resolução mais baixa, muito comprimido para exibição na web ou recortado de um quadro maior. O upscaling com IA resolve, com muita rapidez, um problema real e frequente de produção.
Como o upscaling realmente funciona
Os modelos de super resolução são treinados para prever os detalhes de alta frequência que foram perdidos ou nunca foram captados em uma imagem de resolução mais baixa. Eles não simplesmente esticam e interpolam pixels. Eles sintetizam textura, nitidez e detalhes finos com base em previsões estatísticas sobre o que deveria existir naquela região, considerando o contexto ao redor. A diferença de qualidade em relação à interpolação bicúbica é significativa e visível de imediato.
Ferramentas que entregam resultados consistentes
Clarity Pro Upscaler é o padrão atual para resultados fotorrealistas. Ele adiciona textura fina a retratos, paisagens e fotos de produtos, sem o suavizado plástico e excessivo que caracterizava upscalers mais antigos. Pele, tecido, cabelo e superfícies arquitetônicas respondem bem.
Real ESRGAN é um cavalo de batalha comprovado e confiável. Ele lida com upscaling de 4x em uma ampla variedade de tipos de conteúdo, desde fotografia até materiais ilustrados, e processa rápido o bastante para fluxos em lote em que o volume importa.
Image Upscale by Topaz Labs suporta ampliação de até 6x e tem desempenho especialmente bom em texturas finas, como a trama de tecidos, fios de cabelo e superfícies arquitetônicas. Para máxima recuperação de detalhes, este é o teto do que está disponível atualmente.
P Image Upscale da PrunaAI processa imagens em menos de um segundo, o que o torna a opção mais rápida para fluxos de trabalho em que o volume importa mais do que a máxima qualidade de aprimoramento.
| Modelo | Upscale máximo | Melhor para |
|---|
| Clarity Pro Upscaler | 4x | Detalhe fotorrealista, retratos |
| Real ESRGAN | 4x | Uso geral, tipos de conteúdo misturados |
| Image Upscale (Topaz) | 6x | Recuperação máxima de textura |
| P Image Upscale | 4x | Velocidade, processamento em lote |
A remoção de fundo parece simples, e por muito tempo foi um trabalho manual tedioso e demorado. A IA moderna faz isso de forma instantânea e com precisão suficiente para uso em produção comercial.
Por que importa mais do que se espera
Um recorte limpo é o ponto de partida para fotografia de produtos, composição de miniaturas, produção de ativos de marca e montagem de imagens compostas. A qualidade do recorte determina a qualidade de tudo o que é construído sobre ele. Bordas mal mascaradas, franjas em volta do cabelo ou partes faltando ficam imediatamente visíveis no trabalho finalizado e transmitem uma impressão de produção de baixa qualidade.
O modelo da Bria lida com os casos-limite que antes exigiam máscaras manuais: fios de cabelo finos, elementos translúcidos como óculos ou tecidos finos, formas naturais complexas como plantas e pelos. Ele processa com qualidade comercial e se integra diretamente ao fluxo de trabalho da PicassoIA, então você pode remover um fundo e, na sequência, levar o resultado para um editor de imagens, um compositor ou uma ferramenta de vídeo sem atrito de exportação.
💡 Dica: Após a remoção de fundo, passe o resultado por uma etapa de restauração com IA para limpar os artefatos das bordas antes da composição. A combinação produz resultados que equivalem à qualidade de recorte de estúdio profissional, com uma fração do tempo investido.
Aplicações comuns:
- Imagens de listagem de produtos para e-commerce em escala
- Isolamento de sujeito para miniaturas do YouTube
- Criação de stories e modelos para redes sociais
- Bibliotecas de ativos de marca e produção de sistemas visuais
- Montagem de imagens compostas para publicidade e campanhas
Música original para conteúdo é cara. Licenciar bibliotecas livres de royalties é econômico, mas as mesmas faixas aparecem em todo lugar e o público as reconhece. A geração de música com IA muda a economia por completo: você descreve o que quer e recebe um áudio original, sem preocupações com licenciamento nem taxas por uso.
Como a qualidade se compara às alternativas
A melhora nos últimos 18 meses foi acentuada. A música com IA dos primeiros tempos tinha uma monotonia e uma previsibilidade características, com progressões genéricas e instrumentação intercambiável. Os modelos atuais produzem faixas com faixa dinâmica real, coerência estrutural ao longo de músicas completas e instrumentação que responde de forma significativa às especificidades do prompt.
Os modelos que fazem o trabalho
Lyria 3 Pro da Google produz composições completas com estrutura musical profissional, incluindo verso, refrão e crescimentos dinâmicos. Dê um gênero, um clima e um andamento, e ele devolve uma música completa, e não um loop.
Music 2.6 da Minimax é rápido e gera faixas vocais junto com arranjos instrumentais. Para conteúdo que precisa de uma canção com elementos cantados, e não apenas um fundo instrumental, esta é a opção mais prática disponível atualmente.
ElevenLabs Music se integra naturalmente se você já usa a ElevenLabs para trabalhos de voz. Os controles de estilo são detalhados o suficiente para acompanhar um clima de referência específico sem produzir algo que soe como uma cópia derivada.
Stable Audio 2.5 da Stability AI é a opção mais forte para trabalhos atmosféricos e ambientes. Conteúdo de longa duração, sequências cinematográficas e qualquer situação em que a música precise ficar por baixo de um diálogo sem competir com ele respondem bem às características de seu resultado.
Para que os criadores usam música com IA:
- Vinhetas de abertura, encerramento e faixas de fundo para o YouTube
- Áudio de transição e vinhetas para podcasts
- Ganchos de áudio original para Reels nas redes sociais
- Vídeos de marca com trilha sonora sem um compositor
- Design de áudio para cursos e conteúdo educacional
6. Texto para fala com IA
Os melhores modelos atuais de texto para fala são genuinamente difíceis de distinguir de um dublador profissional humano na primeira audição. Para criadores que produzem grandes volumes de conteúdo narrado, esta é uma das mudanças de fluxo de trabalho mais significativas disponíveis agora.
Como ele está sendo realmente usado
A aplicação óbvia é a narração, mas a faixa prática é mais ampla. Dublagem de conteúdo traduzido para outros idiomas em escala. Criação de vozes de personagens para projetos animados ou ilustrados. Geração de áudio provisório para edições de vídeo antes de uma gravação final de voz. Produção de versões em áudio de artigos escritos para acessibilidade e alcance. Teste de roteiros e ritmo antes de reservar um estúdio de gravação.
Modelos que entregam qualidade real
V3 by ElevenLabs é o padrão atual de naturalidade. Ele lida com variação emocional, mudanças de ritmo e entonação conversacional que modelos anteriores de TTS não conseguiam produzir. A narração de longa duração mantém a consistência tonal por vários minutos, sem a deriva robótica que antes caracterizava a voz sintética.
Speech 2.8 HD da Minimax produz áudio com qualidade de estúdio e uma resposta de frequência extremamente limpa. É a escolha certa quando a saída será ouvida em fones ou alto-falantes de qualidade, onde artefatos de compressão e falhas de frequência se tornam audíveis.
Chatterbox Pro da Resemble AI adiciona clonagem de voz a um modelo base de TTS forte, permitindo criar uma voz personalizada consistente a partir de uma amostra curta de áudio de referência. Para criadores que constroem uma identidade sonora reconhecível, vale priorizar isso desde cedo.
Gemini 3.1 Flash TTS oferece suporte a 30 vozes distintas em mais de 70 idiomas. Para criadores que publicam conteúdo multilíngue ou atendem públicos que não falam inglês, esta é a opção mais prática disponível atualmente.
| Situação | Melhor modelo |
|---|
| Narração de longa duração | V3 (ElevenLabs) |
| Conteúdo multilíngue | Gemini 3.1 Flash TTS |
| Identidade de voz personalizada | Chatterbox Pro |
| Saída de áudio de alta fidelidade | Speech 2.8 HD |
A última categoria reúne um conjunto de ferramentas especializadas que fazem um trabalho visual que antes exigia conhecimento de After Effects ou de um artista de motion graphics dedicado. É aqui que imagens paradas se tornam conteúdo em movimento, que o áudio dirige a animação visual e que filmagens existentes são estendidas ou reestilizadas.
O que entra nesta categoria
Animação de imagem para vídeo de sujeitos parados. Transferência de estilo e recoloração de vídeo. Animação de personagens a partir de poses de referência. Geração de sincronização labial que alinha o movimento da boca a qualquer faixa de áudio. Restauração e upscaling de vídeo para material de arquivo. Juntas, essas ferramentas permitem que um criador solo produza conteúdo polido e rico em movimento, sem habilidades especializadas de pós-produção nem anos de prática em edição de linha do tempo.
Ferramentas que fazem trabalho criativo real
Wan 2.7 T2V gera vídeo em 1080p a partir de texto com forte aderência ao prompt. É rápido o bastante para testes iterativos de conceito antes de se comprometer com uma direção final em uma produção maior.
Wan 2.7 I2V usa uma imagem estática como primeiro quadro e anima a partir dela, produzindo movimento consistente com a composição de origem. Para animar suas próprias imagens geradas ou fotografadas, esta é a opção mais controlável disponível.
Kling Avatar v2 anima imagens de rosto em vídeo com movimento facial e expressão realistas. Para conteúdo no estilo de porta-voz ou para animação de personagens a partir de um retrato de referência, isso elimina o que antes era uma barreira técnica significativa para criadores solo.
Audio to Video by Lightricks pega uma faixa de áudio e anima uma imagem de origem para acompanhar o seu ritmo e energia. É a solução direta para conteúdo de videoclipes, miniaturas animadas de podcasts ou vídeos de marca sincronizados com áudio, sem habilidades de edição em linha do tempo.
💡 Combine essas ferramentas: Gere uma imagem, faça o upscaling para 4K com o Clarity Pro Upscaler, anime-a com o Wan 2.7 I2V e depois sincronize-a com uma música gerada pelo Lyria 3 Pro. Isso resulta em uma peça totalmente produzida, sem recursos de banco de imagens e sem custos de licenciamento.
O valor prático de ter as 7 capacidades em um só lugar é a continuidade do fluxo de trabalho. Alternar entre cinco serviços de IA separados, com sistemas de créditos, interfaces e formatos de exportação de arquivos diferentes, cria um atrito que se acumula ao longo de um dia de produção. Pequenos atrasos somam horas reais.
A PicassoIA reúne mais de 90 modelos de imagem, 107 modelos de vídeo, upscalers, removedores de fundo, geradores de música e ferramentas de voz em uma única interface. Você gera uma imagem, remove seu fundo, faz o upscaling, anima-a, adiciona uma faixa de voz e a sonoriza com música original sem trocar de plataforma nem gerenciar várias contas.
Para criadores que produzem conteúdo em volume, essa continuidade vale mais do que qualquer pequena vantagem de qualidade de um único modelo sobre um concorrente.
As 7 ferramentas de IA que vale incorporar ao seu fluxo de trabalho:
- Geração de texto para imagem para ativos visuais em qualquer escala
- Texto para vídeo para conteúdo em movimento sem câmera nem equipe
- Super resolução para upscaling, recuperação de qualidade e preparação para impressão
- Remoção de fundo para composições limpas e ativos de produtos
- Geração de música com IA para áudio original e livre de royalties
- Texto para fala para narração escalável e conteúdo multilíngue
- Efeitos visuais e animação para resultados de movimento polidos
Você não precisa usar as sete em todo projeto. Comece pela que resolve seu gargalo atual. Se os visuais estão atrasando você, comece pela geração de imagens. Se você paga licenças de música, comece pela música com IA. Se as narrações levam dois dias, comece pelo texto para fala. Use uma até que ela seja rápida e confiável no seu fluxo de trabalho e então adicione a próxima.
Todos os modelos listados aqui estão disponíveis em picassoia.com/en/all-models. Escolha o que se encaixa no seu próximo projeto e veja quanto muda em uma única sessão.


