A espera acabou. O que antes levava horas de trabalho manual agora acontece em segundos. A transição dos fluxos de trabalho criativos tradicionais para a geração com IA representa uma das mudanças de produtividade mais significativas na criação de conteúdo digital. Essa transformação não se trata de substituir a criatividade humana, e sim de acelerar a fase de execução para que os criadores possam se concentrar na ideação e no refinamento.
Close extremo de imagens de IA sendo renderizadas em tempo real: veja os pixels passarem de padrões abstratos a imagens fotorrealistas em poucos segundos.
O que mudou na velocidade da IA
Três anos atrás, gerar uma única imagem de alta qualidade podia levar minutos. Hoje, o mesmo processo termina em menos de 10 segundos com modelos como o Flux 2 Klein 4B e o P-Image da PrunaAI. A aceleração vem de melhorias na arquitetura, otimização de hardware e técnicas especializadas de inferência.
Otimizações de arquitetura incluem:
- Destilação de modelos: modelos menores e mais rápidos que mantêm a qualidade
- Quantização: cálculos com precisão reduzida e perda mínima de qualidade
- Processamento paralelo: inferência com múltiplas GPUs dividindo a carga de trabalho
- Otimização de cache: reaproveitamento de cálculos para prompts semelhantes
💡 Dica sobre velocidade: O modelo Z-Image Turbo é otimizado especificamente para a velocidade de geração, mantendo a qualidade fotorrealista da saída, o que o torna ideal para fluxos de trabalho de iteração rápida.
A revolução da criação de vídeo em tempo real
Os prazos de produção de vídeo despencaram. Onde a animação tradicional podia exigir semanas, os geradores de vídeo com IA hoje produzem resultados comparáveis em minutos. Os modelos Kling V2.6 e WAN 2.6 T2V demonstram essa aceleração, gerando sequências de vídeo coerentes a partir de prompts de texto em menos de dois minutos.
Perspectiva de baixo ângulo de um editor de vídeo trabalhando com várias sequências geradas por IA ao mesmo tempo: quatro vídeos diferentes sendo renderizados em paralelo.
Fatores de aceleração do vídeo:
- Algoritmos de coerência de quadros: mantêm a consistência entre as sequências
- Previsão de movimento: reduzem o cálculo para movimentos previsíveis
- Compressão temporal: otimizam o processamento entre quadros
- Escalonamento de resolução: alocação inteligente de detalhes com base no movimento
| Fluxo de vídeo tradicional | Fluxo com IA | Redução de tempo |
|---|
| Storyboard: 2-3 dias | Refinamento do prompt: 30 minutos | 94% mais rápido |
| Criação de ativos: 1-2 semanas | Geração com IA: 2-3 horas | 90% mais rápido |
| Animação: 3-4 semanas | Síntese de movimento: 4-6 horas | 95% mais rápido |
| Edição: 1 semana | Montagem automatizada: 1-2 horas | 85% mais rápido |
| Total: 6-8 semanas | Total: 8-12 horas | 99% mais rápido |
Eficiência do processamento em lote
O verdadeiro poder da IA moderna aparece quando várias solicitações são processadas ao mesmo tempo. O processamento em lote permite que os criadores gerem dezenas de variações, testem estilos diferentes e explorem direções criativas no tempo que antes era necessário para uma única saída.
Vista por cima do ombro de um processamento em lote com IA: dezenas de janelas de geração trabalhando em paralelo num monitor ultralargo curvo.
Técnicas de otimização em lote:
- Processamento paralelo de prompts: execução de várias gerações simultaneamente
- Grupos de consistência de estilo: mantêm a coerência entre as variações
- Refinamento progressivo: iteração sobre as melhores saídas de cada lote
- Filtragem automatizada: seleção assistida por IA dos resultados mais fortes
Fluxo prático em lote:
- Gere de 20 a 30 variações iniciais com o Qwen Image 2512
- Use o ranqueamento por IA para identificar os 5 melhores candidatos
- Refine esses 5 com ajustes detalhados de parâmetros
- Faça a seleção final e o upscaling com o Crystal Upscaler
- Tempo total: de 15 a 20 minutos para o que antes levava dias
A aceleração por GPU por trás da velocidade
A base de hardware dessa aceleração está em arquiteturas de GPU especializadas, otimizadas para inferência de IA. As GPUs modernas processam milhares de operações em paralelo, reduzindo drasticamente o tempo de geração.
Rack de servidores com intensa atividade computacional: indicadores luminosos mostram o processamento paralelo em várias GPUs.
Fatores de otimização de GPU:
- Tensor cores: unidades especializadas em operações matriciais
- Largura de banda de memória: transferência de dados mais rápida entre as unidades de processamento
- Arquitetura paralela: milhares de núcleos trabalhando simultaneamente
- Eficiência de resfriamento: desempenho alto e sustentado, sem throttling térmico
Recomendações de hardware para velocidade:
- Entrada: RTX 4070 (12GB), geração de imagem em 5-8 segundos
- Profissional: RTX 4090 (24GB), geração de imagem em 2-4 segundos
- Servidor: clusters A100/H100, processamento em lote em menos de um segundo
- Soluções em nuvem: plataforma PicassoIA, geração instantânea sem investimento em hardware
Comparação entre fluxos de trabalho
A mudança dos fluxos tradicionais para os fluxos com IA representa mais do que economia de tempo: é uma mudança fundamental na estrutura do processo criativo.
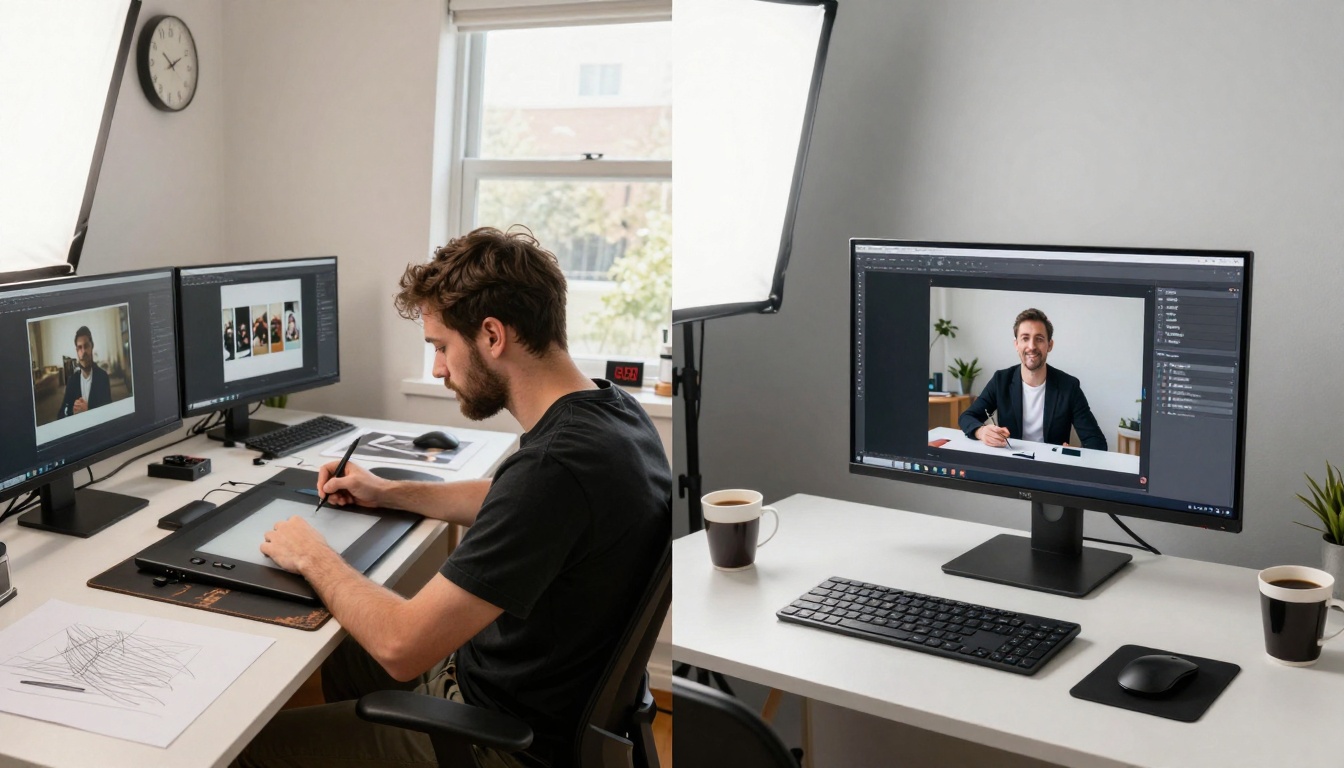
Visualização em tela dividida: espaço de trabalho tradicional e desorganizado de um lado, configuração limpa com IA do outro, mostrando a enorme diferença de tempo.
Gargalos do fluxo tradicional:
- Criação manual de ativos (esboço, modelagem, texturização)
- Dependências de processos sequenciais
- Limitações de renderização no hardware
- Atrasos nos ciclos de revisão
- Curvas de aprendizado de softwares especializados
Vantagens do fluxo com IA:
- Exploração paralela de conceitos
- Visualização instantânea de ideias
- Iteração e refinamento rápidos
- Menos barreiras técnicas
- Capacidade de produção escalável
💡 Dica sobre o processo: Os criadores mais eficientes usam a IA não como substituta, mas como aceleradora, empregando o tempo economizado em decisões criativas de nível mais alto, e não em tarefas de execução.
A velocidade não se limita aos computadores de mesa. Ferramentas de IA para celular levam recursos de geração rápida a smartphones e tablets, permitindo criar em qualquer lugar e a qualquer hora.
Smartphone exibindo vários aplicativos de IA gerando conteúdo ao mesmo tempo: criação com qualidade profissional de qualquer lugar.
Técnicas de aceleração no celular:
- Computação na borda: o processamento no próprio dispositivo evita a latência da rede
- Compressão de modelos: versões menores dos modelos de desktop
- Híbrido com nuvem: processamento pesado na nuvem, refinamento no dispositivo
- Resultados em cache: reaproveitamento de gerações semelhantes para respostas mais rápidas
Fluxos populares no celular:
- Conteúdo para redes sociais: gere imagens para publicações em 10-15 segundos
- Visuais para apresentações: crie gráficos para slides durante reuniões
- Maquetes de produtos: visualize conceitos durante discussões com clientes
- Captura de inspiração: transforme anotações em imagens na hora
Processo de refinamento iterativo
A velocidade permite uma abordagem diferente para o refinamento. Em vez de dedicar horas a uma única direção, os criadores podem explorar vários caminhos ao mesmo tempo e chegar ao resultado mais forte.
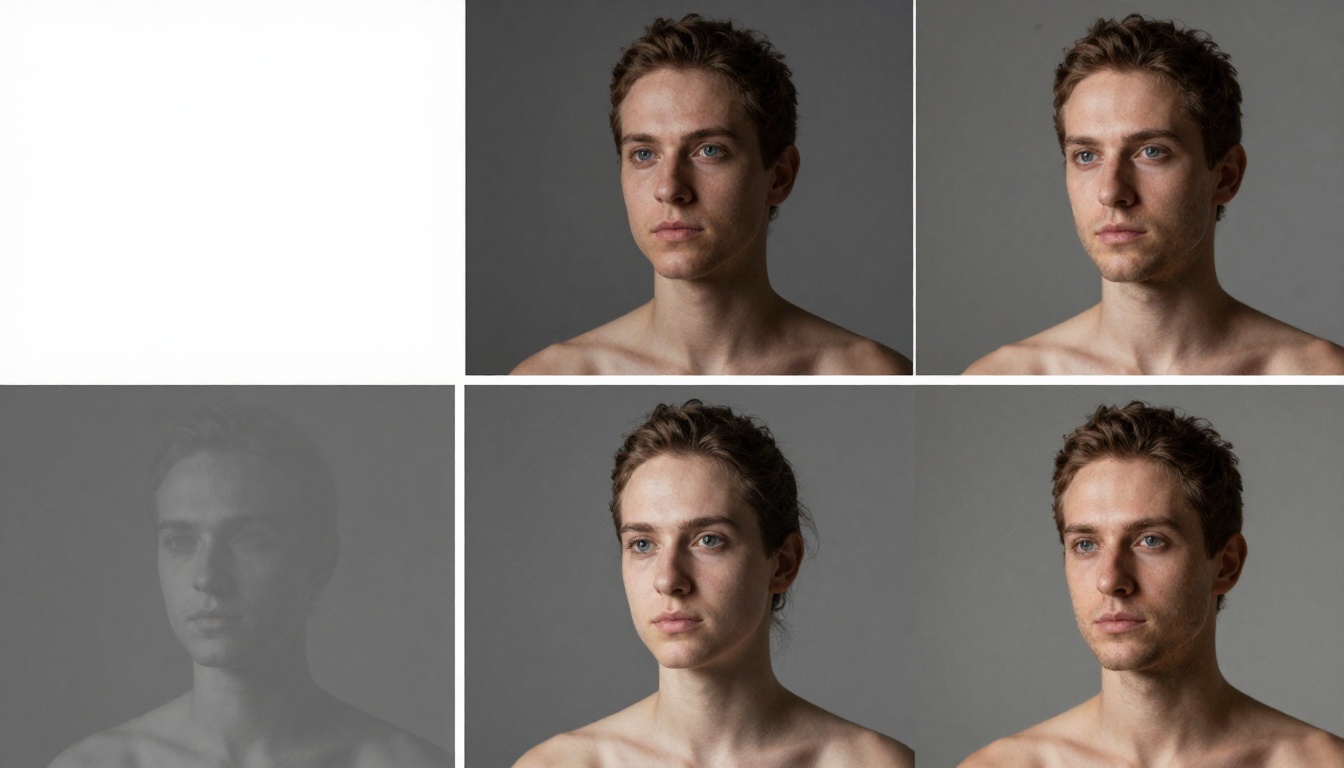
Visualização de refinamento em quatro etapas: acompanhe a qualidade evoluir de formas básicas até detalhes fotorrealistas por meio de ciclos rápidos de iteração.
Estratégia de refinamento iterativo:
- Fase 1: gere de 10 a 15 conceitos brutos (30 segundos cada)
- Fase 2: selecione os 3 melhores para desenvolvimento detalhado (60 segundos cada)
- Fase 3: refine composição e iluminação (90 segundos cada)
- Fase 4: acabamento final e upscaling (120 segundos cada)
- Total: de 7 a 8 minutos para o que exigia horas de trabalho manual
Parâmetros de refinamento a ajustar:
- Especificidade do prompt: de descrições gerais a descrições detalhadas
- Consistência de estilo: manter a coerência entre as iterações
- Ajuste de parâmetros: ajustar a amostragem, a guidance scale e as configurações de qualidade
- Integração de feedback: incorporar preferências visuais automaticamente
Dinâmica da criação ao vivo
A velocidade da IA moderna possibilita novas formas de criação interativa e colaborativa. Transmitir ao vivo sessões de geração com IA demonstra as capacidades em tempo real enquanto engaja o público.
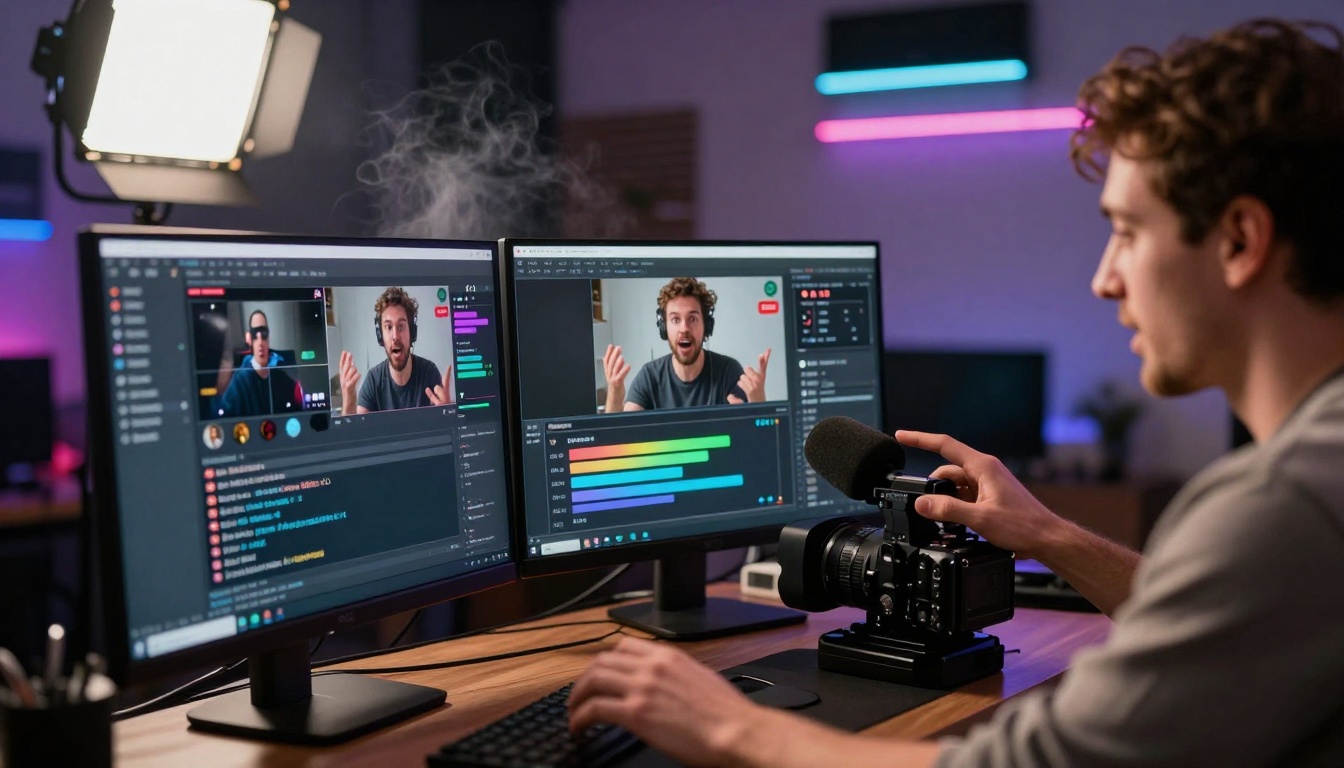
Criador de conteúdo transmitindo seu fluxo de trabalho com IA: várias telas mostram a interface de geração, o chat do público e a prévia do resultado ao mesmo tempo.
Vantagens da criação ao vivo:
- Feedback imediato: sugestões do público incorporadas em tempo real
- Processo transparente: os espectadores veem o fluxo completo de geração
- Valor educacional: demonstração de técnicas e boas práticas
- Construção de comunidade: ideação e refinamento colaborativos
Integração com ferramentas de transmissão:
- Plugins do OBS: geração de IA direto no software de transmissão
- Integração com o chat: prompts do público processados automaticamente
- Exibição de múltiplas saídas: mostra variações e progresso ao mesmo tempo
- Otimização de desempenho: manutenção da qualidade da transmissão durante a geração
Infraestrutura técnica para velocidade
Por trás da interface do usuário existe uma arquitetura técnica sofisticada, projetada para máxima vazão e latência mínima.
Visualização conceitual do fluxo de dados de IA: partículas luminosas representam informações se movendo por pipelines de processamento otimizados.
Camadas de otimização de velocidade:
1. Arquitetura do modelo
- Projetos de transformers eficientes
- Mecanismos de atenção otimizados
- Contagem reduzida de parâmetros
- Cabeçotes especializados por tarefa
2. Motor de inferência
- Compilação just-in-time
- Otimização de memória
- Adaptação do tamanho do lote
- Uso de cache
3. Camada de hardware
- Gerenciamento de memória da GPU
- Alocação de processamento paralelo
- Equilíbrio de desempenho térmico
- Otimização de eficiência energética
4. Infraestrutura de rede
- Redes de distribuição de conteúdo
- Nós de computação na borda
- Algoritmos de balanceamento de carga
- Técnicas de redução de latência
Guia prático de implementação
Acelerar seu fluxo de trabalho exige mais do que ferramentas mais rápidas: é preciso adaptar o processo e planejar a implementação de forma estratégica.
Passo 1: escolha de ferramentas conforme a necessidade de velocidade
Passo 2: reestruturação do fluxo de trabalho
- Substitua processos sequenciais por processos paralelos
- Implemente a geração em lote para variações
- Use a IA para rascunhos e a revisão humana para o acabamento final
- Estabeleça limites de qualidade para aprovação automatizada
Passo 3: adaptação do controle de qualidade
- Desenvolva protocolos de revisão rápida
- Implemente a pontuação de qualidade assistida por IA
- Crie verificações de consistência de estilo
- Estabeleça fluxos de aprovação para diferentes tipos de conteúdo
Passo 4: monitoramento de desempenho
- Acompanhe o tempo de geração por tipo de ativo
- Meça o número de iterações até a aprovação final
- Monitore a consistência da qualidade em diferentes configurações de velocidade
- Calcule o tempo economizado em comparação com os métodos tradicionais
Equilíbrio entre velocidade e qualidade
A aceleração não significa sacrificar a qualidade. Os modelos de IA modernos mantêm altos padrões enquanto reduzem drasticamente o tempo de geração.
Técnicas de preservação da qualidade:
- Refinamento progressivo: começar rápido e acrescentar detalhes iterativamente
- Geração em múltiplas passagens: rascunho rápido seguido de uma passagem de qualidade
- Abordagens híbridas: geração com IA e retoques humanos
- Transferência de estilo: aplicação de características de qualidade a partir de imagens de referência
Configurações de velocidade por caso de uso:
- Exploração de conceitos: velocidade máxima, com perda aceitável de qualidade
- Rascunhos de apresentação: equilíbrio entre velocidade e qualidade
- Entregas finais: um pouco mais lentas, com qualidade máxima
- Variações em lote: otimizadas para consistência entre as saídas
Tendências futuras de aceleração
As melhorias de velocidade atuais representam apenas o começo. Várias tecnologias emergentes prometem mais aceleração.
Desenvolvimentos de curto prazo (6 a 12 meses):
- Chips especializados em inferência: hardware projetado especificamente para geração de IA
- Avanços em compressão de modelos: modelos menores com qualidade equivalente
- Otimização de arquitetura paralela: melhor uso de sistemas com múltiplas GPUs
- Integração com computação na borda: geração móvel e local mais rápida
Desenvolvimentos de médio prazo (1 a 3 anos):
- Algoritmos inspirados em computação quântica: novas abordagens matemáticas para a geração
- Computação neuromórfica: arquiteturas de processamento inspiradas no cérebro
- Computação fotônica: processamento baseado em luz para velocidade extrema
- Redes de geração distribuída: processamento de IA ponto a ponto
Como começar a criar mais rápido
A transição para fluxos de trabalho acelerados com IA exige tanto a adoção de ferramentas quanto a mudança de processos. Comece com estes passos práticos:
- Experimente modelos focados em velocidade, como o GPT Image 1.5, para visualização rápida
- Implemente fluxos em lote para exploração de conceitos e testes de variações
- Meça seu prazo atual e defina metas específicas de aceleração
- Desenvolva protocolos de verificação de qualidade que funcionem com ciclos de geração mais rápidos
- Itere e refine seu processo com base nos ganhos reais de velocidade
As ferramentas existem. A infraestrutura dá suporte. A única dúvida que resta é a rapidez com que você vai adaptar seu processo criativo para aproveitar essas capacidades de aceleração. Teste modelos diferentes, experimente tamanhos de lote e acompanhe sua economia de tempo: é provável que você descubra que o que levava dias agora termina em horas, e o que exigia horas termina em minutos.
Tente gerar seu primeiro lote de imagens com o modelo P-Image e sinta a diferença de velocidade na prática. A aceleração não é teórica: é mensurável, prática e está disponível agora mesmo.


