Se você já assistiu a um vídeo gerado por IA e pensou "esse movimento está errado", já conhece o problema que o Kling 3.0 foi criado para resolver. Tecido que flutua em vez de cair. Cabelo que se move como um bloco rígido. Personagens cujos pés nunca encostam direito no chão. O Kling 3.0 ataca esses problemas na camada de física, produzindo movimento que se sustenta quadro a quadro em vez de se transformar em ruído visual depois de dois segundos.
Este não é mais um modelo de texto para vídeo que renderiza quadros parados bonitos e chama o movimento entre eles de "bom o suficiente". O Kling 3.0 trata o movimento como o resultado principal, e não como efeito colateral da geração de quadros. Essa distinção é o que o separa da maioria dos concorrentes no mercado de vídeo com IA neste momento.
O que o Kling 3.0 realmente faz
A maioria dos modelos de vídeo com IA gera os quadros de forma independente e depois os junta. O movimento que você vê é, em grande parte, interpolação: o modelo adivinha o que deveria haver entre o quadro A e o quadro B. O Kling 3.0 usa outra abordagem, modelando as trajetórias do movimento antes de renderizar o conteúdo visual. Essa ordem de operações importa muito para o realismo, porque a física do movimento é definida antes de os pixels serem fixados.
Física de movimento que se sustenta
A simulação de física do Kling 3.0 leva em conta as propriedades dos materiais já na etapa de simulação. Seda se comporta de forma diferente do algodão. A água responde à gravidade de um jeito diferente da poeira. Quando um personagem em um clipe do Kling v3 Video se move pelo espaço, o movimento secundário, aquilo que acompanha a ação principal, como o cabelo balançando depois que a cabeça vira ou a barra da saia atrasando em relação à passada, é calculado a partir do vetor de movimento primário, e não adivinhado quadro a quadro.
É por isso que o Kling 3.0 para movimento realista supera de forma consistente modelos mais antigos em cenas com muito tecido e em animação de retratos. O movimento secundário parece natural porque é derivado fisicamente, e não apenas previsto estatisticamente a partir dos dados de treinamento.
O modelo aplica valores de inércia diferentes para cada tipo de material. O ombro de uma jaqueta estruturada permanece fixo enquanto as lapelas se deslocam levemente. A barra de um chiffon ondula continuamente enquanto a cintura da mesma peça se mantém parada. Esses efeitos não são camadas colocadas por cima do vídeo. Eles estão incorporados ao modelo de movimento antes de a renderização começar.
Consistência temporal explicada
A consistência temporal é o que faz um vídeo de IA dar certo ou fracassar. Ela responde a uma pergunta: o sujeito continua parecendo a mesma pessoa, ou o mesmo objeto, de quadro em quadro, sem tremular, deformar ou mudar de posição?
O Kling 3.0 mantém a consistência de identidade entre os estados de movimento. Se uma mulher começa um clipe com um vestido vermelho e se vira para longe da câmera, o vestido não tremula, não muda de cor nem de silhueta entre a virada e o retorno. Versões anteriores da família Kling se saíam bem em planos estáticos, mas começavam a derivar de forma perceptível em sequências de movimento ativo. A V3 elimina a maior parte dessa deriva por meio de um mecanismo de atenção revisado, que ancora as características de identidade ao longo de todo o clipe, e não quadro a quadro.
Vale notar: A consistência temporal se degrada mais rápido no modo de clipe longo (10 segundos) do que no modo de clipe curto (5 segundos). Para cenas de movimento complexo com sujeitos ativos, dois clipes bem preparados de 5 segundos quase sempre superam um único clipe de 10 segundos que enfrenta dificuldades. Una-os na pós-produção em vez de forçar o modelo além do seu ponto ideal.
3 coisas que o Kling 3.0 faz melhor
Há categorias específicas em que a melhoria do Kling 3.0 em relação às versões anteriores é substancial o bastante para importar em trabalhos de produção. Nem toda cena se beneficia da mesma forma. Mas estas três categorias mostram os ganhos mais claros.
Tecido e cabelo fluidos
A simulação de tecido em vídeo com IA historicamente tem sido pouco confiável. O tecido ou fica rigidamente colado ao corpo, sem movimento próprio, ou se desprende totalmente da física e flutua como se estivesse suspenso debaixo d’água. O Kling 3.0 encontra o meio-termo que o torna crível: o tecido fluido mantém contato com o corpo nos pontos de ancoragem (ombros, cintura, pulsos) enquanto se move livremente nas barras e nas extremidades.
O cabelo responde à direção da cabeça com um atraso compatível com o peso real do fio, em vez de saltar instantaneamente para a nova posição. Quando um sujeito vira a cabeça para a esquerda em um clipe do Kling 3.0, o cabelo acompanha com um pequeno atraso proporcional ao seu comprimento e à densidade simulada. O resultado é o tipo de movimento incidental que faz a filmagem parecer captada por câmera, e não gerada.
Isso importa sobretudo para:
- Vídeos de moda e editorial
- Animação de retratos a partir de fotografias
- Conteúdo de estilo de vida com movimento orgânico e natural
- Qualquer cena que envolva vento, água ou interação ambiental com materiais
Movimento de câmera sem deriva
Um dos modos de falha mais comuns em vídeo com IA é o movimento composto: o que acontece quando você combina movimento de câmera com um sujeito em movimento. A câmera faz uma panorâmica, o sujeito caminha, o fundo se desloca, e o modelo perde a noção das relações espaciais. Você acaba com uma cena que parece uma pintura que alguém está dissolvendo lentamente pelas bordas para dentro.
O Kling v3 Omni Video lida com movimento composto de forma muito melhor do que qualquer variante v2.x. A geometria da cena se mantém coerente mesmo quando você especifica um travelling ou uma panorâmica junto com a ação do personagem. O fundo se ancora corretamente enquanto o sujeito se move de forma independente dentro do quadro, e as duas camadas de movimento não vazam uma para a outra.
Controle preciso do movimento de personagens
O Kling v3 Motion Control oferece uma precisão que o modelo de vídeo padrão não tem. Você pode especificar trajetórias de movimento, controlar a velocidade da ação e definir onde no quadro o movimento deve acontecer. Para criadores que precisam de resultados previsíveis, e não de variações aleatórias a cada geração, essa versão é a escolha prática para produção.
A variante de controle de movimento aceita:
- Trajetórias de movimento desenhadas com pincel indicando onde os sujeitos devem se deslocar dentro do quadro
- Modificadores de velocidade, de câmera lenta até uma versão acelerada
- Máscaras por zona para manter partes do quadro estáticas enquanto outras se animam
Para animação de retratos a partir de uma foto de referência, essa precisão é essencial. Você especifica em que direção a cabeça deve virar, quanto e em que ritmo, em vez de torcer para que o modelo interprete um prompt ambíguo do jeito que você imaginou.
Como usar o Kling 3.0 no PicassoIA
O Kling 3.0 está disponível no PicassoIA em três versões distintas do modelo, cada uma adequada a objetivos de saída diferentes. Escolher a certa antes de escrever o prompt economiza um tempo considerável de iteração e de créditos de geração.
Passo 1: escolha a versão certa do modelo
| Modelo | Melhor para | Saída |
|---|
| Kling v3 Video | Texto para vídeo geral, cenas cinematográficas | Cinematográfico em 1080p |
| Kling v3 Motion Control | Animação precisa de personagens, trajetórias controladas | Controlado em 1080p |
| Kling v3 Omni Video | Cenas complexas com vários elementos, câmera mais sujeito | Cena completa em 1080p |
Se você está começando sem uma imagem de referência e quer gerar a partir de uma descrição em texto, o Kling v3 Video é o ponto de partida certo. Se você tem um plano específico que precisa replicar a partir de uma foto de referência, ou quer controle rigoroso sobre o movimento do personagem, o Kling v3 Motion Control oferece a precisão para fazer isso sem depender da interpretação do prompt.
Passo 2: escrevendo prompts para movimento realista
O maior erro de prompt para movimento realista: descrever como a cena parece em vez do que ela faz.
Fraco: "Uma mulher de vestido branco parada em uma praia."
Forte: "Uma mulher de vestido branco de linho fluido caminhando devagar em direção à câmera por uma praia de areia, a barra do tecido se puxando para trás a cada passo enquanto o vento do oceano o pressiona contra suas pernas, o cabelo se erguendo e assentando a cada passada, pegadas deixadas na areia molhada atrás dela."
A diferença está na especificidade do movimento. O Kling 3.0 responde a verbos e modificadores de movimento: erguendo, puxando, pressionando, assentando, balançando, ondulando. Eles sinalizam ao modelo a física que ele deve aplicar, e não apenas como a composição estática deveria parecer.
Dica de prompt: Inclua a causa do movimento (vento, caminhada, virada de cabeça) junto com o efeito (tecido inflando, cabelo mudando de posição, sombra se movendo). Descrições causais produzem movimento mais internamente coerente do que descrições apenas do resultado. "O vento faz o vestido inflar" dá ao modelo uma razão física. "O vestido está inflando" é apenas um estado.
Passo 3: ajustando a duração do clipe
Para movimento realista especificamente, as diretrizes de duração abaixo se sustentam de forma consistente:
- 5 segundos: ideal para sequências de uma única ação (uma virada de cabeça, um passo à frente, tecido pego por uma rajada de vento)
- 10 segundos: funciona para cenas de movimento contínuo, mas exige fundos mais simples e menos elementos de movimento simultâneos
- Modo rápido: consistência temporal menor, aceitável para prévias rápidas e checagens de layout, mas não para a saída final
A hierarquia de versões vale conhecer para contexto: o Kling v2.6 lida bem com movimento geral e é um padrão sólido para cenas que não exigem física de tecido no nível máximo. O Kling v2.5 Turbo Pro troca um pouco de qualidade por velocidade e é útil quando você precisa de muitas iterações. O Kling v2.1 Master foi o padrão de qualidade antes da v3. Cada geração representa um avanço mensurável em realismo de movimento, não apenas em resolução.
Kling v3 ou outros modelos de vídeo
O movimento realista não é exclusivo do Kling 3.0. Vários outros modelos da plataforma competem seriamente nesse campo, e cada um tem cenários em que é a melhor escolha.
A vantagem do Kling v3 sobre os concorrentes é mais visível em simulação de tecido e física de cabelo sob movimento ativo. O Veo 3 do Google iguala ou supera o Kling na complexidade de cena e na integração nativa de áudio, mas roda mais devagar e com custo maior. O Wan 2.7 T2V é mais rápido e econômico para cenas que não exigem comportamento preciso de tecido. A escolha entre eles depende do que a sua cena específica precisa, e não de qual modelo está no topo do ranking geral.
Casos de uso reais que mais se beneficiam
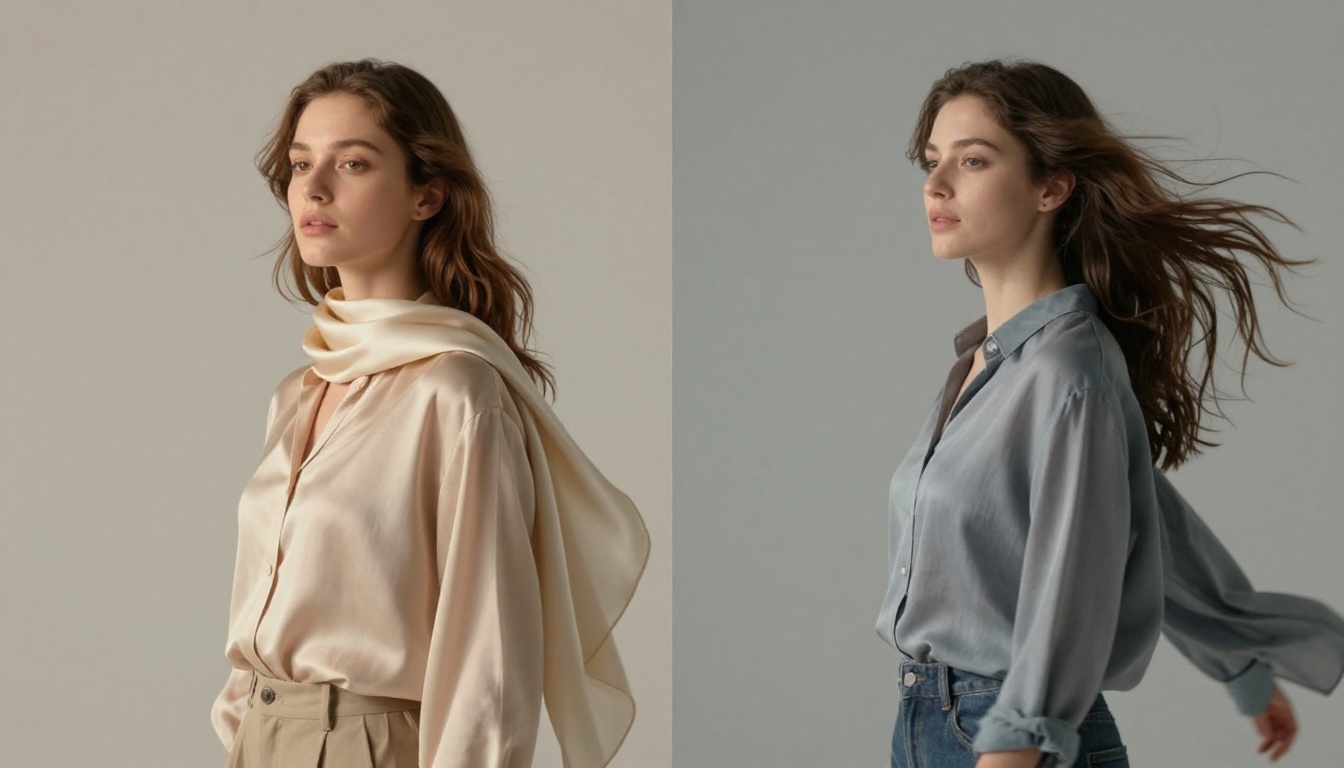
O Kling 3.0 para movimento realista não é igualmente útil para todo tipo de conteúdo. Há categorias em que suas capacidades específicas produzem resultados difíceis de alcançar de qualquer outra forma, e categorias em que um modelo mais rápido e leve entrega resultados comparáveis com menos espera.
Moda e conteúdo editorial
É aqui que a física de tecido do Kling 3.0 produz resultados genuinamente difíceis de igualar. Vestidos fluidos, blazers estruturados em movimento, lenços pegos pelo vento, calças de perna larga balançando a cada passada: tudo isso exige um modelo que entenda o comportamento do material no nível da física de cada quadro, em vez de fazer uma média estatística. O resultado pode ser usado diretamente por marcas de moda, publicações editoriais e vídeos de lookbook que precisam parecer filmados.
Animação de retratos a partir de fotografias
Se você tem uma fotografia forte e quer dar vida a ela, o Kling v3 Motion Control é uma das ferramentas mais capazes disponíveis para esse fluxo de trabalho específico. A consistência de identidade na v3 significa que o sujeito do clipe animado continua parecendo a pessoa da foto original, o que não é garantido com modelos anteriores. Uma leve virada de cabeça, um piscar lento, cabelo se movendo com uma brisa simulada: tudo isso parece uma extensão natural da imagem original, e não uma aproximação gerada dela.
Vídeos de estilo de vida e de marca
O movimento em conteúdo de estilo de vida costuma ser sutil e incidental: uma mão alcançando uma xícara de café, uma pessoa virando para sorrir para a câmera, cabelo pego por uma brisa em um terraço ensolarado. A forma como o Kling 3.0 trata o movimento secundário (aquele movimento incidental que acontece junto com a ação principal) é o que faz esses clipes parecerem documentais, e não gerados. A xícara de café não deforma. O cabelo não tremula. O sorriso não muda de identidade no meio do quadro.
Para vídeos de marca em que o sujeito é um produto em movimento, como um frasco de perfume, uma peça de roupa ou um móvel, a mesma precisão física se aplica às superfícies dos objetos e à interação com o ambiente.
4 erros que matam a qualidade do movimento
A maioria dos resultados com falha do Kling 3.0 tem causas comuns. Evitar estes quatro erros específicos economiza tempo e créditos de geração consideráveis antes de você chegar a um resultado utilizável.
-
Sobrecarregar a cena com movimentos simultâneos: pedir cinco elementos em movimento ao mesmo tempo (personagem caminhando, vento nas árvores, água correndo, câmera fazendo panorâmica, multidão no fundo) fragmenta o orçamento de física do modelo. Escolha no máximo dois ou três elementos de movimento e deixe que sejam bem executados.
-
Ignorar prompts negativos: o Kling 3.0 responde bem a orientações negativas explícitas. Incluir "sem movimento brusco, sem tremulação, sem deformação, sem rostos que se transformam" junto ao prompt principal melhora de forma mensurável a consistência da saída já na primeira geração.
-
Descrever a aparência em vez do comportamento: descrições estáticas produzem vídeo com cara de estático, mesmo quando o sujeito está tecnicamente em movimento. Verbos de movimento e linguagem causal (o que causa o movimento, e não apenas como o movimento parece) geram resultados melhores especificamente com este modelo.
-
Usar clipes de 10 segundos para cenas de movimento complexo: a consistência temporal do modelo se mantém em 5 segundos com muito mais confiabilidade do que em 10. Para cenas com movimento ativo e vários elementos, una clipes mais curtos na pós-produção em vez de forçar uma geração mais longa e torcer para que ela se sustente.
O Kling v3 cuida da geração de movimento. Outras ferramentas do PicassoIA ampliam o que você pode fazer antes e depois.
Se a sua imagem de origem precisa de nitidez antes da animação, os modelos de Super Resolution podem fazer upscaling (aumento de resolução) de uma fotografia suave ou de baixa resolução até uma qualidade adequada para animação antes que ela entre no Kling v3 Motion Control. Para clipes de retrato em que o sujeito precisa falar, o Kling Avatar v2 adiciona sincronização labial realista ao resultado animado. Camadas de áudio, incluindo narração e música de fundo, podem ser geradas pelas ferramentas Text to Speech e AI Music Generation da plataforma e adicionadas como etapa final.
O fluxo de trabalho: aumente a nitidez da imagem de origem com o Super Resolution, anime com o Kling v3, adicione sincronização labial com o Kling Avatar v2 se necessário, acrescente áudio com geração de texto para fala ou música e exporte. Cada etapa está disponível na mesma plataforma, sem trocar de ferramenta nem gerenciar conexões de API.
Comece a criar
O Kling 3.0 para movimento realista já está disponível no PicassoIA, sem exigir configuração de GPU local, configuração de API ou instalação técnica. Escolha uma fotografia, descreva o movimento que você quer ver em termos físicos específicos e gere um clipe de 5 segundos.
A diferença entre uma cena que parece "gerada por IA" e uma que parece filmagem de verdade quase sempre se resume à camada de movimento. É exatamente isso que o Kling 3.0 foi criado para produzir.
Comece com o Kling v3 Video para cenas gerais, passe para o Kling v3 Motion Control quando precisar de precisão na animação de personagens, e use o Kling v3 Omni Video para composições complexas que combinam movimento de câmera com vários sujeitos em movimento. As três versões já estão disponíveis, e os resultados falam com mais clareza do que qualquer descrição da tecnologia por trás delas.


