A distância entre uma fotografia e uma imagem gerada por IA está diminuindo num ritmo que a maioria das pessoas não esperava. Dois anos atrás, mãos com seis dedos e olhos apontando levemente para direções erradas eram os sinais mais evidentes. Hoje, os modelos mais avançados produzem imagens que resistem a uma inspeção de perto, em resolução total, em cenas complexas com vários sujeitos. Essa virada não aconteceu porque a IA ficou "mais inteligente" em algum sentido vago. Aconteceu por causa de mudanças específicas e mensuráveis em arquitetura, dados de treinamento e velocidade de inferência. Entender essas mudanças mostra exatamente para onde a geração de imagens está indo a seguir.
A revolução da resolução já aconteceu
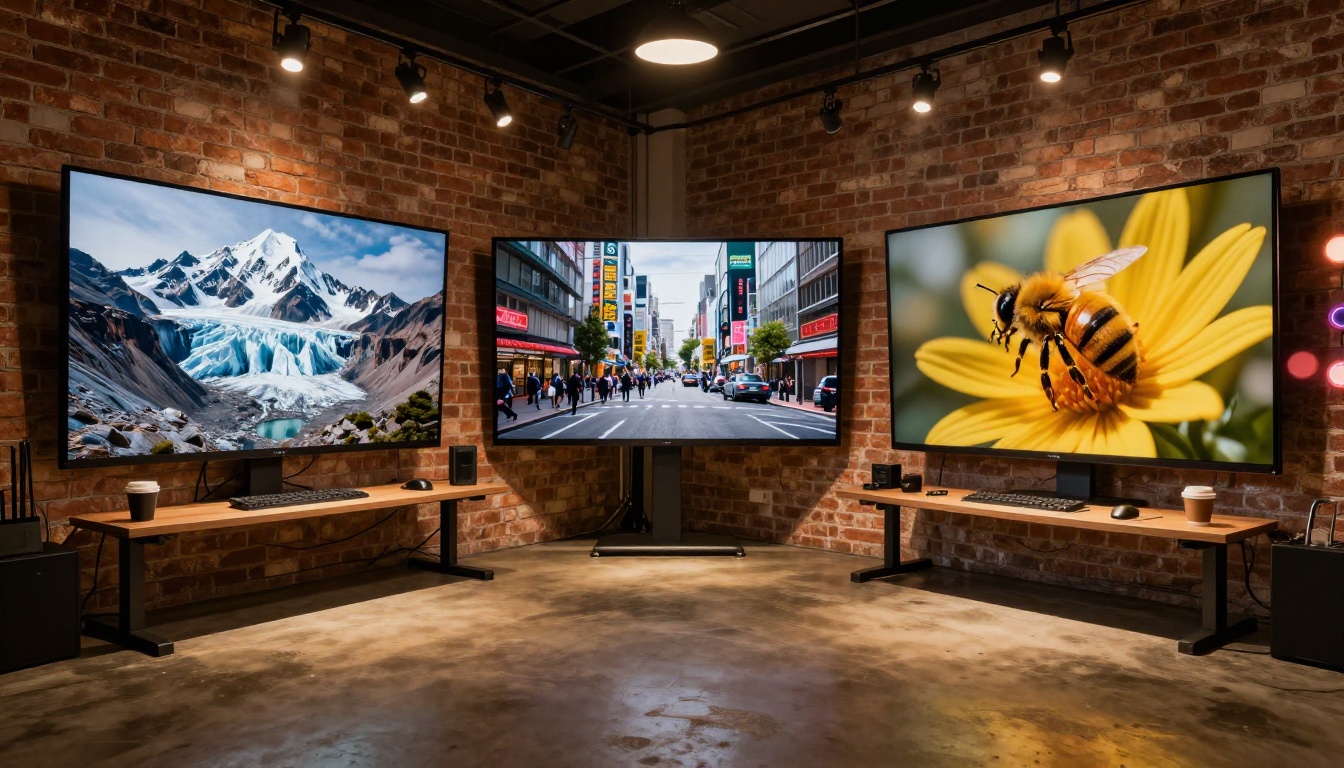
Quando os modelos de difusão apareceram publicamente, gerar uma imagem limpa de 512x512 era o padrão de referência. Qualquer coisa maior exigia truques, divisão em blocos ou upscaling pesado, que introduziam seus próprios artefatos. Esse limite já avançou muito.
Como os modelos ficaram tão nítidos tão rápido
O salto na qualidade da saída veio de três fatores acontecendo ao mesmo tempo: conjuntos de dados de treinamento maiores, com amostras selecionadas em alta resolução; melhorias de arquitetura que preservaram os detalhes espaciais durante o processo de remoção de ruído; e schedulers melhores, capazes de produzir resultados limpos em menos etapas. O resultado é que uma saída de 1 megapixel agora é a expectativa básica, e não uma conquista.
Modelos como o Flux Dev operam com 12 bilhões de parâmetros e tratam a geração de 1 megapixel como saída padrão. O que torna isso significativo não é apenas a contagem de pixels. É o fato de que detalhes finos, texturas de tecido, fios de cabelo individuais e gradientes sutis de iluminação sobrevivem ao processo de geração intactos.
O que uma saída nítida realmente significa para criadores
Nitidez já na geração significa menos pós-processamento. Quando uma imagem de IA está limpa o bastante para ser usada diretamente, o fluxo de trabalho cai de três ou quatro etapas (gerar, aumentar a resolução, retocar, exportar) para uma só. Essa redução de esforço é o que as equipes profissionais realmente levam em conta quando avaliam essas ferramentas.
💡 Dica: Ao gerar imagens para uso comercial, sempre exporte na resolução máxima e evite a tentação de reduzir o tamanho no momento do prompt. A diferença de qualidade é significativa.
Velocidade sem sacrificar a qualidade
Até pouco tempo atrás, qualidade e velocidade na geração de imagens com IA estavam em tensão direta. Imagens melhores demoravam mais. Geração mais rápida significava saída mais grosseira. Essa contrapartida praticamente desapareceu.
Por que os modelos de 4 etapas mudaram tudo
Os modelos de difusão tradicionais exigiam 50 ou mais etapas de remoção de ruído para produzir uma imagem limpa. Cada etapa somava tempo de geração. O desenvolvimento dos modelos destilados, treinados para replicar a saída de seus equivalentes mais pesados em uma fração das etapas, quebrou essa contrapartida por completo.
O Flux Schnell gera uma imagem de 1 megapixel em quatro etapas de remoção de ruído e termina em menos de cinco segundos. Para fluxos de trabalho que envolvem dezenas de iterações de prompt, a diferença entre uma geração de cinco segundos e uma de 30 segundos não é cosmética. Ela muda a forma como as pessoas realmente trabalham, permitindo uma iteração visual rápida que antes era impraticável.
| Modelo | Etapas | Velocidade | Melhor para |
|---|
| Flux Schnell | 4 | Menos de 5s | Iteração rápida, rascunhos de conceito |
| Flux Dev | 28-50 | 15-30s | Saída de alta fidelidade, trabalho de detalhe |
| Flux 1.1 Pro | Otimizado | Segundos | Prompts precisos, saídas variadas |
| Stable Diffusion | 50 | Variável | Controle personalizado, ajuste de scheduler |
A geração em tempo real já é viável
O avanço da destilação em 4 etapas desencadeou uma corrida rumo à geração em tempo real. Vários grupos de pesquisa demonstraram geração em taxas de quadros interativas sob condições controladas. Embora isso ainda não esteja disponível nas ferramentas de consumo padrão, a trajetória é clara. Os modelos que geram imagens em segundos hoje vão gerá-las em milissegundos em pouco tempo.
Para profissionais de conteúdo, essa mudança importa mais em fluxos de trabalho iterativos, em que ver os resultados instantaneamente significa manter o estado de fluxo criativo em vez de alternar de contexto enquanto espera uma renderização.
As 3 maiores mudanças que estão chegando ao texto para imagem
As melhorias em resolução e velocidade já estão aqui. A próxima onda de mudanças relevantes se concentra em três problemas específicos com os quais até os melhores modelos atuais ainda têm dificuldade.
Consistência entre várias imagens
Peça a qualquer modelo para gerar o mesmo personagem em duas poses diferentes e você receberá duas imagens que parecem pessoas diferentes. Esse é o problema da consistência, e ele continua sendo um dos desafios mais trabalhados no campo.
Várias abordagens estão convergindo para uma solução. Entradas de imagem de referência, condicionamento de pose no estilo ControlNet e métodos de adaptação como o LoRA permitem que os modelos ancorem a aparência do personagem entre as gerações. Não são perfeitos, mas são bem melhores do que o que era possível 18 meses atrás. Os modelos que estão chegando agora oferecem cada vez mais suporte nativo a esses controles.
💡 Dica: Quando você precisar de personagens consistentes em um projeto, use o travamento de seed junto com uma imagem de referência como sua fonte de verdade. O Flux Dev oferece suporte tanto ao modo img2img quanto a seeds fixas, o que o torna muito adequado para esse tipo de trabalho iterativo.
Anatomia precisa e controle espacial
Mãos, pés e disposições espaciais complexas continuam sendo o modo de falha mais visível na geração de imagens com IA. O motivo é estrutural: os modelos de difusão aprendem padrões estatísticos a partir dos dados de treinamento, em vez de entender a anatomia da forma como um ilustrador treinado entende.
O condicionamento de pose no estilo ControlNet é a principal forma de mitigação. Ao fornecer um esqueleto ou um mapa de profundidade como âncora estrutural, você limita as decisões de composição do modelo a um layout espacial definido. A qualidade da saída com controle de pose ativo é substancialmente melhor do que apenas com prompts.
A nova geração de modelos está sendo treinada com dados espaciais mais estruturados, o que deve reduzir a frequência desses erros já no modelo base, sem exigir entradas de pose para cada geração.
Renderização precisa de texto nas imagens
Texto legível dentro de imagens geradas tem sido historicamente um dos sinais mais claros de saída de IA. A maioria dos modelos embaralha letras, inventa caracteres ou produz palavras que parecem plausíveis, mas são ilegíveis.
O Ideogram v2 foi criado especificamente para resolver isso. Ele renderiza texto legível dentro de imagens, incluindo placas, rótulos e manchetes, ao ser treinado com conjuntos de dados que associam explicitamente texto em imagens a dados de referência precisos. O resultado é um modelo que pode produzir um cartaz com um título legível ou uma vitrine com as palavras corretas, sem uma etapa separada de sobreposição de texto.
Essa capacidade está se tornando cada vez mais comum entre os modelos, já que as abordagens de treinamento e de arquitetura que a viabilizaram agora são bem compreendidas e estão sendo adotadas de forma mais ampla.
Como os profissionais usam essas ferramentas hoje
A forma mais esclarecedora de ver para onde a geração de imagens com IA está indo é observar onde as equipes profissionais já a usam com seriedade, não de forma experimental.
Fluxos de trabalho de fotografia de produtos
Equipes de e-commerce foram das primeiras a adotar. O caso de uso é simples: fotografe um produto em um fundo limpo e depois use IA para colocá-lo em qualquer cenário, estação ou ambiente, sem uma sessão de estúdio. O que mudou recentemente é que a qualidade dessas composições ficou alta o bastante para passar na revisão visual em escala.
Ferramentas de inpainting permitem que as equipes troquem fundos, corrijam inconsistências de iluminação e removam objetos de fotos de produtos já existentes. O outpainting estende uma imagem composta para além do seu quadro original, para se adequar às diferentes proporções das plataformas. Essas não são capacidades conceituais que existem apenas em um artigo de pesquisa. Elas estão em uso ativo na produção de grandes marcas do varejo.
Criação de ativos para marcas e marketing
Equipes de mídias sociais estão usando a geração de imagens com IA para produzir ativos específicos para cada plataforma, em um volume que antes era impossível sem grandes departamentos criativos. Uma única descrição de produto pode se desdobrar em uma dúzia de direções visuais distintas no tempo que leva para passar um briefing a um fotógrafo.
O gargalo deslocou-se da produção de imagens para a seleção de imagens. As equipes geram cinquenta opções e curam cinco. O julgamento editorial do diretor de criação importa mais agora, e não menos, porque a restrição de produção bruta foi removida.
Modelos que vale acompanhar agora
Escolher um modelo é uma decisão prática, não filosófica. Cada modelo tem pontos fortes específicos, e combinar esses pontos com a tarefa produz resultados melhores do que escolher um único modelo para tudo.
Flux Dev: trabalho de detalhe em escala
O Flux Dev é um modelo de 12 bilhões de parâmetros criado para saídas de alta fidelidade. Ele oferece suporte tanto aos fluxos de texto para imagem quanto ao img2img, trabalha com 11 proporções e permite iterações com seed travada para resultados consistentes. Quando a tarefa exige o máximo de detalhe e o orçamento de tempo comporta gerações de 15 a 30 segundos, este é o modelo a escolher.
Seu parâmetro de guidance permite ajustar o equilíbrio entre a aderência estrita ao prompt e uma liberdade maior de composição. Valores mais altos produzem interpretações mais literais de prompts complexos. Valores mais baixos produzem resultados visualmente mais interessantes, mas menos controlados.
Flux Schnell: quando a velocidade é a restrição
O Flux Schnell produz imagens limpas de 1 megapixel em menos de cinco segundos, com quatro etapas de remoção de ruído. No PicassoIA ele funciona sem limites de créditos nem de gerações, o que significa que você pode rodar 50 variações em uma única sessão sem acompanhar o uso.
Para rascunhos de conceito, moodboards rápidos para clientes ou qualquer fluxo de trabalho que exija alto volume de iterações, o Schnell é a escolha prática. A qualidade se sustenta bem para a maioria dos usos comerciais, e a principal contrapartida é um detalhe um pouco menos refinado em comparação com o Flux Dev nas suas configurações máximas.
Flux 1.1 Pro: aderência precisa ao prompt
O Flux 1.1 Pro lê os prompts com atenção e reflete com alta precisão detalhes específicos de composição, descrições de iluminação e elementos do sujeito. Sua entrada de imagem de prompt permite orientar a composição com uma imagem de referência junto ao texto, o que é útil quando você tem uma direção visual definida a seguir.
O recurso opcional de expansão de prompt acrescenta variedade criativa quando você quer resultados além da sua formulação inicial. Ele se encaixa melhor em fluxos de produção profissionais, nos quais o controle do prompt e a previsibilidade da saída importam mais do que a velocidade bruta.
Ideogram v2: quando sua imagem precisa de palavras
O Ideogram v2 resolve o problema da renderização de texto. Cartazes, rótulos, sinalização e peças com marca que incluem texto legível não exigem mais uma etapa de edição separada. O modelo aceita um prompt simples, incluindo as palavras exatas que você quer exibidas, e as renderiza de forma legível na cena.
Sua capacidade de inpainting é precisa. Envie uma imagem com uma máscara em preto e branco, e o modelo preenche somente a área mascarada, mantendo todo o resto intacto. Predefinições de estilo, incluindo Realistic, Anime e Render 3D, permitem controlar o tom visual sem reescrever o prompt a cada vez.
Stable Diffusion: controle máximo de parâmetros
O Stable Diffusion continua sendo a opção mais controlável para quem quer ajustar cada aspecto do processo de geração. Seis opções de scheduler, suporte a prompt negativo e uma guidance scale ajustável oferecem alavancas que modelos mais opinativos não expõem.
Para quem construiu fluxos de trabalho em torno de comportamentos específicos de scheduler ou que realiza experimentos estruturados de prompt com condições repetíveis, a superfície de controle explícita do Stable Diffusion é uma vantagem real.
Como usar o Flux Dev no PicassoIA
Como o Flux Dev é um dos modelos de melhor desempenho no PicassoIA, aqui está um passo a passo direto de como obter os melhores resultados com ele.
Configuração do prompt passo a passo
Passo 1. Abra o Flux Dev no PicassoIA no seu navegador. Não é necessário criar conta nem instalar software.
Passo 2. Escreva seu prompt no campo de texto. Seja específico sobre o sujeito, a direção da luz, o ângulo da câmera e o ambiente. Prompts vagos produzem resultados vagos. Um prompt como "mulher em um parque" gera uma saída muito mais fraca do que "uma mulher de 30 e poucos anos caminhando por uma floresta de bordos salpicada de sol no começo de outubro, luz filtrada pela copa das árvores, lente de 85mm, profundidade de campo rasa".
Passo 3. Defina sua proporção. O Flux Dev oferece 11 opções, incluindo 16:9 para banners de paisagem, 9:16 para stories em redes sociais e 4:5 para posts de retrato. Combine a proporção com sua plataforma antes de gerar, e não depois.
Passo 4. Escolha seu modo. O Go Fast executa uma versão quantizada em fp8 do modelo para uma saída mais rápida. Desative-o quando for necessária a máxima fidelidade.
Passo 5. Defina as etapas de inferência entre 28 e 50. Mais etapas produzem imagens mais nítidas, ao custo de mais tempo de geração. Para a maioria dos usos, 28 etapas produzem excelentes resultados.
Passo 6. Se você quiser resultados reproduzíveis, defina uma seed fixa. Isso permite iterar sobre a redação do prompt mantendo estável o ponto de partida da composição.
Proporção e configurações de exportação
| Plataforma | Proporção recomendada | Formato |
|---|
| Cabeçalho de blog | 16:9 | JPG ou WebP |
| Post no Instagram | 4:5 | WebP |
| Cabeçalho do Twitter/X | 3:1 | JPG |
| Story ou Reel | 9:16 | WebP |
| Quadrado de produto | 1:1 | PNG |
💡 Dica: Para maquetes de produtos e imagens que precisam de bordas limpas, exporte em PNG. Para o restante, WebP com qualidade 80 oferece o melhor equilíbrio entre tamanho do arquivo e clareza visual.
Comece a criar no PicassoIA agora
A qualidade de geração de um modelo e a plataforma em que você o executa são duas coisas separadas. Até o melhor modelo produz resultados piores quando a plataforma o limita, aplica compressão na exportação ou o envolve em uma interface confusa.
O PicassoIA executa o Flux Dev, o Flux Schnell, o Flux 1.1 Pro, o Ideogram v2, o Stable Diffusion e mais de 90 modelos adicionais de texto para imagem, sem limites de créditos nem marcas d’água. Você gera, baixa um arquivo limpo e o utiliza. Não há controle de custo por imagem, nem níveis de assinatura que bloqueiem modelos específicos, nem marcas d’água nas exportações.
A plataforma também oferece aumento de resolução por super-resolução, remoção de fundo, troca de rosto, inpainting, outpainting e geração de vídeo, para que o fluxo de trabalho, da imagem inicial ao ativo final, fique em um só lugar. À medida que os modelos de imagem com IA continuam evoluindo, o PicassoIA os adiciona diretamente. A lista disponível hoje em picassoia.com/en/all-models reflete o estado atual da arte, e não um retrato de seis meses atrás.
O melhor momento para se familiarizar com essas ferramentas é agora, antes que elas se tornem uma habilidade profissional básica. Escolha um modelo, gere cem imagens e preste atenção em onde ele surpreende você. É assim que se constrói a intuição sobre o que essas ferramentas são capazes de fazer e como se posicionar para usar a próxima geração de modelos quando ela chegar.


