يشغّل معظم الناس أول أمر نصي لفيديو بالذكاء الاصطناعي، ثم يتساءلون فورًا عما حدث بشكل خاطئ. الناتج لا يشبه المقطع السينمائي الذي تخيّلوه. الشخصيات تتحرك بطريقة غير طبيعية. المشهد يغيّر الإضاءة في منتصف المقطع. كل شيء يبدو كأن أحدهم دهن شريط VHS منخفض الميزانية من عام 1993 بالفازلين. هل يبدو هذا مألوفًا؟
الأمر في الحقيقة لا علاقة له غالبًا بالأدوات نفسها. مولّدات الفيديو الحديثة مثل Seedance 2.0 وKling v3 وVeo 3 قادرة فعلًا على نتائج مذهلة. المشكلة في الغالب تكمن في الأسلوب. يرتكب الناس الأخطاء الخمسة نفسها مرارًا، ويُحبطون، ويستنتجون أن فيديو الذكاء الاصطناعي غير جاهز.
إنه جاهز. أنت فقط تستخدمه بطريقة خاطئة.
لماذا تفشل 90% من فيديوهات الذكاء الاصطناعي؟
الفجوة بين التوقع والنتيجة
عندما يجرّب الناس أدوات تحويل النص إلى فيديو للمرة الأولى، يتعاملون معها كأنها محركات بحث. يكتبون "كلب يركض في حديقة" ويتوقعون شيئًا يشبه مقطعًا من مكتبة اللقطات الجاهزة. ما يحصلون عليه بدلًا من ذلك فوضى متحولة ومتقطعة، تتحول فيها أرجل الكلب إلى عشب عند الإطار الثاني عشر.
الأدوات ليست معطلة. النموذج الذهني هو الخاطئ. توليد فيديو الذكاء الاصطناعي أقرب إلى إخراج لقطة منه إلى كتابة استعلام بحث. كلما كان إدخالك أكثر تحديدًا، كان الناتج أكثر تحكمًا.
💡 فكّر في أوامر فيديو الذكاء الاصطناعي كما يفكر المخرج في قائمة اللقطات: الشخص المحدد، والحركة المحددة، وزاوية الكاميرا المحددة، والإضاءة المحددة. الغموض يولّد الفوضى.
يشرح هذا المقال الأخطاء الخمسة المحددة التي تفصل بين فيديو الذكاء الاصطناعي الرديء والنتائج التي تبدو احترافية، وكيفية إصلاح كل خطأ بالضبط.
الخطأ الأول: أوامر نصية غامضة تُفسد جودة الحركة
كيف يبدو الأمر النصي الضعيف؟
الأمر النصي الضعيف لفيديو الذكاء الاصطناعي يصف ما هو موجود، لا ما يتحرك. عبارة "امرأة تمشي في مدينة" لا تخبر النموذج بكيفية مشيها، ولا بما تفعله الكاميرا، ولا بكيفية انتقال المشهد. على النموذج أن يخمّن. وعندما تخمّن النماذج، تهلوس.
إليك كيف يبدو الفرق عمليًا:
| الأمر النصي الضعيف | الأمر النصي القوي |
|---|
| "مدينة في الليل" | "لقطة جوية بحركة بطيئة فوق شارع وسط المدينة المبلل بالمطر عند الثانية صباحًا، ضباب يتسلل بين المباني، والكاميرا تميل من أسطح المباني إلى مستوى الشارع" |
| "رجل يطبخ" | "لقطة قريبة لأيدي الشيف وهما تضيفان الأعشاب إلى مقلاة حديد زهر، والبخار يتصاعد بحركة بطيئة، وضوء مطبخ دافئ من الأعلى، والكاميرا تتراجع ببطء لتكشف الموقد كاملًا" |
| "أمواج البحر" | "لقطة من زاوية منخفضة من خط الشاطئ، موجة كبيرة تتكسر وتندفع نحو الكاميرا بحركة بطيئة، إضاءة ذهبية من الخلف، ورغوة البحر تمتد فوق الرمال المبللة في المقدمة" |
العمود الأيمن ينتج نتائج سينمائية. العمود الأيسر ينتج ضبابية عامة.
كيف تكتب أوامر تعمل فعلًا؟
يحتاج كل أمر نصي فعّال لفيديو الذكاء الاصطناعي إلى أربعة عناصر:
- الشخص أو الشيء مع الفعل: من أو ما الذي يتحرك، وما الحركة المحددة؟
- سلوك الكاميرا: هل الكاميرا ثابتة، أم تتحرك أفقيًا، أم تقترب بالدولي، أم تصوّر من الجو، أم تُحمل باليد؟
- ظروف الإضاءة: وقت اليوم، والاتجاه، ودرجة حرارة اللون، والأجواء.
- المزاج والملمس: هل هناك حبيبات فيلم؟ حركة بطيئة؟ عمق ميداني ضحل؟
بالنسبة للنماذج التي تدعم الصوت مثل Seedance 2.0 أو Veo 3.1، يمكنك أيضًا وصف الصوت: "خطوات على رصيف مبلل، وأبواق سيارات بعيدة، وهدير خافت للمكان."
💡 اكتب الحركة أولًا، ثم الكاميرا. إذا كنت تعرف أن الشخص يركض من اليسار إلى اليمين، فاختر ما إذا كانت الكاميرا ثابتة أو تتحرك أفقيًا أو تتبع الحركة. سيدمجهما النموذج بطريقة أكثر طبيعية بكثير.
أوصاف مفيدة يمكن دمجها في الأوامر النصية: حركة سينمائية، حركة واقعية كالصور الفوتوغرافية، إضاءة طبيعية، ثبات زمني، تماسك من إطار إلى إطار، عمق ميداني ضحل، اقتراب بطيء بالدولي، تثبيت يدوي.
الخطأ الثاني: دقة خاطئة لمنصة النشر
لماذا تهم إعدادات الدقة أكثر مما تظن؟
معظم الناس لا يلمسون إعدادات الدقة أبدًا. يولّدون الفيديو بالإعداد الافتراضي للنموذج، ثم يتساءلون لماذا يبدو الفيديو مشوّشًا عند عرضه بملء الشاشة على جهاز مراقبة أو عند رفعه إلى YouTube.
لكل منصة متطلبات دقة مختلفة. تريد TikTok وInstagram Reels نسبة 9:16 بدقة 1080p. يحتاج YouTube الأفقي إلى نسبة 16:9 بدقة 1080p على الأقل، مع تفضيل 4K لأولوية الخوارزمية. تحتاج العروض التقديمية عادة إلى نسبة 16:9 بدقة 720p على الأقل. توليد الفيديو بدقة 480p ثم تمديده من أسرع الطرق لإفساد المصداقية.
طابق الدقة مع الوجهة
إليك تفصيلًا عمليًا للدقة حسب حالة الاستخدام:
| حالة الاستخدام | الحد الأدنى | الموصى به |
|---|
| YouTube أفقي | 720p | 1080p أو 4K |
| TikTok / Reels | 1080p عمودي | 1080p |
| شريحة عرض تقديمي | 720p | 1080p |
| خلفية موقع إلكتروني متكررة | 720p | 1080p |
| تسليم للعميل | 1080p | 4K |
يدعم LTX 2.3 Pro وWan 2.7 T2V كلاهما مخرجات تصل إلى 4K. ينتج Kling v3 وPixverse v5 دقة 1080p مستقرة. وللتكرار السريع بتكلفة أقل، يعمل Hailuo 02 Fast بدقة 512p بشكل جيد في مسودات الاختبار الأولية قبل الالتزام بالنسخة النهائية عالية الدقة.
💡 اصنع المسودة بدقة أقل، وأنهِ النسخة النهائية بالدقة المستهدفة. هذا يوفّر نقاط التوليد أثناء مرحلة التكرار، ويمنعك من الالتزام بتكوين ضعيف بتكلفة كاملة.
الخطأ الثالث: تجاهل الصور المرجعية تمامًا
ماذا تفعل الصور المرجعية لفيديو الذكاء الاصطناعي؟
معظم الناس يستخدمون فيديو الذكاء الاصطناعي في وضع تحويل النص إلى فيديو، ثم يتساءلون لماذا تبدو شخصياتهم مختلفة في كل مقطع. الوجه يتغيّر. الملابس تتبدّل. لوحة الألوان في الخلفية تنجرف. يُسمّى هذا عدم الاتساق الزمني، وهو العامل الأول الذي يقضي على الانغماس في المحتوى المولّد بالذكاء الاصطناعي.
الحل هو توليد تحويل الصورة إلى فيديو. بدلًا من وصف الشخص من الصفر، تزوّد النموذج بصورة موجودة كإطار أول. ثم يحرّك النموذج الصورة إلى الأمام من تلك النقطة، محافظًا على الاتساق البصري طوال المقطع.
أي النماذج تتعامل مع تحويل الصورة إلى فيديو بأفضل شكل؟
ليست كل النماذج تقبل الصور المرجعية بالقدر نفسه. إليك تفصيل لأفضل خيارات تحويل الصورة إلى فيديو المتاحة الآن:
| النموذج | نقاط القوة | الاستخدام الأمثل |
|---|
| Wan 2.7 I2V | الحفاظ القوي على الشخص أو المنتج، حركة سلسة | لقطات المنتجات، البورتريهات |
| Kling v2.6 | اتساق زمني عالٍ، مخرجات 1080p | محتوى العلامات التجارية، المشاهد |
| Seedance 2.0 | مزامنة صوت مدمجة، مخرجات سينمائية | المحتوى الاجتماعي |
| Ray 2 720p | تكرار سريع، مخرجات 720p متينة | النمذجة الأولية السريعة |
| Pixverse v5.6 | تأثيرات حركة إبداعية | المحتوى المنمّط |
سير العمل بسيط: أنشئ صورة عالية الجودة تطابق الشخصية أو المشهد أو المنتج الذي تريده، أو احصل عليها من مصدر آخر، ثم غذِّ النموذج بتلك الصورة كإطار البداية. يتحرك النموذج إلى الأمام من تلك النقطة.
💡 كلما كانت صورتك المصدرية أقوى، كان فيديوك أفضل. الصورة المرجعية الواقعية كالصور الفوتوغرافية والمضاءة جيدًا ستتفوق دائمًا على صورة ضبابية أو سيئة التكوين. وإذا لزم الأمر، شغّل صورتك المصدرية عبر أداة رفع الدقة قبل استخدامها كمرجع.
استخدام أداة PicassoIA Video المجانية للاختبار أولًا
PicassoIA Video هي أداة توليد الفيديو المجانية وغير المحدودة في المنصة، ما يجعلها مثالية لاختبار سير عمل الصورة المرجعية دون تكلفة قبل إنفاق نقاط النماذج المتقدمة. استخدمها للتحقق من تكوين الصورة وموضع الشخص قبل تشغيل الأمر النصي نفسه عبر Wan 2.7 I2V أو Kling v2.6.
الخطأ الرابع: تخطي المعالجة اللاحقة للفيديو
لماذا يحتاج الناتج الخام لفيديو الذكاء الاصطناعي إلى مرحلة نهائية؟
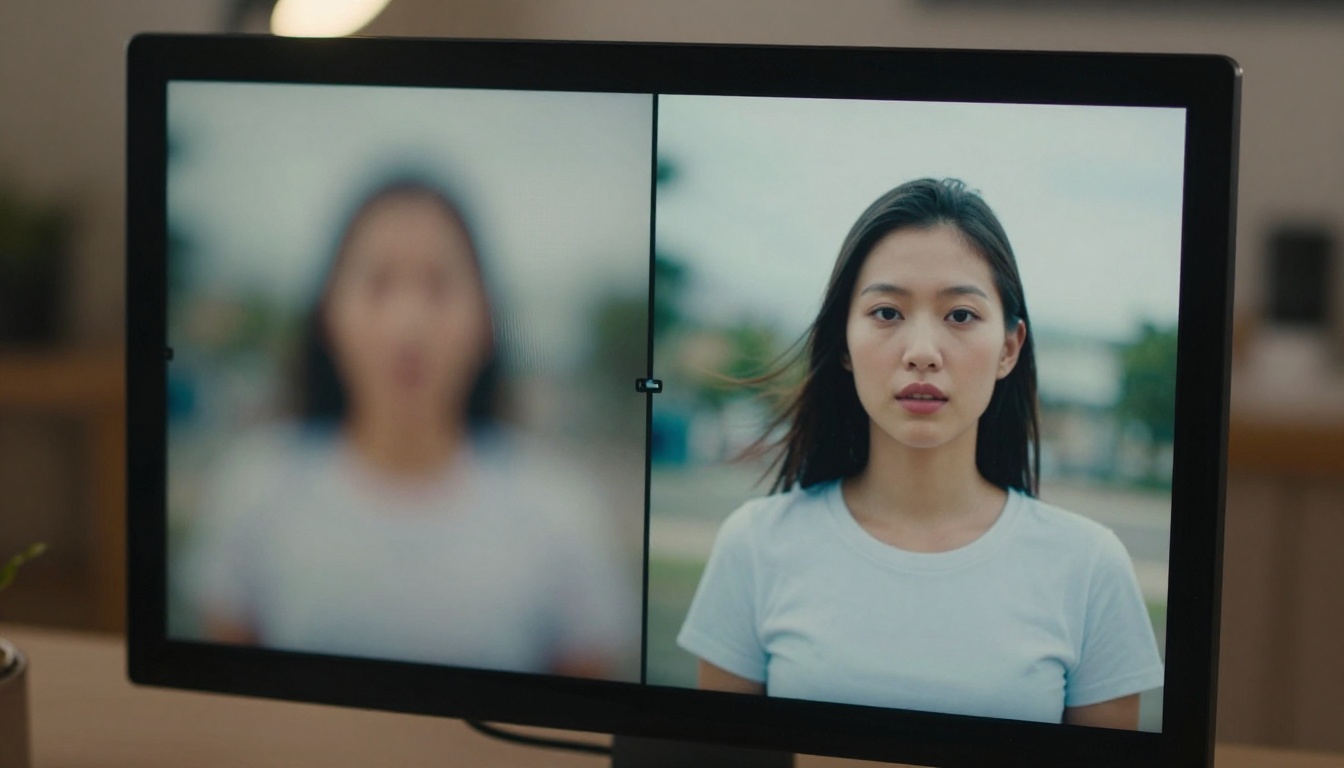
حتى الأمر النصي الممتاز لتوليد الفيديو على نموذج قوي لا ينتج دائمًا مخرجات جاهزة للنشر. فغالبًا ما تحتوي المقاطع المولّدة بالذكاء الاصطناعي على مشكلات بسيطة: نعومة طفيفة، أو تباين منخفض في المناطق المظلمة، أو وميض خفيف عند الانتقالات، أو ضبابية حركة في العناصر سريعة الحركة.
هذه ليست إخفاقات في النموذج. إنها خصائص لتقنية التوليد الحالية، وأدوات المعالجة المتخصصة مصممة لإصلاحها.
أدوات المعالجة المناسبة لفيديو الذكاء الاصطناعي
ثلاث أدوات مخصصة تستحق إدراجها في سير عملك:
Crystal Video Upscaler: يرفع دقة اللقطات إلى 4K مع الحفاظ على تفاصيل الحركة وشحذ الحواف. ممتاز لتحويل مسودة 720p إلى نسخة نهائية بدقة 4K.
Video Upscale by Topaz Labs: مدرَّبة تحديدًا على تشوهات الفيديو. تتعامل مع تقليل الضوضاء، وإزالة ضبابية الحركة، ورفع الدقة إلى 4K بمعدل يصل إلى 120 إطارًا في الثانية في مرور واحد. الأداة المفضلة للمخرجات الجاهزة للعملاء.
Upscale v1 by Runway: حل سريع ونظيف لرفع الدقة مدمج في منظومة Runway. الأفضل لتعزيز الدقة بسرعة دون تصحيح مكثف للتشوهات.
خط الإنتاج القياسي لمنشئي فيديو الذكاء الاصطناعي المحترفين يبدو هكذا:
- أنشئ مسودة بدقة 720p باستخدام نموذج سريع
- عدّل الأمر النصي بناءً على ما نجح، وأعد التوليد عند الحاجة
- التوليد النهائي بدقة 1080p مع النموذج الأنسب
- مرّر الفيديو عبر أداة رفع الدقة لتنظيف التشوهات وزيادة الحدة
- صدّر الفيديو وانشره
يقدّم هذا الأسلوب جودة قريبة من 4K من نماذج تُخرج بدقة 1080p، لأن مرحلة المعالجة تضيف نسيجًا حقيقيًا وحدةً لم يُصيّرهما النموذج التوليدي.
💡 لا تتخطَّ خطوة المعالجة أبدًا في أعمال العملاء. الفرق بين فيديو خام بدقة 1080p وآخر مرفوع الدقة ونظيف من التشوهات يظهر فورًا للمشاهدين غير التقنيين.
الخطأ الخامس: استخدام نموذج واحد لكل مهمة
لماذا يحدّ التفكير القائم على حل شامل من جودة المخرجات؟
لا يوجد نموذج واحد لفيديو الذكاء الاصطناعي يجيد كل شيء. بعض النماذج سريعة لكنها تفقد الاتساق في المقاطع الأطول. بعضها ينتج حركة بطيئة مذهلة لكنه يتعامل بضعف مع الحوار. وبعضها يُخرج 4K لكنه يعاني مع الحركة البشرية الواقعية.
صنّاع المحتوى الذين يتمسكون بنموذج واحد لكل حالة استخدام ينتهي بهم الأمر إلى تقديم تنازلات في الجودة في معظم ما ينتجونه.
ابنِ مجموعة نماذج، لا عادة نموذج
يحتفظ منشئو فيديو الذكاء الاصطناعي ذوو الخبرة بمجموعة صغيرة من نموذجين إلى أربعة نماذج، يُختار كل منها لحالات استخدام محددة. إليك إطار عمل عملي:
للمحتوى السينمائي والسردي:
يتصدّر Sora 2 وVeo 3 هذه الفئة. كلاهما يتعامل مع تكوينات المشاهد المعقدة والحركة البشرية الواقعية وتماسك المقاطع الممتدة أفضل من معظم البدائل.
للمحتوى الاجتماعي السريع:
صُمّم Seedance 2.0 وPixverse v5.6 للسرعة والمخرجات الجاهزة للمنصات. يتضمن Seedance صوتًا متزامنًا، ما يقلّل وقت ما بعد الإنتاج بشكل كبير للمحتوى الموجّه للشبكات الاجتماعية أولًا.
لفيديو المنتجات والعلامات التجارية:
Kling v3 وWan 2.7 I2V هما الخياران الأقوى للحفاظ على ثبات مظهر المنتج عبر الإطارات. ضروري للتجارة الإلكترونية والمواد الخاصة بالعلامات التجارية.
للتسليمات عالية الدقة:
LTX 2.3 Pro وGen 4.5 by Runway للعملاء الذين يحتاجون مخرجات 4K بجودة حركة سينمائية.
للنمذجة الأولية الاقتصادية:
Ray Flash 2 720p وWan 2.7 T2V بفئات الدقة الأدنى. اضبط التكوين والأوامر النصية قبل الالتزام بتشغيلات النماذج المتقدمة.
💡 يجب أن تجيب مجموعة نماذجك عن ثلاثة أسئلة: ما حالة الاستخدام؟ ما هدف الدقة؟ ما الميزانية لكل مقطع؟ اربط كل مجموعة بنموذج محدد، وستتوقف عن تقديم تنازلات في الجودة.
كيف تستخدم PicassoIA لفيديوهات ذكاء اصطناعي أفضل
خطوة بخطوة: أول فيديو ذكاء اصطناعي جاد لك
توفّر لك PicassoIA الوصول إلى أكثر من 100 نموذج لتحويل النص إلى فيديو من واجهة واحدة. إليك سير عمل قابل للتكرار يطبّق كل إصلاح من هذا المقال:
الخطوة 1: اكتب أمرًا نصيًا مفصّلًا أولًا.
قبل فتح أي أداة، اكتب أمر الفيديو في مستند منفصل. ضمّنه الشخص والحركة وحركة الكاميرا والإضاءة والأجواء. استهدف أربع إلى ست جمل وصفية على الأقل.
الخطوة 2: اختر نموذجك بناءً على حالة الاستخدام.
استخدم تفصيل مجموعة النماذج أعلاه مرجعًا لك. للعمل العام، ابدأ بنموذج Seedance 2.0 لتكامل الصوت وإعداداته السينمائية الافتراضية.
الخطوة 3: اضبط الدقة قبل التوليد.
معظم النماذج تستخدم إعدادًا متوسطًا افتراضيًا. قبل الضغط على توليد، تحقق من معامل الدقة واضبطه ليطابق منصتك المستهدفة.
الخطوة 4: ولّد مسودة، ثم كرّر.
مخرجك الأول مسودة. عدّل الأمر النصي بناءً على ما نجح وما لم ينجح. احتفظ بالعناصر المحددة التي نجحت كما هي في الأمر النصي المعدّل.
الخطوة 5: استخدم تحويل الصورة إلى فيديو للحفاظ على ثبات الشخصيات.
إذا احتجت إلى الشخصية نفسها أو المنتج نفسه عبر عدة مقاطع، فولّد صورة مرجعية قوية أولًا، ثم استخدمها كمدخل لنموذج Wan 2.7 I2V أو Kling v2.6.
الخطوة 6: شغّل مرحلة معالجة على المخرج النهائي.
مرّر مقطعك المعتمد عبر Crystal Video Upscaler أو Video Upscale by Topaz قبل النشر.
استخدام Hunyuan Video لأقصى درجات الواقعية
يستحق Hunyuan Video من Tencent ذكرًا خاصًا لصنّاع المحتوى الذين يعطون الأولوية للواقعية قبل كل شيء. توليد حركته من الأدق فيزيائيًا بين المتاح، خاصة للمشاهد التي تتضمن حركة طبيعية: الماء والقماش والشعر وميكانيكا الجسم.
ادمجه مع أمر نصي يتضمن أوصافًا فيزيائية ("شعر يلتقطه نسيم خفيف من اليمين"، "قماش قطني به تجعيدة خفيفة عند المرفق"). غالبًا ما تنجح النتائج في الفحص البصري وتبدو كلقطات حقيقية من النظرة الأولى.
توقف عن تكرار هذه الأخطاء
الأخطاء الخمسة أعلاه تفسّر الغالبية العظمى من مخرجات فيديو الذكاء الاصطناعي الرديئة:
- أوامر نصية غامضة لا تمنح النموذج شيئًا ملموسًا ليعمل عليه
- دقة خاطئة تُفسد الجودة في مرحلة التسليم
- غياب الصور المرجعية ينتج شخصيات غير متسقة ومشاهد تنجرف
- تخطي المعالجة اللاحقة يترك تحسينات الجودة الممكنة دون استغلال
- تفكير قائم على نموذج واحد يحصر كل مشروع في أضعف متوسط
لكل خطأ منها حل مباشر. اكتب أوامر نصية أكثر تحديدًا. اضبط الدقة قبل التوليد. استخدم تحويل الصورة إلى فيديو للاتساق البصري. مرّر نسخك النهائية عبر مرحلة معالجة. ابنِ مجموعة نماذج لحالات الاستخدام المختلفة.
الفجوة بين فيديو الذكاء الاصطناعي الهاوي والمخرجات الاحترافية تعود تقريبًا كليًا إلى سير العمل، لا إلى الوصول إلى أدوات أفضل. كل نموذج مذكور في هذا المقال متاح الآن على PicassoIA، إلى جانب أكثر من 100 خيار إضافي لتحويل النص إلى فيديو وتحويل الصورة إلى فيديو.
اختر خطأً واحدًا من هذه القائمة، وأصلحه في جلستك القادمة، وراقب ما يتغير في مخرجاتك. ثم تابع البقية.