La plupart des gens lancent leur premier prompt vidéo IA et se demandent aussitôt ce qui a bien pu clocher. Le résultat n’a rien à voir avec le plan cinématographique imaginé. Les personnages bougent de façon peu naturelle. La lumière change en cours de plan. Le tout ressemble à une cassette VHS bon marché de 1993 recouverte de vaseline. Ça vous rappelle quelque chose ?
Le problème vient rarement des outils eux-mêmes. Les générateurs de vidéos IA modernes comme Seedance 2.0, Kling v3 et Veo 3 sont vraiment capables de résultats impressionnants. Le souci tient presque toujours à la démarche. Les gens commettent sans cesse les mêmes cinq erreurs, se découragent et concluent que la vidéo IA n’est pas encore prête.
Elle l’est. Simplement, vous ne vous y prenez pas bien.
Pourquoi 90 % des vidéos IA déçoivent
L’écart entre l’attente et le résultat
Quand on essaie pour la première fois les outils de texte vers vidéo, on les traite comme des moteurs de recherche. On écrit « un chien qui court dans un parc » et on attend un extrait qui ressemble à une séquence de banque d’images. Ce qu’on obtient, c’est un fouillis flou et scintillant, où les pattes du chien se transforment en herbe vers la douzième image.
Les outils ne sont pas défaillants. C’est le modèle mental qui est faux. La génération de vidéos par IA se rapproche davantage de la mise en scène d’un plan que de la saisie d’une requête. Plus votre description est précise, plus le résultat est maîtrisé.
💡 Pensez vos prompts vidéo IA comme un réalisateur pense son découpage : sujet précis, mouvement précis, angle de caméra précis, lumière précise. L’ambiguïté engendre le chaos.
Cet article détaille les cinq erreurs précises qui séparent une mauvaise vidéo IA d’un résultat d’allure professionnelle, et explique comment corriger chacune d’elles.
Erreur 1 : des prompts vagues qui tuent la qualité du mouvement
À quoi ressemble un prompt faible
Un prompt vidéo IA faible décrit ce qui existe, pas ce qui bouge. « Une femme qui marche dans une ville » ne dit rien au modèle de sa façon de marcher, du mouvement de la caméra ni de la manière dont la scène passe d’un état à l’autre. Le modèle doit deviner. Et quand un modèle devine, il hallucine.
Voici la différence concrète :
| Prompt faible | Prompt efficace |
|---|
| « Une ville la nuit » | « Survol aérien en ralenti d’un centre-ville aux rues luisantes de pluie à 2 h du matin, brouillard qui dérive entre les immeubles, caméra qui bascule des toits vers le niveau de la rue » |
| « Un homme qui cuisine » | « Gros plan sur les mains d’un chef qui ajoute des herbes dans une poêle en fonte, vapeur qui s’élève au ralenti, lumière chaude de cuisine venant du dessus, caméra qui recule lentement pour révéler toute la cuisinière » |
| « Des vagues de l’océan » | « Plan en contre-plongée depuis le rivage, une grosse vague qui se forme puis s’écrase en ralenti vers la caméra, contre-jour de l’heure dorée, écume qui trace des lignes sur le sable mouillé au premier plan » |
La colonne de droite produit des résultats cinématographiques. La colonne de gauche produit un flou généralisé.
Comment écrire des prompts qui fonctionnent vraiment
Tout prompt vidéo IA efficace repose sur quatre éléments :
- Sujet et action : qui ou quoi bouge, et quel est précisément le mouvement ?
- Comportement de la caméra : la caméra est-elle fixe, en panoramique, en travelling avant, aérienne, à l’épaule ?
- Conditions de lumière : moment de la journée, direction, température de couleur, atmosphère.
- Ambiance et texture : grain de film ? Ralenti ? Faible profondeur de champ ?
Pour les modèles avec audio comme Seedance 2.0 ou Veo 3.1, vous pouvez aussi décrire le son : « des pas sur un trottoir mouillé, klaxons lointains, bourdonnement ambiant grave ».
💡 Décrivez d’abord le mouvement, puis la caméra. Si vous savez que le sujet court de gauche à droite, choisissez si la caméra est fixe, en panoramique ou en suivi. Le modèle les combinera bien plus naturellement.
Descripteurs utiles à intégrer dans vos prompts : mouvement cinématographique, mouvement photoréaliste, lumière naturelle, cohérence temporelle, cohérence d’image en image, faible profondeur de champ, travelling avant lent, caméra à l’épaule stabilisée.
Pourquoi le réglage de résolution compte plus qu’on ne le pense
La plupart des gens ne touchent jamais aux réglages de résolution. Ils génèrent avec la valeur par défaut du modèle, puis s’étonnent que leur vidéo soit pixellisée en plein écran sur un moniteur ou une fois importée sur YouTube.
Chaque plateforme a ses propres exigences. TikTok et les Reels d’Instagram attendent du 9:16 en 1080p. YouTube en horizontal demande du 16:9 en 1080p au minimum, avec une préférence pour la 4K en matière de priorité algorithmique. Les présentations exigent généralement du 16:9 en 720p minimum. Générer en 480p puis étirer l’image est l’un des moyens les plus rapides de perdre toute crédibilité.
Adaptez votre résolution à la destination
Voici un tableau pratique de résolutions par usage :
| Usage | Minimum | Recommandé |
|---|
| YouTube horizontal | 720p | 1080p ou 4K |
| TikTok / Reels | 1080p vertical | 1080p |
| Diapositive de présentation | 720p | 1080p |
| Boucle de fond de site web | 720p | 1080p |
| Livrable client | 1080p | 4K |
LTX 2.3 Pro et Wan 2.7 T2V prennent tous deux en charge une sortie allant jusqu’à la 4K. Kling v3 et Pixverse v5 offrent une sortie stable en 1080p. Pour itérer rapidement à moindre coût, Hailuo 02 Fast en 512p convient bien aux premières ébauches avant de lancer un rendu final haute résolution.
💡 Ébauchez en basse résolution, finalisez à la résolution cible. Cela économise des crédits de génération pendant la phase d’itération et vous évite de valider une mauvaise composition à plein tarif.
Erreur 3 : ignorer totalement les images de référence
Ce que les images de référence apportent à la vidéo IA
La plupart des gens utilisent la vidéo IA en mode texte vers vidéo, puis s’étonnent que leur personnage change d’un plan à l’autre. Le visage évolue, la tenue se modifie, la palette de couleurs de l’arrière-plan dérive. On appelle cela l’incohérence temporelle, et c’est le principal facteur de rupture d’immersion dans les contenus générés par IA.
La solution consiste à utiliser la génération d’image vers vidéo. Plutôt que de décrire un sujet de zéro, vous fournissez au modèle une image existante comme première image. Le modèle anime ensuite la scène à partir de ce point de départ, en conservant la cohérence visuelle tout au long du plan.
Quels modèles gèrent le mieux l’image vers vidéo
Tous les modèles n’acceptent pas les images de référence avec la même aisance. Voici un aperçu des meilleures options d’image vers vidéo disponibles aujourd’hui :
| Modèle | Points forts | Idéal pour |
|---|
| Wan 2.7 I2V | Bonne conservation du sujet, mouvement fluide | Photos de produits, portraits |
| Kling v2.6 | Forte cohérence temporelle, sortie en 1080p | Contenus de marque, scènes |
| Seedance 2.0 | Synchronisation audio intégrée, rendu cinématographique | Contenus sociaux |
| Ray 2 720p | Itération rapide, sortie 720p solide | Prototypage rapide |
| Pixverse v5.6 | Effets de mouvement créatifs | Contenus stylisés |
La démarche est simple : générez ou trouvez une image de haute qualité correspondant au personnage, à la scène ou au produit souhaité, puis transmettez cette image comme première image. Le modèle l’anime à partir de là.
💡 Plus votre image source est solide, meilleure sera votre vidéo. Une image de référence photoréaliste et bien éclairée surpassera toujours une image floue ou mal composée. Si besoin, passez votre image source par un upscaler de super-résolution avant de l’utiliser comme référence.
Utiliser l’outil gratuit PicassoIA Video pour tester d’abord
PicassoIA Video est le générateur de vidéos gratuit et illimité de la plateforme. Il est donc idéal pour tester votre flux de travail avec image de référence sans frais, avant de consommer des crédits de modèles premium. Servez-vous-en pour valider votre composition et le placement de votre sujet avant de relancer le même prompt avec Wan 2.7 I2V ou Kling v2.6.
Erreur 4 : sauter l’étape de post-traitement vidéo
Pourquoi une sortie IA brute a besoin d’une passe finale
Même un excellent prompt vidéo IA sur un modèle performant ne produit pas toujours un résultat prêt à publier. Les clips générés par l’IA présentent souvent de petits défauts : une légère douceur de l’image, un faible contraste dans les zones sombres, un léger scintillement lors des transitions ou un flou de bougé sur les sujets qui se déplacent vite.
Ce ne sont pas des échecs du modèle. Ce sont des caractéristiques de la technologie de génération actuelle, que des outils de traitement dédiés sont conçus pour corriger.
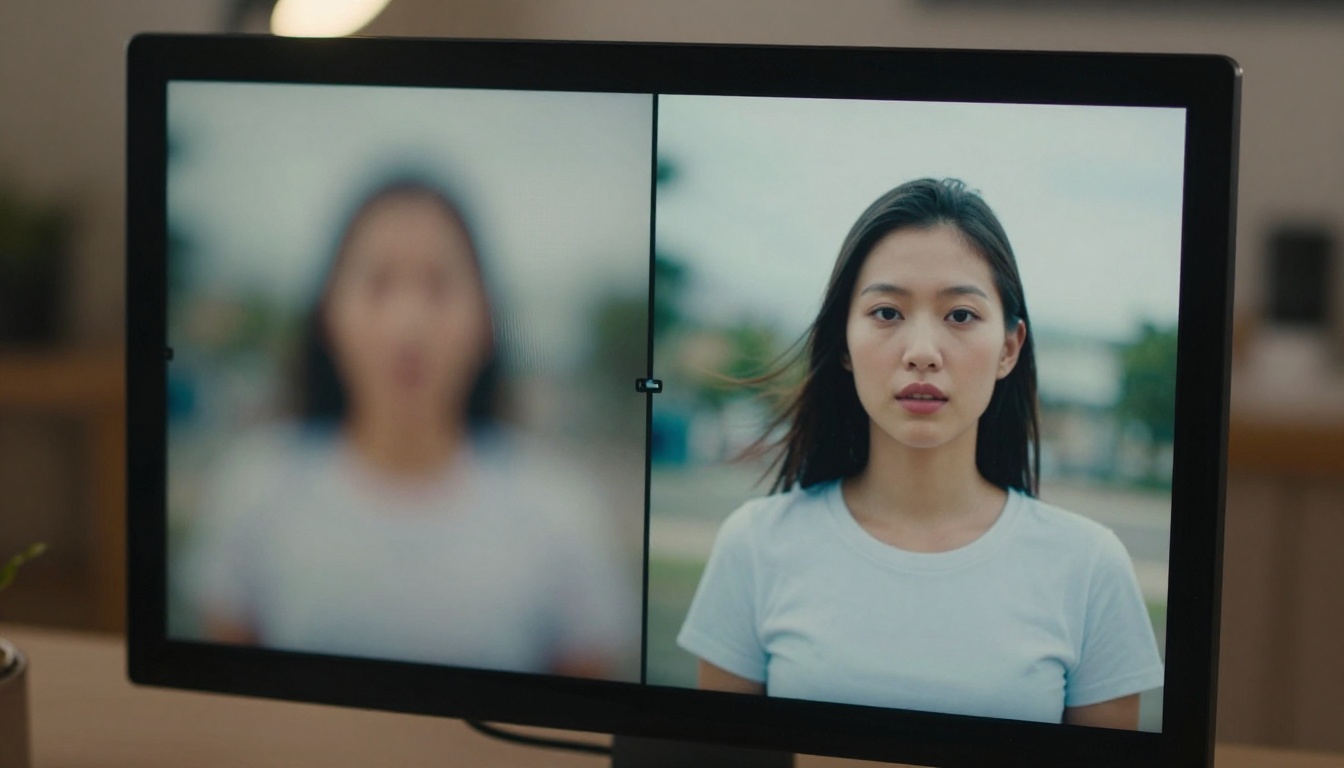
Les bons outils pour post-traiter la vidéo IA
Trois outils dédiés méritent d’être intégrés à votre flux de travail :
Crystal Video Upscaler : augmente la résolution des séquences jusqu’à la 4K tout en préservant les détails du mouvement et en accentuant les contours. Excellent pour passer d’une ébauche en 720p à un rendu final en 4K.
Video Upscale by Topaz Labs : entraîné spécifiquement sur les artefacts vidéo. Il gère la réduction du bruit, le défloutage du mouvement et l’upscaling en 4K jusqu’à 120 fps en une seule passe. L’outil de référence pour les livrables clients.
Upscale v1 by Runway : une solution d’upscaling rapide et propre, intégrée à l’écosystème Runway. Idéale pour des gains de résolution rapides, sans correction lourde des artefacts.
Le flux de production standard des créateurs professionnels de vidéo IA ressemble à ceci :
- Générer une ébauche en 720p avec un modèle rapide
- Ajuster le prompt en fonction de ce qui a fonctionné, puis régénérer si nécessaire
- Lancer le rendu final en 1080p avec le modèle le mieux adapté
- Passer dans l’upscaler pour nettoyer les artefacts et gagner en netteté
- Exporter et publier
Cette approche offre une qualité proche de la 4K à partir de modèles qui génèrent en 1080p, car l’étape de traitement ajoute de la texture et de la netteté réelles que le modèle génératif n’a pas rendues.
💡 Ne sautez jamais l’étape de traitement pour un travail client. La différence entre une vidéo IA brute en 1080p et une version upscalée, débarrassée de ses artefacts, saute aux yeux de spectateurs non techniciens.
Erreur 5 : utiliser un seul modèle pour toutes les tâches
Pourquoi la pensée « tout-en-un » limite la qualité
Il n’existe aucun modèle de vidéo IA qui excelle en tout. Certains modèles sont rapides mais perdent en cohérence sur les plans longs. D’autres produisent des ralentis somptueux mais gèrent mal les dialogues. D’autres encore sortent du 4K mais peinent avec les mouvements humains réalistes.
Les créateurs qui s’enferment dans un seul modèle pour tous leurs usages finissent par faire des compromis sur la qualité pour la plupart de leurs productions.
Construisez un ensemble de modèles, pas une habitude de modèle
Les créateurs expérimentés de vidéo IA gardent un petit ensemble de deux à quatre modèles, chacun choisi pour des usages précis. Voici un cadre pratique :
Pour les contenus cinématographiques et narratifs :
Sora 2 et Veo 3 sont en tête ici. Les deux gèrent mieux que la plupart des alternatives les compositions de scènes complexes, les mouvements humains réalistes et la cohérence des plans longs.
Pour les contenus sociaux rapides :
Seedance 2.0 et Pixverse v5.6 sont conçus pour la rapidité et des sorties prêtes pour les plateformes. Seedance intègre un audio synchronisé, ce qui réduit nettement le temps de post-production pour les contenus pensés avant tout pour les réseaux sociaux.
Pour les vidéos de produits et de marque :
Kling v3 et Wan 2.7 I2V sont les choix les plus solides pour maintenir l’apparence du produit d’une image à l’autre. Essentiel pour le e-commerce et les supports de marque.
Pour les livrables haute résolution :
LTX 2.3 Pro et Gen 4.5 by Runway pour les clients qui ont besoin d’une sortie en 4K avec une qualité de mouvement cinématographique.
Pour le prototypage économique :
Ray Flash 2 720p et Wan 2.7 T2V dans leurs paliers de résolution inférieurs. Travaillez votre composition et vos prompts avant de lancer des rendus sur les modèles premium.
💡 Votre ensemble de modèles doit répondre à trois questions : quel est l’usage ? quelle est la résolution cible ? quel est le budget par plan ? Associez chaque combinaison à un modèle précis et vous cesserez de faire des compromis sur la qualité.
Étape par étape : votre première vidéo IA sérieuse
PicassoIA vous donne accès à plus de 100 modèles de texte vers vidéo depuis une interface unique. Voici un flux de travail reproductible qui applique chacune des corrections de cet article :
Étape 1 : rédigez d’abord un prompt détaillé.
Avant d’ouvrir le moindre outil, rédigez votre prompt vidéo dans un document séparé. Incluez le sujet, l’action, le mouvement de caméra, la lumière et l’atmosphère. Visez au moins quatre à six phrases descriptives.
Étape 2 : choisissez votre modèle selon l’usage.
Servez-vous de la répartition en ensemble de modèles ci-dessus comme référence. Pour un travail polyvalent, commencez par Seedance 2.0 pour son intégration audio et ses réglages cinématographiques par défaut.
Étape 3 : réglez la résolution avant de générer.
La plupart des modèles utilisent un réglage intermédiaire par défaut. Avant de cliquer sur générer, vérifiez le paramètre de résolution et réglez-le selon votre plateforme cible.
Étape 4 : générez une ébauche, puis itérez.
Votre premier résultat est une ébauche. Ajustez le prompt selon ce qui a fonctionné et ce qui n’a pas fonctionné. Conservez mot pour mot les éléments qui ont donné de bons résultats dans la version révisée.
Étape 5 : utilisez l’image vers vidéo pour la cohérence des personnages.
Si vous avez besoin du même personnage ou du même produit sur plusieurs plans, générez d’abord une image de référence solide, puis utilisez-la comme entrée de Wan 2.7 I2V ou Kling v2.6.
Étape 6 : lancez une passe de traitement sur le rendu final.
Passez votre plan validé dans Crystal Video Upscaler ou dans Video Upscale by Topaz avant publication.
Utiliser Hunyuan Video pour un réalisme maximal
Hunyuan Video de Tencent mérite une mention particulière pour les créateurs qui privilégient avant tout le photoréalisme. Sa génération de mouvement compte parmi les plus fidèles à la physique disponibles, en particulier pour les scènes impliquant des mouvements naturels : eau, tissus, cheveux et mécanique du corps.
Associez-le à un prompt contenant des descripteurs physiques (« cheveux soulevés par une légère brise venant de la droite », « tissu en coton avec un léger pli au niveau du coude ») et les résultats passent souvent pour de vraies séquences à un premier visionnage.
Arrêtez de répéter ces erreurs
Les cinq erreurs ci-dessus expliquent la grande majorité des mauvais résultats en vidéo IA :
- Des prompts vagues qui ne donnent rien de concret au modèle sur lequel travailler
- Une mauvaise résolution qui détruit la qualité au moment de la livraison
- L’absence d’images de référence, qui entraîne des personnages incohérents et des scènes qui dérivent
- Le post-traitement oublié, qui laisse de côté des gains de qualité évitables
- La pensée mono-modèle, qui limite chaque projet à la moyenne du modèle le plus faible
Chacune a une solution directe. Rédigez des prompts plus précis. Réglez la résolution avant de générer. Utilisez l’image vers vidéo pour la cohérence visuelle. Passez vos rendus finaux dans une étape de traitement. Construisez un ensemble de modèles adapté à chaque usage.
L’écart entre une vidéo IA amateur et un résultat d’allure professionnelle tient presque entièrement au flux de travail, et non à l’accès à de meilleurs outils. Chaque modèle cité dans cet article est disponible dès maintenant sur PicassoIA, aux côtés de plus de 100 autres options de texte vers vidéo et d’image vers vidéo.
Choisissez une seule erreur de cette liste, corrigez-la lors de votre prochaine session et observez ce qui change dans vos résultats. Passez ensuite au reste.