قبل ثلاث سنوات، كان توليد نموذج ثلاثي الأبعاد واقعي المظهر يتطلب شهورًا من التدريب على Blender أو Cinema 4D أو Maya. اليوم، يكفي صورة واحدة وحوالي 30 ثانية. هذا التحول ليس تدريجيًا. إنه واحد من أهم التغييرات التي طرأت على مجال التقنية الإبداعية خلال العقد الماضي، وهو يحدث الآن.
هذا هو توليد النماذج ثلاثية الأبعاد بالذكاء الاصطناعي فعليًا، وكيف يعمل، وأين يُستخدم بالفعل، وكيف يمكنك أن تبدأ في إنتاج أصول ثلاثية الأبعاد حقيقية اليوم دون خبرة سابقة في النمذجة.
ما هي النماذج ثلاثية الأبعاد بالذكاء الاصطناعي فعليًا
النموذج ثلاثي الأبعاد هو تمثيل رياضي لجسم ثلاثي الأبعاد يُخزَّن على شكل شبكة (mesh)، أي مجموعة من الرؤوس والحواف والأوجه التي تحدد شكل الجسم. كانت النمذجة ثلاثية الأبعاد التقليدية تتطلب وضع هذه الرؤوس وتوصيلها يدويًا. أما التوليد ثلاثي الأبعاد بالذكاء الاصطناعي فيستبدل هذه العملية اليدوية بشبكات عصبونية مدرَّبة على ملايين الأشكال ثلاثية الأبعاد، ما يتيح للنظام استنتاج الهندسة الكاملة للجسم من وصف نصي أو صورة ثنائية الأبعاد.
التقنية التي تعمل في الخلفية
تعتمد معظم أنظمة توليد النماذج ثلاثية الأبعاد الحديثة على واحد من ثلاثة مناهج أساسية:
| المنهج | المدخل | المخرج | الاستخدام الأمثل |
|---|
| نماذج الانتشار (Diffusion Models) | نص أو صورة | شبكة (Mesh) / NeRF | الأجسام العامة |
| NeRF (حقول الإشعاع العصبية) | صور متعددة | مشهد حجمي | البيئات |
| Gaussian Splatting | صور أو فيديو | تمثيل بالبقع (Splat) | مسح العالم الحقيقي |
تعمل النماذج القائمة على الانتشار، مثل Hunyuan 3D 3.1، من خلال تعلّم توزيع الاحتمالات لأشكال ثلاثية الأبعاد، ثم تحويل الضوضاء تدريجيًا إلى جسم متماسك. والنتيجة شبكة أو سحابة نقاط يمكن تصديرها واستخدامها في خط إنتاج حقيقي.
لماذا تكون النماذج ثلاثية الأبعاد أصعب من ثنائية الأبعاد بالنسبة للذكاء الاصطناعي
توليد صورة ثنائية الأبعاد يعني التنبؤ بقيم ألوان البكسلات عبر شبكة مسطحة. أما توليد نموذج ثلاثي الأبعاد فيعني التنبؤ بهندسة تكون متسقة من كل زاوية. وهذه مشكلة أصعب بشكل جوهري. يجب أن يأخذ النموذج في الحسبان العمق والحجب والمتجهات العمودية على السطح والطوبولوجيا، دون أن يرى أبدًا الجانب الخلفي أو السفلي للجسم المُصوَّر. ومجرد أن أنظمة الذكاء الاصطناعي الحالية تنجز ذلك بموثوقية هو إنجاز هندسي لافت.
كيف يحوّل الذكاء الاصطناعي النص والصور إلى نماذج ثلاثية الأبعاد
هناك ثلاثة مسارات رئيسية للإدخال في توليد النماذج ثلاثية الأبعاد بالذكاء الاصطناعي: النص، والصورة، والعروض المتعددة. ولكل منها نقاط قوة مختلفة بحسب ما تريد بناءه.
التحويل من النص إلى ثلاثي الأبعاد: وصف الهندسة بالكلمات
تأخذ نماذج التحويل من النص إلى ثلاثي الأبعاد وصفًا بلغة طبيعية وتولّد منه شبكة ثلاثية الأبعاد كاملة. يربط الذكاء الاصطناعي المعنى الدلالي بالهندسة المكانية، معتمدًا على ما تعلّمه لتقدير شكل الجسم الموصوف من كل زاوية. تزداد النتائج نظافة وجاهزية للتصدير، لكن الأشكال المعقدة ذات التفاصيل الدقيقة ما زالت تستفيد من التحسين اليدوي.
💡 نصيحة: الأوامر الأكثر تحديدًا تنتج هندسة أفضل. فالوصف "كوب قهوة من السيراميك الأبيض، أسطواني، بارتفاع 10 سم، مع مقبض حلقي" يتفوق على "كوب" بفارق كبير. صِف المادة والمقاس والشكل بوضوح.
التحويل من الصورة إلى ثلاثي الأبعاد: صورة واحدة، جسم كامل
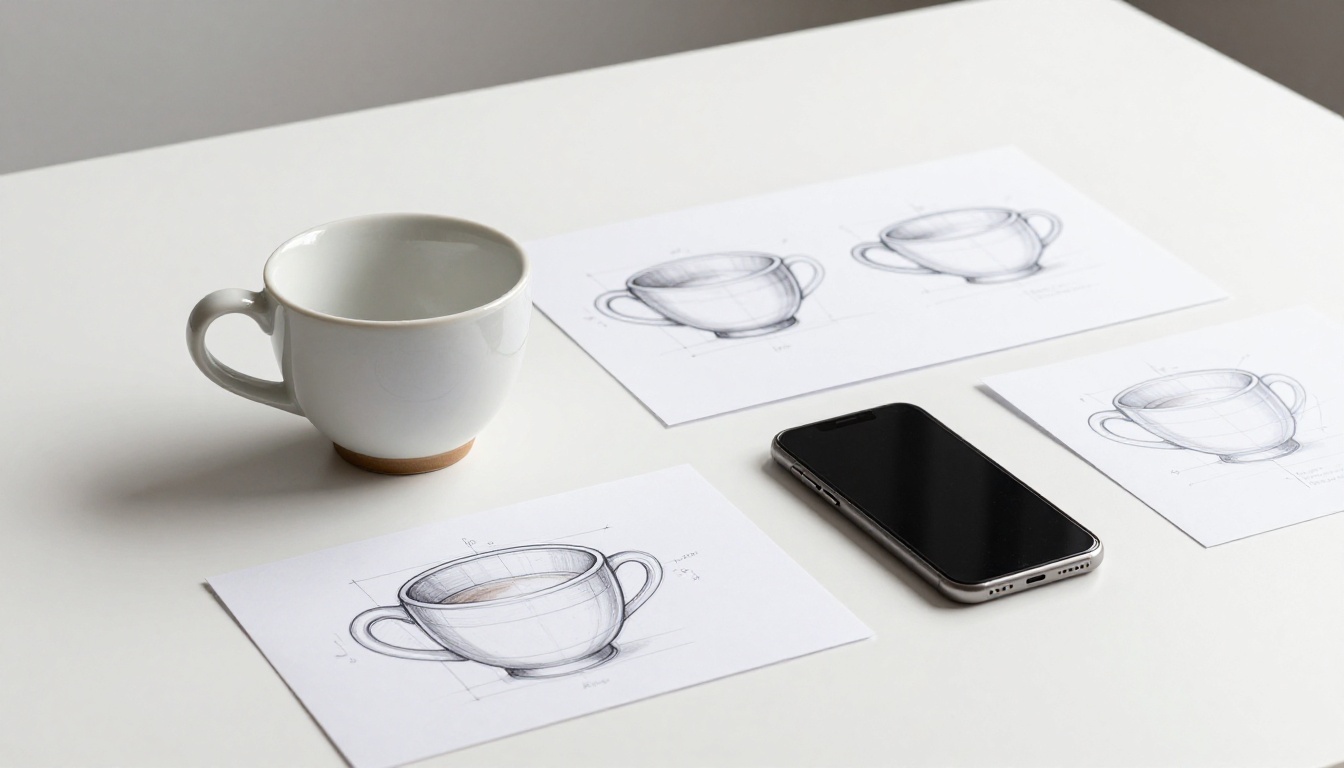
التحويل من الصورة إلى ثلاثي الأبعاد هو حاليًا أكثر أساليب سير العمل عملية لصنّاع المنتجات والمصممين. تقدّم صورة فوتوغرافية واحدة، فيستنتج الذكاء الاصطناعي شكل الجانب الخلفي والجوانب والسطح السفلي استنادًا إلى الشكل والإضاءة والإشارات المتعلقة بالمادة. يُعد Rodin من Hyper3D مثالًا قويًا، إذ يولّد شبكات جاهزة للألعاب من صور المنتجات بتفاصيل سطحية مبهرة. أما Hunyuan 3D 3.1 من Tencent فيذهب أبعد من ذلك، إذ يقدّم نماذج مفصّلة مع تعيين UV سليم انطلاقًا من صورة إدخال واحدة نظيفة.
ما الذي يجعل صورة الإدخال جيدة:
- خلفية نظيفة، ويُفضَّل الأبيض أو الرمادي المحايد
- الجسم في المنتصف دون اقتطاع عند الحواف
- إضاءة منتشرة ومتساوية دون ظلال اتجاهية قوية
- التصوير من زاوية مرتفعة بين 30 و45 درجة
التوليد من العروض المتعددة والفيديو
الطريقة الأكثر دقة تستخدم صورًا متعددة للجسم نفسه مأخوذة من زوايا مختلفة. يعيد الذكاء الاصطناعي بناء الهندسة الكاملة عبر مقارنة كل منظور بالآخر، على غرار ما كان يفعله القياس الضوئي (photogrammetry) قبل الشبكات العصبونية. وتكون المخرجات عادةً شبكات أعلى دقة وبأخطاء طوبولوجية أقل من طرق الصورة الواحدة. كما تُستخدم مقاطع فيديو قصيرة لجسم يدور بهذه الطريقة، إذ تمنح النموذج عشرات المنظورات الضمنية ليعمل منها.
5 مجالات يعمل فيها الذكاء الاصطناعي ثلاثي الأبعاد بالفعل
توليد الذكاء الاصطناعي ثلاثي الأبعاد ليس فكرة تُختبر في مختبرات البحث. إنه قيد الاستخدام الفعلي في عدة صناعات الآن.
تطوير الألعاب المستقلة
بالنسبة للمطورين المنفردين والاستوديوهات الصغيرة، كان إنشاء الأصول ثلاثية الأبعاد دائمًا عنق الزجاجة. فتوظيف فنان ثلاثي الأبعاد لكل قطعة ديكور وكل عنصر بيئي وكل شخصية غير لاعبة مكلف وبطيء. تنتج الأصول المولّدة بالذكاء الاصطناعي من أدوات مثل Rodin عناصر ديكور منخفضة الأوجه جاهزة للألعاب خلال دقائق، سواء كأصول نهائية أو كشبكات أساسية يعمل عليها فنان متعدد المهارات لتحسينها.
عرض المنتجات في التجارة الإلكترونية
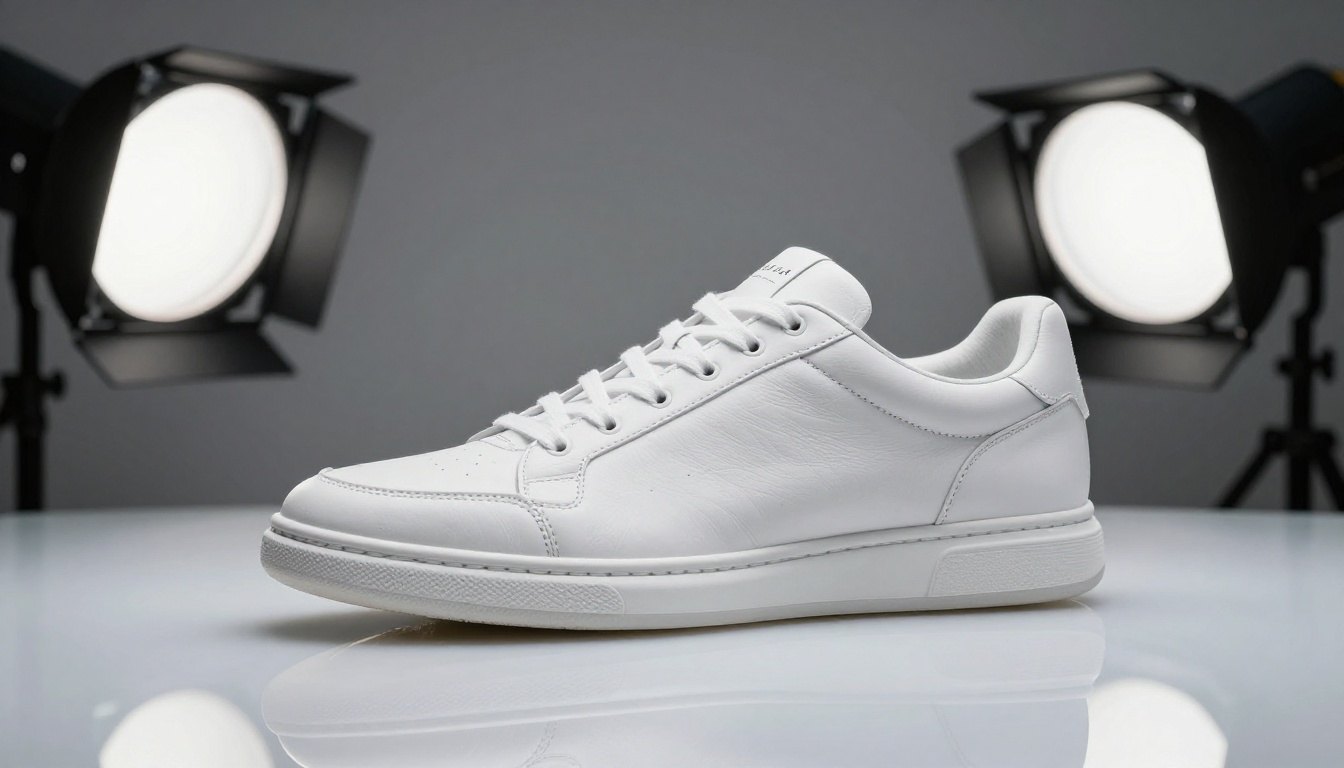
تريد العلامات التجارية الإلكترونية نماذج ثلاثية الأبعاد لكل منتج من أجل تجربة الارتداء بالواقع المعزَّز، وعارضات 360 درجة، وأدوات التخصيص. تقليديًا، كان نموذج ثلاثي الأبعاد لمنتج واحد يكلّف بين 150 و500 دولار عند طلبه من مختص. يخفض التوليد بالذكاء الاصطناعي من صورة فوتوغرافية هذه التكلفة إلى ما يقارب الصفر، بجودة مقبولة بالفعل لمعظم التطبيقات التجارية.
التصوير المسبق للأفلام والرسوم المتحركة
يستخدم المخرجون ورسامو الألواح القصصية التصوير المسبق ثلاثي الأبعاد لتخطيط زوايا الكاميرا وتحديد مواقع الممثلين وحركتهم قبل أن يبدأ التصوير الرئيسي المكلف. والبيئات والشخصيات ثلاثية الأبعاد الأولية المولّدة بالذكاء الاصطناعي سريعة بما يكفي للتكرار عليها في الوقت الفعلي، لتحل محل العملية اليدوية التي كانت تُنجز تقليديًا داخل Maya أو SketchUp.
العمارة والعقارات
يستخدم المعماريون خطوط إنتاج التحويل من الصورة إلى ثلاثي الأبعاد لتوليد نماذج كتلية أولية من صور الرسوم الأولية أو صور الموقع المرجعية. وتستخدم منصات العقارات توليد النماذج ثلاثية الأبعاد بالذكاء الاصطناعي لإنشاء جولات افتراضية انطلاقًا من بيانات المخطط الأساسية وصور الغرف، ما يقلل بشكل ملحوظ تكلفة التجهيز ثلاثي الأبعاد.
تجارب التواصل الاجتماعي والواقع المعزَّز
تحتاج مرشحات الواقع المعزَّز وتطبيقات تجربة الارتداء الافتراضية ومنصات الصور الرمزية إلى محتوى ثلاثي الأبعاد باستمرار وبحجم كبير. ويغذي توليد الذكاء الاصطناعي هذه الخطوط بحجم لا يستطيع أي فريق من النمذجين مضاهاته يدويًا، كما أن سرعة التكرار تجعله مجديًا للمحتوى الموسمي أو الخاص بالحملات، الذي كان سيكون مكلفًا أكثر من اللازم لولا ذلك.
استخدام Hunyuan 3D 3.1 على PicassoIA
تتوفر Hunyuan 3D 3.1 مباشرةً على PicassoIA، ما يجعلها من أسهل خطوط التحويل من الصورة إلى ثلاثي الأبعاد توفرًا اليوم. إليك طريقة استخدامها بفعالية من البداية.
سير العمل خطوة بخطوة
الخطوة 1: جهّز صورة الإدخال
استخدم صورة نظيفة وجيدة الإضاءة للجسم الذي تريد تحويله. أزل الخلفية أولًا إن أمكن. ضع الجسم في منتصف الإطار دون اقتطاع عند أي حافة.
الخطوة 2: ارفع الصورة واضبط الإعدادات
انتقل إلى Hunyuan 3D 3.1 على PicassoIA. ارفع صورتك المرجعية. اضبط كثافة الشبكة الناتجة بحسب الاستخدام المقصود: عدد أوجه أقل للتطبيقات الفورية، وأعلى للتصيير الثابت أو الطباعة.
الخطوة 3: وَلِّد وراجع
يعمل النموذج ويُعيد شبكة ثلاثية الأبعاد عادةً خلال 30 إلى 60 ثانية. استخدم العارض المدمج لفحص النتيجة من جميع الزوايا قبل التنزيل.
الخطوة 4: صدِّر واستخدم
نزّل الناتج بالصيغة التي تفضّلها. صيغ OBJ وGLB وGLTF هي الأكثر شيوعًا. استورده إلى Blender أو Unreal Engine أو Unity أو برنامج ثلاثي الأبعاد تفضّله للاستخدام النهائي وأي تنظيف ضروري.
نصائح لنتائج أفضل
- للمنتجات: تعطي لقطة البطل من زاوية مرتفعة بمقدار 45 درجة نتائج أفضل من المناظر الأمامية المسطحة، التي تمنح الذكاء الاصطناعي معلومات عمق أقل للعمل عليها.
- للشخصيات: صورة مرجعية بوضعية T أو A المحايدة تنتج طوبولوجيا أنظف من وضعية حركية ديناميكية.
- للأجسام ذات الصور الظلية المعقدة: شغّل الصورة نفسها مرتين. تحمل النماذج التوليدية عشوائية متأصلة، وغالبًا ما تُصلح المحاولة الثانية العيوب التي ظهرت في الأولى.
💡 نصيحة متقدمة: صوّر صورتك المرجعية أمام خلفية بسيطة، واستخدم أداة إزالة الخلفية في PicassoIA قبل الرفع. صور الإدخال الأنظف تنتج مخرجات ثلاثية الأبعاد أنظف بشكل ملحوظ.
تحريك النماذج ثلاثية الأبعاد دون خبرة في الربط الهيكلي
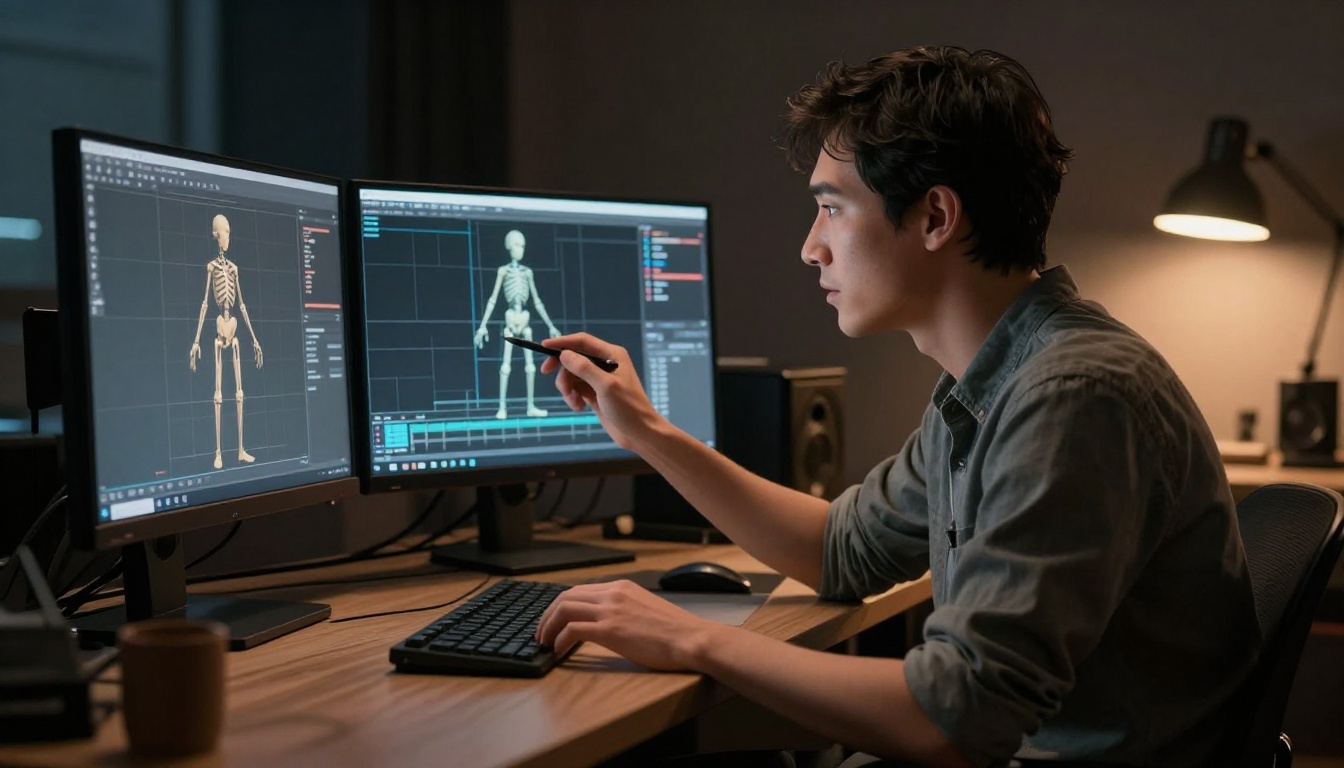
الحصول على نموذج ثلاثي الأبعاد ليس سوى الخطوة الأولى. والتحريك هو تقليديًا المهارة الأصعب في الاكتساب. والذكاء الاصطناعي يزيل هذا الحاجز في كل مرحلة من خط الإنتاج.
ما الذي تفعله Text To Motion Diffusion v2
تولّد Text To Motion Diffusion v2 من Uthana بيانات حركة من أوامر نصية. صِف حركة بلغة طبيعية، فيعيد النموذج بيانات حركة يمكن تطبيقها على أي هيكل ثلاثي الأبعاد متوافق. يلغي ذلك الحاجة إلى معدات التقاط الحركة أو مهارات التحريك بالإطارات المفتاحية تمامًا، بالنسبة للحركات البسيطة إلى متوسطة التعقيد.
تستخدم Text To Motion VQVAE v1 بنية Vector Quantized Variational Autoencoder التي تنتج نتائج أنعم لحلقات التكرار، ما يجعلها مناسبة بشكل خاص للرسوم المتحركة في وضع الخمول، ودورات المشي، والحركات المتكررة الأخرى المستخدمة في الألعاب والتطبيقات الفورية.
الربط الهيكلي التلقائي باستخدام Create Character v1
قبل تطبيق بيانات الحركة، تحتاج شبكة الشخصية إلى هيكل عظمي: ربط (rig). الربط يدويًا عملية تستغرق ساعات عدة وتتطلب معرفة تقنية عميقة بوضع العظام، ورسم الأوزان، وضبط سلسلة الحركة العكسية (inverse kinematics). يؤتمت Create Character v1 ذلك بالكامل. أدخل شبكة شخصية فيعيد لك شخصية مربوطة بالكامل وجاهزة للتحريك.
يمثل الجمع بين Hunyuan 3D 3.1 لتوليد النموذج، وCreate Character v1 للربط، وText To Motion Diffusion v2 للتحريك، خط إنتاج كاملًا من الصفر إلى شخصية متحركة، دون الحاجة إلى مهارات ثلاثية الأبعاد تقليدية في أي مرحلة.
الحدود الصادقة للذكاء الاصطناعي ثلاثي الأبعاد اليوم
توليد الذكاء الاصطناعي ثلاثي الأبعاد قوي، لكن له قيودًا حقيقية تستحق المعرفة قبل أن تعتمد عليه في خط إنتاج.
ما يزال يحتاج إلى عنصر بشري:
- طوبولوجيا معقدة حول المفاصل: غالبًا ما تحتوي الشبكات المولّدة بالذكاء الاصطناعي على توزيع غير منتظم للمضلعات عند المرفقين والركبتين ومفاصل الأصابع. وتحتاج المناطق الوجهية، خاصة حول الفم والعينين، غالبًا إلى تنظيف يدوي قبل أن تعمل الرسوم المتحركة العضوية بشكل صحيح.
- الهندسة الداخلية: لا يستطيع الذكاء الاصطناعي استنتاج شكل داخل جسم أجوف. فداخل الزجاجة أو الغرفة أو الحذاء يُخمَّن بشكل أساسي أو يبقى ناقصًا.
- الأجزاء الميكانيكية الدقيقة: تتطلب التروس والمثبتات الملولبة والتجميعات الدقيقة نمذجة نظيفة بأسلوب CAD، وهو ما لا تنتجه أدوات الانتشار بموثوقية.
- تكسية متسقة على نطاق واسع: قد تتكرر المواد بشكل سيئ أو تنكسر على الهندسات غير المعتادة، ما يستدعي مرحلة رسم للتكسية.
حقائق صيغ الملفات:
| الصيغة | الاستخدام الأمثل | الحجم |
|---|
| OBJ | الاستيراد والتصدير الشامل | متوسط |
| GLB / GLTF | الويب والواقع المعزَّز والمحركات الفورية | مضغوط |
| FBX | محركات الألعاب مع الرسوم المتحركة | كبير |
| STL | سير عمل الطباعة ثلاثية الأبعاد | متوسط |
تُصدِر أدوات الذكاء الاصطناعي عادةً ملفات OBJ أو GLB. وإذا كان خط إنتاجك يتطلب FBX، فستحتاج إلى خطوة تحويل. ويتولى Blender هذا التحويل مجانًا ودون فقدان في الجودة.
إلى أين يتجه توليد الذكاء الاصطناعي ثلاثي الأبعاد
يحوّل الجيل الحالي من الأدوات الصورة الواحدة إلى شبكة ثابتة. وما هو قادم أسرع وأكثر قدرة، ومدمج بشكل متزايد في سير العمل الفوري.
التوليد ثلاثي الأبعاد في الوقت الفعلي
تُظهر النماذج الأولية البحثية توليد شبكة كاملة مع التكسيات وخرائط UV خلال أقل من 10 ثوانٍ. وخلال 12 إلى 24 شهرًا قادمة، سيصبح التوليد ثلاثي الأبعاد في الوقت الفعلي مجديًا في سياقات الإنتاج. أي أنك ستكتب أمرًا نصيًا وترى جسمًا ثلاثي الأبعاد قابلًا للتحرير يظهر في مشهدك فورًا، دون انتظار للمعالجة.
Gaussian Splatting والذكاء الاصطناعي الحجمي
يمثّل Gaussian splatting المشاهد ثلاثية الأبعاد كمجموعات من دوال غاوسية موجَّهة، بدلًا من شبكات المضلعات. ينتج هذا الأسلوب تصييرات واقعية كالصور الفوتوغرافية بشكل لافت، وهو مستخدم بالفعل في خطوط المؤثرات البصرية لدى عدة استوديوهات كبرى. وتبدأ أنظمة الذكاء الاصطناعي في توليد تمثيلات Gaussian splat مباشرةً، ما سيغيّر طريقة إنشاء المحتوى ثلاثي الأبعاد وتجربته في الواقع الافتراضي وبيئات الواقع المعزَّز الغامرة.
التحرير الدلالي ثلاثي الأبعاد
القدرة التالية بعد التوليد هي التحرير باللغة الطبيعية. تتيح لك الأنظمة المبكرة بالفعل وصف تغيير في المادة أو الشكل، فيحدّث النموذج الهندسة ثلاثية الأبعاد وخصائص السطح وفقًا لذلك. وهذا يغلق الحلقة بين النية الإبداعية والتنفيذ التقني، ويلغي الحاجة إلى النمذجة اليدوية في مرحلة المراجعة.
💡 ترقّب: تلاقي انتشار الفيديو وتوليد ثلاثي الأبعاد. فنماذج الفيديو تبني بالفعل فهمًا متماسكًا عبر الإطارات، وهو ما يكافئ هندسيًا الفهم ثلاثي الأبعاد متعدد المنظورات. ومن المرجح أن تنبثق أهم الاختراقات القادمة في الذكاء الاصطناعي ثلاثي الأبعاد من هذا التقاطع.
جرّبه بنفسك
الحاجز الفاصل بين الرغبة في نموذج ثلاثي الأبعاد وامتلاكه انهار فعليًا. لا تحتاج إلى سنوات من التدرب على Blender. ولا تحتاج إلى معدات التقاط الحركة. ولا تحتاج إلى فنان ثلاثي الأبعاد متفرغ.
تتوفر على PicassoIA كل من Hunyuan 3D 3.1 وRodin وCreate Character v1 وText To Motion Diffusion v2 وText To Motion VQVAE v1 على منصة واحدة. وهذا خط إنتاج ثلاثي الأبعاد كامل يعمل بالذكاء الاصطناعي: من صورة المفهوم إلى شخصية متحركة ومربوطة وجاهزة للتصدير.
التقط صورة لشيء على مكتبك. ارفعها. وانظر إلى النتيجة. تلك اللحظة التي تشاهد فيها صورة فوتوغرافية تتحول إلى نموذج ثلاثي الأبعاد في أقل من دقيقة تساوي أكثر من أي شرح. الأدوات موجودة. ابدأ الآن.


