Hace tres años, generar un modelo 3D fotorrealista exigía meses de práctica en Blender, Cinema 4D o Maya. Hoy basta una sola foto y unos 30 segundos. Ese cambio no es gradual. Es uno de los cambios más importantes que ha vivido el ámbito de la tecnología creativa en la última década, y está ocurriendo ahora mismo.
Esto es lo que realmente es la generación de modelos 3D con IA, cómo funciona, dónde ya se usa y cómo puedes empezar a producir recursos 3D reales hoy mismo, sin experiencia previa en modelado.
Qué son realmente los modelos 3D con IA
Un modelo 3D es una representación matemática de un objeto tridimensional almacenada como una malla, un conjunto de vértices, aristas y caras que definen la forma del objeto. El modelado 3D tradicional exigía colocar y conectar esos vértices a mano. La generación 3D con IA sustituye ese proceso manual por redes neuronales entrenadas con millones de formas 3D, lo que permite al sistema inferir la geometría completa de un objeto a partir de una descripción de texto o de una imagen 2D.
La tecnología que hay debajo
La mayor parte de la generación 3D con IA actual usa uno de tres enfoques principales:
| Enfoque | Entrada | Salida | Mejor para |
|---|
| Modelos de difusión | Texto o imagen | Malla / NeRF | Objetos generales |
| NeRF (Neural Radiance Fields) | Varias imágenes | Escena volumétrica | Entornos |
| Gaussian Splatting | Fotos o video | Representación de splats | Escaneo del mundo real |
Los modelos basados en difusión, como Hunyuan 3D 3.1, funcionan aprendiendo la distribución de probabilidad de las formas 3D y refinando de forma iterativa el ruido hasta convertirlo en un objeto coherente. El resultado es una malla o una nube de puntos que puede exportarse y usarse en un flujo de producción real.
Por qué el 3D es más difícil que el 2D para la IA
Generar una imagen 2D significa predecir valores de color de píxeles en una cuadrícula plana. Generar un modelo 3D significa predecir una geometría que sea coherente desde cada ángulo. Es un problema fundamentalmente más difícil. El modelo tiene que tener en cuenta la profundidad, las oclusiones, las normales de superficie y la topología sin haber visto nunca la parte trasera ni la base del objeto fotografiado. Que los sistemas de IA actuales lo consigan de forma fiable ya es, por sí solo, una ingeniería notable.
Cómo convierte la IA el texto y las fotos en 3D
Hay tres vías principales de entrada para la generación 3D con IA: texto, imagen y multivista. Cada una tiene puntos fuertes distintos según lo que quieras construir.
Texto a 3D: describir la geometría con palabras
Los modelos de texto a 3D toman una descripción en lenguaje natural y generan una malla 3D completa. La IA asocia el significado semántico con la geometría espacial y se apoya en su entrenamiento para estimar cómo se ve el objeto descrito desde todos los ángulos. Los resultados son cada vez más limpios y listos para exportar, aunque las formas complejas con mucho detalle todavía necesitan un retoque manual.
💡 Consejo: Los prompts más específicos producen mejor geometría. "Una taza de cerámica blanca, cilíndrica, de 10 cm de alto, con asa en forma de bucle" supera con mucha diferencia a "una taza". Describe el material, la escala y la forma de manera explícita.
Imagen a 3D: una foto, un objeto completo
La conversión de imagen a 3D es hoy el flujo de trabajo más práctico para creadores de productos y diseñadores. Proporcionas una sola fotografía y la IA infiere cómo son la parte trasera, los laterales y la base según la forma, la iluminación y las pistas de material. Rodin, de Hyper3D, es un buen ejemplo: genera mallas listas para videojuegos a partir de fotos de productos, con un detalle de superficie impresionante. Hunyuan 3D 3.1, de Tencent, va más allá y entrega modelos detallados con mapeado UV correcto a partir de una única imagen limpia.
Qué hace buena una foto de entrada:
- Fondo limpio, preferiblemente blanco o gris neutro
- Objeto centrado y sin recortes en los bordes
- Iluminación difusa y uniforme, sin sombras direccionales fuertes
- Tomada desde un ángulo elevado de 30 a 45 grados
Generación multivista y basada en video
El método más preciso usa varias fotos del mismo objeto tomadas desde distintos ángulos. La IA reconstruye la geometría completa cruzando la información de cada vista, de forma parecida a como funcionaba la fotogrametría antes de las redes neuronales. Los resultados suelen ser mallas de mayor fidelidad y con menos errores de topología que los métodos de una sola imagen. También se usan así los videos cortos de un objeto girando, que proporcionan al modelo decenas de puntos de vista implícitos con los que trabajar.
5 ámbitos en los que el 3D con IA ya funciona
La generación 3D con IA no es un concepto que se esté probando en laboratorios de investigación. Hoy está en producción activa en varios sectores.
Desarrollo de videojuegos independientes
Para los desarrolladores en solitario y los estudios pequeños, la creación de recursos 3D siempre ha sido el cuello de botella. Contratar a un artista 3D para cada objeto, cada pieza de entorno y cada personaje no jugador es caro y lento. Los recursos generados con IA de herramientas como Rodin producen en minutos objetos de bajo polígono listos para el juego, ya sea como recursos finales o como mallas base que un artista generalista refina y optimiza.
Visualización de productos para comercio electrónico
Las marcas de comercio electrónico quieren modelos 3D de cada producto para probadores de realidad aumentada, visores de 360 grados y configuradores. Tradicionalmente, encargar un modelo 3D de un solo producto cuesta entre 150 y 500 $. La generación con IA a partir de una fotografía reduce ese costo casi a cero, con una calidad que ya es aceptable para la mayoría de aplicaciones comerciales.
Previsualización para cine y animación
Los directores y los artistas de storyboard usan la previsualización 3D para planificar los ángulos de cámara y la colocación de los actores antes de que empiece el rodaje principal, que es caro. Los entornos y personajes 3D aproximados generados con IA son lo bastante rápidos como para iterar en tiempo real, sustituyendo el proceso manual que se hacía tradicionalmente dentro de Maya o SketchUp.
Arquitectura e inmobiliaria
Los arquitectos usan flujos de imagen a 3D para generar maquetas volumétricas aproximadas a partir de fotos de bocetos o de imágenes de referencia del terreno. Las plataformas inmobiliarias usan la generación 3D con IA para crear recorridos virtuales a partir de datos básicos de planos y fotos de habitaciones, lo que reduce de forma notable el costo del home staging en 3D.
Experiencias sociales y de realidad aumentada
Los filtros de realidad aumentada, las aplicaciones de probador virtual y las plataformas de avatares necesitan contenido 3D constante y a gran escala. La generación con IA alimenta estos flujos con un volumen que ningún equipo de modeladores podría igualar a mano, y la velocidad de iteración la hace viable para contenido de temporada o de campañas que, de otro modo, sería demasiado caro.
Usar Hunyuan 3D 3.1 en PicassoIA
PicassoIA tiene Hunyuan 3D 3.1 disponible directamente, lo que lo convierte en uno de los flujos de imagen a 3D más accesibles que existen hoy. Así se usa de forma eficaz desde cero.
Flujo de trabajo paso a paso
Paso 1: prepara tu imagen de entrada
Usa una fotografía limpia y bien iluminada del objeto que quieres convertir. Si es posible, elimina primero el fondo. Centra el objeto en el encuadre, sin recortes en ningún borde.
Paso 2: sube y configura
Ve a Hunyuan 3D 3.1 en PicassoIA. Sube tu imagen de referencia. Ajusta la densidad de malla de salida según el uso previsto: menos polígonos para aplicaciones en tiempo real, más para renders estáticos o impresión.
Paso 3: genera y revisa
El modelo se ejecuta y devuelve una malla 3D normalmente en 30 a 60 segundos. Usa el visor integrado para inspeccionar el resultado desde todos los ángulos antes de descargarlo.
Paso 4: exporta y usa
Descarga el resultado en el formato que prefieras. OBJ, GLB y GLTF son estándar. Impórtalo en Blender, Unreal Engine, Unity o en el software 3D que uses para el uso final y cualquier limpieza necesaria.
Consejos para mejores resultados
- Para productos: un plano heroico con ángulo elevado de 45 grados funciona mejor que las vistas frontales planas, que dan a la IA menos información de profundidad con la que trabajar.
- Para personajes: una imagen de referencia en pose neutra en T o en A produce una topología más limpia que una pose de acción dinámica.
- Para objetos con siluetas complejas: ejecuta la misma imagen dos veces. Los modelos generativos tienen aleatoriedad inherente, y una segunda pasada suele resolver los artefactos que aparecieron en la primera.
💡 Consejo avanzado: Fotografía tu imagen de referencia sobre un fondo liso y usa la herramienta de eliminación de fondo de PicassoIA antes de subirla. Las imágenes de entrada más limpias producen resultados 3D mucho más limpios.
Animar modelos 3D sin experiencia en rigging
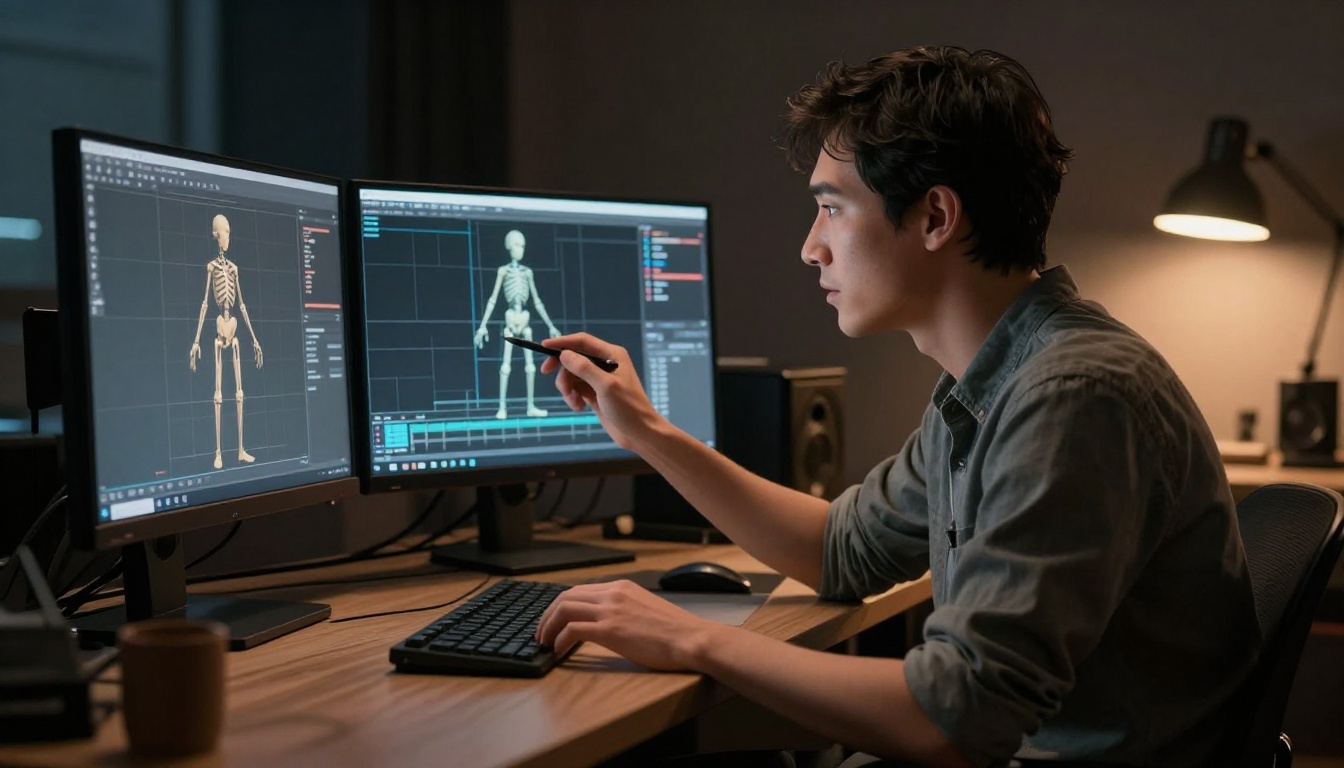
Conseguir un modelo 3D es solo el primer paso. La animación suele ser la habilidad más difícil de adquirir. La IA está derribando esa barrera en cada etapa del flujo de producción.
Qué hace Text To Motion Diffusion v2
Text To Motion Diffusion v2, de Uthana, genera datos de animación a partir de prompts de texto. Describes una acción en lenguaje natural y el modelo devuelve datos de movimiento que pueden aplicarse a cualquier rig 3D compatible. Esto elimina por completo la necesidad de equipos de captura de movimiento o de habilidades de animación por fotogramas clave para movimientos de complejidad simple a media.
Text To Motion VQVAE v1 usa una arquitectura de autocodificador variacional cuantizado por vectores que produce resultados más suaves en ciclos en bucle, lo que lo hace especialmente adecuado para animaciones en reposo, ciclos de caminar y otros movimientos repetitivos que se usan en videojuegos y aplicaciones en tiempo real.
Rigging automático con Create Character v1
Antes de que los datos de animación puedan aplicarse, una malla de personaje necesita un esqueleto: un rig. Hacer el rigging a mano es un proceso de varias horas que exige un conocimiento técnico profundo de la colocación de huesos, el pintado de pesos y la configuración de cadenas de cinemática inversa. Create Character v1 automatiza todo esto. Introduces una malla de personaje y devuelve un personaje con rig completo y listo para animar.
La combinación de Hunyuan 3D 3.1 para generar el modelo, Create Character v1 para el rigging y Text To Motion Diffusion v2 para la animación constituye un flujo completo de cero a personaje animado que no requiere habilidades 3D tradicionales en ninguna etapa.
Las limitaciones reales del 3D con IA hoy
La generación 3D con IA es potente, pero tiene restricciones reales que conviene conocer antes de incorporarla a un flujo de producción.
Lo que todavía necesita una persona:
- Topología compleja alrededor de las articulaciones: las mallas generadas por IA suelen tener una distribución irregular de polígonos en codos, rodillas y articulaciones de los dedos. Las zonas faciales, sobre todo alrededor de la boca y los ojos, necesitan con frecuencia una limpieza manual antes de que la animación orgánica funcione bien.
- Geometría interior: la IA no puede inferir cómo es el interior de un objeto hueco. El interior de una botella, de una habitación o de un zapato se adivina o queda incompleto.
- Piezas mecánicas de precisión: los engranajes, los tornillos roscados y los conjuntos de precisión requieren un modelado limpio de estilo CAD que las herramientas basadas en difusión no producen de forma fiable.
- Texturizado coherente a gran escala: los materiales a veces se repiten mal o se rompen en geometrías poco habituales, y requieren una pasada de pintura de texturas.
Realidades de los formatos de archivo:
| Formato | Mejor para | Tamaño |
|---|
| OBJ | Importación / exportación universal | Medio |
| GLB / GLTF | Web, realidad aumentada, motores en tiempo real | Compacto |
| FBX | Motores de videojuegos con animación | Grande |
| STL | Flujos de impresión 3D | Medio |
Las herramientas de IA suelen generar OBJ o GLB. Si tu flujo de trabajo necesita FBX, hace falta un paso de conversión. Blender realiza esta conversión gratis y sin pérdida de calidad.
Hacia dónde va la generación 3D con IA
La generación actual de herramientas convierte una sola imagen en una malla estática. Lo que viene a continuación es más rápido, más capaz y cada vez más integrado en flujos de trabajo en tiempo real.
Generación 3D en tiempo real
Los prototipos de investigación ya demuestran la generación de mallas completas con texturas y mapas UV incluidos en menos de 10 segundos. En los próximos 12 a 24 meses, la generación 3D en tiempo real será viable en contextos de producción. Eso significa escribir un prompt y ver aparecer en tu escena un objeto 3D editable al instante, sin esperas de procesamiento.
Gaussian Splatting y la IA volumétrica
El Gaussian splatting representa las escenas 3D como colecciones de funciones gaussianas orientadas en lugar de mallas de polígonos. Este enfoque produce renders sorprendentemente fotorrealistas y ya se usa en los flujos de trabajo de efectos visuales de varios grandes estudios. Los sistemas de IA están empezando a generar representaciones de splats gaussianos directamente, lo que cambiará la forma en que se crea y se experimenta el contenido 3D en la realidad virtual y en los entornos de realidad aumentada inmersiva.
Edición 3D semántica
La siguiente capacidad después de la generación es la edición con lenguaje natural. Los primeros sistemas ya permiten describir un cambio de material o de forma y hacer que el modelo actualice en consecuencia la geometría 3D y las propiedades de la superficie. Esto cierra el círculo entre la intención creativa y la ejecución técnica, y elimina la necesidad de modelado manual en la etapa de revisión.
💡 Ojo a esto: la convergencia entre la difusión de video y la generación 3D. Los modelos de video ya construyen una comprensión coherente entre fotogramas, lo que equivale geométricamente a la comprensión 3D multivista. Los próximos avances más importantes en el 3D con IA probablemente surgirán de esa intersección.
Pruébalo tú mismo
La barrera entre querer un modelo 3D y tenerlo se ha derrumbado en la práctica. No necesitas años de práctica en Blender. No necesitas equipos de captura de movimiento. No necesitas tener a un artista 3D contratado.
PicassoIA tiene disponibles en una sola plataforma Hunyuan 3D 3.1, Rodin, Create Character v1, Text To Motion Diffusion v2 y Text To Motion VQVAE v1. Es un flujo de producción 3D completo con IA: de una imagen conceptual a un personaje animado, con rig y listo para exportar.
Haz una foto de algo que tengas en el escritorio. Súbela. Mira qué devuelve. Ese momento de ver cómo una fotografía se convierte en un modelo 3D en menos de un minuto vale más que cualquier explicación. Las herramientas están ahí. Empieza ya.


