तीन साल पहले, किसी फोटोरियलिस्टिक 3D मॉडल को बनाने के लिए Blender, Cinema 4D या Maya में महीनों की प्रैक्टिस चाहिए थी। आज इसके लिए एक फ़ोटो और लगभग 30 सेकंड लगते हैं। यह बदलाव धीरे-धीरे होने वाला नहीं है। पिछले एक दशक में क्रिएटिव टेक्नोलॉजी की दुनिया में यह सबसे बड़े बदलावों में से एक है, और यह अभी हो रहा है।
AI 3D मॉडल जनरेशन असल में क्या है, यह कैसे काम करता है, इसका उपयोग कहाँ पहले से हो रहा है, और बिना किसी पहले के मॉडलिंग अनुभव के आप आज ही असली 3D एसेट कैसे बनाना शुरू कर सकते हैं, यह सब इस आर्टिकल में है।
AI 3D मॉडल असल में क्या हैं
3D मॉडल किसी त्रि-आयामी ऑब्जेक्ट का गणितीय प्रतिनिधित्व है, जिसे मेश के रूप में सेव किया जाता है। मेश वर्टिसेस, एजेज़ और फ़ेसेस का एक समूह है जो ऑब्जेक्ट का आकार तय करता है। पारंपरिक 3D मॉडलिंग में इन वर्टिसेस को हाथ से रखना और जोड़ना पड़ता था। AI 3D जनरेशन इस मैन्युअल प्रक्रिया की जगह न्यूरल नेटवर्क लेता है, जिन्हें लाखों 3D आकारों पर ट्रेन किया गया है। इससे सिस्टम किसी टेक्स्ट विवरण या 2D इमेज से ऑब्जेक्ट की पूरी ज्यामिति का अनुमान लगा सकता है।
इसके नीचे चलने वाली तकनीक
आज ज़्यादातर AI 3D जनरेशन तीन मुख्य तरीकों में से किसी एक पर आधारित है:
| तरीका | इनपुट | आउटपुट | सबसे अच्छा किसके लिए |
|---|
| डिफ़्यूज़न मॉडल | टेक्स्ट या इमेज | मेश / NeRF | सामान्य ऑब्जेक्ट |
| NeRF (न्यूरल रेडियंस फ़ील्ड्स) | कई इमेज | वॉल्यूमेट्रिक सीन | एनवायरनमेंट |
| Gaussian Splatting | फ़ोटो या वीडियो | Splat रेप्रेज़ेंटेशन | असली दुनिया की स्कैनिंग |
Hunyuan 3D 3.1 जैसे डिफ़्यूज़न-आधारित मॉडल 3D आकारों की प्रायिकता वितरण (probability distribution) सीखकर और नॉइज़ को धीरे-धीरे एक सुसंगत ऑब्जेक्ट में बदलकर काम करते हैं। नतीजा एक मेश या पॉइंट क्लाउड होता है, जिसे एक्सपोर्ट करके असली प्रोडक्शन पाइपलाइन में इस्तेमाल किया जा सकता है।
AI के लिए 3D, 2D से कठिन क्यों है
2D इमेज बनाने का मतलब है एक सपाट ग्रिड पर पिक्सेल के रंग का अनुमान लगाना। 3D मॉडल बनाने का मतलब है ऐसी ज्यामिति का अनुमान लगाना जो हर कोण से सुसंगत हो। यह मूल रूप से एक कठिन समस्या है। मॉडल को गहराई, ओक्लूज़न, सरफ़ेस नॉर्मल्स और टोपोलॉजी का ध्यान रखना पड़ता है, जबकि उसने फ़ोटो में खींचे गए ऑब्जेक्ट का पिछला या निचला हिस्सा कभी देखा ही नहीं होता। आज की AI प्रणालियाँ यह भरोसेमंद ढंग से कर पाती हैं, यही अपने आप में उल्लेखनीय इंजीनियरिंग है।
AI टेक्स्ट और फ़ोटो को 3D में कैसे बदलता है
AI 3D जनरेशन के तीन मुख्य इनपुट रास्ते हैं: टेक्स्ट, इमेज और मल्टी-व्यू। हर एक की अपनी ताकत है, यह इस पर निर्भर करता है कि आप क्या बनाना चाहते हैं।
टेक्स्ट-टू-3D: शब्दों से ज्यामिति का वर्णन
टेक्स्ट-टू-3D मॉडल एक सामान्य भाषा का विवरण लेकर पूरा 3D मेश बनाते हैं। AI अर्थ को स्पेशियल ज्यामिति से जोड़ता है और अपनी ट्रेनिंग के आधार पर अनुमान लगाता है कि वर्णित ऑब्जेक्ट हर कोण से कैसा दिखेगा। नतीजे लगातार साफ़ और एक्सपोर्ट के लिए तैयार होते जा रहे हैं, हालाँकि बारीक डिटेल वाले जटिल आकारों को अब भी मैन्युअल रिफ़ाइनमेंट की ज़रूरत पड़ती है।
💡 टिप: ज़्यादा विशिष्ट प्रॉम्प्ट से बेहतर ज्यामिति मिलती है। "एक सफ़ेद सिरेमिक मग, बेलनाकार, 10cm ऊँचा, लूप हैंडल वाला" लिखना "एक मग" से काफ़ी बेहतर परिणाम देता है। मटीरियल, स्केल और आकार साफ़-साफ़ बताएँ।
इमेज-टू-3D: एक फ़ोटो, पूरा ऑब्जेक्ट
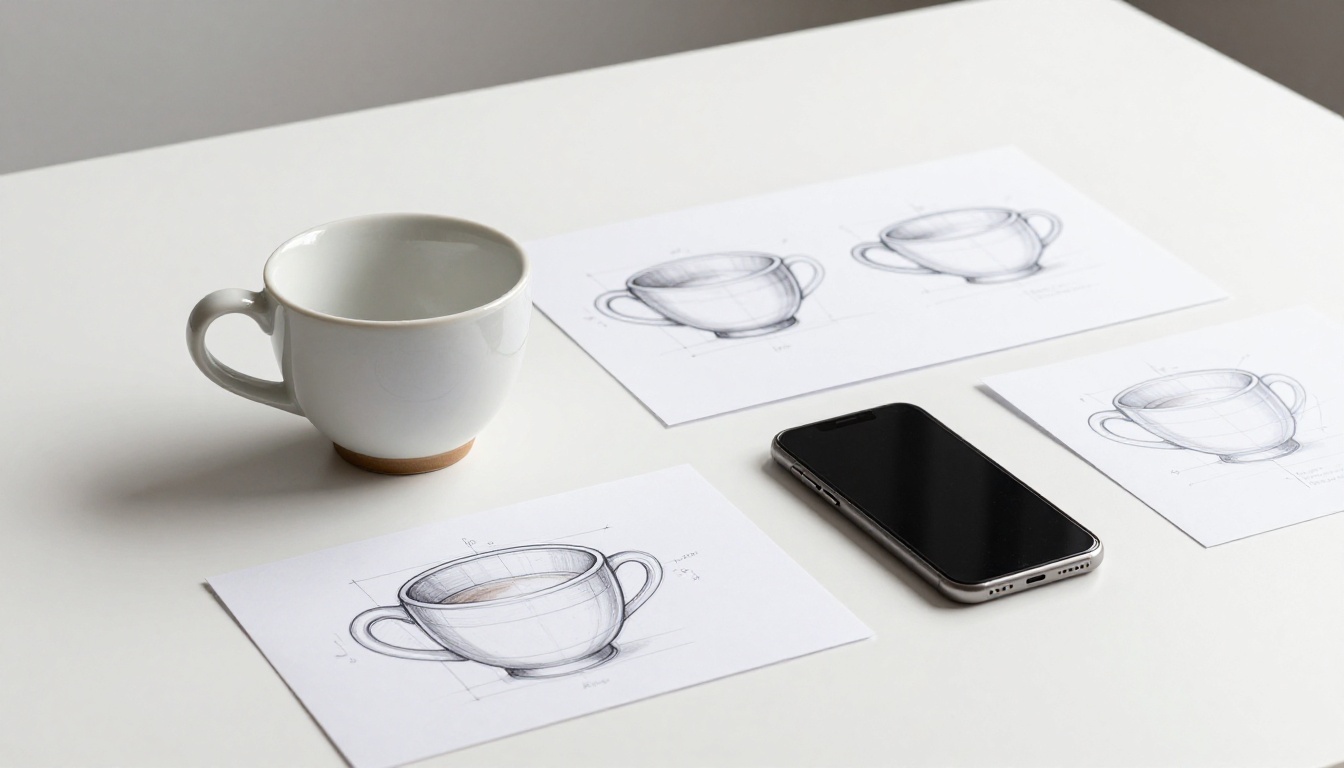
इमेज-टू-3D इस समय प्रोडक्ट क्रिएटर्स और डिज़ाइनर्स के लिए सबसे व्यावहारिक वर्कफ़्लो है। आप एक फ़ोटो देते हैं और AI आकार, रोशनी और मटीरियल के संकेतों के आधार पर अनुमान लगाता है कि पीछे, साइड और नीचे का हिस्सा कैसा दिखता होगा। Rodin Hyper3D का बनाया हुआ एक मज़बूत उदाहरण है, जो प्रोडक्ट फ़ोटो से गेम-रेडी मेश बनाता है और सरफ़ेस डिटेल भी प्रभावशाली होती है। Hunyuan 3D 3.1 Tencent का है, और यह इससे आगे जाता है। एक साफ़ इनपुट इमेज से यह उचित UV मैपिंग के साथ विस्तृत मॉडल देता है।
अच्छी इनपुट फ़ोटो में क्या होता है:
- साफ़ बैकग्राउंड, सफ़ेद या हल्का ग्रे बेहतर है
- ऑब्जेक्ट बीच में हो और किनारों पर कटा हुआ न हो
- डिफ़्यूज़, समान रोशनी हो, तेज़ दिशात्मक परछाइयाँ न हों
- 30 से 45 डिग्री के ऊँचे कोण से शॉट लिया गया हो
मल्टी-व्यू और वीडियो-आधारित जनरेशन
सबसे सटीक तरीका एक ही ऑब्जेक्ट की अलग-अलग कोणों से ली गई कई फ़ोटो का इस्तेमाल करता है। AI हर व्यू को आपस में मिलाकर पूरी ज्यामिति दोबारा बनाता है, काफ़ी कुछ वैसे ही जैसे न्यूरल नेटवर्क से पहले फ़ोटोग्रामेट्री काम करती थी। इन तरीकों से आम तौर पर सिंगल-इमेज तरीकों की तुलना में ज़्यादा सटीक मेश मिलते हैं, जिनमें टोपोलॉजी की गलतियाँ कम होती हैं। किसी ऑब्जेक्ट के घूमते हुए छोटे वीडियो क्लिप भी इसी तरह इस्तेमाल होते हैं, जिससे मॉडल को काम करने के लिए दर्जनों अप्रत्यक्ष व्यूपॉइंट मिल जाते हैं।
5 जगहें जहाँ AI 3D पहले से काम कर रहा है
AI 3D जनरेशन कोई ऐसी अवधारणा नहीं है जिसे रिसर्च लैब में परखा जा रहा हो। यह अभी कई उद्योगों में सक्रिय रूप से इस्तेमाल हो रही है।
इंडी गेम डेवलपमेंट
अकेले काम करने वाले डेवलपर्स और छोटे स्टूडियो के लिए 3D एसेट बनाना हमेशा सबसे बड़ी रुकावट रहा है। हर प्रॉप, एनवायरनमेंट पीस और NPC के लिए 3D आर्टिस्ट रखना महँगा और धीमा है। Rodin जैसे टूल से बने AI एसेट मिनटों में गेम-रेडी लो-पॉली प्रॉप देते हैं। ये या तो सीधे फ़ाइनल एसेट के रूप में इस्तेमाल हो सकते हैं, या बेस मेश के रूप में, जिन्हें एक जनरलिस्ट आर्टिस्ट रिफ़ाइन और ऑप्टिमाइज़ करता है।
ई-कॉमर्स प्रोडक्ट विज़ुअलाइज़ेशन
ई-कॉमर्स ब्रांड्स को AR ट्राई-ऑन, 360-डिग्री व्यूअर और कॉन्फ़िगरेटर के लिए हर प्रोडक्ट का 3D मॉडल चाहिए। पारंपरिक तौर पर एक प्रोडक्ट का 3D मॉडल बनवाने में $150 से $500 लगते हैं। फ़ोटो से AI जनरेशन इस लागत को लगभग शून्य के करीब ले आता है, और इसकी क्वालिटी ज़्यादातर कमर्शियल इस्तेमाल के लिए पहले से स्वीकार्य है।
फ़िल्म और एनिमेशन प्री-विज़ुअलाइज़ेशन
डायरेक्टर्स और स्टोरीबोर्ड आर्टिस्ट महँगी प्रिंसिपल फ़ोटोग्राफ़ी शुरू होने से पहले कैमरा एंगल और ब्लॉकिंग की योजना बनाने के लिए 3D प्री-विज़ुअलाइज़ेशन इस्तेमाल करते हैं। AI से बने मोटे 3D एनवायरनमेंट और कैरेक्टर इतनी तेज़ी से बनते हैं कि रियल टाइम में उन पर बार-बार काम किया जा सकता है। यह उस मैन्युअल प्रक्रिया की जगह ले रहा है जो पारंपरिक रूप से Maya या SketchUp के अंदर होती थी।
आर्किटेक्चर और रियल एस्टेट
आर्किटेक्ट स्केच फ़ोटो या साइट के संदर्भ इमेज से मोटे मासिंग मॉडल बनाने के लिए इमेज-टू-3D पाइपलाइन इस्तेमाल करते हैं। रियल एस्टेट प्लेटफ़ॉर्म बुनियादी फ़्लोर प्लान डेटा और कमरों की फ़ोटो से वर्चुअल वॉकथ्रू बनाने के लिए AI 3D जनरेशन इस्तेमाल करते हैं, जिससे 3D स्टेजिंग की लागत काफ़ी कम हो जाती है।
सोशल और AR अनुभव
AR फ़िल्टर, वर्चुअल ट्राई-ऑन ऐप्स और अवतार प्लेटफ़ॉर्म को लगातार बड़े पैमाने पर 3D कंटेंट चाहिए। AI जनरेशन इन पाइपलाइनों को इतनी मात्रा में कंटेंट देता है जितना कोई मॉडलिंग टीम हाथ से नहीं दे सकती। इसकी इटरेशन की रफ़्तार इसे मौसमी या कैंपेन-विशेष कंटेंट के लिए व्यवहार्य बनाती है, जो वरना बहुत महँगा पड़ता।
PicassoIA पर Hunyuan 3D 3.1 का इस्तेमाल
PicassoIA पर Hunyuan 3D 3.1 सीधे उपलब्ध है, जिससे यह आज की सबसे सुलभ इमेज-टू-3D पाइपलाइनों में से एक बन जाता है। शून्य से शुरू करके इसे असरदार तरीके से इस्तेमाल करने का तरीका यहाँ है।
स्टेप-बाय-स्टेप वर्कफ़्लो
स्टेप 1: अपनी इनपुट इमेज तैयार करें
जिस ऑब्जेक्ट को बदलना चाहते हैं, उसकी एक साफ़ और अच्छी रोशनी वाली फ़ोटो लें। हो सके तो पहले बैकग्राउंड हटा दें। ऑब्जेक्ट को फ़्रेम के बीच में रखें और किसी किनारे से कटने न दें।
स्टेप 2: अपलोड करें और कॉन्फ़िगर करें
PicassoIA पर Hunyuan 3D 3.1 पर जाएँ। अपनी रेफ़रेंस इमेज अपलोड करें। आउटपुट मेश की डेंसिटी अपने उपयोग के हिसाब से एडजस्ट करें: रियल-टाइम ऐप्स के लिए कम पॉली, स्टैटिक रेंडर या प्रिंट के लिए ज़्यादा।
स्टेप 3: जनरेट करें और जाँचें
मॉडल चलता है और आम तौर पर 30 से 60 सेकंड में 3D मेश लौटा देता है। डाउनलोड करने से पहले बिल्ट-इन व्यूअर में सभी कोणों से नतीजा जाँचें।
स्टेप 4: एक्सपोर्ट करें और इस्तेमाल करें
आउटपुट को अपने पसंदीदा फ़ॉर्मेट में डाउनलोड करें। OBJ, GLB और GLTF मानक फ़ॉर्मेट हैं। फ़ाइनल उपयोग और ज़रूरी क्लीनअप के लिए इसे Blender, Unreal Engine, Unity या अपने पसंदीदा 3D सॉफ़्टवेयर में इंपोर्ट करें।
बेहतर आउटपुट के लिए टिप्स
- प्रोडक्ट के लिए: 45 डिग्री के ऊँचे हीरो शॉट फ़्लैट फ़्रंटल व्यू से बेहतर परिणाम देते हैं, क्योंकि सीधे सामने के व्यू में AI को गहराई की कम जानकारी मिलती है।
- कैरेक्टर के लिए: न्यूट्रल T-पोज़ या A-पोज़ रेफ़रेंस इमेज डायनामिक एक्शन पोज़ की तुलना में साफ़ टोपोलॉजी देती है।
- जटिल सिल्हूट वाले ऑब्जेक्ट के लिए: वही इमेज दो बार चलाएँ। जनरेटिव मॉडल में अंतर्निहित रैंडमनेस होती है, और दूसरा पास अक्सर पहले में आई गड़बड़ियों को ठीक कर देता है।
💡 प्रो टिप: अपनी रेफ़रेंस फ़ोटो सादे बैकग्राउंड के सामने लें और अपलोड करने से पहले PicassoIA का बैकग्राउंड हटाने वाला टूल इस्तेमाल करें। साफ़ इनपुट इमेज से 3D आउटपुट भी काफ़ी साफ़ मिलते हैं।
रिगिंग के अनुभव के बिना 3D मॉडल को एनिमेट करना
3D मॉडल पाना सिर्फ़ पहला कदम है। एनिमेशन पारंपरिक रूप से सीखना ज़्यादा कठिन कौशल रहा है। AI पाइपलाइन के हर चरण पर इस बाधा को हटा रहा है।
Text To Motion Diffusion v2 क्या करता है
Text To Motion Diffusion v2 Uthana का बनाया है और टेक्स्ट प्रॉम्प्ट से एनिमेशन डेटा जनरेट करता है। कोई एक्शन सामान्य भाषा में बताएँ, और मॉडल मोशन डेटा लौटाता है जिसे किसी भी संगत 3D रिग पर लगाया जा सकता है। इससे सरल से मध्यम जटिलता वाली हरकतों के लिए मोशन कैप्चर उपकरण या की-फ़्रेम एनिमेशन के कौशल की ज़रूरत पूरी तरह खत्म हो जाती है।
Text To Motion VQVAE v1 एक Vector Quantized Variational Autoencoder आर्किटेक्चर इस्तेमाल करता है, जो लूप साइकल के लिए ज़्यादा स्मूद नतीजे देता है। इसी वजह से यह आइडल एनिमेशन, वॉक साइकल और गेम्स व रियल-टाइम ऐप्स में इस्तेमाल होने वाली दूसरी दोहराई जाने वाली हरकतों के लिए खास तौर पर उपयुक्त है।
Create Character v1 से ऑटो-रिगिंग
एनिमेशन डेटा लगाने से पहले कैरेक्टर मेश को एक कंकाल चाहिए, जिसे रिग कहते हैं। हाथ से रिगिंग करना कई घंटों की प्रक्रिया है, जिसमें हड्डियों की जगह, वेट पेंटिंग और इनवर्स काइनेमैटिक्स चेन के कॉन्फ़िगरेशन की गहरी तकनीकी समझ चाहिए। Create Character v1 इसे पूरी तरह ऑटोमेट कर देता है। एक कैरेक्टर मेश डालें, और यह पूरी तरह रिग्ड, एनिमेशन के लिए तैयार कैरेक्टर लौटा देता है।
Hunyuan 3D 3.1 से मॉडल जनरेशन, Create Character v1 से रिगिंग और Text To Motion Diffusion v2 से एनिमेशन का संयोजन एक पूरी ज़ीरो-से-एनिमेटेड-कैरेक्टर पाइपलाइन बनाता है, जिसके किसी भी चरण पर पारंपरिक 3D कौशल की ज़रूरत नहीं होती।
आज AI 3D की असली सीमाएँ
AI 3D जनरेशन शक्तिशाली है, लेकिन इसे किसी प्रोडक्शन पाइपलाइन में लगाने से पहले इसकी असली सीमाएँ जानना ज़रूरी है।
जिसके लिए अब भी इंसान चाहिए:
- जोड़ों के आसपास जटिल टोपोलॉजी: AI से बने मेश में कोहनी, घुटने और उंगलियों के जोड़ों पर अक्सर अनियमित पॉलीगन वितरण होता है। चेहरे के हिस्से, खासकर मुँह और आँखों के आसपास, ऑर्गेनिक एनिमेशन ठीक से काम करने से पहले अक्सर मैन्युअल क्लीनअप माँगते हैं।
- अंदरूनी ज्यामिति: AI यह अनुमान नहीं लगा सकता कि किसी खोखले ऑब्जेक्ट का अंदरूनी हिस्सा कैसा दिखता है। किसी बोतल, कमरे या जूते का अंदरूनी हिस्सा लगभग अंदाज़े से बनता है या अधूरा रह जाता है।
- सटीक मैकेनिकल पुर्ज़े: गियर, थ्रेडेड फ़ास्टनर और सटीक असेंबली के लिए साफ़ CAD-स्टाइल मॉडलिंग चाहिए, जिसे डिफ़्यूज़न-आधारित टूल भरोसेमंद ढंग से नहीं बनाते।
- बड़े पैमाने पर एकसमान टेक्सचरिंग: मटीरियल कभी-कभी खराब तरीके से टाइल होते हैं या असामान्य ज्यामिति पर टूट जाते हैं, जिसके लिए टेक्सचर पेंटिंग का एक अलग चरण चाहिए।
फ़ाइल फ़ॉर्मेट की सच्चाई:
| फ़ॉर्मेट | सबसे अच्छा किसके लिए | आकार |
|---|
| OBJ | यूनिवर्सल इंपोर्ट / एक्सपोर्ट | मध्यम |
| GLB / GLTF | वेब, AR, रियल-टाइम इंजन | कॉम्पैक्ट |
| FBX | एनिमेशन वाले गेम इंजन | बड़ा |
| STL | 3D प्रिंटिंग वर्कफ़्लो | मध्यम |
AI टूल आम तौर पर OBJ या GLB आउटपुट देते हैं। अगर आपकी पाइपलाइन को FBX चाहिए, तो एक कन्वर्ज़न चरण ज़रूरी है। Blender यह कन्वर्ज़न मुफ़्त में और बिना क्वालिटी खोए कर देता है।
AI 3D जनरेशन किस दिशा में जा रहा है
आज की पीढ़ी के टूल एक इमेज को स्टैटिक मेश में बदलते हैं। आगे जो आने वाला है वह और तेज़, ज़्यादा सक्षम और रियल-टाइम वर्कफ़्लो में ज़्यादा गहराई से जुड़ा होगा।
रियल-टाइम 3D जनरेशन
रिसर्च प्रोटोटाइप बनावट और UV मैप के साथ 10 सेकंड से कम में पूरा मेश जनरेट करने का प्रदर्शन कर रहे हैं। अगले 12 से 24 महीनों में रियल-टाइम 3D जनरेशन प्रोडक्शन के संदर्भों में व्यवहार्य हो जाएगा। इसका मतलब है कि आप एक प्रॉम्प्ट टाइप करेंगे और एक एडिट करने योग्य 3D ऑब्जेक्ट तुरंत आपके सीन में दिखेगा, बिना किसी प्रोसेसिंग इंतज़ार के।
Gaussian Splatting और वॉल्यूमेट्रिक AI
Gaussian splatting 3D सीन को पॉलीगन मेश के बजाय ओरिएंटेड गॉसियन फ़ंक्शन के संग्रह के रूप में दर्शाता है। यह तरीका बेहद फ़ोटोरियलिस्टिक रेंडर देता है और कई बड़े स्टूडियो की विज़ुअल इफ़ेक्ट्स पाइपलाइनों में पहले से इस्तेमाल हो रहा है। AI सिस्टम अब Gaussian splat रेप्रेज़ेंटेशन सीधे जनरेट करने लगे हैं, जो बदल देगा कि VR और इमर्सिव AR वातावरण में 3D कंटेंट कैसे बनाया और अनुभव किया जाता है।
सेमांटिक 3D एडिटिंग
जनरेशन के बाद अगली क्षमता है नेचुरल लैंग्वेज से एडिटिंग। शुरुआती सिस्टम पहले से ही आपको किसी मटीरियल या आकार में बदलाव बताने देते हैं, और मॉडल उसी के हिसाब से 3D ज्यामिति और सरफ़ेस प्रॉपर्टीज़ अपडेट कर देता है। इससे क्रिएटिव इरादे और तकनीकी अमल के बीच का चक्र पूरा होता है, और रिवीज़न के चरण पर मैन्युअल मॉडलिंग की ज़रूरत खत्म हो जाती है।
💡 देखें: वीडियो डिफ़्यूज़न और 3D जनरेशन का मेल। वीडियो मॉडल पहले से फ़्रेम-दर-फ़्रेम एक सुसंगत समझ बनाते हैं, जो ज्यामितीय रूप से मल्टी-व्यू 3D समझ के बराबर है। AI 3D में अगली सबसे बड़ी सफलताएँ संभवतः इसी संगम से निकलेंगी।
खुद आज़माएँ
3D मॉडल चाहने और उसे पा लेने के बीच की दीवार अब व्यावहारिक रूप से खत्म हो चुकी है। आपको सालों की Blender प्रैक्टिस नहीं चाहिए। मोशन कैप्चर उपकरण की ज़रूरत नहीं है। किसी रिटेनर पर 3D आर्टिस्ट रखने की भी ज़रूरत नहीं है।
PicassoIA पर Hunyuan 3D 3.1, Rodin, Create Character v1, Text To Motion Diffusion v2 और Text To Motion VQVAE v1 सब एक ही प्लेटफ़ॉर्म पर उपलब्ध हैं। यह एक पूरी AI-संचालित 3D प्रोडक्शन पाइपलाइन है: कॉन्सेप्ट इमेज से लेकर एनिमेटेड, रिग्ड और एक्सपोर्ट-रेडी कैरेक्टर तक।
अपनी मेज़ पर रखी किसी चीज़ की फ़ोटो लें। उसे अपलोड करें। देखें कि क्या बनकर आता है। एक मिनट से कम में फ़ोटो को 3D मॉडल में बदलते देखने का वह पल किसी भी व्याख्या से ज़्यादा कीमती है। टूल तैयार हैं। अभी शुरू करें।


