تحمل الصور الثابتة قصةً مجمدةً داخل إطار واحد. يأخذ Seedance 2.5 من ByteDance هذا الإطار ويضعه في حركة، فينتج حتى 30 ثانية من فيديو سلس وواقعي بصوت أصلي متزامن، من أي صورة فوتوغرافية ترفعها. النتائج ليست حلقات مفلترة ولا تأثيرات تكبير بسيطة، بل هي مشاهد متحركة متماسكة تتغير فيها الإضاءة، وتتموج الأسطح، ويتحرك الأشخاص بطريقة تتطابق مع فيزياء الصورة الأصلية وأجوائها. إذا كنت تنتظر نموذجًا لتحويل الصورة إلى فيديو يحترم فعلًا جودة تصويرك، فهذا النموذج يستحق الانتباه.
ماذا يفعل Seedance 2.5 فعليًا
من الصورة إلى الفيديو في ثوانٍ
تطبّق معظم أدوات تحويل الصورة إلى فيديو نمط حركة عامًا على أي صورة ترفعها. أما Seedance 2.5 فيفعل شيئًا مختلفًا جذريًا: يبني نموذجًا زمنيًا لصورتك، ويستنتج العمق واتجاه الإضاءة ونوع السطح قبل أن يولّد أي إطار فيديو. والنتيجة حركة تبدو جزءًا أصيلًا من المشهد، لا شيئًا ملصوقًا فوقه.
صمّمت ByteDance هذا النموذج بعدة أهداف تقنية: تماسك زمني عبر المقاطع الطويلة، وحركة معقولة فيزيائيًا لأنواع مختلفة من الأسطح، مثل الماء والقماش والعشب والضباب الجوي، وتوليد صوت يستجيب للمحتوى البصري بدلًا من أن يعمل كمسار مستقل منفصل.
في جوهره، Seedance 2.5 هو محوّل انتشاري (diffusion transformer) يعمل في الفضاء الكامن للفيديو. يعتمد على الصورة المدخلة وأمر نصي للحركة، ثم يحسّن الفيديو الكامن تكراريًا حتى يتطابق الناتج مع المحتوى البصري والحركة الموصوفة معًا. دُرِّب النموذج على طيف واسع من أساليب التصوير الفوتوغرافي الواقعي، ولهذا يتعامل مع صور مدخلة متنوعة دون خطوات المعالجة المسبقة الصارمة التي كانت تحتاجها النماذج القديمة.

صوت أصلي في كل مقطع
من أهم الإضافات في Seedance 2.5 توليد الصوت الأصلي. كانت نماذج سابقة مثل Seedance 2.0 تنتج فيديو فقط، ويبقى الصوت خطوة منفصلة في سير العمل تتطلب إما الصمت أو عملية دبلجة يدوية. أما Seedance 2.5 فيولّد أصواتًا محيطية متزامنة ومؤثرات صوتية مرافقة لإطارات الفيديو.
إذا أظهرت صورتك شلالًا، ستسمع اندفاع الماء في المسار الصوتي. ويولّد مشهد شارع مزدحم ضجيج المرور. الرياح في الأعشاب الطويلة، والمطر على النوافذ، وهمهمة الحشود، وطقطقة النار: يستنتج النموذج الصوت المناسب من السياق البصري ومن وصف أمرك النصي.
يهم هذا صانعي المحتوى لأنه يختصر ما كان سير عمل بأداتين إلى تمريرة توليد واحدة. جودة الصوت ليست بمستوى البث الاحترافي، لكنها قابلة للاستخدام باستمرار مباشرةً دون أي إعداد، سواء للمحتوى الاجتماعي أو العروض التقديمية أو المشاريع الإبداعية.

خيارات المدة والدقة
يدعم Seedance 2.5 مقاطع من 5 ثوانٍ حتى 30 ثانية في تمريرة توليد واحدة. على PicassoIA، تُضبط نسبة العرض إلى الارتفاع افتراضيًا لتطابق الصورة المدخلة، أي أن تكوينك الأصلي محفوظ دون قص قسري أو إعادة تأطير. تبقى الصورة العمودية عمودية، وتبقى اللقطة العريضة عريضة.
النسخة المجانية، Seedance 2.5 Lite، تولّد مقاطع تصل إلى 10 ثوانٍ، وهذا يغطي معظم حالات الاستخدام على وسائل التواصل الاجتماعي. أما Seedance 2.5 الكامل فيمتد إلى 30 ثانية للمحتوى الأطول، مثل الإعلانات التشويقية وفيديوهات العلامات التجارية والحلقات المحيطية.
كيف يقارن Seedance 2.5 بالنماذج الأخرى

قبل اعتماد نموذج واحد لمشروع ما، من المفيد أن تعرف بدقة موقع Seedance 2.5 مقارنةً بالبدائل. يغطي الجدول أدناه نماذج تحويل الصورة إلى فيديو الرئيسية المتاحة على PicassoIA عبر الأبعاد الأكثر أهمية لأعمال الإنتاج.
💡 المدة فارق حقيقي. إذا كان سير عملك يتطلب مقاطع أطول من 10 ثوانٍ من صورة واحدة، فإن Seedance 2.5 من النماذج القليلة حاليًا التي يمكنها تقديم ذلك دون دمج عدة مقاطع معًا.
كيفية استخدام Seedance 2.5 على PicassoIA
يستضيف PicassoIA كلًا من Seedance 2.5 الكامل وSeedance 2.5 Lite المجانية. الواجهة واحدة في النسختين، والفرق الوحيد هو نطاق المدة المتاح. لا حاجة إلى مفتاح API ولا إلى تثبيت محلي ولا إلى إدارة قائمة انتظار من جهتك.
الخطوة 1: ارفع صورتك

انتقل إلى صفحة نموذج Seedance 2.5 على PicassoIA، ثم انقر منطقة رفع الصورة. يقبل النموذج ملفات JPEG وPNG وWebP. للحصول على أفضل النتائج، ارفع صورًا لا يقل ضلعها القصير عن 1024 بكسل. يستخدم النموذج الدقة الكاملة كمدخل للتكييف، والصور منخفضة الدقة تنتج حركة أنعم بوضوح وتفاصيل سطح أقل حدة في الناتج.
تهم نسبة العرض إلى الارتفاع من هذه الخطوة الأولى. إذا رفعت صورة عمودية بنسبة 9:16، فسيكون فيديو الناتج عموديًا. أما اللقطة العريضة بنسبة 16:9 فتبقى عريضة. لا يعيد النموذج تأطير صورتك ولا يقصّها، لذا اضبط تكوين صورتك وفق صيغة الفيديو النهائية قبل الرفع.
الخطوة 2: اكتب أمرًا نصيًا للحركة

الأمر النصي للحركة ليس وصفًا لصورتك، فالنموذج يرى الصورة أصلًا. الأمر يصف ما الذي يتحرك وكيف. هذا هو الفرق الأهم الذي يجب فهمه عند العمل مع Seedance 2.5.
أمر ضعيف: "امرأة تقف في حقل زهور مع جبال في الخلفية"
أمر قوي: "المرأة تدير رأسها ببطء لتنظر إلى اليسار، والعشب الطويل يتمايل مع نسيم لطيف من اليسار إلى اليمين، والجبال البعيدة تلمع قليلًا في سراب حراري بعد الظهر، وحركة سحب بعيدة بالكاميرا"
يقرأ النموذج تعليمات الحركة ويطبّقها على الفيزياء التي استنتجها من الصورة. كلما كان وصف حركتك أدق، كان الناتج أكثر تحكمًا. الأوامر الغامضة تمنح النموذج حرية زائدة، فتكون النتيجة معقولة غالبًا لكنها ليست ما قصدته.
💡 أبقِ تعليمات حركة الكاميرا بسيطة. حركة كاميرا واحدة في كل مقطع (اقتراب، أو تحريك أفقي إلى اليسار، أو ميلان لأعلى) تعطي نتائج أنظف من تكديس عدة حركات معًا.
الخطوة 3: اضبط المدة ثم وَلِّد
اختر طول المقطع المطلوب باستخدام منزلق المدة. بالنسبة إلى Seedance 2.5 Lite المجانية، يصل الحد الأقصى إلى 10 ثوانٍ. أما النموذج الكامل فيمكنك تمديده حتى 30 ثانية. تستغرق المقاطع الأطول وقتًا أطول بشكل متناسب في التوليد، وعادةً بين 60 و120 ثانية من المعالجة لمقطع ناتج مدته 30 ثانية.
انقر Generate فيبدأ النموذج المعالجة. يشغّل PicassoIA التنبؤ بشكل غير متزامن ويعرض مؤشر تقدم مباشرًا. عند الانتهاء، يظهر مشغل الفيديو داخل الصفحة مع المسار المرئي والمسار الصوتي جاهزين للمعاينة مباشرة في المتصفح.
الخطوة 4: حمّل أو شارك
بعد جاهزية المقطع، حمّل ملف MP4 مباشرة من الواجهة. يمنحك PicassoIA أيضًا رابطًا قابلًا للمشاركة للفيديو المولّد. وإذا أردت الاحتفاظ بالمقطع بشكل دائم، فحمّله فور التوليد بدلًا من الاعتماد على الرابط القابل للمشاركة.
أفضل الصور لاستخدام Seedance 2.5
تصوير البورتريه والموضة
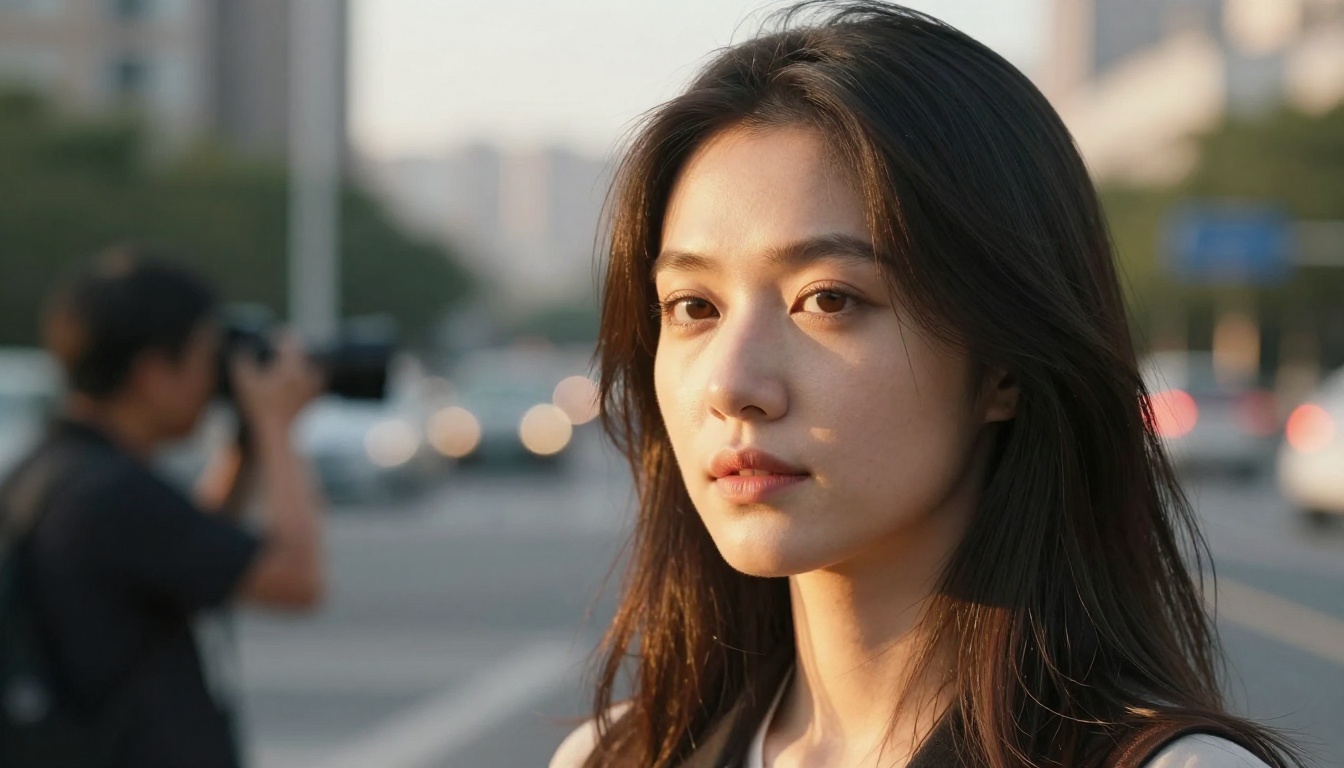
تُظهر صور البورتريه أقوى نتائج Seedance 2.5. دُرِّب النموذج على مجموعة كبيرة من بيانات الحركة البشرية، ما يعني أنه يتعامل مع الحركة الدقيقة للوجه، وفيزياء الشعر، وديناميكية الملابس بدقة لم تنجح فيها النماذج السابقة باستمرار.
ما يعمل جيدًا:
- بورتريهات طبيعية في الهواء الطلق مع إضاءة اتجاهية واضحة
- لقطات أزياء فيها قماش ذو ملمس مرئي وانسدال طبيعي
- بورتريهات بيئية تحتوي خلفيتها على إمكانات حركة طبيعية (أشجار، ماء، سماء مفتوحة)
- بورتريهات مقرّبة تكون فيها الحركات الدقيقة للتعابير وحركة الشعر هدف التحريك الأساسي
ما يميل إلى الصعوبة:
- بورتريهات على خلفية استوديو بيضاء خالصة لا تقدم البيئة فيها شيئًا يمكن تحريكه
- صور معدّلة بكثافة بملمس بشرة اصطناعي لا يستطيع النموذج أن يخصص لها فيزياء واقعية
- لقطات جماعية كثيفة لأكثر من ثلاثة أشخاص، حيث تخلق الحركة المستقلة لكل شخص تعارضات
مشاهد المناظر الطبيعية والطبيعة
المناظر الطبيعية غنية بصريًا بالنسبة إلى Seedance 2.5 لأنها تحتوي على طبقات حركة مستقلة متعددة: السماء والماء والأوراق والضباب الجوي. يتعامل النموذج معها بشكل مستقل ويجمعها في مقطع متماسك تتحرك فيه كل طبقة بسرعة واقعية نسبةً إلى الأخرى.
لتحريك المناظر الطبيعية، حدّد كل طبقة بوضوح في أمرك النصي:
"تنجرف السحب المنخفضة ببطء من اليمين إلى اليسار عبر حافة الجبل، وتتمايل أشجار الصنوبر في المقدمة برفق وانتظام، ويعكس سطح البحيرة ما حوله ويتموج بفعل ريح خفيفة، ويتحول ضوء الصباح الحجمي نحو الدفء قليلًا خلال 10 ثوانٍ، وميلان بطيء للكاميرا لأعلى"
ينتج هذا النوع من الأوامر متعددة الطبقات نتائج أغنى بوضوح من تعليمة من جملة واحدة. أنت في الواقع تمنح النموذج موجزًا إخراجيًا لا وصفًا لموضوع.
💡 صور الساعة الذهبية تتحرك بشكل جيد بصفة خاصة. تمنح الإضاءة الاتجاهية في صور الساعة الذهبية النموذج إشارات واضحة لحركة الظلال مع تقدّم الشمس المحاكاة خلال المقطع.
العمارة والمشاهد الحضرية
تعمل لقطات المدن والعمارة جيدًا عندما تركّز الحركة على العناصر البيئية: المشاة والمركبات والأعلام وفتحات البخار وحركة السماء. يعامل النموذج الهياكل الصلبة كنقاط مرجعية ثابتة، ويحرّك كل ما حولها وأمامها.
بالنسبة إلى العمارة، يأتي أكثر النتائج سينمائيةً من الجمع بين حركات اقتراب بطيئة على طريقة اللقطات الجوية مع حركة مشاة محيطة في المشهد:
"يدخل الناس ويخرجون من الإطار على الرصيف أسفل المبنى، وتعبر حافلة في أقصى اليسار، ويدفئ ضوء الصباح تدريجيًا واجهة الزجاج، واقتراب جوي بطيء نحو مدخل المبنى"
أنماط أوامر تعمل فعلًا
بعد تنفيذ عدد كبير من توليدات Seedance 2.5 على أنواع مختلفة من الصور، تنتج بعض بُنى الأوامر نتائج أفضل باستمرار من غيرها. هذه ليست عبارات سحرية، بل أوصاف حركة محددة تمنح النموذج قيودًا سلوكية واضحة.
ابدأ بحركة الشخص أولًا. ابدأ دائمًا بما يفعله الشخص الرئيسي. يعطي النموذج الأولوية لأول تعليمة حركة يتلقاها، وكل شيء آخر يُبنى حولها كمرساة.
ثانيًا، أضف الحركة البيئية. أضف حركة الخلفية والجو بعد الشخص. عبارات مثل "تتمايل الأشجار في الخلفية" و"تنجرف السحب فوق الرأس" تمنح النموذج أهدافًا ثانوية للتحريك تثري الحركة العامة دون أن تتنافس مع الشخص الرئيسي.
حركة الكاميرا في الأخير. ضع تعليمات الكاميرا في نهاية الأمر. يضمن ذلك أن يحسم النموذج حركة الشخص والبيئة قبل تطبيق السلوك الافتراضي للكاميرا، ما يمنع تعارض الاثنين.
حدّد الإيقاع صراحةً. تؤثر كلمات مثل ببطء و_تدريجيًا_ و_برفق_ و_بسرعة_ و_فجأة_ مباشرةً في سرعة الحركة. وبدونها، يلجأ النموذج إلى سرعة متوسطة، وهي غالبًا سريعة جدًا للمشاهد الهادئة وبطيئة جدًا لمشاهد الحركة.
بنية أمر تعمل جيدًا:
[Primary subject motion + direction] + [secondary environment motion] + [atmospheric detail] + [camera movement + pace]
💡 تجنب النفي في الأوامر. كتابة "لا تهتز الكاميرا" تميل إلى إنتاج اهتزاز. اكتب ما تريده بدلًا من ذلك: "حامل ثلاثي ثابت، وموضع كاميرا ساكن تمامًا."
نماذج أخرى لتحويل الصورة إلى فيديو تستحق الاستخدام
Wan 2.7 I2V لتفاصيل المشهد
يُعد Wan 2.7 I2V من Wan Video أقوى بديل لنموذج Seedance 2.5 من حيث الأمانة البصرية الخالصة في الناتج المتحرك. يعمل بحد أقصى 10 ثوانٍ دون صوت أصلي، لكن مستوى الحفاظ على تفاصيل السطح استثنائي. إذا كنت تعمل على صور ذات ملمس غني تضم جدرانًا حجرية أو خشبًا قديمًا أو نسيجًا معقدًا للأقمشة أو تفاصيل نباتية دقيقة، يحافظ Wan 2.7 غالبًا على هذا الملمس بأمانة أكبر من Seedance 2.5.
المفاضلة واضحة: لا صوت أصلي، ومدة قصوى أقصر، وسرعة توليد أبطأ لكل إطار. وبالنسبة إلى التصوير الساكن وتصوير المنتجات حيث تتفوق دقة التفاصيل على تعقيد الحركة، يستحق الأمر اختباره مقابل Seedance 2.5.
Kling v3 للتحكم السينمائي
يمنحك Kling v3 Video من Kwaivgi معاملات تحكم دقيقة في الكاميرا تتجاوز ما يمكن أن يصفه الأمر النصي. يمكنك تحديد مسارات كاميرا دقيقة، وتغييرات البعد البؤري، وسلوك تتبع الشخص عبر واجهة التحكم المخصصة للنموذج. وهذا يجعله الخيار الصحيح عندما تحتاج إلى لقطة سينمائية محددة جدًا لا يستطيع نظام Seedance 2.5 القائم على النص إعادة إنتاجها بثبات عبر عدة توليدات.
يدعم Kling v3 الصوت الأصلي ويولّد بدقة 1080p. وهو خيار قوي للمحتوى التجاري والعلامات التجارية حيث يكون انضباط الكاميرا والدقة التكوينية متطلبات لا تقبل المساومة.
Pixverse v5.6 للتسليم السريع
يضحّي Pixverse v5.6 ببعض الأمانة البصرية مقابل سرعة التوليد. وهو أسرع من Seedance 2.5 باستمرار، ويُنتج ناتجًا بدقة 1080p مع صوت أصلي. إذا كان سير عملك يتضمن التكرار السريع عبر أوامر كثيرة قبل اعتماد مقطع نهائي، يتيح لك Pixverse v5.6 تشغيل توليدات تجريبية أكثر في الميزانية الزمنية نفسها.
بالنسبة إلى الناتج بجودة نهائية موجّه للاستخدام الاحترافي، يُعد Seedance 2.5 النموذج الأقوى. أما للتكرار السريع واختبار الأوامر وعروض العملاء، فينافس Pixverse v5.6 بجدية في السرعة والدقة.
كيف يبدو الصوت فعليًا
سؤال شائع من صانعي المحتوى الذين يقيّمون Seedance 2.5: هل الصوت الأصلي قابل للاستخدام فعلًا، أم أنه ميزة شكلية تبدو مصطنعة عند التسليم؟
تعتمد الإجابة الصريحة بشكل كبير على نوع المشهد. إليك تفصيلًا مبنيًا على اختبارات عملية عبر فئات صور مختلفة:
| نوع المشهد | جودة الصوت | ملاحظات الإنتاج |
|---|
| الطبيعة في الهواء الطلق (ماء، رياح، أوراق) | ممتاز | ضجيج محيطي نظيف ومتوقّت جيدًا مع المرئي |
| الشارع الحضري (مرور، حشود، بناء) | جيد | تشوّهات نغمية عرضية عند الذروات |
| المساحات الداخلية (منزل، مكتب، معرض) | متوسط | بعض الهسيس الخلفي، وقابل للاستخدام |
| الموسيقى أو الكلام الصوتي | ضعيف | النموذج غير مصمم لهذا الاستخدام |
| المشاهد التجريدية أو الماكرو المتطرف | متغيّر | يولّد النموذج أحيانًا صمتًا |
بالنسبة إلى المحتوى الذي يذهب مباشرة إلى منصات التواصل، يعمل الصوت المحيطي جيدًا دون معالجة لاحقة في معظم سيناريوهات الهواء الطلق والطبيعة. أما أي محتوى له متطلبات صارمة لجودة الصوت، مثل البث أو التسليم التجاري أو المحتوى المتزامن مع الموسيقى، فعامل صوت Seedance 2.5 كمسار مرجعي واستبدله في مرحلة ما بعد الإنتاج.
نماذج لغوية كبيرة داخل سير العمل
يستحق الأمر الإشارة إلى أن Seedance 2.5 يستخدم داخليًا مكونات نموذج لغوي كبير لتفسير الأوامر. دمجت ByteDance محلل أوامر قائمًا على نموذج لغوي يقرأ وصف حركتك ويحوّله إلى توكنات حركة قبل أن تبدأ عملية الانتشار. ولهذا يستجيب Seedance 2.5 أفضل بكثير للأوصاف باللغة الطبيعية من الأوامر بأسلوب الكلمات المفتاحية التي كانت تحتاجها نماذج انتشار الفيديو القديمة.
على PicassoIA، يمكنك أيضًا إقران Seedance 2.5 بأدوات النماذج اللغوية الخاصة بالمنصة لكتابة الأوامر النصية الخاصة بالحركة وتحسينها قبل التوليد. استخدم نموذجًا لغويًا لصياغة وصف الحركة انطلاقًا من موجزك الإبداعي، ثم الصق الناتج مباشرة في Seedance 2.5. تقلل هذه الطريقة ذات الخطوتين بشكل كبير عدد توليدات الاختبار اللازمة للوصول إلى نتيجة مرضية، وهذا يترجم مباشرة إلى استهلاك أقل للنقاط في المقاطع الأطول والأغلى.
💡 النماذج اللغوية الكبيرة (LLM) كتّاب أوامر نصية. إذا لم تكن متأكدًا من كيفية وصف الحركة التي تريدها، فالصق وصفًا لصورتك وهدفك الإبداعي في نموذج لغوي واطلب منه كتابة أمر نصي للحركة بأسلوب Seedance. غالبًا ما يحتاج الناتج إلى تعديل طفيف فقط قبل أن يصبح جاهزًا للتوليد.
ابدأ بتوليد أول مقطع لك
أفضل طريقة لمعايرة توقعاتك هي تشغيل ثلاثة توليدات اختبارية بالصورة نفسها: واحد بأمر من جملة واحدة بسيطة، وواحد بأمر متعدد الطبقات كامل يتبع البنية الواردة في هذا المقال، وواحد تترك فيه النموذجَ يولّد بلا أي أمر. يُظهر فارق الجودة عبر هذه التشغيلات الثلاثة مقدار قيمة هندسة الأوامر لنوع صورتك تحديدًا، قبل أن تستثمر وقتًا في توليدات أطول أو أكثر تعقيدًا.
كلٌّ من Seedance 2.5 وSeedance 2.5 Lite المجانية متاحان الآن على PicassoIA. لا إعداد، ولا مفاتيح API، ولا إدارة قائمة انتظار من جهتك. ارفع صورة فوتوغرافية لديك بالفعل، واكتب أمر حركة باستخدام البنية الواردة أعلاه، ثم وَلِّد المقطع. تمنحك هذه النتيجة الأولى، حتى لو كانت غير مثالية، أساسًا ملموسًا تبني عليه، والتحسين لا يعدو كونه ضبط متغير واحد في كل مرة.
إذا أردت الاطلاع على المجموعة الكاملة لنماذج تحويل الصورة إلى فيديو المتاحة على المنصة قبل اعتماد Seedance 2.5، فهي موجودة كاملةً في picassoia.com/en/all-models. نماذج مثل Kling v2.6، وSeedance 1.5 Pro، وLTX 2.3 Pro لكل منها نقاط قوة مميزة بحسب نوع صورتك ومتطلبات جودتك. والاختبار عبر نموذجين أو ثلاثة بالصورة المدخلة نفسها هو أسرع طريقة لإيجاد النموذج الذي يناسب سير عملك.


