Las imágenes fijas guardan una historia congelada en un solo fotograma. Seedance 2.5 de ByteDance toma ese fotograma y lo pone en movimiento, generando hasta 30 segundos de video fluido y fotorrealista con audio nativo sincronizado a partir de cualquier fotografía que subas. Los resultados no son bucles filtrados ni simples efectos de zoom. Son animaciones de escena coherentes, en las que la luz cambia, las superficies ondulan y los sujetos se mueven de forma acorde con la física y la atmósfera de la imagen original. Si llevabas tiempo esperando un modelo de imagen a video que de verdad respete la calidad de tu fotografía, este es el que merece tu atención.
Qué hace realmente Seedance 2.5
De la foto al video en segundos
La mayoría de las herramientas de imagen a video aplican un patrón de movimiento genérico a cualquier imagen que subas. Seedance 2.5 hace algo fundamentalmente distinto: construye un modelo temporal de tu imagen, infiriendo la profundidad, la dirección de la luz y el tipo de superficie antes de generar un solo fotograma de video. El resultado es un movimiento que parece propio de la escena, en lugar de pegado encima.
ByteDance diseñó este modelo con varios objetivos técnicos: coherencia temporal en clips largos, un movimiento físicamente plausible para distintos tipos de superficie, como agua, tela, hierba o neblina atmosférica, y una generación de audio que responde al contenido visual en lugar de funcionar como una pista independiente.
En esencia, Seedance 2.5 es un transformer de difusión que opera en el espacio latente del video. Se condiciona con la imagen de entrada y un prompt de movimiento, y después refina el video latente de forma iterativa hasta que el resultado coincide tanto con el contenido visual como con el movimiento descrito. El modelo se ha entrenado con una amplia variedad de estilos de fotografía del mundo real, por eso maneja imágenes de entrada heterogéneas sin los pasos de preprocesado rígidos que requerían los modelos anteriores.

Audio nativo en cada clip
Una de las novedades más importantes de Seedance 2.5 es la generación de audio nativo. Modelos anteriores como Seedance 2.0 producían solo video, dejando el audio como un paso aparte del flujo de trabajo que exigía silencio o una pasada de doblaje manual. Seedance 2.5 genera sonido ambiental sincronizado y efectos de Foley junto a los fotogramas del video.
Si tu imagen de entrada muestra una cascada, en la pista de audio oirás el estruendo del agua. Una escena de calle concurrida genera el ambiente del tráfico. El viento en la hierba alta, la lluvia en las ventanas, el murmullo de la multitud, el crepitar del fuego: el modelo infiere el sonido adecuado a partir del contexto visual y de la descripción de tu prompt.
Esto importa a los creadores porque reúne en una sola pasada de generación lo que antes era un flujo de trabajo de dos herramientas. La calidad del audio no es de nivel de emisión, pero para contenido en redes sociales, presentaciones y proyectos creativos, resulta siempre utilizable tal cual sale.

Opciones de duración y resolución
Seedance 2.5 admite clips de entre 5 y 30 segundos en una sola pasada de generación. En PicassoIA, la relación de aspecto se ajusta por defecto a la de la imagen de entrada, lo que significa que tu composición original se conserva sin recortes forzados ni reencuadres. Un retrato vertical sigue siendo vertical. Un paisaje panorámico sigue siendo panorámico.
La versión gratuita, Seedance 2.5 Lite, genera clips de hasta 10 segundos, lo que cubre la mayoría de los casos de uso en redes sociales. El Seedance 2.5 completo amplía el límite a 30 segundos, pensado para contenido de formato más largo, como tráileres, videos de marca y bucles ambientales.
Cómo se compara Seedance 2.5 con otros modelos

Antes de decidirte por un solo modelo para un proyecto, conviene saber exactamente dónde se sitúa Seedance 2.5 frente a las alternativas. La tabla siguiente recoge los principales modelos de imagen a video disponibles en PicassoIA según las dimensiones más importantes para el trabajo de producción.
💡 La duración es un diferenciador real. Si tu flujo de trabajo requiere clips de más de 10 segundos a partir de una sola imagen, Seedance 2.5 es actualmente uno de los pocos modelos que puede entregarlos sin unir varios clips.
Cómo usar Seedance 2.5 en PicassoIA
PicassoIA aloja tanto el Seedance 2.5 completo como el Seedance 2.5 Lite gratuito. La interfaz es la misma en ambos, con la única diferencia del rango de duración disponible. No necesitas clave de API, ni instalación local, ni gestionar colas por tu cuenta.
Paso 1: sube tu imagen

Ve a la página del modelo Seedance 2.5 en PicassoIA y haz clic en la zona de subida de imágenes. El modelo acepta archivos JPEG, PNG y WebP. Para obtener mejores resultados, sube imágenes de al menos 1024 píxeles en el lado corto. El modelo usa la resolución completa como entrada de condicionamiento, y las subidas de baja resolución producen un movimiento notablemente más difuso y menos detalle de textura en la salida.
La relación de aspecto importa desde este primer paso. Si subes un retrato vertical en 9:16, el video de salida será vertical. Un paisaje panorámico en 16:9 sigue siendo panorámico. El modelo no reencuadra ni recorta tu imagen, así que compón tu fotografía pensando en el formato final del video antes de subirla.
Paso 2: escribe un prompt de movimiento

El prompt de movimiento no es una descripción de tu imagen. El modelo ya ve la imagen. El prompt describe qué se mueve y cómo. Esta es la distinción más importante que debes entender al trabajar con Seedance 2.5.
Prompt débil: "una mujer de pie en un campo de flores con montañas al fondo"
Prompt eficaz: "la mujer gira la cabeza despacio hacia la izquierda, la hierba alta se mece con una brisa suave de izquierda a derecha, las montañas lejanas tiemblan levemente en la neblina de calor de la tarde, un suave travelling hacia atrás"
El modelo lee tus instrucciones de movimiento y las aplica a la física que ha inferido de la imagen. Cuanto más específica sea tu descripción del movimiento, más controlado será el resultado. Los prompts vagos dan al modelo demasiada libertad, y el resultado suele ser plausible pero no lo que pretendías.
💡 Mantén sencillas las instrucciones de cámara. Un solo movimiento de cámara por clip (acercamiento, paneo a la izquierda, inclinación hacia arriba) produce resultados más limpios que apilar varios movimientos a la vez.
Paso 3: ajusta la duración y genera
Selecciona la duración deseada con el control deslizante. En el Seedance 2.5 Lite gratuito, el máximo es de 10 segundos. En el modelo completo, puedes ampliar hasta 30 segundos. Los clips más largos tardan proporcionalmente más en generarse, normalmente entre 60 y 120 segundos de procesamiento para un clip de salida de 30 segundos.
Haz clic en Generar y el modelo empieza a procesar. PicassoIA ejecuta la predicción de forma asíncrona y muestra un indicador de progreso en vivo. Cuando termina, aparece el reproductor de video en línea, con la pista de video y la de audio listas para previsualizarse directamente en el navegador.
Paso 4: descarga o comparte
Cuando el clip esté listo, descarga el MP4 directamente desde la interfaz. PicassoIA también te ofrece una URL para compartir el video generado. Si necesitas conservar el clip de forma permanente, descárgalo justo después de generarlo en lugar de depender del enlace para compartir.
Las mejores imágenes para Seedance 2.5
Retrato y fotografía de moda
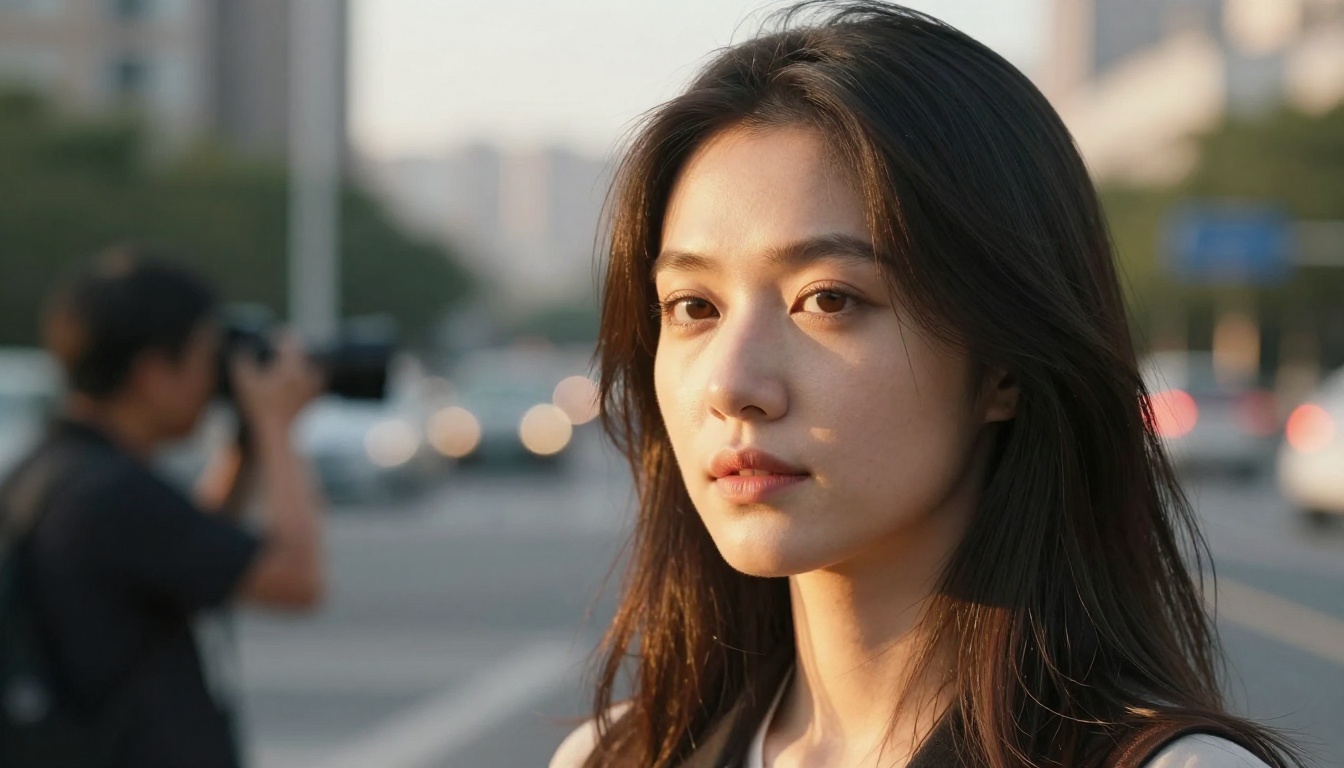
Las fotografías de retrato son el terreno en el que Seedance 2.5 muestra sus mejores resultados. El modelo se ha entrenado con un amplio corpus de datos de movimiento humano, lo que le permite manejar el movimiento facial sutil, la física del cabello y la dinámica de la ropa con una precisión que los modelos anteriores siempre fallaban.
Lo que funciona bien:
- Retratos naturales al aire libre con luz direccional clara
- Imágenes de moda con tela de textura visible y caída natural
- Retratos ambientales en los que el fondo tiene potencial de movimiento natural (árboles, agua, cielo abierto)
- Retratos en primer plano en los que las microexpresiones y el movimiento del cabello son el objetivo principal de la animación
Lo que suele dar problemas:
- Retratos en estudio con fondo blanco puro, donde el entorno no ofrece nada que animar
- Imágenes muy retocadas con texturas de piel artificiales a las que el modelo no puede asignar una física realista
- Fotos de grupo densas con más de tres personas, donde el movimiento independiente de cada sujeto genera conflictos
Paisajes y escenas naturales
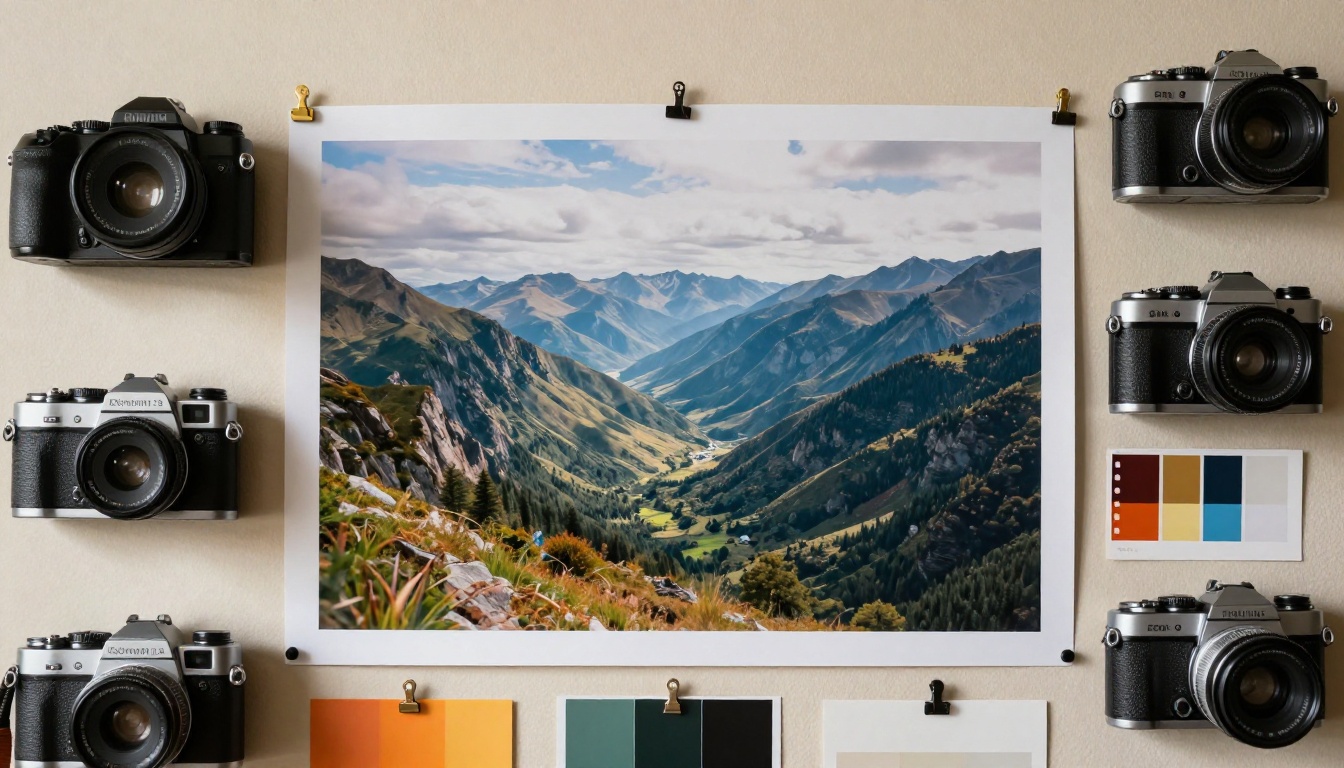
Los paisajes naturales son muy ricos visualmente para Seedance 2.5, porque contienen varias capas de movimiento independientes: cielo, agua, follaje, neblina atmosférica. El modelo maneja estas capas por separado y las compone en un clip coherente en el que cada una se mueve a una velocidad realista respecto a las demás.
Para animar un paisaje, especifica cada capa de forma explícita en tu prompt:
"Nubes bajas derivan despacio de derecha a izquierda sobre la cresta de la montaña, los pinos del primer plano se mecen suavemente al ritmo del viento, la superficie del lago refleja y ondula con una brisa ligera, la luz volumétrica de la mañana se vuelve un poco más cálida a lo largo de 10 segundos, una lenta inclinación de cámara hacia arriba"
Este tipo de prompt por capas produce resultados notablemente más ricos que una instrucción de una sola frase. En esencia, le estás dando al modelo un guion de dirección en lugar de una descripción del sujeto.
💡 Las imágenes de hora dorada se animan especialmente bien. La luz direccional de las fotos de hora dorada le da al modelo pistas claras para el movimiento de las sombras a medida que el sol simulado avanza a lo largo del clip.
Arquitectura y escenas urbanas
Las tomas de ciudad y arquitectura funcionan bien cuando centras el movimiento en los elementos del entorno: peatones, vehículos, banderas, rejillas de vapor y el movimiento del cielo. El modelo trata las estructuras sólidas como puntos de referencia fijos y anima todo lo que las rodea y se sitúa delante de ellas.
En arquitectura, la salida más cinematográfica surge de combinar movimientos lentos de travelling de estilo aéreo con movimiento ambiental de peatones en la escena:
"Peatones entran y salen del encuadre en la acera de abajo, un autobús cruza por el extremo izquierdo, la luz de la mañana calienta poco a poco la fachada de cristal, un travelling aéreo lento hacia la entrada del edificio"
Patrones de prompt que de verdad funcionan
Tras realizar numerosas generaciones con Seedance 2.5 con distintos tipos de imagen, ciertas estructuras de prompt producen resultados sistemáticamente mejores que otras. No son frases mágicas. Son descripciones de movimiento concretas que dan al modelo límites de comportamiento claros.
Primero, el movimiento del sujeto. Empieza siempre por lo que hace el sujeto principal. El modelo prioriza la primera instrucción de movimiento que recibe, y todo lo demás se construye alrededor de ese ancla.
En segundo lugar, el movimiento del entorno. Añade el movimiento del fondo y de la atmósfera después del sujeto. Frases como "los árboles se mecen al fondo" y "las nubes derivan sobre nosotros" dan al modelo objetivos de animación secundarios que enriquecen el movimiento general sin competir con el sujeto principal.
La cámara, al final. Coloca las instrucciones de cámara al final del prompt. Así el modelo resuelve primero el movimiento del sujeto y del entorno antes de aplicar el comportamiento de la cámara virtual, lo que evita que ambos entren en conflicto.
Indica el ritmo de forma explícita. Palabras como despacio, gradualmente, suavemente, rápidamente y bruscamente influyen directamente en la velocidad de la animación. Sin ellas, el modelo usa una velocidad moderada, que suele ser demasiado rápida para escenas sutiles y demasiado lenta para secuencias de acción.
Estructura de prompt que funciona:
[Primary subject motion + direction] + [secondary environment motion] + [atmospheric detail] + [camera movement + pace]
💡 Evita las negaciones en los prompts. Escribir "no sacudas la cámara" tiende a producir temblor. Escribe lo que quieres en su lugar: "trípode fijo, posición de cámara completamente quieta".
Otros modelos de imagen a video que vale la pena usar
Wan 2.7 I2V para el detalle de la escena
Wan 2.7 I2V de Wan Video es la alternativa más sólida a Seedance 2.5 en fidelidad visual pura del resultado animado. Genera hasta 10 segundos sin audio nativo, pero la conservación del detalle de superficie es excepcional. Si trabajas con fotografías muy texturizadas, con muros de piedra, madera envejecida, tejidos intrincados o detalles botánicos finos, Wan 2.7 suele conservar esa textura con más fidelidad que Seedance 2.5.
La contrapartida es clara: sin audio nativo, duración máxima más corta y generación más lenta por fotograma. Para la fotografía de bodegón y de producto, donde la fidelidad del detalle pesa más que la complejidad del movimiento, merece la pena probarlo frente a Seedance 2.5.
Kling v3 para el control cinematográfico
Kling v3 Video de Kwaivgi ofrece parámetros de control de cámara más precisos de lo que un prompt de texto puede describir. Puedes especificar trayectorias de cámara exactas, cambios de distancia focal y el comportamiento de seguimiento del sujeto a través de la interfaz de control dedicada del modelo. Esto lo convierte en la opción adecuada cuando necesitas un plano cinematográfico muy concreto que el sistema de Seedance 2.5 basado en texto no puede reproducir de forma fiable en varias generaciones.
Kling v3 admite audio nativo y genera en 1080p. Es una opción sólida para contenido comercial y de marca en el que la precisión de la cámara y de la composición son requisitos innegociables.
Pixverse v5.6 para una entrega rápida
Pixverse v5.6 sacrifica algo de fidelidad visual a cambio de velocidad de generación. Es siempre más rápido que Seedance 2.5 y produce salida en 1080p con audio nativo. Si tu flujo de trabajo implica iterar rápido con muchos prompts antes de decidir un clip final, Pixverse v5.6 te permite hacer más generaciones de prueba en el mismo tiempo.
Para una salida de calidad final destinada a uso profesional, Seedance 2.5 es el modelo más sólido. Para iterar rápido, probar prompts y enseñar previsualizaciones a clientes, Pixverse v5.6 compite en serio en velocidad y resolución.
Cómo suena realmente el audio
Una pregunta habitual de los creadores que evalúan Seedance 2.5: ¿el audio nativo es realmente utilizable o es una función de novedad que suena artificial en la entrega?
La respuesta honesta depende mucho del tipo de escena. Este es un desglose basado en pruebas prácticas con distintas categorías de imagen:
| Tipo de escena | Calidad de audio | Notas de producción |
|---|
| Naturaleza al aire libre (agua, viento, follaje) | Excelente | Ambiente limpio, bien sincronizado con lo visual |
| Calle urbana (tráfico, multitud, obras) | Buena | Algún artefacto tonal ocasional en los picos |
| Espacios interiores (hogar, oficina, galería) | Moderada | Algo de siseo de fondo, utilizable |
| Música o voz hablada | Mala | El modelo no está diseñado para este caso de uso |
| Abstractos o macro extremo | Variable | El modelo a veces genera silencio |
Para contenido que va directamente a redes sociales, el audio ambiental funciona bien sin posprocesado en la mayoría de los escenarios al aire libre y de naturaleza. Para cualquier cosa con requisitos estrictos de calidad de audio, como emisión, entrega comercial o contenido sincronizado con música, trata el audio de Seedance 2.5 como una pista de referencia y reemplázala en la posproducción.
LLM dentro del flujo de trabajo
Vale la pena señalar que Seedance 2.5 utiliza internamente componentes de modelo de lenguaje para interpretar los prompts. ByteDance integró un analizador de prompts basado en LLM que lee tu descripción de movimiento y la asigna a tokens de movimiento antes de que comience el proceso de difusión. Por eso Seedance 2.5 responde mucho mejor a las descripciones en lenguaje natural que a los prompts de palabras clave que requerían los modelos de difusión de video anteriores.
En PicassoIA también puedes combinar Seedance 2.5 con las herramientas de LLM de la plataforma para redactar y pulir tus prompts de movimiento antes de generar. Usa un modelo de lenguaje para escribir un borrador de la descripción de movimiento a partir de tu brief creativo y pega después el resultado directamente en Seedance 2.5. Este enfoque en dos pasos reduce de forma notable el número de generaciones de prueba necesarias antes de llegar a un resultado satisfactorio, lo que se traduce directamente en un menor consumo de créditos en clips más largos y costosos.
💡 Los LLM son redactores de prompts. Si no sabes cómo describir el movimiento que quieres, pega en un modelo de lenguaje una descripción de tu imagen y tu objetivo creativo, y pídele que escriba un prompt de movimiento al estilo de Seedance. Normalmente el resultado solo necesita pequeños ajustes antes de estar listo para generar.
Empieza a generar tu primer clip
La mejor forma de calibrar las expectativas es hacer tres generaciones de prueba con la misma imagen: una con un prompt mínimo de una sola frase, otra con un prompt por capas completo siguiendo la estructura de este artículo, y otra en la que dejes que el modelo genere sin ningún prompt. La diferencia de calidad entre estas tres pruebas te muestra exactamente cuánto aporta la ingeniería de prompts para tu tipo de imagen concreto, antes de invertir tiempo en generaciones más largas o complejas.
Tanto Seedance 2.5 como el Seedance 2.5 Lite gratuito están disponibles ahora en PicassoIA. Sin configuración, sin claves de API y sin gestionar colas por tu cuenta. Sube una fotografía que ya tengas, escribe un prompt de movimiento con la estructura descrita arriba y genera el clip. Ese primer resultado, aunque sea imperfecto, te da una base concreta para mejorar, y mejorarlo consiste en ajustar una variable cada vez.
Si quieres ver toda la gama de modelos de imagen a video disponibles en la plataforma antes de decidirte por Seedance 2.5, la colección completa está en picassoia.com/en/all-models. Modelos como Kling v2.6, Seedance 1.5 Pro y LTX 2.3 Pro tienen cada uno puntos fuertes distintos según el tipo de imagen y los requisitos de calidad. Probar dos o tres modelos con la misma imagen de entrada es la forma más rápida de encontrar el que encaja en tu flujo de trabajo.


