Une image fixe porte une histoire figée dans un seul cadre. Seedance 2.5 de ByteDance prend ce cadre et le met en mouvement, pour produire jusqu’à 30 secondes de vidéo fluide et photoréaliste, avec un audio natif synchronisé, à partir de n’importe quelle photographie que vous importez. Les résultats ne sont pas des boucles filtrées ni de simples effets de zoom. Ce sont des animations de scène cohérentes, où la lumière change, les surfaces ondulent et les sujets bougent d’une manière qui respecte la physique et l’atmosphère de l’image d’origine. Si vous attendiez un modèle d’image vers vidéo qui respecte vraiment la qualité de vos photos, c’est celui qui mérite votre attention.
Ce que fait réellement Seedance 2.5
De la photo à la vidéo en quelques secondes
La plupart des outils d’image vers vidéo appliquent un schéma de mouvement générique à n’importe quelle image importée. Seedance 2.5 fait quelque chose de fondamentalement différent : il construit un modèle temporel de votre image, en déduisant la profondeur, la direction de la lumière et le type de surface avant de générer la moindre image vidéo. Le résultat est un mouvement qui paraît naturel dans la scène, au lieu d’être plaqué par-dessus.
ByteDance a conçu ce modèle avec plusieurs objectifs techniques : une cohérence temporelle sur les clips longs, des mouvements physiquement plausibles pour différents types de surfaces, dont l’eau, le tissu, l’herbe et la brume atmosphérique, et une génération audio qui réagit au contenu visuel au lieu de fonctionner comme une piste indépendante séparée.
Au fond, Seedance 2.5 est un transformer de diffusion qui opère dans l’espace latent vidéo. Il s’appuie sur l’image d’entrée et sur un prompt de mouvement, puis affine itérativement la vidéo latente jusqu’à ce que le résultat corresponde à la fois au contenu visuel et au mouvement décrit. Le modèle a été entraîné sur un large éventail de styles de photographie réelle, ce qui lui permet de traiter des images d’entrée hétérogènes sans les étapes de prétraitement rigides que nécessitaient les anciens modèles.

Un audio natif dans chaque clip
L’un des ajouts les plus importants de Seedance 2.5 est la génération audio native. Les modèles précédents comme Seedance 2.0 ne produisaient que de la vidéo, et l’audio restait une étape séparée du flux de travail, qui se résumait soit à laisser la vidéo muette, soit à un doublage manuel. Seedance 2.5 génère en même temps que les images vidéo un son d’ambiance et des bruitages synchronisés.
Si votre image d’entrée montre une cascade, vous obtenez le grondement de l’eau dans la piste audio. Une rue animée génère l’ambiance de la circulation. Le vent dans les hautes herbes, la pluie sur les vitres, le murmure de la foule, le crépitement d’un feu : le modèle déduit le son approprié à partir du contexte visuel et de la description de votre prompt.
Cela compte pour les créateurs, car cela réduit à une seule passe de génération ce qui était auparavant un flux de travail à deux outils. La qualité audio n’est pas de niveau broadcast, mais pour les contenus sociaux, les présentations et les projets créatifs, elle reste systématiquement utilisable telle quelle.

Options de durée et de résolution
Seedance 2.5 prend en charge des clips de 5 secondes à 30 secondes en une seule passe de génération. Sur PicassoIA, le format est par défaut celui de l’image d’entrée, ce qui signifie que votre composition d’origine est préservée sans recadrage forcé ni modification du cadrage. Un portrait vertical reste vertical. Un paysage panoramique reste panoramique.
La version gratuite, Seedance 2.5 Lite, génère des clips allant jusqu’à 10 secondes, ce qui couvre la plupart des usages sur les réseaux sociaux. La version complète Seedance 2.5 s’étend jusqu’à 30 secondes pour les contenus plus longs comme les bandes-annonces, les vidéos de marque et les boucles d’ambiance.
Comparaison de Seedance 2.5 avec d’autres modèles

Avant de vous engager sur un seul modèle pour un projet, il est utile de savoir précisément où se situe Seedance 2.5 face aux alternatives. Le tableau ci-dessous couvre les principaux modèles d’image vers vidéo disponibles sur PicassoIA, selon les critères les plus importants pour un travail de production.
💡 La durée est un véritable facteur de différenciation. Si votre flux de travail exige des clips de plus de 10 secondes à partir d’une seule image, Seedance 2.5 est actuellement l’un des rares modèles capables de le faire sans assembler plusieurs clips.
PicassoIA héberge à la fois la version complète Seedance 2.5 et la version gratuite Seedance 2.5 Lite. L’interface est la même pour les deux, la seule différence étant la plage de durée disponible. Pas de clé API, pas d’installation locale et pas de gestion de file d’attente de votre côté.
Étape 1 : importez votre image

Rendez-vous sur la page du modèle Seedance 2.5 sur PicassoIA et cliquez sur la zone d’import d’image. Le modèle accepte les fichiers JPEG, PNG et WebP. Pour de meilleurs résultats, importez des images dont le petit côté fait au moins 1024 pixels. Le modèle utilise la pleine résolution comme entrée de conditionnement, et les images de faible résolution produisent un mouvement nettement plus flou et une texture moins fidèle dans la sortie.
Le format compte dès cette première étape. Si vous importez un portrait vertical en 9:16, la vidéo finale sera verticale. Un paysage panoramique en 16:9 reste panoramique. Le modèle ne recadre pas et ne reconfigure pas votre image, composez donc votre photo en pensant au format vidéo final avant de l’importer.
Étape 2 : rédigez un prompt de mouvement

Le prompt de mouvement n’est pas une description de votre image. Le modèle voit déjà l’image. Le prompt décrit ce qui bouge et comment. C’est la distinction la plus importante à comprendre lorsque l’on travaille avec Seedance 2.5.
Prompt faible : « une femme debout dans un champ de fleurs avec des montagnes en arrière-plan »
Prompt efficace : « la femme tourne lentement la tête vers la gauche, de hautes herbes ondulent sous une douce brise de gauche à droite, les montagnes lointaines scintillent légèrement dans la brume de chaleur de l’après-midi, léger travelling arrière »
Le modèle lit vos instructions de mouvement et les applique à la physique qu’il a déduite de l’image. Plus votre description du mouvement est précise, plus le résultat sera maîtrisé. Les prompts vagues laissent au modèle une liberté trop grande, et le résultat est souvent plausible mais pas celui que vous aviez en tête.
💡 Gardez les instructions de caméra simples. Un seul mouvement de caméra par clip (travelling avant, panoramique à gauche, inclinaison vers le haut) produit des résultats plus propres que l’empilement de plusieurs mouvements en même temps.
Étape 3 : réglez la durée et générez
Sélectionnez la durée souhaitée avec le curseur. Pour la version gratuite Seedance 2.5 Lite, la limite est de 10 secondes. Pour le modèle complet, vous pouvez aller jusqu’à 30 secondes. Les clips plus longs prennent proportionnellement plus de temps à générer, généralement entre 60 et 120 secondes de traitement pour un clip de sortie de 30 secondes.
Cliquez sur Générer et le modèle commence le traitement. PicassoIA exécute la prédiction de façon asynchrone et affiche un indicateur de progression en direct. Une fois terminée, le lecteur vidéo apparaît directement dans la page, avec la piste vidéo et la piste audio prêtes à être prévisualisées dans le navigateur.
Étape 4 : téléchargez ou partagez
Une fois le clip prêt, téléchargez le MP4 directement depuis l’interface. PicassoIA vous fournit aussi une URL de partage pour la vidéo générée. Si vous voulez conserver le clip de façon permanente, téléchargez-le immédiatement après la génération plutôt que de compter sur le lien de partage.
Les meilleures images pour Seedance 2.5
Photographie de portrait et de mode
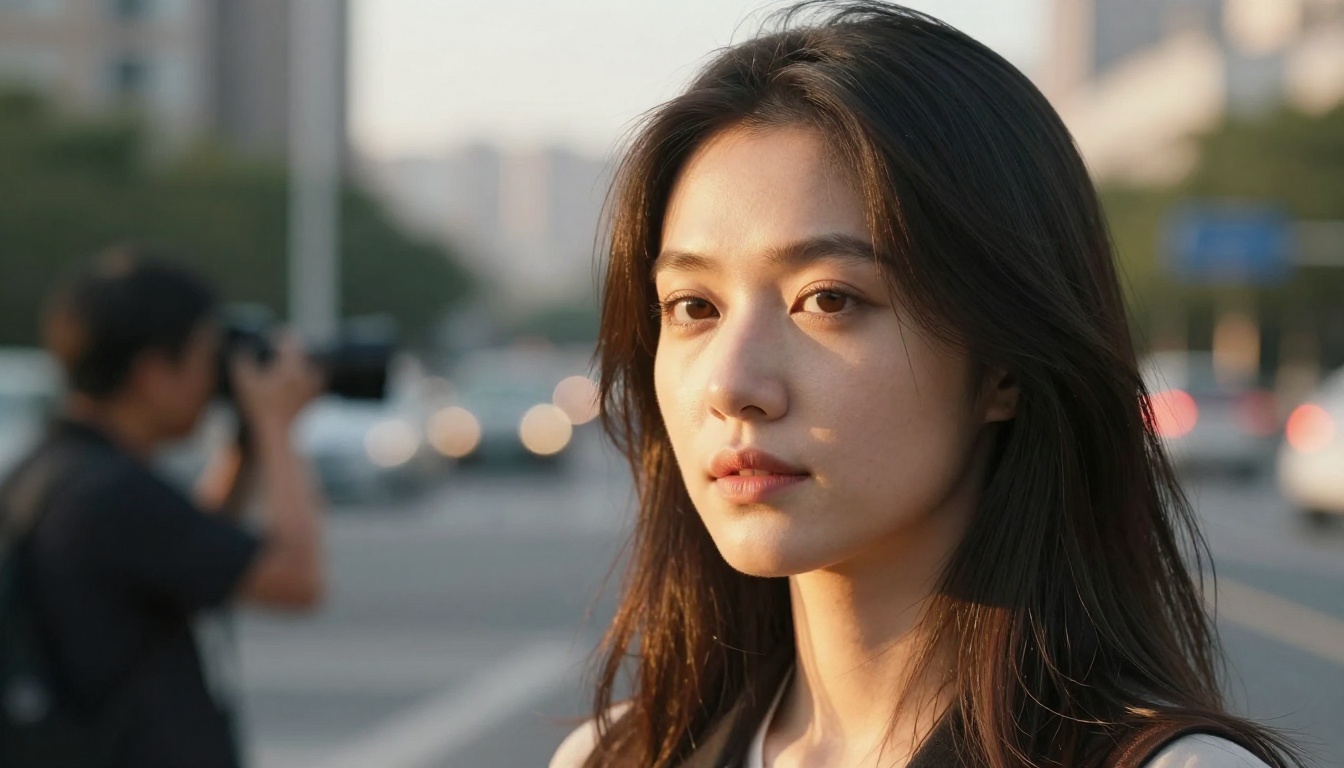
Les photographies de portrait sont le domaine où Seedance 2.5 montre ses meilleurs résultats. Le modèle a été entraîné sur un large corpus de données de mouvement humain, ce qui lui permet de gérer les mouvements subtils du visage, la physique des cheveux et la dynamique des vêtements avec une précision que les modèles précédents manquaient systématiquement.
Ce qui fonctionne bien :
- Portraits naturels en extérieur avec une lumière directionnelle nette
- Photos de mode avec un tissu présentant une texture visible et un tombé naturel
- Portraits environnementaux où l’arrière-plan contient un potentiel de mouvement naturel (arbres, eau, ciel dégagé)
- Gros plans de portrait où les micro-expressions et le mouvement des cheveux sont la cible principale de l’animation
Ce qui a tendance à poser problème :
- Portraits sur fond de studio blanc uni, où l’environnement n’offre rien à animer
- Images fortement retouchées avec des textures de peau artificielles auxquelles le modèle ne peut pas attribuer une physique réaliste
- Photos de groupe denses de plus de trois personnes, où le mouvement indépendant de chaque sujet crée des conflits
Paysages et scènes naturelles
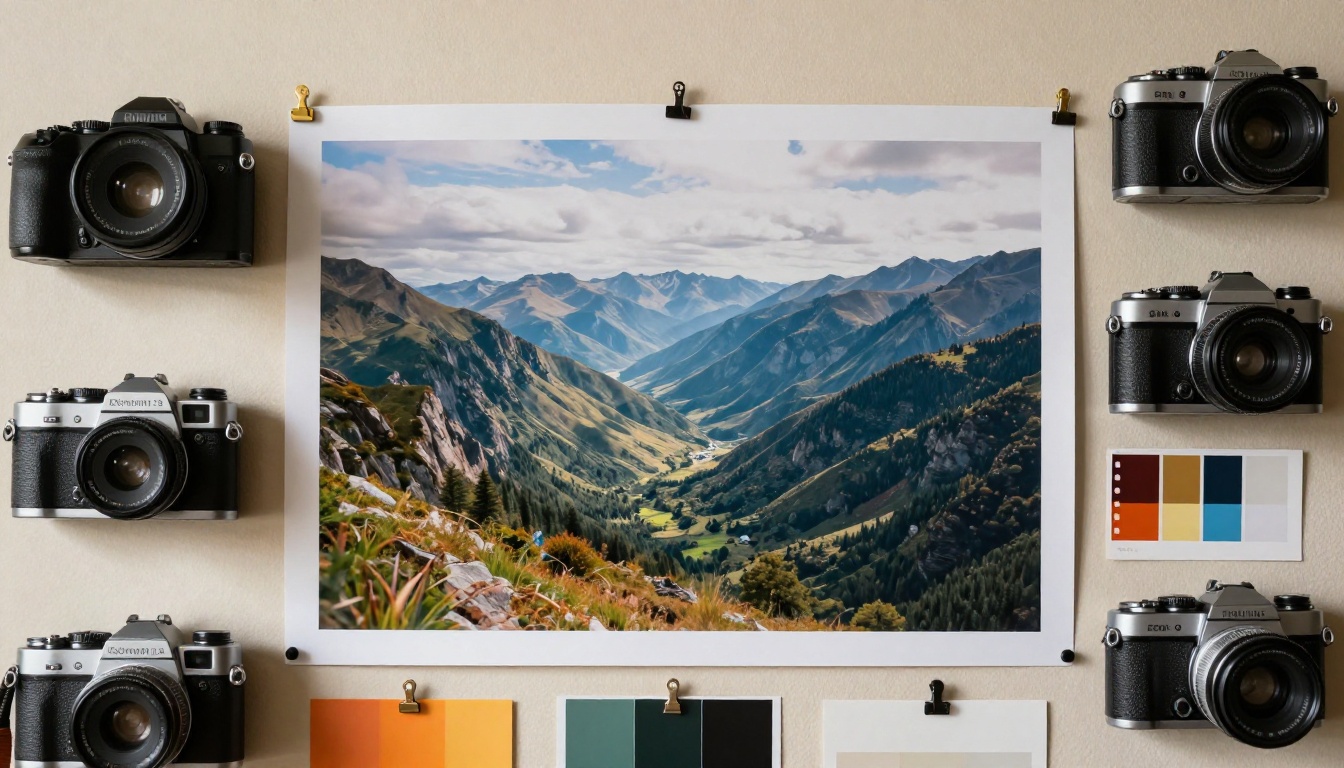
Les paysages naturels sont très riches visuellement pour Seedance 2.5, car ils contiennent plusieurs couches de mouvement indépendantes : ciel, eau, feuillage, brume atmosphérique. Le modèle traite ces couches séparément et les assemble en un clip cohérent, où chaque couche bouge à une vitesse réaliste par rapport aux autres.
Pour animer un paysage, précisez chaque couche explicitement dans votre prompt :
« Des nuages bas dérivent lentement de droite à gauche sur la crête de la montagne, les pins au premier plan se balancent doucement en rythme, la surface du lac reflète et ondule sous une légère brise, une lumière matinale volumétrique se réchauffe légèrement au fil des 10 secondes, lent mouvement d’inclinaison vers le haut »
Ce type de prompt en couches produit des résultats nettement plus riches qu’une instruction en une seule phrase. Vous donnez en réalité au modèle le brief d’un réalisateur plutôt qu’une simple description du sujet.
💡 Les images à l’heure dorée s’animent particulièrement bien. La lumière directionnelle des photos prises à l’heure dorée donne au modèle des indices clairs sur le déplacement des ombres à mesure que le soleil simulé progresse au fil du clip.
Architecture et scènes urbaines
Les prises de vue de villes et d’architecture fonctionnent bien lorsque vous concentrez le mouvement sur les éléments environnementaux : piétons, véhicules, drapeaux, bouches de vapeur et mouvement du ciel. Le modèle traite les structures solides comme des repères statiques et anime tout ce qui les entoure et se trouve devant elles.
Pour l’architecture, le résultat le plus cinématique vient de la combinaison de lents mouvements de travelling aérien avec un mouvement piéton ambiant dans la scène :
« Des piétons entrent et sortent du cadre sur le trottoir en contrebas, un bus traverse tout à gauche, la lumière matinale réchauffe progressivement la façade en verre, lent travelling aérien vers l’entrée du bâtiment »
Des schémas de prompt qui fonctionnent vraiment
Après de nombreuses générations avec Seedance 2.5 sur différents types d’images, certaines structures de prompt produisent systématiquement de meilleurs résultats que d’autres. Ce ne sont pas des formules magiques. Ce sont des descriptions de mouvement précises qui donnent au modèle des contraintes de comportement claires.
Le mouvement du sujet d’abord. Commencez toujours par ce que fait le sujet principal. Le modèle privilégie la première instruction de mouvement qu’il reçoit, et tout le reste s’organise autour de cet ancrage.
Le mouvement de l’environnement ensuite. Ajoutez le mouvement de l’arrière-plan et de l’atmosphère après celui du sujet. Des formules comme « les arbres se balancent en arrière-plan » ou « des nuages dérivent au-dessus » donnent au modèle des cibles d’animation secondaires qui enrichissent le mouvement global sans entrer en concurrence avec le sujet principal.
Le mouvement de caméra en dernier. Placez les instructions de caméra à la fin du prompt. Le modèle résout ainsi le mouvement du sujet et de l’environnement avant d’appliquer le comportement de caméra virtuelle, ce qui évite que les deux entrent en conflit.
Précisez explicitement le rythme. Des mots comme lentement, progressivement, doucement, rapidement et brusquement influencent directement la vitesse de l’animation. Sans eux, le modèle adopte une vitesse modérée, souvent trop rapide pour les scènes subtiles et trop lente pour les séquences d’action.
Une structure de prompt qui fonctionne :
[Primary subject motion + direction] + [secondary environment motion] + [atmospheric detail] + [camera movement + pace]
💡 Évitez les négations dans les prompts. Écrire « ne secoue pas la caméra » tend à produire des secousses. Décrivez plutôt ce que vous voulez : « trépied verrouillé, position de caméra totalement immobile ».
D’autres modèles d’image vers vidéo qui valent le détour
Wan 2.7 I2V pour le détail de scène
Wan 2.7 I2V de Wan Video est la meilleure alternative à Seedance 2.5 pour la fidélité visuelle pure de la sortie animée. Il génère jusqu’à 10 secondes sans audio natif, mais le niveau de préservation des détails de surface est exceptionnel. Si vous travaillez avec des photographies très texturées, présentant des murs en pierre, du bois patiné, des tissages de tissu complexes ou des détails botaniques fins, Wan 2.7 préserve souvent cette texture plus fidèlement que Seedance 2.5.
Le compromis est clair : pas d’audio natif, durée maximale plus courte et vitesse de génération plus lente par image. Pour les natures mortes et la photographie de produits, où la fidélité des détails compte plus que la complexité du mouvement, il vaut la peine d’être testé face à Seedance 2.5.
Kling v3 pour le contrôle cinématique
Kling v3 Video de Kwaivgi vous offre des paramètres de contrôle de caméra précis, au-delà de ce qu’un prompt texte peut décrire. Vous pouvez spécifier des trajectoires de caméra exactes, des changements de focale et le comportement de suivi du sujet via l’interface de contrôle dédiée du modèle. C’est le bon choix lorsque vous avez besoin d’un plan cinématique très précis que le système de Seedance 2.5 fondé sur le texte ne peut pas reproduire de façon fiable d’une génération à l’autre.
Kling v3 prend en charge l’audio natif et génère en 1080p. C’est une option solide pour les contenus commerciaux et de marque, où la rigueur de la caméra et la précision de la composition sont des exigences non négociables.
Pixverse v5.6 pour une génération rapide
Pixverse v5.6 sacrifie un peu de fidélité visuelle au profit de la vitesse de génération. Il est systématiquement plus rapide que Seedance 2.5 et produit une sortie en 1080p avec audio natif. Si votre flux de travail consiste à itérer rapidement sur de nombreux prompts avant de valider un clip final, Pixverse v5.6 vous permet de lancer davantage de générations de test dans le même laps de temps.
Pour une sortie de qualité finale destinée à un usage professionnel, Seedance 2.5 est le modèle le plus solide. Pour l’itération rapide, le test de prompts et les aperçus pour les clients, Pixverse v5.6 rivalise sérieusement en matière de vitesse et de résolution.
À quoi ressemble réellement l’audio
Une question revient souvent chez les créateurs qui évaluent Seedance 2.5 : l’audio natif est-il vraiment utilisable, ou s’agit-il d’une fonctionnalité gadget qui sonne artificiellement à la livraison ?
La réponse honnête dépend fortement du type de scène. Voici une analyse fondée sur des tests pratiques réalisés sur différentes catégories d’images :
| Type de scène | Qualité audio | Notes de production |
|---|
| Nature en extérieur (eau, vent, feuillage) | Excellente | Ambiance propre, bien synchronisée avec l’image |
| Rue urbaine (circulation, foule, chantier) | Bonne | Artefacts tonaux occasionnels sur les pics |
| Espaces intérieurs (maison, bureau, galerie) | Moyenne | Un léger souffle de fond, exploitable |
| Musique ou parole vocale | Faible | Le modèle n’est pas conçu pour cet usage |
| Abstrait ou macro extrême | Variable | Le modèle génère parfois du silence |
Pour les contenus destinés directement aux réseaux sociaux, l’audio d’ambiance se comporte bien sans post-traitement dans la plupart des scénarios en extérieur et nature. Pour tout ce qui a des exigences strictes de qualité audio (diffusion, livraison commerciale ou contenu synchronisé sur la musique), considérez l’audio de Seedance 2.5 comme une piste de référence et remplacez-la en post-production.
Les LLM au cœur du flux de travail
Il est utile de noter que Seedance 2.5 utilise lui-même en interne des composants de grand modèle de langage pour l’interprétation des prompts. ByteDance a intégré un analyseur de prompt fondé sur un LLM, qui lit votre description de mouvement et la traduit en tokens de mouvement avant que le processus de diffusion ne commence. C’est pourquoi Seedance 2.5 répond bien mieux aux descriptions en langage naturel qu’aux prompts sous forme de mots-clés qu’exigeaient les anciens modèles de diffusion vidéo.
Sur PicassoIA, vous pouvez aussi associer Seedance 2.5 aux outils LLM de la plateforme pour rédiger et affiner vos prompts de mouvement avant la génération. Utilisez un modèle de langage pour rédiger la description du mouvement à partir de votre brief créatif, puis collez le résultat directement dans Seedance 2.5. Cette approche en deux étapes réduit nettement le nombre de générations de test nécessaires avant d’obtenir un résultat satisfaisant, ce qui se traduit directement par une consommation de crédits moindre sur les clips plus longs et plus coûteux.
💡 Les LLM sont de bons rédacteurs de prompts. Si vous ne savez pas comment décrire le mouvement souhaité, collez une description de votre image et de votre objectif créatif dans un modèle de langage, puis demandez-lui de rédiger un prompt de mouvement dans le style de Seedance. Le résultat ne demande généralement que de légers ajustements avant d’être prêt pour la génération.
Lancez la génération de votre premier clip
La meilleure façon de calibrer vos attentes est de lancer trois générations de test avec la même image : une avec un prompt minimal d’une phrase, une avec un prompt en couches complet suivant la structure de cet article, et une où vous laissez le modèle générer sans aucun prompt. La différence de qualité entre ces trois essais vous montre exactement ce que vaut l’ingénierie de prompt pour votre type d’image, avant d’investir du temps dans des générations plus longues ou plus complexes.
Seedance 2.5 et la version gratuite Seedance 2.5 Lite sont tous deux disponibles dès maintenant sur PicassoIA. Pas de configuration, pas de clé API et pas de gestion de file d’attente de votre côté. Importez une photo que vous avez déjà, rédigez un prompt de mouvement en suivant la structure ci-dessus, puis générez le clip. Ce premier résultat, même imparfait, vous donne une base concrète à améliorer, et l’amélioration consiste à ajuster une variable à la fois.
Si vous voulez voir l’ensemble des modèles d’image vers vidéo disponibles sur la plateforme avant de vous engager sur Seedance 2.5, la collection complète se trouve sur picassoia.com/en/all-models. Des modèles comme Kling v2.6, Seedance 1.5 Pro et LTX 2.3 Pro ont chacun des atouts distincts selon votre type d’image et vos exigences de qualité. Tester deux ou trois modèles avec la même image d’entrée est le moyen le plus rapide de trouver celui qui convient à votre flux de travail.


