وايفو الذكاء الاصطناعي الخاصة بك لديها المظهر المثالي، والاسم المثالي، وقصة خلفية مصوغة بعناية. ثم تفتح فمها وتتكلم بصوت يشبه نظام الملاحة في السيارة وهو يقرأ إخلاء مسؤولية طبيًا. هذا الانفصال يهدم كل شيء. الصوت العاطفي ليس ميزة كمالية في عمل الشخصيات بالذكاء الاصطناعي. إنه الفرق بين شخصية تبدو حيّة وأخرى تبدو كعرض تجريبي.
يوجّه هذا المقال كلامه إلى كل من يريد إصلاح ذلك. سواء كنت تبني رفيقًا بالذكاء الاصطناعي، أو تنتج محتوى صوتيًا لرواية مرئية، أو تجرّب فقط شخصيات الأدوار، فآليات تركيب الكلام العاطفي متاحة لك الآن، والأدوات على PicassoIA تجعل استخدامها بسيطًا بشكل لافت.
لماذا تقتل الأصوات الرتيبة الانغماس
الدماغ البشري مهيّأ لقراءة الصوت كإشارة أساسية للنية والعاطفة. قبل أن نعالج الكلمات بوقت طويل، نلتقط النبرة والطبقة والإيقاع. جملة مثل "اشتقتُ إليك" تصل بشكل مختلف تمامًا إذا قيلت بنبرة صاعدة مع شيء من الأنفاس، أو قيلت بصوت مسطّح وإيقاع ثابت. الكلمات واحدة، لكن المحتوى العاطفي ليس كذلك.
مشكلة مخرجات TTS الافتراضية
معظم أنظمة تحويل النص إلى كلام الجاهزة تُحسّن من أجل الوضوح والمفهومية. وهذا هو الخيار الصحيح لتطبيقات الملاحة وقارئات الشاشة وأدوات إمكانية الوصول. لكنه الخيار الخاطئ لرفيقة بالذكاء الاصطناعي تعتمد شخصيتها كليًا على طريقة كلامها حين تكون متحمسة، أو متوترة، أو مكسورة القلب بهدوء.
تميل مخرجات TTS الافتراضية إلى المعاناة من ثلاث مشكلات محددة:
- رتابة الإيقاع الكلامي: تبقى درجة الصوت ضمن نطاق ضيق بغض النظر عن المحتوى
- إيقاع موحّد: تصل كل جملة تقريبًا بالسرعة نفسها
- غياب الوقفات الدقيقة: الكلام الطبيعي يتنفس ويتردد، أما الكلام الاصطناعي فلا يفعل ذلك
النتيجة صوت صحيح تقنيًا لكنه فارغ عاطفيًا.
ما الذي يعنيه الصوت العاطفي فعلًا
العاطفة في الكلام ليست مقبضًا واحدًا تديره نحو الأعلى. إنها مزيج من خصائص صوتية عدة تعمل معًا. حين يتكلم الشخص بحماس ترتفع درجة صوته ويتسارع إيقاعه. وحين يتكلم بحزن تنخفض درجة صوته ويبطؤ إيقاعه، وتطول الوقفات بين العبارات. أما الرقة فتتضمن نطقًا ألين للحروف الساكنة ومدى حجم صوت أضيق قليلًا.
تتعلم نماذج الصوت العاطفي الجيدة هذه الأنماط من كميات هائلة من بيانات الكلام البشري. أفضلها يتيح لك تحديد الهدف العاطفي، سواء عبر وسوم أسلوبية صريحة، أو هندسة الأوامر، أو عناصر تحكم مخصصة في المعاملات، بدلًا من إجبارك على التخمين أي مزيج من الإعدادات يحقق الإحساس الذي تريده.
العلم وراء الصوت العاطفي
فهم الآليات الكامنة وراء الكلام العاطفي يجعلك أفضل بكثير في كتابة الأوامر لنماذج TTS. تتوقف عن التخمين وتبدأ بالهندسة.
الدرجة والإيقاع والوقفات
تحمل هذه المعاملات الثلاثة الجزء الأكبر من الإشارة العاطفية في الكلام البشري. إليك ما تقوله الأبحاث عن كل فئة عاطفية:
| العاطفة | نمط الدرجة | الإيقاع | الوقفات |
|---|
| الفرح / الحماس | مرتفعة، نطاق واسع | سريع | قصيرة، حيوية |
| الحزن | منخفضة، نطاق ضيق | بطيء | طويلة، متكررة |
| الغضب | مرتفعة، ارتفاعات حادة | سريع | قليلة جدًا |
| الرقة | متوسطة إلى منخفضة، ناعمة | بطيء إلى معتدل | ناعمة، مقصودة |
| المفاجأة | قفزة مفاجئة في الدرجة | متغيّر | صمت قصير قبلها |
| التوتر | مرتفعة قليلًا | غير منتظم | مملوءة بأصوات التنفس |
حين تكتب أمرًا نصيًا لنموذج TTS عاطفي، فأنت عمليًا تطلب منه تطبيق النمط الصحيح من هذا الجدول. كلما فهم النموذج تنوع الكلام الطبيعي بشكل أفضل، نفّذه بإقناع أكبر.
التحكم في الإيقاع الكلامي مقابل الوسوم الأسلوبية
هناك طريقتان رئيسيتان تستخدمهما أنظمة TTS الحديثة للتعامل مع العاطفة:
الوسوم الأسلوبية تعليمات صريحة مضمّنة في الأمر النصي، مثل [joyful] أو [sad] أو [whispering]. بعض النماذج تقرأ هذه الوسوم داخل النص وتعدّل مخرجاتها وفقها. استخدامها سريع، لكنها قد تبدو آلية إن أُفرط فيها.
التحكم في الإيقاع الكلامي هو النهج الأكثر تطورًا، حيث يعالج النموذج الإشارات العاطفية من اللغة الطبيعية للأمر نفسه، ويعدّل الدرجة والإيقاع والشدة بشكل عضوي. النماذج المدرّبة على هذا النهج تميل إلى إنتاج مخرجات أكثر طبيعية، لأن العاطفة تنبثق من المحتوى بدلًا من أن تُلصق عليه.
أفضل النتائج تأتي من الجمع بين الطريقتين: اكتب حوارًا يحمل عاطفة بشكل طبيعي، ثم حدّد الحالة العاطفية في معاملات التوليد.
أفضل نماذج TTS لأصوات الوايفو العاطفية
تستضيف PicassoIA مجموعة قوية من نماذج تحويل النص إلى كلام، وليست كلها مناسبة بالتساوي لعمل الشخصيات العاطفية. إليك النماذج التي تقدم النتائج فعلًا.
Chatterbox من Resemble AI
Chatterbox صُمم خصيصًا للتحكم في العاطفة. وهو الخيار البارز لعمل صوت وايفو الذكاء الاصطناعي تحديدًا، لأنه يمنحك أدوات مباشرة للتحكم في شدة العاطفة، وليس فقط في أسلوب الصوت. يمكنك استنساخ صوت مرجعي من عينة صوتية قصيرة، ثم تطبيق تنويعات عاطفية على ذلك الصوت المستنسخ، ما يعني أن صوت شخصيتك يبقى ثابتًا بينما يتغير سجلها العاطفي بسلاسة بين المشاهد.
إذا كنت تحتاج إلى السرعة دون التضحية بالجودة، فإن Chatterbox Turbo يقدم مخرجات أسرع مع تراجع طفيف جدًا في التعبيرية. أما للجودة الإنتاجية مع أقصى قدر من الفروق العاطفية، فإن Chatterbox Pro يستحق الترقية.
💡 نصيحة: زوّد Chatterbox بعينة صوتية من 15 إلى 30 ثانية لممثل صوت يقرأ مقطعًا محايدًا عاطفيًا. هذا يمنح النموذج أساسًا نظيفًا يعمل عليه قبل أن تضيف العاطفة فوقه.
ElevenLabs V3
ElevenLabs V3 من أكثر نماذج تحويل النص إلى كلام متعددة اللغات تعبيرية المتاحة. مخرجاته في المشاهد العاطفية بشرية بشكل ملحوظ، ويعود ذلك جزئيًا إلى أن V3 دُرّب مع اهتمام خاص بالإشارات الصوتية الدقيقة التي تميّز العاطفة الحقيقية عن العاطفة المؤداة. الفرق حقيقي ومسموع.
بالنسبة للمشاريع التي تحتاج فيها شخصيتك إلى الكلام بلغات متعددة مع الحفاظ على الاتساق العاطفي، يتعامل V3 مع نقل العاطفة بين اللغات بكفاءة. الشخصية التي تبدو دافئة ومحبة بالإنجليزية ستحمل تلك الصفة إلى مخرجات يابانية أو إسبانية.
أما للتطبيقات الفورية أو رفقاء الذكاء الاصطناعي التفاعليين حيث يهم زمن الاستجابة، فإن ElevenLabs Flash v2.5 و Turbo v2.5 يقلّصان زمن التوليد بشكل كبير مع الحفاظ على تعبيرية كافية للاستخدام الحواري.
MiniMax Speech 2.8 HD
MiniMax Speech 2.8 HD يشغل فئة الجودة الاستوديوية. قوته في الأداء الصوتي الناعم والحميمي، وهو ما يتناسب جيدًا مع السجلات الدافئة المحبّة التي تشغلها شخصيات الوايفو عادةً. يتعامل النموذج بدقة خاصة مع الكلام الهامس، والأداء المصحوب بالأنفاس، والانكسارات العاطفية في الصوت.
للتكرار الأسرع خلال مرحلة الاختبار، يتيح لك MiniMax Speech 2.8 Turbo معاينات سريعة قبل الالتزام بالتصيير الكامل بجودة HD. وإذا احتجت إلى هوية صوتية مخصصة، فإن MiniMax Voice Cloning يتيح لك بناء الصوت الأساسي أولًا.
Qwen3 TTS
Qwen3 TTS هو الخيار المفاجئ في هذه القائمة. قدراته في تصميم الصوت مرنة بشكل غير معتاد: يمكنك وصف صوت من الصفر باستخدام اللغة الطبيعية ("امرأة شابة هادئة الكلام ذات جودة هامسة قليلًا ونبرات صاعدة لطيفة")، وسيحاول النموذج توليد هوية الصوت تلك. بالنسبة للشخصيات التي لا تملك عينة صوتية مرجعية لكن لديك صورة ذهنية مفصلة عن طريقة كلامها، يقدم Qwen3 TTS نقطة دخول إبداعية لا تقدمها النماذج الأخرى.
كيفية استخدام Chatterbox على PicassoIA
بما أن Chatterbox هو النموذج الأنسب لهذه الحالة، إليك سير عمل خطوة بخطوة للحصول على مخرجات عاطفية منه على PicassoIA.
الخطوة 1: الوصول إلى النموذج
انتقل إلى picassoia.com/en/collection/text-to-speech/resemble-ai-chatterbox. سترى واجهة التوليد مع حقل إدخال النص وحقول اختيارية لرفع المرجع الصوتي.
الخطوة 2: اكتب حوارًا يحمل العاطفة
هذا هو الجزء الذي يتجاهله معظم الناس، ولهذا تبدو مخرجاتهم مسطّحة. لا تكتب نصًا محايدًا وتتوقع أن يحقن النموذج العاطفة فيه. اكتب حوارًا يحمل الثقل العاطفي أصلًا في اختيار كلماته وبنية جمله.
مدخل ضعيف (نص محايد، على أمل الحصول على عاطفة):
"أنا سعيد برؤيتك."
مدخل قوي (نص يحمل العاطفة في بنائه):
"يا إلهي، عدتَ فعلًا. ظللتُ أقول لنفسي إنك ستعود، لكن جزءًا مني كان خائفًا جدًا من ألا تعود."
يمنح المثال الثاني النموذج محتوى عاطفيًا حقيقيًا يعمل عليه: دهشة، وارتياح، وهشاشة، وفرح بالكاد مكبوح. ومخرجاته الصوتية ستعكس ذلك.
الخطوة 3: اضبط معامل العاطفة
يقبل Chatterbox شدة العاطفة كمدخل مباشر. ابدأ بإعداد معتدل (حوالي 0.5 إلى 0.7 على المقياس من 0 إلى 1)، ثم عدّل بحسب المشهد. اللحظات الدرامية المكثفة تستدعي شدة أعلى. أما اللحظات الهادئة الحميمة فغالبًا ما تبدو أفضل عند شدات أقل، حيث تكون العاطفة ضمنية لا معلنة.
الخطوة 4: ارفع مرجعًا صوتيًا (اختياري لكنه موصى به)
إذا كان لديك مقطع مرجعي لصوت شخصيتك، فارفعه. حتى عينة مدتها 20 ثانية تُحدث فرقًا كبيرًا في اتساق المخرجات. يستخدمها النموذج لتثبيت الطابع الصوتي الأساسي، ثم يطبّق التنوع العاطفي فوقه.
الخطوة 5: عاين، كرّر، ثم صدّر
ولّد معاينة، واستمع بعناية عبر سماعات الرأس لا عبر مكبرات الحاسوب المحمول، ثم عدّل. التغييرات الصغيرة في بنية الجمل كثيرًا ما تنتج تحسنًا في جودة المخرجات أكبر من تعديلات المعاملات. صدّر بصيغة WAV للحفاظ على أقصى جودة في سير العمل اللاحق.
دمج الصوت مع مزامنة الشفاه
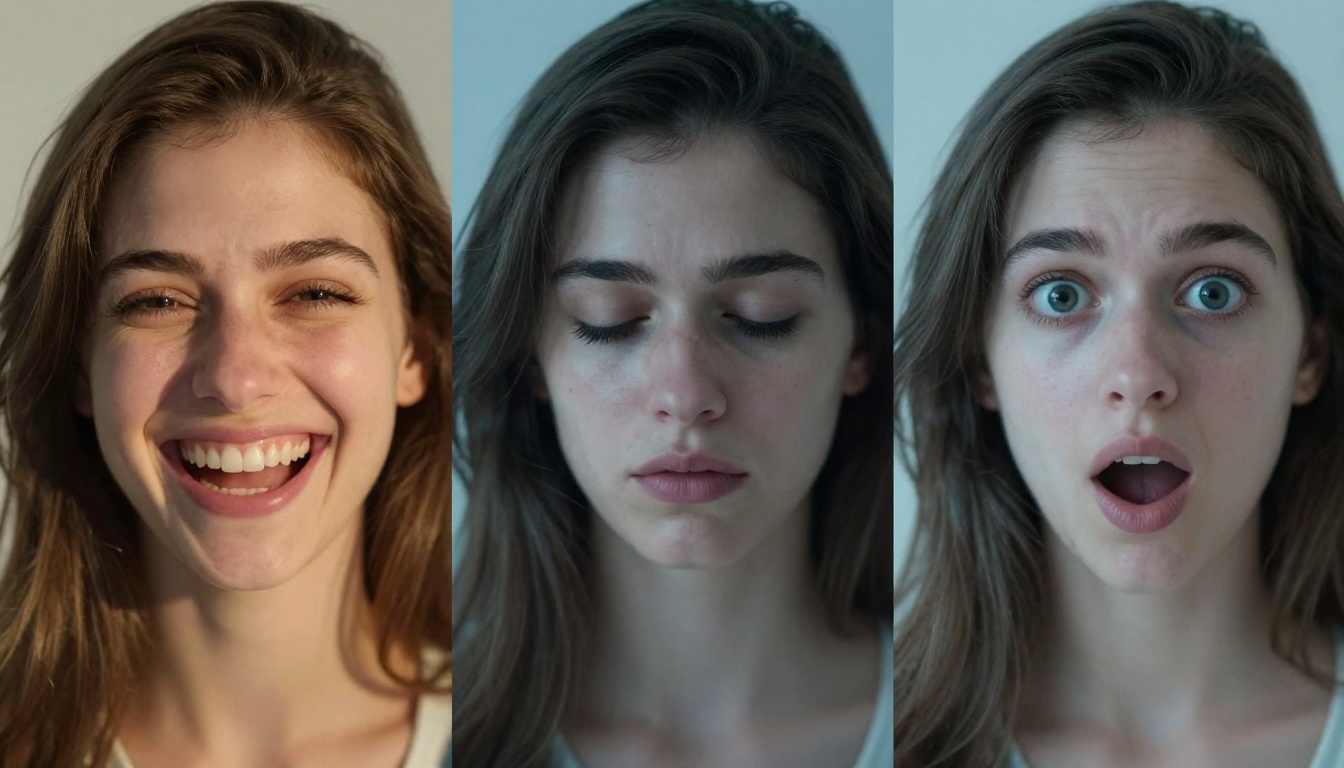
الصوت وحده قوي. أما الصوت المتزامن مع وجه متحرك فشيء آخر تمامًا. تتيح لك أدوات مزامنة الشفاه في PicassoIA أن ترفق الصوت المولّد بصورة شخصية أو بفيديو موجود، فتنتج أفاتارًا متحدثًا يطابق المحتوى العاطفي للكلام.
Omni Human 1.5 للأفاتارات المتحدثة
ByteDance Omni Human 1.5 هو حاليًا أقوى خيار لتحريك صورة شخصية ثابتة إلى فيديو متحدث. أعطه صورة بورتريه واحدة لشخصيتك الوايفو والصوت الذي ولّدته باستخدام Chatterbox أو ElevenLabs، وسينتج فيديو تتحرك فيه الفم والوجه والجزء العلوي من الجسد بالتزامن مع الكلام.
تحترم المخرجات المحتوى العاطفي للصوت. إذا كان الصوت متحمسًا، ينتج النموذج حركة وجه أكثر حيوية. وإذا كان الصوت ناعمًا ورقيقًا، تكون الحركة أكثر تحفظًا. هذا الترابط العاطفي بين الصوت والصورة هو ما يجعل النتيجة تبدو حقيقية لا آلية.
Lipsync 2 Pro للفيديو الموجود
إذا كان لديك بالفعل فيديو لشخصيتك (من أداة أخرى لتوليد الفيديو بالذكاء الاصطناعي) وتريد استبدال الصوت أو إضافته، فإن Sync Lipsync 2 Pro هو الأداة الدقيقة لهذا السير. يكتشف منطقة الوجه في الفيديو الموجود ويعيد رسم حركات الفم لتطابق مسار الصوت الجديد.
للتطبيقات الأسرع التي لا تتطلب دقة عالية، فإن Sync Lipsync 2 وPixverse Lipsync بدائل قوية. أما HeyGen Lipsync Precision فيبرز بشكل خاص عند التعامل مع فيديو يكون فيه وجه الشخصية مخفيًا جزئيًا أو مائلًا.
استخدام النماذج اللغوية الكبيرة لكتابة نصوص عاطفية أفضل
أكبر رافعة في إخراج الصوت العاطفي هي جودة النص المدخل. الكتابة الأفضل تنتج صوتًا أفضل. تمنحك مجموعة النماذج اللغوية الكبيرة في PicassoIA أدوات قوية لصياغة حوار يمكن لأنظمة TTS أن تعمل به فعلًا.
GPT 5 لحوار الشخصيات
يتفوق GPT 5 في توليد حوار شخصيات متنوع عاطفيًا عند إعطائه وصفًا واضحًا للشخصية. صف شخصية الشخصية وحالتها العاطفية الحالية وسياق المشهد. واطلب تحديدًا حوارًا يحمل العاطفة في بنيته، لا في محتواه فقط. جودة المخرجات في عمل صوت الشخصيات قوية بشكل ملحوظ، وفهم GPT 5 للفروق الدقيقة في السجل العاطفي يجعله شريكًا إبداعيًا مفيدًا.
بالنسبة للنصوص الأطول أو المشاريع التي تتطلب أقواسًا عاطفية معقدة عبر مشاهد متعددة، فإن GPT 5 Pro يضيف قدرة استدلال أعمق تساعد على الحفاظ على اتساق الشخصية عبر حجم كبير من الحوار.
Claude 4 Sonnet للكتابة الدقيقة
يتميز Claude 4 Sonnet بقدرة خاصة على الكتابة التي تنقل المعاني الضمنية. وغالبًا ما تكون العاطفة في عمل الصوت أكثر فاعلية حين تكون ضمنية لا معلنة مباشرة، ويميل Claude إلى ذلك السجل الأدق. بالنسبة للمشاهد التي تكبت فيها شخصيتك عاطفتها، أو تخفي هشاشتها خلف الدعابة، أو تقول شيئًا وتشعر بشيء آخر، تميل مخرجات Claude 4 Sonnet إلى أن تكون أغنى بالإشارات الصوتية من الكتابة العاطفية المباشرة.
يقدم Claude 4.5 Sonnet و Claude Sonnet 5 كلاهما بدائل قوية حسب تعقيد المشروع وطوله.
💡 نصيحة لسير العمل: استخدم نموذجًا لغويًا كبيرًا لكتابة النص الكامل أولًا. ثم غذِّ كل قسم إلى نموذج TTS الخاص بك مع وسم العاطفة المناسب. هذا الفصل بين الكتابة والتوليد يحافظ على جودة كل مرحلة في أعلى مستوياتها.
الأخطاء الشائعة وكيفية إصلاحها
بعد العمل مع نماذج TTS العاطفية، تظهر أخطاء معينة مرارًا. إليك الأخطاء التي تكلّف أكبر قدر من جودة المخرجات.
استخدام نص محايد عاطفيًا ولوم النموذج. النموذج لا يستطيع إلا تضخيم ما هو موجود في النص. إذا كانت الكتابة مسطّحة، فسيكون الصوت مسطّحًا مهما كانت إعدادات العاطفة التي تطبقها. أعد كتابة السطر قبل أن تلمس المعاملات.
ضبط شدة العاطفة مرتفعة جدًا. الشدة القصوى غالبًا ما تنتج نتائج تبدو مبالغًا فيها أو كرتونية. النقطة المثلى لمعظم عمل شخصيات الوايفو هي 0.5 إلى 0.75 على المقاييس المُعيَّرة. احتفظ بالطرف الأعلى لذروات درامية محددة.
تجاهل علامات الترقيم. تستخدم نماذج TTS علامات الترقيم كإشارات للإيقاع. السطر الذي لا يحتوي على فواصل أو وقفات سيُلقى كتيار واحد متصل. أضف نقاط تنفس طبيعية حيث يتوقف الشخص الحقيقي.
عدم الاستماع بسماعات جيدة. مكبرات الحاسوب المحمول تضغط نطاق الترددات الذي تعيش فيه الإشارات الصوتية العاطفية. السماعات تكشف كيف يبدو مخرجك فعلًا وأين يحتاج إلى تعديل.
توليد فقرات طويلة في تمريرة واحدة. قسّم الخطب العاطفية الطويلة إلى مقاطع أقصر، وولّد كل مقطع بالاستهداف العاطفي المناسب. المقاطع المجمّعة ذات الانتقالات العاطفية السلسة تتفوق تقريبًا دائمًا على المخرجات الطويلة في تمريرة واحدة.
| الخطأ الشائع | الحل السريع |
|---|
| مخرجات مسطّحة رغم إعدادات عاطفية مرتفعة | أعد كتابة السطر بلغة عاطفية أكثر |
| مخرجات مبالغ فيها دراميًا | خفّض شدة العاطفة إلى 0.5-0.6 |
| أداء متعجل ومتقطع الأنفاس | أضف فواصل وعلامات حذف لإعطاء مساحة للتنفس |
| انحراف الهوية الصوتية بين المقاطع | ارفع دائمًا مقطع الصوت المرجعي نفسه |
| عدم تطابق مزامنة الشفاه | اقطع الصمت من بداية الصوت قبل المزامنة |
مجموعة الأدوات المناسبة لسير عملك
الأدوات موجودة، وهي جيدة، وهي متاحة على منصة واحدة. إليك مجموعة الأدوات العملية لسير عمل كامل لصوت وايفو عاطفي:
- اكتب النص باستخدام GPT 5 أو Claude 4 Sonnet، مع تحديد المحطات العاطفية لكل مشهد
- ولّد الصوت باستخدام Chatterbox للتحكم الأقصى في العاطفة، أو ElevenLabs V3 للعمل متعدد اللغات
- أضف جودة استوديو باستخدام MiniMax Speech 2.8 HD للمشاهد الصوتية الحميمة والدافئة
- حرّك الشخصية باستخدام Omni Human 1.5 لمزامنة الصوت مع صورة البورتريه
- حسّن مزامنة الشفاه على الفيديو الموجود باستخدام Sync Lipsync 2 Pro
يعمل السير كله دون مغادرة PicassoIA. لا تصدير من أطراف ثالثة، ولا تكاملات معقدة، ولا انتظار لتفعيل حسابات أدوات منفصلة.
شخصيتك جاهزة للكلام
الصوت العاطفي في شخصيات الذكاء الاصطناعي ليس سحرًا، وليس معقدًا بمجرد أن تفهم ما الذي يحركه. الكتابة الأفضل، والنموذج المناسب للهدف العاطفي الذي تريده، وقليل من التحسين التكراري، هذا كل ما تحتاجه. الفجوة بين شخصية تبدو آلية وأخرى تبدو حيّة فعلًا أصغر مما يتوقع معظم الناس، والأدوات على PicassoIA تضع تلك الفجوة في متناول أي شخص.
اختر مشهدًا واحدًا. اكتب الحوار بثقل عاطفي حقيقي. شغّله عبر Chatterbox بشدة عاطفية معتدلة. استمع بالسماعات. ستلاحظ الفرق فورًا.
من هنا، فإن الكتالوج الكامل لنماذج تحويل النص إلى كلام في انتظارك، ولكل منها نقاط قوتها للسجلات العاطفية المختلفة وحالات الاستخدام المتنوعة. وايفو الخاصة بك لها صوت. والآن امنحها شيئًا يستحق أن تقوله.


