Tu waifu de IA tiene el aspecto perfecto, el nombre perfecto y una historia de fondo cuidadosamente elaborada. Luego abre la boca y habla con una voz que suena a sistema de navegación GPS leyendo un aviso médico. Esa desconexión lo rompe todo. La voz emocional no es una función de lujo en el trabajo con personajes de IA. Es la diferencia entre un personaje que parece vivo y uno que parece una demo.
Este artículo es para cualquiera que quiera solucionar eso. Tanto si estás creando un compañero de IA, produciendo contenido con voz para una novela visual o simplemente experimentando con las personalidades de tus personajes, la mecánica de la síntesis de voz emocional está al alcance de cualquiera ahora mismo, y las herramientas de PicassoIA la hacen sorprendentemente fácil de usar.
Por qué las voces planas arruinan la inmersión
El cerebro humano está programado para leer la voz como una señal principal de intención y emoción. Mucho antes de procesar las palabras, registramos el tono, la altura y el ritmo. Una frase como "Te eché de menos" suena totalmente distinta según se diga con una entonación ascendente y un ligero aliento, o con un tono plano y un ritmo constante. Las palabras son idénticas. El contenido emocional no.
El problema de la salida TTS por defecto
La mayoría de los sistemas de texto a voz listos para usar optimizan la claridad y la inteligibilidad. Es lo correcto para las apps de navegación, los lectores de pantalla y las herramientas de accesibilidad. Es lo incorrecto para un compañero de IA cuya personalidad depende por completo de cómo suena cuando está emocionada, nerviosa o con el corazón roto en silencio.
La salida TTS por defecto tiende a sufrir tres problemas concretos:
- Prosodia monótona: el tono se mantiene dentro de una banda estrecha independientemente del contenido
- Ritmo uniforme: cada frase llega más o menos a la misma velocidad
- Sin micropausas: el habla natural respira y vacila; el habla sintética no
El resultado es una voz técnicamente correcta y emocionalmente vacía.
Qué significa realmente la voz emocional
La emoción en el habla no es un mando que se sube sin más. Es una combinación de varias propiedades acústicas que trabajan en sincronía. Cuando una persona habla con entusiasmo, el tono sube y el ritmo se acelera. Cuando habla con tristeza, el tono baja, el ritmo se ralentiza y hay pausas más largas entre frases. La ternura implica un ataque más suave en las consonantes y un rango de volumen ligeramente reducido.
Los buenos modelos de TTS emocional aprenden estos patrones a partir de enormes cantidades de datos de habla humana. Los mejores te permiten especificar el objetivo emocional, ya sea mediante etiquetas de estilo explícitas, ingeniería de prompts o controles de parámetros dedicados, en lugar de obligarte a adivinar qué combinación de ajustes produce la sensación que buscas.
La ciencia detrás de la emoción vocal
Entender la mecánica que hay detrás del habla emocional te hace bastante mejor al escribir prompts para modelos de TTS. Dejas de adivinar y empiezas a diseñar.
Tono, ritmo y pausas
Estos tres parámetros transportan la mayor parte de la señal emocional en el habla humana. Esto es lo que dice la investigación sobre cada categoría emocional:
| Emoción | Patrón de tono | Ritmo | Pausas |
|---|
| Alegría / Entusiasmo | Alto, rango amplio | Rápido | Cortas, enérgicas |
| Tristeza | Bajo, rango estrecho | Lento | Largas, frecuentes |
| Ira | Alto, subidas bruscas | Rápido | Mínimas |
| Ternura | Medio-bajo, suave | Lento-moderado | Suaves, deliberadas |
| Sorpresa | Salto súbito de tono | Variable | Breve silencio antes |
| Nerviosismo | Ligeramente elevado | Irregular | Llenas de sonidos de respiración |
Cuando escribes un prompt para un modelo de TTS emocional, en el fondo le pides que aplique el patrón correcto de esta tabla. Cuanto mejor entienda el modelo la variación natural del habla, con más convicción lo ejecutará.
Control de prosodia frente a etiquetas de estilo
Hay dos enfoques principales que usan los sistemas de TTS modernos para gestionar la emoción:
Las etiquetas de estilo son instrucciones explícitas incrustadas en el prompt de texto, como [joyful], [sad] o [whispering]. Algunos modelos las leen en línea y ajustan su salida en consecuencia. Son rápidas de usar, pero pueden sonar mecánicas si se abusa de ellas.
El control de prosodia es el enfoque más sofisticado, en el que el modelo procesa las señales emocionales del lenguaje natural del propio prompt y ajusta el tono, el ritmo y la intensidad de forma orgánica. Los modelos entrenados con este enfoque tienden a producir una salida de sonido más natural, porque la emoción surge del contenido en lugar de añadirse después.
Los mejores resultados llegan al combinar ambos: escribe diálogos con emoción natural y, después, especifica el estado emocional en los parámetros de generación.
Los mejores modelos de TTS para voces emocionales de waifu
PicassoIA alberga una buena selección de modelos de texto a voz, y no todos son igual de adecuados para el trabajo con personajes emocionales. Estos son los que de verdad cumplen.
Chatterbox de Resemble AI
Chatterbox está diseñado específicamente para el control de la emoción. Es la opción destacada para el trabajo de voz de waifu de IA porque te da mandos directos sobre la intensidad emocional, no solo sobre el estilo de voz. Puedes clonar una voz de referencia a partir de una muestra de audio corta y luego aplicar variantes emocionales a esa voz clonada, lo que significa que la voz de tu personaje se mantiene coherente mientras su registro emocional cambia de forma natural entre escenas.
Si necesitas velocidad sin sacrificar calidad, Chatterbox Turbo entrega resultados más rápidos con una pérdida apenas marginal de expresividad. Para una calidad de nivel de producción con el máximo matiz emocional, Chatterbox Pro vale la pena dar el salto.
💡 Consejo: Dale a Chatterbox una muestra de voz de entre 15 y 30 segundos de un actor de voz leyendo un pasaje emocionalmente neutro. Así el modelo tiene una base limpia sobre la que trabajar antes de añadir emoción encima.
ElevenLabs V3
ElevenLabs V3 es uno de los modelos de TTS multilingües más expresivos disponibles. Su salida en escenas emocionales resulta notablemente humana, en parte porque V3 se entrenó con especial atención a las señales acústicas sutiles que marcan la emoción genuina en lugar de la emoción interpretada. La diferencia es real y se oye.
Para proyectos en los que tu personaje necesita hablar en varios idiomas manteniendo la coherencia emocional, V3 gestiona bien la transferencia emocional entre idiomas. Un personaje que suena cálido y afectuoso en inglés conservará esa cualidad al hablar en japonés o en español.
Para aplicaciones en tiempo real o compañeros de IA interactivos en los que importa la latencia, ElevenLabs Flash v2.5 y Turbo v2.5 reducen drásticamente el tiempo de generación conservando expresividad suficiente para uso conversacional.
MiniMax Speech 2.8 HD
MiniMax Speech 2.8 HD ocupa el nivel de calidad de estudio. Su fortaleza está en la entrega vocal suave e íntima, que encaja bien con los registros cálidos y afectuosos que suelen ocupar los personajes waifu. El modelo maneja con especial precisión el habla susurrada, la entrega con aliento y las quiebras emocionales en la voz.
Para iterar más rápido en la fase de pruebas, MiniMax Speech 2.8 Turbo te da previsualizaciones rápidas antes de comprometerte con renders HD completos. Si necesitas una identidad de voz personalizada, MiniMax Voice Cloning te permite crear primero la voz base.
Qwen3 TTS
Qwen3 TTS es el comodín de esta lista. Sus capacidades de diseño de voz son inusualmente flexibles: puedes describir una voz desde cero con lenguaje natural ("una mujer joven de habla suave con una calidad ligeramente aireada y entonaciones ascendentes suaves") y el modelo intentará sintetizar esa identidad vocal. Para personajes de los que no tienes una muestra de audio de referencia, pero sí una imagen mental detallada de cómo debería sonar, Qwen3 TTS ofrece un punto de partida creativo que otros modelos no ofrecen.
Cómo usar Chatterbox en PicassoIA
Como Chatterbox es el modelo más adecuado para este caso de uso, aquí tienes un flujo de trabajo paso a paso para obtener resultados emocionales con él en PicassoIA.
Paso 1: accede al modelo
Ve a picassoia.com/en/collection/text-to-speech/resemble-ai-chatterbox. Verás la interfaz de generación con el campo de texto y los campos opcionales para subir una referencia de voz.
Paso 2: escribe un diálogo que transmita emoción
Esta es la parte que más gente se salta, y por eso su resultado suena plano. No escribas texto neutro esperando que el modelo inyecte emoción. Escribe un diálogo que ya contenga el peso emocional en sus palabras y en su estructura de frases.
Entrada débil (texto neutro, esperando emoción):
"Me alegra verte."
Entrada fuerte (texto que transmite emoción en su construcción):
"¡Madre mía, de verdad has vuelto! Me repetía que volverías, pero una parte de mí tenía tanto miedo de que no lo hicieras."
El segundo ejemplo le da al modelo contenido emocional real con el que trabajar: sorpresa, alivio, vulnerabilidad, una alegría apenas contenida. La salida acústica reflejará eso.
Paso 3: ajusta el parámetro de emoción
Chatterbox acepta la intensidad emocional como entrada directa. Empieza con un ajuste moderado (alrededor de 0,5 a 0,7 en una escala de 0 a 1) y ajústalo según la escena. Los momentos muy dramáticos justifican una intensidad más alta. Los momentos tranquilos e íntimos suelen sonar mejor con intensidades más bajas, donde la emoción se insinúa en lugar de declararse.
Paso 4: sube una referencia de voz (opcional pero recomendable)
Si tienes un clip de referencia de la voz de tu personaje, súbelo. Incluso una muestra de 20 segundos marca una diferencia significativa en la coherencia de la salida. El modelo la usa para fijar el carácter vocal fundamental mientras aplica la variación emocional por encima.
Paso 5: previsualiza, itera y exporta
Genera una previsualización, escúchala con atención con auriculares en lugar de con los altavoces del equipo portátil, y ajusta. Los pequeños cambios en la estructura de las frases suelen producir cambios mayores en la calidad de la salida que los ajustes de parámetros. Exporta en WAV para conservar la máxima calidad en los flujos de trabajo posteriores.
Combinar la voz con la sincronización labial
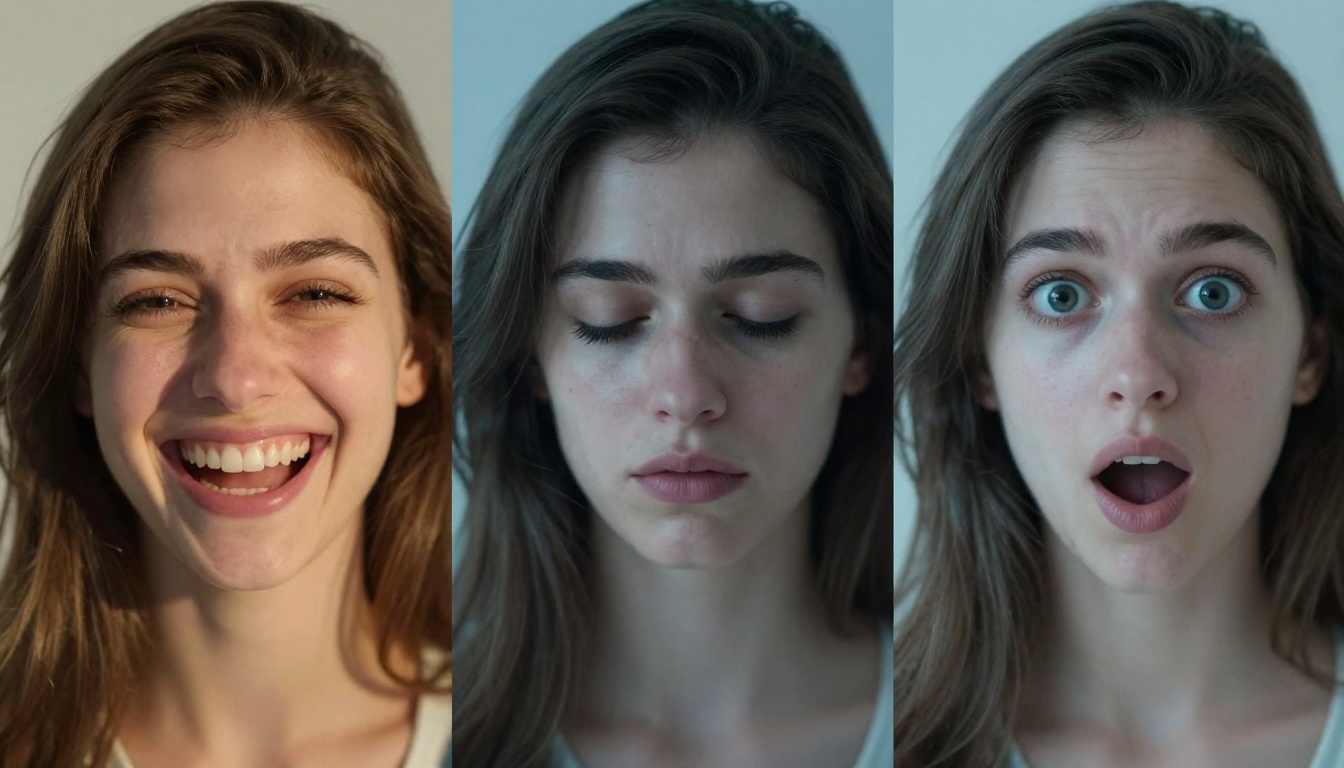
La voz por sí sola es poderosa. La voz sincronizada con un rostro en movimiento es otra cosa completamente distinta. Los modelos de sincronización labial de PicassoIA te permiten tomar el audio generado y asociarlo a una imagen de personaje o a un video existente, lo que produce un avatar parlante que coincide con el contenido emocional del habla.
Omni Human 1.5 para avatares parlantes
ByteDance Omni Human 1.5 es actualmente la opción más potente para animar una imagen estática de personaje y convertirla en un video parlante. Dale un único retrato de tu personaje waifu y el audio que generaste con Chatterbox o ElevenLabs, y producirá un video en el que la boca, el rostro y la parte superior del cuerpo del personaje se mueven en sincronía con el habla.
La salida respeta el contenido emocional del audio. Si la voz es entusiasta, el modelo genera un movimiento facial más animado. Si la voz es suave y tierna, el movimiento es más contenido. Esa coherencia emocional entre el audio y la imagen es lo que hace que el resultado parezca real y no mecánico.
Lipsync 2 Pro para video existente
Si ya tienes un video de tu personaje (de otra herramienta de generación de video con IA) y quieres reemplazar o añadir la voz, Sync Lipsync 2 Pro es la herramienta de precisión para este flujo de trabajo. Detecta la región facial del video existente y reasigna los movimientos de la boca para que coincidan con la nueva pista de audio.
Para aplicaciones más rápidas y menos exigentes en precisión, Sync Lipsync 2 y Pixverse Lipsync son alternativas sólidas. HeyGen Lipsync Precision es especialmente eficaz con video en el que el rostro del personaje está parcialmente oculto o girado.
Usar LLM para escribir mejores guiones emocionales
La palanca más importante en la salida de TTS emocional es la calidad del texto de entrada. Una mejor escritura produce una mejor voz. La colección de modelos de lenguaje grandes de PicassoIA te ofrece herramientas potentes para crear diálogos con los que los sistemas de TTS puedan trabajar de verdad.
GPT 5 para diálogos de personajes
GPT 5 destaca en la generación de diálogos de personajes con emociones variadas cuando recibe una ficha de personalidad clara. Describe la personalidad de tu personaje, su estado emocional actual y el contexto de la escena. Pide específicamente un diálogo que transmita la emoción en su estructura, no solo en su contenido. La calidad de la salida para el trabajo de voz de personajes es notablemente buena, y la comprensión que GPT 5 tiene de las sutiles diferencias de registro emocional lo convierte en un compañero creativo útil.
Para guiones largos o proyectos que requieren arcos emocionales complejos a lo largo de varias escenas, GPT 5 Pro añade una capacidad de razonamiento más profunda que ayuda a mantener la coherencia de los personajes en un gran volumen de diálogo.
Claude 4 Sonnet para escritura matizada
Claude 4 Sonnet destaca especialmente en escribir con subtexto. La emoción suele ser más eficaz en el trabajo de voz cuando se insinúa en lugar de declararse, y Claude tiende hacia ese registro más sutil. En escenas en las que tu personaje reprime una emoción, oculta su vulnerabilidad tras el humor o dice una cosa mientras siente otra, la salida de Claude 4 Sonnet tiende a ser más rica en señales acústicas que una escritura abiertamente emocional.
Claude 4.5 Sonnet y Claude Sonnet 5 ofrecen ambos alternativas sólidas según la complejidad y la extensión de tu proyecto.
💡 Consejo de flujo de trabajo: Usa un LLM para escribir primero el guion completo. Después, pasa cada sección a tu modelo de TTS con la etiqueta de emoción correspondiente. Esta separación entre escritura y generación mantiene ambas etapas en su máxima calidad.
Errores comunes y cómo corregirlos
Después de trabajar con modelos de TTS emocional, aparecen ciertos errores una y otra vez. Estos son los que más calidad de salida cuestan.
Usar texto emocionalmente neutro y culpar al modelo. El modelo solo puede amplificar lo que hay en el texto. Si la escritura es plana, la voz será plana sin importar qué ajustes de emoción apliques. Reescribe la línea antes de tocar los parámetros.
Poner la intensidad emocional demasiado alta. La intensidad máxima suele producir resultados que suenan exagerados o caricaturescos. El punto ideal para la mayoría de los trabajos con personajes waifu está entre 0,5 y 0,75 en escalas normalizadas. Reserva la parte alta para picos dramáticos concretos.
Ignorar la puntuación. Los modelos de TTS usan la puntuación como señal de ritmo. Una línea sin comas ni pausas se entregará como un flujo continuo sin interrupciones. Añade puntos de respiración naturales donde una persona real haría una pausa.
No escuchar con buenos auriculares. Los altavoces del equipo portátil comprimen el rango de frecuencias donde viven las señales acústicas emocionales. Los auriculares revelan cómo suena realmente tu salida y dónde necesita ajustes.
Generar párrafos largos en una sola pasada. Divide los discursos emocionales largos en segmentos más cortos y genera cada uno con el objetivo emocional adecuado. Los segmentos unidos con transiciones emocionales suaves casi siempre superan a las salidas largas de una sola pasada.
| Error común | Solución rápida |
|---|
| Salida plana a pesar de ajustes de emoción altos | Reescribe la línea con un lenguaje más emotivo |
| Salida exagerada | Baja la intensidad emocional a 0,5-0,6 |
| Entrega apresurada y sin aliento | Añade comas y puntos suspensivos para dar espacio a la respiración |
| La identidad de voz se desvía entre segmentos | Sube siempre el mismo clip de audio de referencia |
| Desajuste del lipsync | Recorta el silencio del inicio del audio antes de sincronizar |
El conjunto de herramientas adecuado para tu flujo de trabajo
Las herramientas existen, son buenas y están accesibles en una sola plataforma. Este es el conjunto práctico para un flujo de trabajo completo de voz emocional de waifu:
- Escribe el guion con GPT 5 o Claude 4 Sonnet, especificando los momentos emocionales por escena
- Genera la voz con Chatterbox para el máximo control emocional, o con ElevenLabs V3 para trabajo multilingüe
- Añade calidad de estudio con MiniMax Speech 2.8 HD para escenas vocales íntimas y cálidas
- Anima al personaje con Omni Human 1.5 para sincronizar el audio con un retrato
- Refina el lipsync sobre video existente con Sync Lipsync 2 Pro
Todo el flujo de trabajo se ejecuta sin salir de PicassoIA. Sin exportaciones a terceros, sin integraciones complicadas, sin esperar a que se activen cuentas de herramientas separadas.
Tu personaje está listo para hablar
La voz emocional en los personajes de IA no es magia ni es complicada una vez que entiendes qué la impulsa. Una mejor escritura, el modelo adecuado para el objetivo emocional que buscas y un poco de refinamiento iterativo son todo lo que hace falta. La distancia entre un personaje que suena robótico y uno que parece genuinamente vivo es menor de lo que la mayoría espera, y las herramientas de PicassoIA ponen esa distancia al alcance de cualquiera.
Elige una escena. Escribe el diálogo con un peso emocional real. Pásalo por Chatterbox con una intensidad emocional moderada. Escúchalo con auriculares. Notarás la diferencia de inmediato.
A partir de ahí, el catálogo completo de modelos de texto a voz te está esperando, cada uno con sus propias fortalezas para distintos registros emocionales y casos de uso. Tu waifu tiene voz. Ahora dale algo que valga la pena decir.


