आपकी AI वेइफ़ू का लुक परफ़ेक्ट है, नाम परफ़ेक्ट है, और उसकी बैकस्टोरी भी बड़ी सावधानी से गढ़ी गई है। फिर वह मुँह खोलती है और ऐसी आवाज़ में बोलती है जो किसी GPS नेविगेशन सिस्टम के मेडिकल डिस्क्लेमर पढ़ने जैसी लगती है। यही बेमेल सब कुछ तोड़ देता है। AI कैरेक्टर वर्क में इमोशनल आवाज़ कोई लग्ज़री फ़ीचर नहीं है। यही वह फ़र्क है जो एक कैरेक्टर को जीवित महसूस कराता है और दूसरे को सिर्फ़ डेमो जैसा।
यह लेख उसी समस्या को ठीक करने के लिए है। चाहे आप AI कंपेनियन बना रहे हों, विज़ुअल नॉवेल के लिए वॉइसओवर वाला कंटेंट तैयार कर रहे हों, या बस कैरेक्टर पर्सोना के साथ प्रयोग कर रहे हों, इमोशनल स्पीच सिंथेसिस के मैकेनिक्स आज ही आसानी से समझ में आ सकते हैं, और PicassoIA के टूल इन्हें इस्तेमाल करना बेहद सरल बना देते हैं।
फीकी आवाज़ें इमर्शन को क्यों मार देती हैं
इंसानी दिमाग आवाज़ को इरादे और भावना के मुख्य संकेत के रूप में पढ़ने के लिए बना है। शब्दों को प्रोसेस करने से बहुत पहले हम लहजा, पिच और रफ़्तार पकड़ लेते हैं। "I missed you" जैसा वाक्य पूरी तरह अलग असर करता है, यह इस पर निर्भर करता है कि उसे ऊपर उठते लहजे और हल्की सी भर्रायी आवाज़ के साथ बोला गया है या एक सपाट, एक-सी रफ़्तार में। शब्द वही रहते हैं। भावनात्मक अर्थ नहीं।
डिफ़ॉल्ट TTS आउटपुट की समस्या
ज़्यादातर आउट-ऑफ़-द-बॉक्स टेक्स्ट-टू-स्पीच सिस्टम स्पष्टता और समझ पर ध्यान देते हैं। नेविगेशन ऐप, स्क्रीन रीडर और एक्सेसिबिलिटी टूल्स के लिए यह सही तरीका है। लेकिन उस AI कंपेनियन के लिए यह गलत तरीका है जिसकी पर्सनैलिटी पूरी तरह इस पर टिकी है कि वह उत्साहित, घबराई हुई, या चुपचाप दिल टूटने पर कैसी सुनाई देती है।
डिफ़ॉल्ट TTS आउटपुट अक्सर तीन खास समस्याओं से जूझता है:
- मोनोटोन प्रोसोडी: कंटेंट चाहे जो हो, पिच एक संकीर्ण दायरे में ही रहती है
- एक-सी पेसिंग: हर वाक्य लगभग एक ही रफ़्तार से आता है
- माइक्रो-पॉज़ की कमी: असली बोलचाल में साँस लेने और रुकने की जगह होती है; सिंथेटिक स्पीच में नहीं
नतीजा एक ऐसी आवाज़ है जो तकनीकी रूप से सही है और भावनात्मक रूप से खाली।
इमोशनल आवाज़ का असल मतलब क्या है
स्पीच में इमोशन कोई एक डायल नहीं है जिसे आप ऊपर घुमा दें। यह कई ध्वनिक गुणों का एक साथ मिलकर काम करने का नतीजा है। जब कोई उत्साह के साथ बोलता है, तो पिच ऊपर जाती है और रफ़्तार बढ़ती है। उदासी में पिच नीचे आती है, रफ़्तार धीमी होती है और वाक्यांशों के बीच लंबे ठहराव आते हैं। कोमलता में व्यंजनों की शुरुआत नरम होती है और लाउडनेस की रेंज थोड़ी कम हो जाती है।
अच्छे इमोशनल TTS मॉडल इन पैटर्न्स को इंसानी स्पीच के भारी डेटा से सीखते हैं। सबसे अच्छे मॉडल आपको इमोशनल लक्ष्य तय करने देते हैं, या तो साफ़ स्टाइल टैग्स से, प्रॉम्प्ट इंजीनियरिंग से, या समर्पित पैरामीटर कंट्रोल से। वे आपको यह अंदाज़ा लगाने पर मजबूर नहीं करते कि किन सेटिंग्स के मेल से वह फ़ीलिंग बनेगी जो आप चाहते हैं।
वोकल इमोशन के पीछे का विज्ञान
इमोशनल स्पीच के नीचे के मैकेनिक्स को समझने से आप TTS मॉडल को प्रॉम्प्ट करने में काफ़ी बेहतर बनते हैं। आप अंदाज़ा लगाना बंद करते हैं और इंजीनियरिंग शुरू करते हैं।
पिच, पेस और पॉज़
इंसानी स्पीच में इमोशन का ज़्यादातर संकेत ये तीन पैरामीटर लेकर चलते हैं। रिसर्च हर इमोशन कैटेगरी के बारे में क्या बताती है, वह यहाँ है:
| इमोशन | पिच पैटर्न | पेस | पॉज़ |
|---|
| खुशी / उत्साह | ऊँची, चौड़ी रेंज | तेज़ | छोटे, ऊर्जावान |
| उदासी | नीची, संकीर्ण रेंज | धीमी | लंबे, बार-बार |
| गुस्सा | ऊँची, तीखी बढ़त | तेज़ | न्यूनतम |
| कोमलता | मध्यम-नीची, चिकनी | धीमी से मध्यम | नरम, सोच-समझकर |
| आश्चर्य | अचानक पिच छलांग | बदलता हुआ | उससे पहले संक्षिप्त खामोशी |
| घबराहट | थोड़ी ऊँची | अनियमित | साँस की आवाज़ों से भरा |
जब आप किसी इमोशनल TTS मॉडल को प्रॉम्प्ट करते हैं, तो आप असल में उससे इस तालिका के सही पैटर्न को लागू करने के लिए कह रहे होते हैं। मॉडल जितना बेहतर नेचुरल स्पीच की विविधता को समझता है, वह उतनी ही विश्वसनीयता से उसे अमल में लाता है।
प्रोसोडी कंट्रोल बनाम स्टाइल टैग्स
आधुनिक TTS सिस्टम इमोशन को संभालने के लिए मुख्य रूप से दो तरीके अपनाते हैं:
स्टाइल टैग्स टेक्स्ट प्रॉम्प्ट में डाले गए साफ़ निर्देश होते हैं, जैसे [joyful], [sad] या [whispering]। कुछ मॉडल इन्हें इनलाइन पढ़ते हैं और अपना आउटपुट उसी हिसाब से बदलते हैं। इन्हें इस्तेमाल करना तेज़ है, लेकिन ज़्यादा इस्तेमाल करने पर ये यांत्रिक लग सकते हैं।
प्रोसोडी कंट्रोल ज़्यादा परिष्कृत तरीका है, जिसमें मॉडल प्रॉम्प्ट की प्राकृतिक भाषा से ही इमोशनल संकेत प्रोसेस करता है और पिच, पेस व तीव्रता को स्वाभाविक रूप से समायोजित करता है। इस तरीके से ट्रेन किए गए मॉडल ज़्यादा प्राकृतिक आवाज़ देते हैं, क्योंकि इमोशन कंटेंट से उभरता है, ऊपर से चिपकाया नहीं जाता।
सबसे अच्छे नतीजे दोनों को मिलाने से आते हैं: स्वाभाविक रूप से इमोशनल डायलॉग लिखें, फिर अपने जनरेशन पैरामीटर में इमोशनल स्थिति तय करें।
इमोशनल वेइफ़ू आवाज़ों के लिए बेस्ट TTS मॉडल
PicassoIA पर टेक्स्ट-टू-स्पीच मॉडल का मज़बूत चयन है, और ये सभी इमोशनल कैरेक्टर वर्क के लिए बराबर उपयुक्त नहीं हैं। ये वे हैं जो सच में नतीजा देते हैं।
Resemble AI का Chatterbox
Chatterbox इमोशन कंट्रोल के लिए ही बनाया गया है। AI वेइफ़ू वॉइस वर्क के लिए यह खास तौर पर सबसे आगे है, क्योंकि यह सिर्फ़ वॉइस स्टाइल नहीं, बल्कि इमोशनल तीव्रता पर सीधे नियंत्रण देता है। आप एक छोटे ऑडियो सैंपल से रेफ़रेंस वॉइस क्लोन कर सकते हैं और फिर उस क्लोन की गई आवाज़ पर इमोशनल वेरिएंट लागू कर सकते हैं। इसका मतलब है कि आपके कैरेक्टर की आवाज़ एक-सी रहती है, जबकि उसका इमोशनल रजिस्टर दृश्यों के बीच स्वाभाविक रूप से बदलता है।
अगर आपको क्वालिटी से समझौता किए बिना स्पीड चाहिए, तो Chatterbox Turbo तेज़ आउटपुट देता है, जिसमें अभिव्यक्ति में बस मामूली कमी आती है। प्रोडक्शन-स्तर की क्वालिटी और अधिकतम इमोशनल बारीकी के लिए Chatterbox Pro अपग्रेड के लायक है।
💡 टिप: Chatterbox को किसी वॉइस एक्टर का 15 से 30 सेकंड का वॉइस सैंपल दें, जिसमें वह इमोशनली न्यूट्रल पैसेज पढ़ रहा हो। इससे इमोशन की परत चढ़ाने से पहले मॉडल को एक साफ़ बेसलाइन मिलती है।
ElevenLabs V3
ElevenLabs V3 उपलब्ध सबसे ज़्यादा एक्सप्रेसिव मल्टीलिंगुअल TTS मॉडलों में से एक है। इमोशनल दृश्यों में इसका आउटपुट उल्लेखनीय रूप से इंसानी लगता है, आंशिक रूप से इसलिए कि V3 को उन सूक्ष्म ध्वनिक संकेतों पर विशेष ध्यान देकर ट्रेन किया गया था जो असली इमोशन को दिखावटी इमोशन से अलग करते हैं। फ़र्क असली है और सुनाई भी देता है।
उन प्रोजेक्ट्स के लिए जहाँ आपके कैरेक्टर को इमोशनल एकरूपता बनाए रखते हुए कई भाषाओं में बोलना है, V3 क्रॉस-लैंग्वेज इमोशनल ट्रांसफ़र अच्छी तरह संभालता है। जो कैरेक्टर अंग्रेज़ी में गर्मजोशी भरा और स्नेही सुनाई देता है, वह वही गुण जापानी या स्पेनिश आउटपुट में भी ले आता है।
रियल-टाइम एप्लिकेशन या इंटरैक्टिव AI कंपेनियन के लिए, जहाँ लेटेंसी मायने रखती है, ElevenLabs Flash v2.5 और Turbo v2.5 जनरेशन का समय काफ़ी घटा देते हैं, और बातचीत के उपयोग के लिए पर्याप्त एक्सप्रेसिवनेस भी बनाए रखते हैं।
MiniMax Speech 2.8 HD
MiniMax Speech 2.8 HD स्टूडियो-क्वालिटी श्रेणी में आता है। इसकी ताकत नरम, अंतरंग वोकल डिलीवरी में है, जो उन स्नेही, गर्म रजिस्टरों से अच्छी तरह मेल खाती है जिनमें वेइफ़ू कैरेक्टर आम तौर पर रहते हैं। यह मॉडल फुसफुसाती स्पीच, भर्राई हुई डिलीवरी और आवाज़ में इमोशनल दरारों को खास सटीकता से संभालता है।
टेस्टिंग के चरण में तेज़ इटरेशन के लिए, MiniMax Speech 2.8 Turbo पूरे HD रेंडर पर लगने से पहले आपको त्वरित प्रीव्यू देता है। अगर आपको कस्टम वॉइस पहचान चाहिए, तो MiniMax Voice Cloning आपको पहले बेस वॉइस बनाने देता है।
Qwen3 TTS
Qwen3 TTS इस सूची का वाइल्ड कार्ड है। इसकी वॉइस डिज़ाइन क्षमताएँ असामान्य रूप से लचीली हैं: आप नेचुरल लैंग्वेज में किसी आवाज़ का शून्य से वर्णन कर सकते हैं ("a soft-spoken young woman with a slightly breathy quality and gentle upward inflections") और मॉडल उस वॉइस पहचान को सिंथेसाइज़ करने की कोशिश करेगा। उन कैरेक्टरों के लिए जिनका आपके पास रेफ़रेंस ऑडियो सैंपल नहीं है, लेकिन जिनकी आवाज़ कैसी होनी चाहिए इसकी आपके मन में विस्तृत तस्वीर है, Qwen3 TTS एक रचनात्मक शुरुआती बिंदु देता है जो दूसरे मॉडल नहीं देते।
PicassoIA पर Chatterbox कैसे इस्तेमाल करें
चूँकि Chatterbox इस उपयोग के लिए सबसे उपयुक्त मॉडल है, यहाँ PicassoIA पर उससे इमोशनल आउटपुट पाने का चरण-दर-चरण वर्कफ़्लो है।
चरण 1: मॉडल तक पहुँचें
picassoia.com/en/collection/text-to-speech/resemble-ai-chatterbox पर जाएँ। आपको टेक्स्ट इनपुट और वैकल्पिक वॉइस रेफ़रेंस अपलोड फ़ील्ड वाला जनरेशन इंटरफ़ेस दिखेगा।
चरण 2: ऐसा डायलॉग लिखें जिसमें इमोशन हो
यही वह हिस्सा है जिसे ज़्यादातर लोग छोड़ देते हैं, और इसीलिए उनका आउटपुट सपाट लगता है। न्यूट्रल टेक्स्ट लिखकर यह उम्मीद न करें कि मॉडल उसमें इमोशन भर देगा। ऐसा डायलॉग लिखें जिसमें शब्दों के चुनाव और वाक्य की बनावट में ही इमोशनल वज़न पहले से हो।
कमज़ोर इनपुट (न्यूट्रल टेक्स्ट, इमोशन की उम्मीद में):
"मैं आपको देखकर खुश हूँ।"
मज़बूत इनपुट (टेक्स्ट जो अपनी बनावट में इमोशन लेकर चलता है):
"ओह माय गॉड, आप सच में लौट आए। मैं खुद को यही कहती रही कि आप आएँगे, पर मेरा एक हिस्सा बहुत डरा हुआ था कि आप नहीं आएँगे।"
दूसरा उदाहरण मॉडल को असली इमोशनल सामग्री देता है: आश्चर्य, राहत, कमज़ोरी, और मुश्किल से दबाई जा सकने वाली खुशी। ध्वनिक आउटपुट उसी को दर्शाएगा।
चरण 3: इमोशन पैरामीटर सेट करें
Chatterbox इमोशन की तीव्रता को सीधे इनपुट के रूप में लेता है। एक मध्यम सेटिंग से शुरू करें (0 से 1 के पैमाने पर लगभग 0.5 से 0.7) और दृश्य के हिसाब से समायोजित करें। बहुत नाटकीय पलों में ज़्यादा तीव्रता चाहिए। शांत, अंतरंग पलों में अक्सर कम तीव्रता बेहतर लगती है, जहाँ इमोशन कहा नहीं, बल्कि महसूस कराया जाता है।
चरण 4: वॉइस रेफ़रेंस अपलोड करें (वैकल्पिक, पर सुझाया गया)
अगर आपके पास अपने कैरेक्टर की आवाज़ की रेफ़रेंस क्लिप है, तो उसे अपलोड करें। यहाँ तक कि 20 सेकंड का सैंपल भी आउटपुट की एकरूपता में बड़ा फ़र्क डालता है। मॉडल उसका इस्तेमाल मूल वॉइस कैरेक्टर को लॉक करने के लिए करता है, और उसके ऊपर इमोशनल बदलाव लागू करता है।
चरण 5: प्रीव्यू करें, इटरेट करें, एक्सपोर्ट करें
एक प्रीव्यू जनरेट करें, लैपटॉप स्पीकर की बजाय हेडफ़ोन से ध्यान से सुनें, और समायोजित करें। वाक्य की बनावट में छोटे बदलाव अक्सर पैरामीटर बदलने से बड़े आउटपुट बदलाव लाते हैं। आगे के वर्कफ़्लो में अधिकतम क्वालिटी बनाए रखने के लिए WAV के रूप में एक्सपोर्ट करें।
वॉइस को लिपसिंक के साथ जोड़ना
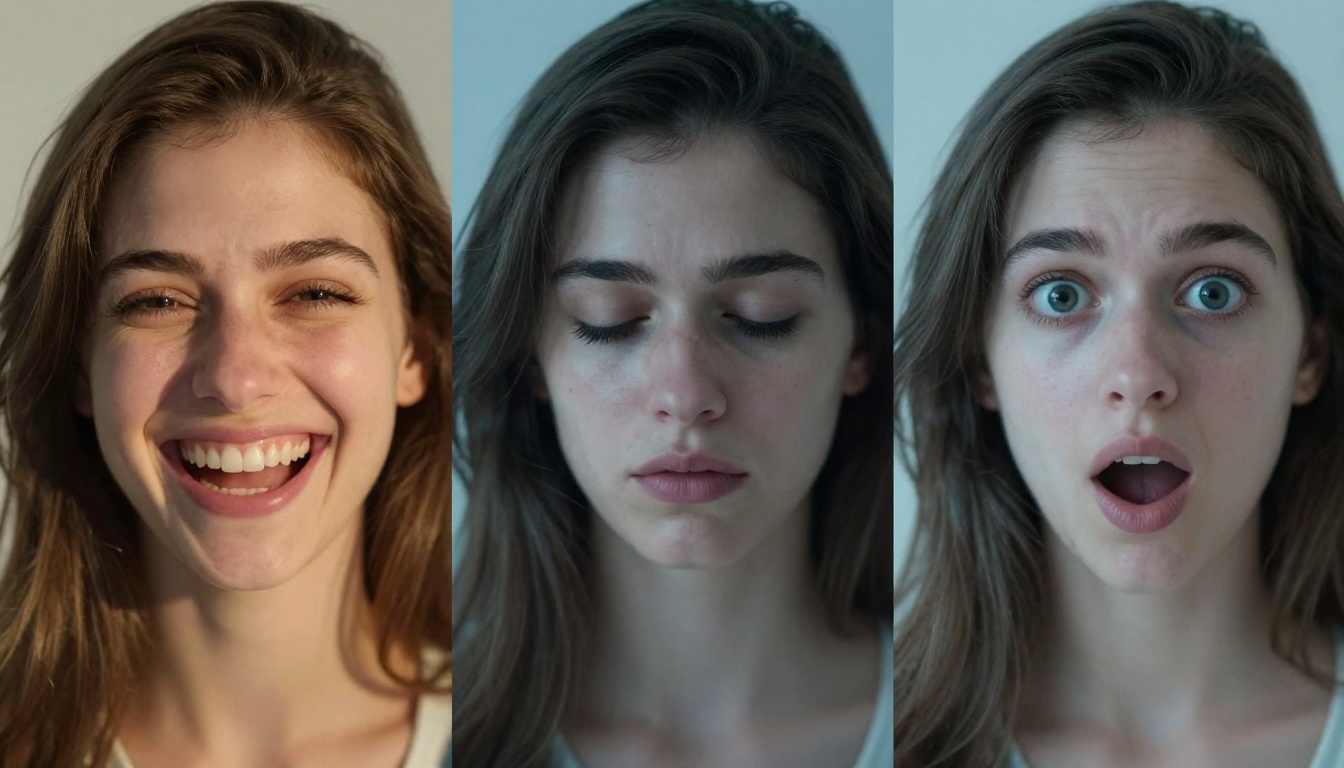
अकेली वॉइस भी शक्तिशाली है। लेकिन जब वह किसी चलते हुए चेहरे से सिंक हो जाती है, तो बात ही कुछ और होती है। PicassoIA के लिपसिंक मॉडल आपको जनरेट किया गया ऑडियो लेकर उसे किसी कैरेक्टर इमेज या मौजूदा वीडियो से जोड़ने देते हैं, जिससे एक टॉकिंग अवतार बनता है जो स्पीच के इमोशनल कंटेंट से मेल खाता है।
टॉकिंग अवतार के लिए Omni Human 1.5
ByteDance Omni Human 1.5 स्थिर कैरेक्टर इमेज को टॉकिंग वीडियो में बदलने के लिए फ़िलहाल सबसे मज़बूत विकल्प है। इसे अपने वेइफ़ू कैरेक्टर का एक पोर्ट्रेट इमेज और Chatterbox या ElevenLabs से बनाया गया ऑडियो दें, और यह एक ऐसा वीडियो बनाता है जिसमें कैरेक्टर के होंठ, चेहरा और ऊपरी शरीर स्पीच के साथ सिंक होकर हिलते हैं।
आउटपुट ऑडियो के इमोशनल कंटेंट को दर्शाता है। अगर आवाज़ उत्साहित है, तो मॉडल ज़्यादा जीवंत चेहरे की गतिविधि बनाता है। अगर आवाज़ नरम और कोमल है, तो गतिविधि ज़्यादा संयमित रहती है। ऑडियो और विज़ुअल आउटपुट के बीच यही इमोशनल तालमेल नतीजे को यांत्रिक नहीं, बल्कि असली महसूस कराता है।
मौजूदा वीडियो के लिए Lipsync 2 Pro
अगर आपके पास पहले से आपके कैरेक्टर का वीडियो है (किसी दूसरे AI वीडियो जनरेशन टूल से), और आप वॉइस बदलना या जोड़ना चाहते हैं, तो Sync Lipsync 2 Pro इस वर्कफ़्लो के लिए सटीक टूल है। यह मौजूदा वीडियो में चेहरे का हिस्सा पहचानता है और होंठों की हरकत को नए ऑडियो ट्रैक से मेल खाने के लिए फिर से मैप करता है।
तेज़ और कम सटीकता-संवेदी उपयोग के लिए, Sync Lipsync 2 और Pixverse Lipsync ठोस विकल्प हैं। HeyGen Lipsync Precision खास तौर पर तब मज़बूत है जब वीडियो में कैरेक्टर का चेहरा आंशिक रूप से ढका हो या किसी कोण पर हो।
बेहतर इमोशनल स्क्रिप्ट लिखने के लिए LLM का इस्तेमाल
इमोशनल TTS आउटपुट में सबसे बड़ा लीवर टेक्स्ट इनपुट की गुणवत्ता है। बेहतर लेखन बेहतर आवाज़ देता है। PicassoIA का लार्ज लैंग्वेज मॉडल संग्रह आपको ऐसे डायलॉग गढ़ने के शक्तिशाली टूल देता है जिनके साथ TTS सिस्टम सच में काम कर सकें।
कैरेक्टर डायलॉग के लिए GPT 5
GPT 5 स्पष्ट पर्सोना ब्रीफ़ मिलने पर भावनात्मक रूप से विविध कैरेक्टर डायलॉग लिखने में उत्कृष्ट है। अपने कैरेक्टर का व्यक्तित्व, उसकी वर्तमान भावनात्मक स्थिति और दृश्य का संदर्भ बताएँ। खास तौर पर ऐसा डायलॉग माँगें जिसमें इमोशन उसकी बनावट में हो, सिर्फ़ कंटेंट में नहीं। कैरेक्टर वॉइस वर्क के लिए आउटपुट की क्वालिटी काफ़ी मज़बूत है, और इमोशनल रजिस्टर के सूक्ष्म फ़र्कों को समझने में GPT 5 एक उपयोगी रचनात्मक साथी बनता है।
लंबी स्क्रिप्ट या ऐसे प्रोजेक्ट के लिए जिनमें जटिल, कई दृश्यों वाले इमोशनल आर्क चाहिए, GPT 5 Pro अधिक गहरी रीज़निंग क्षमता जोड़ता है, जो बड़े डायलॉग में कैरेक्टर की एकरूपता बनाए रखने में मदद करती है।
सूक्ष्म लेखन के लिए Claude 4 Sonnet
Claude 4 Sonnet सबटेक्स्ट वाली लेखनी में खास ताकत रखता है। वॉइस वर्क में इमोशन अक्सर तब सबसे असरदार होता है जब वह सीधे कहा जाने के बजाय संकेत से महसूस हो, और Claude उसी सूक्ष्म रजिस्टर की ओर झुकता है। उन दृश्यों के लिए जहाँ आपका कैरेक्टर इमोशन दबा रहा है, कमज़ोरी को हास्य के पीछे छिपा रहा है, या कुछ कहते हुए कुछ और महसूस कर रहा है, Claude 4 Sonnet का आउटपुट सीधे इमोशनल लेखन से ज़्यादा ध्वनिक संकेतों से भरा होता है।
Claude 4.5 Sonnet और Claude Sonnet 5 दोनों आपके प्रोजेक्ट की जटिलता और लंबाई के हिसाब से मज़बूत विकल्प हैं।
💡 वर्कफ़्लो टिप: पहले पूरी स्क्रिप्ट लिखने के लिए LLM का इस्तेमाल करें। फिर हर हिस्से को संबंधित इमोशन टैग के साथ अपने TTS मॉडल में डालें। लेखन और जनरेशन को अलग रखने से दोनों चरण अपनी सर्वोच्च क्वालिटी पर रहते हैं।
आम गलतियाँ और उन्हें कैसे ठीक करें
इमोशनल TTS मॉडल के साथ काम करने पर कुछ गलतियाँ बार-बार दिखती हैं। यहाँ वे हैं जो आउटपुट क्वालिटी को सबसे ज़्यादा नुकसान पहुँचाती हैं।
इमोशनली न्यूट्रल टेक्स्ट इस्तेमाल करना और दोष मॉडल पर डालना। मॉडल सिर्फ़ वही बढ़ा सकता है जो टेक्स्ट में है। अगर लेखन सपाट है, तो आप कोई भी इमोशन सेटिंग लगाएँ, आवाज़ सपाट ही रहेगी। पैरामीटर छूने से पहले लाइन दोबारा लिखें।
इमोशन तीव्रता को बहुत ज़्यादा सेट करना। अधिकतम तीव्रता अक्सर ऐसे नतीजे देती है जो ओवरड्रामैटिक या कार्टून जैसे लगते हैं। ज़्यादातर वेइफ़ू कैरेक्टर वर्क के लिए सबसे अच्छा दायरा सामान्यीकृत पैमानों पर 0.5 से 0.75 है। ऊँची सीमा को खास नाटकीय चरमों के लिए रखें।
विराम चिह्नों को नज़रअंदाज़ करना। TTS मॉडल विराम चिह्नों को पेसिंग संकेत के रूप में इस्तेमाल करते हैं। जिस लाइन में कॉमा या ठहराव नहीं है, वह एक लगातार धारा की तरह बोली जाएगी। जहाँ असली इंसान रुकेगा, वहाँ सांस लेने के प्राकृतिक बिंदु जोड़ें।
अच्छे हेडफ़ोन से न सुनना। लैपटॉप स्पीकर उस फ़्रीक्वेंसी रेंज को कंप्रेस कर देते हैं जहाँ इमोशनल ध्वनिक संकेत रहते हैं। हेडफ़ोन दिखाते हैं कि आपका आउटपुट असल में कैसा सुनाई देता है और उसे कहाँ समायोजन की ज़रूरत है।
एक ही बार में लंबे पैराग्राफ़ जनरेट करना। लंबे इमोशनल भाषणों को छोटे हिस्सों में बाँटें और हर हिस्से को उपयुक्त इमोशनल लक्ष्य के साथ जनरेट करें। स्मूथ इमोशनल ट्रांज़िशन वाले जोड़े गए हिस्से लगभग हमेशा एक ही बार में बने लंबे आउटपुट से बेहतर प्रदर्शन करते हैं।
| आम गलती | त्वरित समाधान |
|---|
| ऊँची इमोशन सेटिंग के बावजूद सपाट आउटपुट | ज़्यादा इमोशनल शब्दों के साथ लाइन दोबारा लिखें |
| ओवरड्रामैटिक आउटपुट | इमोशन तीव्रता 0.5-0.6 तक घटाएँ |
| जल्दबाज़ी वाली, हाँफती डिलीवरी | साँस के लिए जगह बनाने को कॉमा और एलिप्सिस जोड़ें |
| हिस्सों के बीच वॉइस पहचान खिसकना | हमेशा एक ही रेफ़रेंस ऑडियो क्लिप अपलोड करें |
| लिपसिंक में गड़बड़ी | सिंक करने से पहले ऑडियो की शुरुआत की खामोशी काटें |
आपके वर्कफ़्लो के लिए सही टूल्स का सेट
टूल मौजूद हैं, अच्छे हैं, और एक ही प्लेटफ़ॉर्म पर उपलब्ध हैं। पूरे इमोशनल वेइफ़ू वॉइस वर्कफ़्लो के लिए व्यावहारिक सेट यह है:
- GPT 5 या Claude 4 Sonnet से स्क्रिप्ट लिखें, और हर दृश्य के लिए इमोशनल बीट्स तय करें
- अधिकतम इमोशन नियंत्रण के लिए Chatterbox, या मल्टीलिंगुअल काम के लिए ElevenLabs V3 से वॉइस जनरेट करें
- गर्म, अंतरंग वोकल दृश्यों के लिए MiniMax Speech 2.8 HD से स्टूडियो क्वालिटी जोड़ें
- ऑडियो को पोर्ट्रेट से सिंक करने के लिए Omni Human 1.5 से कैरेक्टर को एनिमेट करें
- मौजूदा वीडियो पर Sync Lipsync 2 Pro से लिपसिंक सुधारें
पूरा वर्कफ़्लो PicassoIA छोड़े बिना चलता है। कोई थर्ड-पार्टी एक्सपोर्ट नहीं, कोई जटिल इंटीग्रेशन नहीं, और अलग-अलग टूल अकाउंट बनने का इंतज़ार नहीं।
आपका कैरेक्टर बोलने के लिए तैयार है
AI कैरेक्टर में इमोशनल वॉइस कोई जादू नहीं है, और एक बार समझ आ जाए कि उसे क्या चलाता है, तो यह जटिल भी नहीं है। बेहतर लेखन, आपके इच्छित इमोशनल लक्ष्य के लिए सही मॉडल, और थोड़ा-सा बार-बार का सुधार, बस इतना ही चाहिए। रोबोटिक आवाज़ वाले कैरेक्टर और सच में जीवंत लगने वाले कैरेक्टर के बीच का फ़ासला लोगों की उम्मीद से कहीं ज़्यादा छोटा है, और PicassoIA के टूल उस फ़ासले को किसी के लिए भी पहुँच में ला देते हैं।
एक दृश्य चुनें। असली इमोशनल वज़न के साथ डायलॉग लिखें। उसे मध्यम इमोशन तीव्रता पर Chatterbox से चलाएँ। हेडफ़ोन लगाकर सुनें। फ़र्क आपको तुरंत सुनाई देगा।
उसके बाद टेक्स्ट-टू-स्पीच मॉडल का पूरा संग्रह तैयार है, जिसमें से हर मॉडल अलग-अलग इमोशनल रजिस्टर और उपयोग के मामलों के लिए अपनी खूबियाँ लिए है। आपकी वेइफ़ू के पास अब आवाज़ है। अब उसे कुछ ऐसा दीजिए जो कहने लायक हो।


