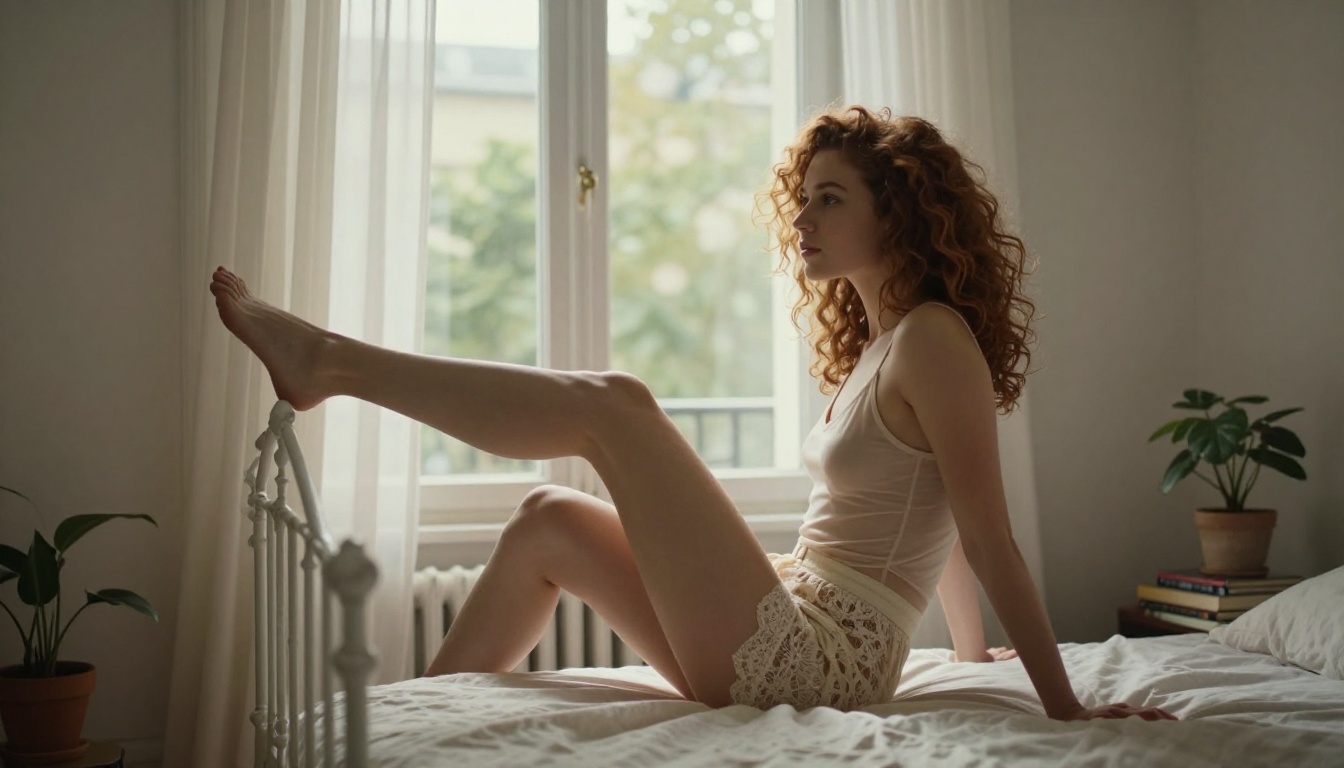
كيفية الضبط الدقيق لنماذج الذكاء الاصطناعي لمحتوى NSFW يبدو واقعيًا فعلًا
شرح مفصّل لكيفية ضبط نماذج توليد الصور بالذكاء الاصطناعي لمحتوى قريب من NSFW. يغطي اختيار النموذج الأساسي، وتنظيم مجموعة البيانات مع عدد الصور والتعليقات، ومعاملات تدريب LoRA، وكلمات المحفّز، وإعدادات CFG، وكيفية تشغيل النماذج المضبوطة على منصات الذكاء الاصطناعي لصور الجلامور (glamour) الواقعية والصور الفنية.
الضبط الدقيق لنموذج ذكاء اصطناعي لمحتوى NSFW من الموضوعات التي تتجنب معظم المنصات شرحها بالشكل الصحيح. تحصل على مدونات غامضة، وشروحات لا تعمل، ومنتديات مليئة بالتناقضات. يتجاوز هذا المقال كل ذلك. سواء كنت تريد لقطات جلامور (glamour) واقعية، أو صور تصوير البودوار (boudoir) الفنية، أو تصوير أزياء بطابع إيحائي يرفض النموذج الأساسي العام توليده بالجودة التي تحتاجها، فالضبط الدقيق هو الحل. وهو أسهل بكثير مما يظن معظم الناس. الفرق بين نتيجة متوسطة ونتيجة قابلة للنشر فعلًا ليس في أوامر نصية أفضل. إنه نموذج مدرّب بشكل صحيح يفهم جماليتك على مستوى أساسي.
لماذا لا تكفي النماذج العامة
المشكلة في استخدام نموذج أساسي كما هو لمحتوى قريب من محتوى البالغين بسيطة: لقد دُرِّب على كل شيء. أي أن فهم النموذج للجسم البشري مخفف على ملايين الأساليب والأشكال الفنية والسياقات. عندما تطلب منه مظهرًا محددًا أو لون بشرة معينًا أو مزاجًا بعينه، يميل النموذج إلى المتوسط. النتائج صحيحة تقنيًا لكنها عامة من الناحية الجمالية.
يعالج الضبط الدقيق ذلك بإعادة تدريب أوزان النموذج على مجموعة بيانات منتقاة ومركّزة. فبدلًا من المتوسط عبر الإنترنت كله، يتعلم النموذج بالضبط ما تريد أن ينتجه. والفرق ليس تدريجيًا، بل جذري.
💡 فكّر في الأمر هكذا: النموذج الأساسي مصوّر عام صوّر حفلات الزفاف والحياة البرية والرياضة والطعام. أما النموذج المضبوط فهو متخصص في الجلامور (glamour) صوّر 500 بورتريه تحريري. المتخصص يفوز في كل مرة.
هناك أيضًا جانب يتعلق بالإشراف على المحتوى. تُوجَّه مخرجات كثير من النماذج الأساسية أثناء التدريب لتقليل النتائج الصريحة. يمنحك الضبط الدقيق على جهازك، ومع مجموعة بياناتك، تحكمًا مباشرًا فيما ينتجه النموذج وما لا ينتجه.
الأوزان المدرّبة مسبقًا مقابل الأوزان المخصصة
أوزان النموذج المدرّب مسبقًا هي نقطة البداية. فهي تحمل مليارات الارتباطات المتعلَّمة بين توكنات النص والأنماط البصرية. لا يمحو الضبط الدقيق هذه الارتباطات، بل يوجّهها في اتجاه محدد مع الحفاظ على الأساس.
لهذا السبب يعطي الضبط الدقيق على 20 إلى 50 صورة نتائج قوية بشكل مدهش. أنت لا تبدأ من الصفر. أنت توجّه نظامًا قويًا بالفعل يعرف كيف يبدو الإنسان، وكيف تبدو ملمس البشرة، وكيف تبدو الإضاءة الناعمة. مهمتك أن تخبره أي نسخة محددة من تلك الأشياء تريد.
طريقة LoRA
التكيّف منخفض الرتبة (LoRA) هو أكثر طرق الضبط الدقيق عملية للمبدعين الأفراد. فبدلًا من إعادة تدريب مليارات معاملات النموذج كلها (وهو ما يتطلب عتادًا صناعيًا وأسابيع من الحوسبة)، يدرّب LoRA مجموعة صغيرة من أوزان المحوّلات الموضوعة فوق النموذج الأساسي.
النتائج العملية: يستغرق التدريب من 30 إلى 90 دقيقة على GPU استهلاكي، ويكون الملف الناتج عادةً بين 50 و200 ميغابايت، ويمكن إدخال المحوّل وإخراجه دون المساس بالنموذج الأساسي. يمكنك حتى دمج عدة LoRA معًا في توليد واحد، ومزج أساليب أو مفاهيم مختلفة بتأثير مرجّح. هذه المرونة هي ما يجعل LoRA المعيار في سير عمل الضبط الدقيق لمحتوى NSFW اليوم.
DreamBooth هو البديل، وينتج ملفات checkpoint كاملة بدلًا من المحوّلات. مخرجاته غالبًا أعلى دقة قليلًا، لكن أحجام الملفات (من 2 إلى 7 غيغابايت لكل ملف) ومتطلبات التدريب تجعل LoRA الخيار العملي لمعظم سير العمل.
اختيار النموذج الأساسي المناسب
يحدّد اختيار النموذج الأساسي سقف ما هو ممكن. هذه أهم الخيارات وما الذي يتفوق فيه كل منها:
Flux Dev ينتج حاليًا أكثر أشكال بشرية واقعية بين النماذج المتاحة للعموم. فهمه للتشريح وملمس البشرة واستجابة الإضاءة متفوق بوضوح على البنى الأقدم. وفي الضبط الدقيق لمحتوى NSFW لهذا أهمية كبيرة: من أكثر أنماط الفشل شيوعًا في توليد المحتوى للبالغين أشكال غير صحيحة تشريحيًا، وFLUX يتعامل مع هذا بشكل أفضل من أسلافه.
SDXL ما زال مهمًا بفضل منظومة LoRA الضخمة التي يملكها. توجد آلاف من LoRA الجاهزة لنموذج SDXL، لأساليب ومظاهر وأنماط جسدية محددة. إذا أردت دمج عدة LoRA في توليد واحد، فدعم SDXL للمحوّلات المتعددة عبر SDXL Multi ControlNet LoRA لا مثيل له.
Stable Diffusion 1.5 هو الخيار القديم. وهو سريع ويملك أوسع مكتبة LoRA، لكن أقصى دقة له وسقف الواقعية فيه يجعلانه غير مناسب للعمل الواقعي الحديث. إذا كنت تبدأ من الصفر اليوم، فتجاوز SD 1.5.
لماذا يتفوق Realistic Vision في البشرة
Realistic Vision v5.1 ضُبط خصيصًا من مبدعيه للمخرجات الفوتوغرافية. يتعامل مع ملمس البشرة والمسام والعيوب الطبيعية وتلاشي الإضاءة على البشرة البشرية بشكل أفضل من SDXL الأساسي. وفي المحتوى الذي تكون فيه جودة البشرة أساسية، فإن بدء تدريب الضبط الدقيق لديك فوق Realistic Vision يمنحك تقدمًا كبيرًا.
RealVisXL v3.0 Turbo يطبّق الفلسفة نفسها على بنية XL، وينتج مخرجات بدقة أعلى وواقعية مماثلة. للتكرار السريع، تجعل ميزة سرعته منه النموذج الأساسي المفضل لتجارب التدريب الاستكشافية.
بناء مجموعة بيانات مناسبة
هنا يخفق معظم الناس. مجموعة البيانات الضعيفة الانتقاء تنتج نموذجًا لا يمكن توجيهه بالأوامر النصية. فالمدخلات السيئة تعطي مخرجات سيئة، وهذه القاعدة تنطبق في الضبط الدقيق بصرامة أكبر منها في أي مكان آخر تقريبًا في تعلم الآلة.
قواعد عدد الصور وجودتها
الحد الأدنى المقبول لمحوّل LoRA مركّز لمحتوى NSFW هو 20 صورة. النقطة المثالية هي 40 إلى 80 صورة. وبعد 200 صورة تبدأ في مواجهة عوائد متناقصة دون زيادة متناسبة في وقت التدريب.
يجب أن تستوفي كل صورة في مجموعة بياناتك هذه المعايير:
الدقة: 768x768 بكسل كحد أدنى. ويُفضّل 1024x1024 أو أعلى.
الاتساق: يجب أن تعكس كل الصور الموضوع الذي تريد ضبطه. إذا كنت تدرّب أسلوبًا، فيجب أن تعكس كل الصور ذلك الأسلوب.
التنوع ضمن التركيز: ظروف إضاءة وزوايا ومسافات مختلفة. مجموعة من 50 لقطة قريبة أمامية الإضاءة ومتشابهة تقريبًا تنتج نموذجًا لا يستطيع التعامل مع أي شيء آخر.
صفر علامات مائية: بلا كولاج، ولا لقطات شاشة، ولا صور مركّبة.
تركيز حاد: صور التدريب غير الواضحة تعلّم النموذج إنتاج مخرجات غير واضحة.
💡 نصيحة احترافية: اجعل 10 إلى 15% من مجموعة بياناتك صور تنظيم (regularization)، أي صورًا من الفئة العامة وليست موضوعك المحدد. هذا يمنع الإفراط في التخصيص (overfitting) ويساعد النموذج على التعميم بشكل صحيح عند تلقي أوامر نصية جديدة.
أما بالنسبة لمحتوى الجلامور (glamour) والبودوار (boudoir) تحديدًا، فيجب أن تمتد مجموعة بياناتك على ثلاثة إعدادات إضاءة مختلفة على الأقل (نافذة طبيعية، الصندوق الناعم (softbox) في الاستوديو، إضاءة محيطة خافتة)، وعلى نطاقين إلى ثلاثة نطاقات للمسافة (لقطة بورتريه قريبة، لقطة متوسطة، جسم كامل)، وعلى أربعة اختيارات مختلفة على الأقل للملابس أو التنسيق. هذا التنوع هو ما يجعل النموذج المدرّب مستجيبًا بدلًا من أن يكون جامدًا.
تعليقات تُدرّب فعلًا
أدوات الوسم التلقائي مثل BLIP2 و WD Tagger تمنحك تعليقات دقيقة تقنيًا. لكن في الضبط الدقيق لمحتوى NSFW تريد تعليقات يدوية تصف بالضبط ما تريد أن يربطه النموذج بكلمة المحفّز.
التعليق الجيد للتدريب:
[trigger_word], a woman with auburn hair wearing a sheer camisole,
sitting on a white bed, soft window light, photorealistic,
film grain, 85mm portrait photography
التعليق السيئ للتدريب:
woman sitting on bed near window
الفرق ليس طفيفًا. التعليق المفصّل يعلّم النموذج أي الخصائص البصرية تنتمي إلى مفهومك. أما التعليق المختصر فيعلّمه القليل جدًا. خصّص من 15 إلى 20 دقيقة لكل صورة للتعليقات. وهي أعلى عائد على الوقت المستثمر في سير العمل كله.
تدريب LoRA خطوة بخطوة
بمجرد أن تجهز مجموعة بياناتك وتكتب تعليقاتها، يصبح التدريب نفسه مباشرًا إذا عرفت أي المعاملات تضبط. توفر أدوات مثل Kohya_ss و EveryDream 2 و SimpleTuner واجهات رسومية تعرض المعاملات الحاسمة دون الحاجة إلى خبرة في سطر الأوامر.
المعاملات المهمة فعلًا
تكشف معظم أدوات تدريب LoRA عشرات المعاملات. أما التي تحرّك النتيجة فعلًا فهي:
معدل التعلم: ابدأ بقيمة 1e-4 لشبكة LoRA. إذا كان مرتفعًا جدًا فسينسى النموذج معرفته الأساسية. وإذا كان منخفضًا جدًا فلن يتقارب التدريب خلال عدد معقول من الخطوات.
رتبة الشبكة (r): تتحكم في حجم محوّل LoRA. للعمل على التفاصيل الدقيقة مثل ملمس البشرة وملامح الوجه، استخدم الرتبة 32 أو 64. الرتب الأعلى تلتقط مزيدًا من الفروق الدقيقة، لكنها تنتج ملفات أكبر وتتطلب ذاكرة VRAM أكثر.
خطوات التدريب: لمجموعة بيانات من 40 صورة، استهدف من 1,500 إلى 2,500 خطوة. صيغة بسيطة: (number of images) x 30 = target steps.
حجم الدفعة (Batch Size): استخدم 1 إذا كنت على GPU واحد بذاكرة VRAM أقل من 16 غيغابايت. الدفعات الأكبر أسرع، لكنها ليست ضرورية بالضرورة للجودة.
المعامل
القيمة الموصى بها
التأثير
معدل التعلم
1e-4
يتحكم في سرعة التكيّف
رتبة الشبكة
32 إلى 64
سعة المحوّل
خطوات التدريب
1,500 إلى 2,500
إجمالي تكرارات التدريب
Clip skip
2
يعمل مع بنية SDXL
الدقة
1024x1024
طابق دقة المخرجات لديك
المجدول (Scheduler)
cosine with restarts
يمنع قفزات الخسارة
كلمات المحفّز وعزل المفهوم
كلمة المحفّز هي توكن نصي يُفعّل LoRA عند تضمينه في الأمر النصي. من دونها يتسرب تأثير LoRA إلى كل توليد بشكل غير متوقع.
اختر شيئًا غير موجود بالفعل في مفردات النموذج. الكلمات المختلقة تعمل جيدًا: xk3r_style، aur3lia_portrait، nvs_glamour. إذا استخدمت كلمة حقيقية مثل "glamour" أو "portrait"، فستتفعّل تأثيرات LoRA جزئيًا حتى عندما لا تريد ذلك.
💡 اختبار العزل: بعد التدريب، ولّد 10 صور دون كلمة المحفّز. إذا ظهر أسلوب LoRA أو موضوعه في تلك الصور، فكلمة المحفّز عامة أكثر من اللازم، أو أن معدل التعلم لديك كان مرتفعًا جدًا.
اختبار النموذج المضبوط
انتهى التدريب. الآن يأتي التحقق، وهنا يستعجل معظم الناس فيفوتهم مشكلات الجودة التي كان يمكن إصلاحها بجولة تدريب إضافية واحدة.
بنية الأمر النصي لأفضل النتائج
يتبع الأمر النصي المنظّم جيدًا لنموذج مضبوط بدقة لمحتوى NSFW هذا القالب:
الأمر النصي السلبي مهم بقدر أهمية الأمر النصي الإيجابي:
cartoon, illustration, 3D render, CGI, painting,
watermark, blurry, deformed anatomy, extra limbs,
bad hands, low resolution, oversaturated
مقياس CFG والخطوات وأخذ العينات
هذه المعاملات الثلاثة تتحكم في عملية التوليد مباشرة:
مقياس CFG: من 6 إلى 8 للمخرجات الواقعية. القيم الأدنى تمنح النموذج حرية إبداعية أكبر. والقيم الأعلى تدفعه نحو أمرك النصي بقوة أكبر، وغالبًا على حساب الطبيعية.
الخطوات: 25 إلى 35 هي النقطة المثالية. أقل من 20 تحصل على قطع ضوضاء مرئية. وفوق 50، تتناقص العوائد بحدة.
أداة أخذ العينات (Sampler): DPM++ 2M Karras هو الخيار الموثوق للعمل الواقعي. أما Euler A فينتج تنوعًا أكبر قليلًا إذا أردت استكشاف مفهوم قبل الالتزام بتركيبة نهائية.
تشغيل نماذج LoRA على PicassoIA
إذا لم تكن تريد إدارة بنية تحتية للتدريب محليًا، يمكنك العمل مباشرة مع نماذج تدعم LoRA المتاحة على المنصة دون إعداد بيئة GPU خاصة بك.
استخدام Flux Dev LoRA
Flux Dev LoRA هو الخيار الرئيسي لعمل البورتريه الواقعي. يقبل أوزان LoRA خارجية ويطبّقها عند تشغيل النموذج. سير العمل:
ارفع ملف LoRA .safetensors المدرّب لديك
اضبط وزن LoRA بين 0.6 و0.8 (القيم الأعلى تطبّق LoRA بقوة أكبر)
اكتب أمرك النصي متضمنًا كلمة المحفّز
اضبط CFG على 7.0، والخطوات على 30، وأخذ العينات على DPM++ 2M
p-image-lora هو البديل الأسرع عندما تحتاج إلى تكرار سريع. يشغّل مهايئات LoRA بسرعة تقارب 2x سرعة Flux Dev، وهذا مهم عند اختبار 20 أمرًا نصيًا مختلفًا في جلسة واحدة.
لتعديل الصورة بعد التوليد، يتيح لك Qwen Image Edit Plus LoRA تطبيق تعديلات قائمة على التعليمات فوق المخرجات المولّدة، لضبط الإضاءة أو تفاصيل الملابس أو عناصر الخلفية دون إعادة توليد الصورة كاملة من الصفر.
SDXL للتحكم في الوضعية
عندما تحتاج إلى تحكم دقيق في وضعية الجسم والتكوين، يضيف SDXL Multi ControlNet LoRA تكييفًا للوضعية فوق أوزانك المضبوطة. تغذّيه بهيكل OpenPose أو بصورة مرجعية، فينتج النموذج شخصًا يطابق تلك الوضعية بالضبط مع تطبيق أسلوب LoRA الخاص بك.
هذا مفيد بشكل خاص في محتوى NSFW حيث تكون الدقة التشريحية حاسمة. بدلًا من الأمل في أن يفسر النموذج "وضعية الاستلقاء" بشكل صحيح، تحدد الوضعية بدقة بمرجع، ودع LoRA يتولى الأسلوب وتفاصيل البشرة.
SDXL ControlNet LoRA هو الإصدار ذو ControlNet واحد، وهو أسرع قليلًا ويكفي لمعظم الحالات التي تحتاج فيها إلى إشارة تكييف واحدة فقط.
الأخطاء الشائعة التي تفسد الجودة
هذه الأخطاء مسؤولة عن 90% من نتائج الضبط الدقيق السيئة.
1. التدريب على عدد قليل جدًا من الصور
خمس عشرة صورة ليست مجموعة بيانات، بل نقطة انطلاق فقط. بهذا العدد، يحفظ النموذج صورًا محددة بدلًا من تعلّم المفهوم. ستعكس المخرجات صور التدريب مباشرة بدلًا من التعميم عنها.
2. معدل تعلم مرتفع جدًا
أكثر الأعراض شيوعًا: مخرجاتك تشبه تمامًا إحدى صور التدريب بدلًا من مزيج من المفهوم. اخفض معدل التعلم إلى عُشر قيمته، وأعد التدريب من نفس checkpoint الأساسي.
3. تجاهل الأمر النصي السلبي
الأمر النصي السلبي القوي يزيل قطع CGI والأخطاء التشريحية وتسرب الأسلوب من النموذج الأساسي. تجاهله يعني التفريط في الجودة في كل توليد.
4. عدم الاختبار عند أوزان LoRA متعددة
وزن LoRA يساوي 1.0 يكون قويًا جدًا في الغالب. اختبر عند 0.5 و0.7 و0.85 و1.0 لإيجاد النقطة المثالية. معظم LoRA المدرَّبة جيدًا تبلغ ذروتها بين 0.7 و0.85.
5. أساليب مختلطة في مجموعة البيانات
إذا كانت نصف صور التدريب لقطات ذهبية دافئة في الساعة الذهبية والنصف الآخر لقطات استوديو باردة، فلن يتعلم النموذج شيئًا متماسكًا عن الإضاءة. اختر أسلوبًا واحدًا لكل LoRA والتزم به بالكامل.
💡 قاعدة 48 ساعة: بعد التدريب، انتظر 48 ساعة قبل تقييم LoRA. النظر إليه مباشرة بعد جلسة تدريب طويلة يخلق انطباعات خاطئة. العين الجديدة تلتقط المشكلات الحقيقية التي يخفيها الحماس.
كيف يبدو النموذج المضبوط
هذه مقارنة قبل وبعد ملموسة من النموذج الأساسي نفسه:
أمر النموذج الأساسي: beautiful woman in lingerie, soft lighting, photorealistic
النتيجة: عامة، مسطحة، تشريح غير صحيح، وإضاءة غير حاسمة.
النموذج المضبوط، بالأمر النصي نفسه مع كلمة المحفّز: nvs_glamour, beautiful woman in ivory camisole, soft window light from left, 85mm f/1.4, film grain
النسخة المضبوطة ليست أفضل فقط. إنها فئة مختلفة من المخرجات. الأولى صورة من مخزون الصور، والثانية صورة تحريرية (editorial). هذا ما تنتجه 40 صورة منتقاة بعناية و 2,000 خطوة تدريب فعلًا عند ضبطها بشكل صحيح.
ما يهم أكثر في تلك المقارنة ليس الدقة أو الحدة، بل التحديد. النموذج المضبوط لديه رأي حول ما يجب أن تبدو عليه مخرجاته. أما النموذج الأساسي فليس لديه رأي. ذلك الرأي هو LoRA.
هل أنت مستعد لإنشاء نموذجك الخاص؟
الآن لديك كل ما تحتاجه لبدء بناء نماذج مضبوطة تنتج صورًا لا يستطيع أي نموذج أساسي عام مجاراتها. الفجوة بين LoRA مدرّب جيدًا والمخرجات الافتراضية ليست طفيفة. إنها الفرق بين تصوير المخزون وجلسة تصوير تحريرية شخصية.
أسرع طريق للمضي قدمًا هو تشغيل أوامرك النصية الأولى عبر Flux Dev LoRA أو p-image-lora على PicassoIA، لترى كيف تبدو جودة مخرجات LoRA قبل أن تستثمر وقتًا في تدريب نموذجك الخاص. وعندما يصبح لديك معيار لما هو جيد، يمكنك التكرار نحوه عبر جولات تدريب مركّزة.
تمنحك المنصة أيضًا إمكانية الوصول إلى Realistic Vision v5.1، RealVisXL v3.0 Turbo، و SDXL جنبًا إلى جنب. هذا النوع من اختبار A/B السريع هو ما يساعدك على اتخاذ قرارات مستنيرة حول النموذج الأساسي الذي تستثمر فيه حوسبة الضبط الدقيق، دون الالتزام بجولة تدريب تستغرق 90 دقيقة فقط لتكتشف أن النموذج كان الخيار الخاطئ.
ابدأ بمجموعة بيانات مركّزة واحدة، وكلمة محفّز واحدة، وجولة تدريب واحدة مضبوطة بشكل جيد. أول LoRA يعلّمك أكثر من أي مصدر مكتوب.