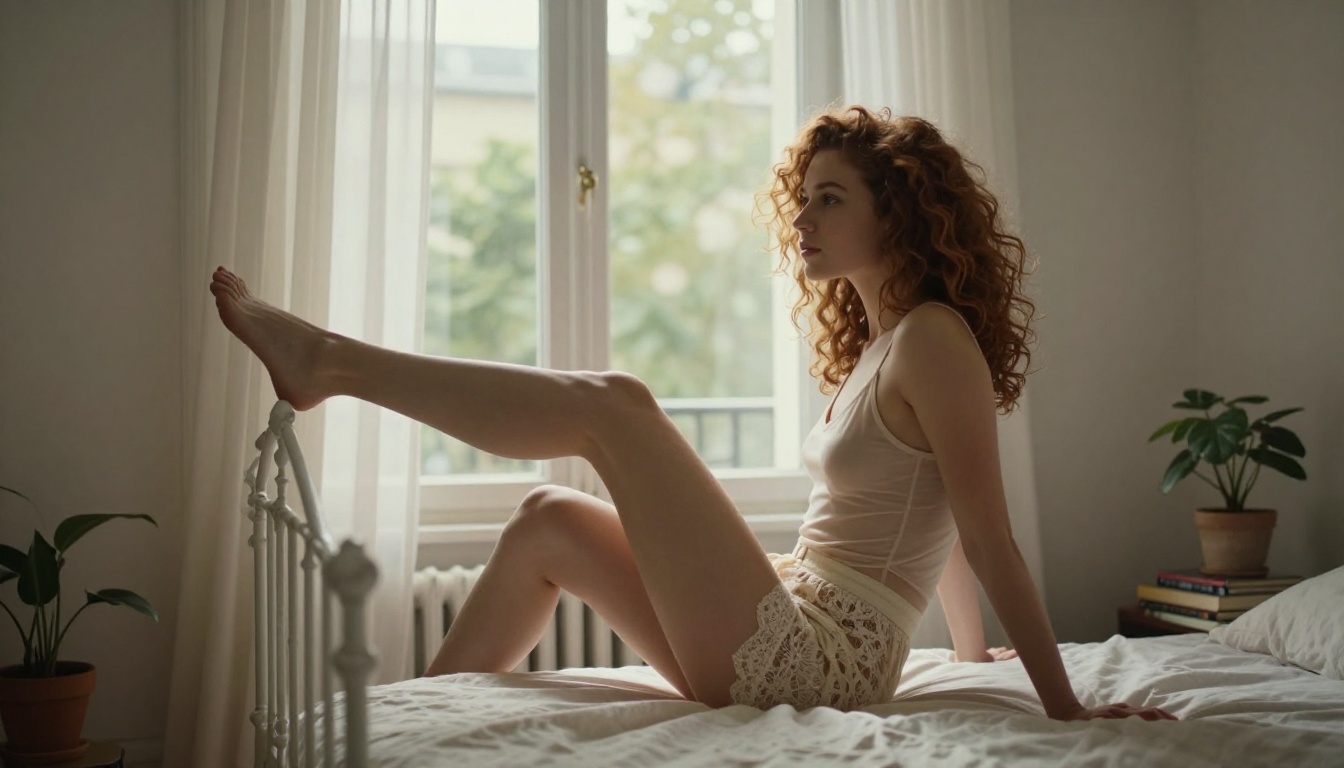
Como fazer fine-tuning de modelos de IA para conteúdo NSFW que realmente parece real
Um detalhamento completo de como fazer fine-tuning de modelos de geração de imagens por IA para conteúdo adjacente a NSFW. Aborda a escolha do modelo base, a curadoria do dataset com quantidade de imagens e legendas, parâmetros de treinamento LoRA, palavras-gatilho, configurações de CFG e como rodar modelos com fine-tuning em plataformas de IA para imagens fotorrealistas de glamour e de estilo artístico.
Fazer fine-tuning de um modelo de IA para conteúdo NSFW é um desses temas que a maioria das plataformas se recusa a explicar direito. Você encontra posts vagos, tutoriais quebrados e fóruns cheios de contradições. Este artigo corta tudo isso. Não importa se você quer fotos de glamour fotorrealistas, imagens artísticas no estilo boudoir ou fotografia de moda sugestiva que um modelo base genérico simplesmente se recusa a gerar com a qualidade que você precisa: o fine-tuning é a resposta. E ele é mais acessível do que a maioria imagina. A diferença entre um resultado medíocre e algo genuinamente publicável não são prompts melhores. É um modelo bem treinado que entende sua estética em um nível fundamental.
Por que modelos genéricos ficam aquém
O problema de usar um modelo base pronto para conteúdo adjacente a adulto é simples: ele foi treinado com tudo. Ou seja, a compreensão do modelo sobre a figura humana fica diluída em milhões de estilos, formas de arte e contextos. Quando você pede um visual específico, um tom de pele específico ou um clima específico, ele faz uma média. Os resultados são tecnicamente corretos, mas esteticamente genéricos.
O fine-tuning resolve isso ao retreinar os pesos do modelo com um dataset curado e focado. Em vez de fazer média com a internet inteira, o modelo aprende exatamente o que você quer que ele produza. A diferença não é incremental. É categórica.
💡 Pense assim: um modelo base é um fotógrafo generalista que já fotografou casamentos, vida selvagem, esportes e comida. Um modelo com fine-tuning é um especialista em glamour que já fotografou 500 retratos editoriais. O especialista vence sempre.
Também existe um ângulo de moderação de conteúdo. Muitos modelos base têm suas saídas direcionadas durante o treinamento para reduzir resultados explícitos. Fazer fine-tuning no seu próprio hardware, com seu próprio dataset, dá controle direto sobre o que o modelo faz e o que não faz.
Pesos pré-treinados ou personalizados
Os pesos de modelos pré-treinados são o ponto de partida. Eles carregam bilhões de associações aprendidas entre tokens de texto e padrões visuais. O fine-tuning não apaga essas associações. Ele as empurra em uma direção específica, preservando a base.
É por isso que fazer fine-tuning com 20 a 50 imagens produz resultados surpreendentemente fortes. Você não está começando do zero. Está direcionando um sistema já poderoso, que já sabe como é um ser humano, como é a textura da pele e como é a luz suave. Seu trabalho é dizer a ele qual versão específica dessas coisas você quer.
O método LoRA
Low-Rank Adaptation (LoRA) é o método de fine-tuning mais prático para criadores individuais. Em vez de retreinar todos os bilhões de parâmetros do modelo (o que exige hardware industrial e semanas de computação), o LoRA treina um pequeno conjunto de pesos adaptadores que ficam sobre o modelo base.
Na prática: o treinamento leva de 30 a 90 minutos em uma GPU de consumo, o arquivo resultante costuma ter de 50 a 200 MB, e o adaptador pode ser trocado sem tocar no modelo base. Você pode até combinar vários LoRAs em uma única geração, misturando estilos ou conceitos diferentes com influência ponderada. Essa flexibilidade é o que faz do LoRA o padrão para os fluxos de trabalho de fine-tuning NSFW hoje.
O DreamBooth é a alternativa, produzindo arquivos de checkpoint completos em vez de adaptadores. As saídas costumam ter um pouco mais de fidelidade, mas o tamanho dos arquivos (2 a 7 GB cada) e os requisitos de treinamento tornam o LoRA a escolha prática para a maioria dos fluxos de trabalho.
Escolhendo o modelo base certo
A escolha do modelo base define um teto para o que é possível. Estas são as principais opções e onde cada uma se destaca:
Flux Dev atualmente produz as figuras humanas mais fotorrealistas de todos os modelos disponíveis publicamente. Sua compreensão de anatomia, textura da pele e resposta à iluminação é claramente superior à das arquiteturas mais antigas. Para o fine-tuning NSFW, isso importa muito: um dos modos de falha mais comuns na geração de conteúdo adulto são figuras anatomicamente incorretas, e o FLUX lida com isso melhor que seus antecessores.
SDXL continua relevante por causa do seu enorme ecossistema de LoRAs. Existem milhares de LoRAs de SDXL prontos para estéticas, tipos de corpo e estilos específicos. Se você quer combinar vários LoRAs em uma única geração, o suporte a múltiplos adaptadores do SDXL por meio do SDXL Multi ControlNet LoRA não tem igual.
O Stable Diffusion 1.5 é a opção legada. É rápido e tem a biblioteca de LoRAs mais extensa, mas sua resolução máxima e o teto geral de realismo o tornam inadequado para trabalhos fotorrealistas modernos. Se você está começando do zero hoje, pule o SD 1.5.
Por que o Realistic Vision vence na pele
Realistic Vision v5.1 foi especificamente ajustado por seus criadores para saídas fotográficas. Ele lida com textura da pele, poros, imperfeições naturais e a queda de luz na pele humana melhor que o SDXL puro. Para conteúdo NSFW em que a qualidade da pele é fundamental, começar seu próprio fine-tuning sobre o Realistic Vision dá uma vantagem significativa.
RealVisXL v3.0 Turbo leva a mesma filosofia para a arquitetura XL, produzindo saídas em resolução maior com realismo comparável. Para iterações rápidas, sua vantagem de velocidade faz dele a base preferida para treinamentos exploratórios.
Montando um dataset adequado
É aqui que a maioria das pessoas falha. Um dataset mal curado produz um modelo que não pode ser direcionado com prompts. Lixo entra, lixo sai: o princípio se aplica com mais rigor no fine-tuning do que em quase qualquer outro lugar do aprendizado de máquina.
Regras de quantidade e qualidade de imagens
O mínimo viável para um LoRA NSFW focado são 20 imagens. O ponto ideal são 40 a 80 imagens. Acima de 200 imagens você começa a ter retornos decrescentes sem um aumento proporcional no tempo de treinamento.
Cada imagem do seu dataset deve atender a estes padrões:
Resolução: mínimo de 768x768 pixels. Idealmente 1024x1024 ou mais.
Consistência: todas as imagens devem compartilhar o tema que você quer ajustar. Se você está treinando um estilo, todas as imagens devem refletir esse estilo.
Variedade dentro do foco: diferentes condições de iluminação, ângulos e distâncias. Um dataset de 50 closes frontais quase idênticos, com luz frontal, produz um modelo que não consegue lidar com nada diferente.
Zero marcas d’água: sem colagens, sem capturas de tela e sem imagens compostas.
Foco nítido: imagens de treinamento desfocadas ensinam o modelo a produzir saídas desfocadas.
💡 Dica de profissional: inclua de 10 a 15% do dataset como imagens de regularização, fotos da categoria geral que NÃO são o seu tema específico. Isso evita overfitting e ajuda o modelo a generalizar corretamente quando recebe prompts novos.
Para conteúdo de glamour e boudoir especificamente, seu dataset deve abranger pelo menos três configurações de iluminação distintas (janela natural, softbox de estúdio, luz ambiente baixa), duas a três faixas de distância (retrato de close, plano médio, corpo inteiro) e pelo menos quatro escolhas diferentes de figurino ou styling. Essa variedade é o que torna o modelo treinado responsivo em vez de rígido.
Legendas que realmente treinam
Ferramentas de legendagem automática como BLIP2 e WD Tagger geram legendas tecnicamente precisas. Mas para o fine-tuning NSFW, você quer legendas manuais que descrevam exatamente o que você quer que o modelo associe à sua palavra-gatilho.
Uma boa legenda de treinamento:
[trigger_word], a woman with auburn hair wearing a sheer camisole,
sitting on a white bed, soft window light, photorealistic,
film grain, 85mm portrait photography
Uma legenda de treinamento ruim:
woman sitting on bed near window
A diferença não é sutil. A legenda detalhada ensina ao modelo quais características visuais pertencem ao seu conceito. A legenda mínima ensina quase nada. Dedique de 15 a 20 minutos por imagem às legendas. É o investimento de maior retorno sobre o tempo em todo o fluxo de trabalho.
Treinamento LoRA passo a passo
Depois que seu dataset estiver preparado e legendado, o treinamento em si é direto se você souber quais parâmetros definir. Ferramentas como Kohya_ss, EveryDream 2 e SimpleTuner oferecem interfaces gráficas que expõem os parâmetros críticos sem exigir conhecimento de linha de comando.
Parâmetros que realmente importam
A maioria das ferramentas de treinamento LoRA expõe dezenas de parâmetros. Os que de fato fazem diferença são:
Taxa de aprendizado: comece em 1e-4 para a rede LoRA. Alta demais e o modelo esquece seu conhecimento base. Baixa demais e o treinamento não converge em um número razoável de passos.
Rank da rede (r): controla o tamanho do adaptador LoRA. Para trabalhos de detalhe fino, como textura da pele e traços faciais, use rank 32 ou 64. Ranks mais altos capturam mais nuances, mas produzem arquivos maiores e exigem mais VRAM.
Passos de treinamento: para um dataset de 40 imagens, mire em 1.500 a 2.500 passos. Uma fórmula simples: (number of images) x 30 = target steps.
Tamanho do lote: use 1 se você estiver em uma única GPU com menos de 16 GB de VRAM. Lotes maiores são mais rápidos, mas não são estritamente necessários para a qualidade.
Parâmetro
Valor recomendado
Efeito
Taxa de aprendizado
1e-4
Controla a velocidade de adaptação
Rank da rede
32 a 64
Capacidade do adaptador
Passos de treinamento
1.500 a 2.500
Total de iterações de treinamento
Clip skip
2
Funciona com a arquitetura SDXL
Resolução
1024x1024
Igual à resolução de saída
Scheduler
cosine with restarts
Evita picos de loss
Palavras-gatilho e isolamento de conceito
Uma palavra-gatilho é um token de texto que ativa seu LoRA quando incluído em um prompt. Sem uma, a influência do LoRA se espalha por todas as gerações de forma imprevisível.
Escolha algo que ainda não exista no vocabulário do modelo. Palavras inventadas funcionam bem: xk3r_style, aur3lia_portrait, nvs_glamour. Se você usar uma palavra real como "glamour" ou "retrato", os efeitos do LoRA serão parcialmente ativados mesmo quando você não quiser.
💡 O teste de isolamento: depois do treinamento, gere 10 imagens SEM sua palavra-gatilho. Se o estilo ou o tema do LoRA aparecer nessas imagens, sua palavra-gatilho é genérica demais ou sua taxa de aprendizado estava alta demais.
Testando seu modelo com fine-tuning
O treinamento terminou. Agora vem a validação, e é aqui que a maioria das pessoas se apressa e deixa passar problemas de qualidade que seriam fáceis de corrigir com mais uma rodada de treinamento.
Estrutura de prompt para melhores resultados
Um prompt bem estruturado para um modelo NSFW com fine-tuning segue este modelo:
O prompt negativo importa tanto quanto seu prompt positivo:
cartoon, illustration, 3D render, CGI, painting,
watermark, blurry, deformed anatomy, extra limbs,
bad hands, low resolution, oversaturated
Escala CFG, passos e amostragem
Estes três parâmetros controlam o processo de geração diretamente:
CFG Scale: de 6 a 8 para saídas fotorrealistas. Valores mais baixos dão ao modelo mais liberdade criativa. Valores mais altos o empurram com mais força para o seu prompt, muitas vezes às custas da naturalidade.
Passos: 25 a 35 é o ponto ideal. Abaixo de 20 você obtém artefatos de ruído visíveis. Acima de 50, os retornos caem bruscamente.
Amostrador: DPM++ 2M Karras é a escolha confiável para trabalhos fotorrealistas. Euler A produz um pouco mais de variação se você quiser explorar um conceito antes de se comprometer com a composição final.
Executando modelos LoRA na PicassoIA
Se você não quer gerenciar uma infraestrutura de treinamento local, pode trabalhar diretamente com os modelos habilitados para LoRA disponíveis na plataforma, sem configurar seu próprio ambiente de GPU.
Usando o Flux Dev LoRA
Flux Dev LoRA é a opção principal para trabalhos de retrato fotorrealista. Ele aceita pesos LoRA externos e os aplica no momento da inferência. O fluxo de trabalho:
Envie seu arquivo LoRA treinado .safetensors
Defina o peso do LoRA entre 0,6 e 0,8 (valores mais altos aplicam o LoRA com mais intensidade)
Escreva seu prompt incluindo sua palavra-gatilho
Defina o CFG como 7,0, os passos como 30 e o amostrador como DPM++ 2M
p-image-lora é a alternativa mais rápida quando você precisa de iteração rápida. Ele roda adaptadores LoRA cerca de 2x mais rápido que o Flux Dev, o que importa quando você testa 20 variações de prompt em uma única sessão.
Para edição de imagem depois da geração, o Qwen Image Edit Plus LoRA permite aplicar edições baseadas em instruções sobre as saídas geradas, ajustando iluminação, detalhes de roupa ou elementos do fundo sem regenerar a imagem inteira do zero.
SDXL para controle de pose
Quando você precisa de controle preciso sobre a posição do corpo e a composição, o SDXL Multi ControlNet LoRA adiciona condicionamento de pose sobre seus pesos com fine-tuning. Você fornece um esqueleto OpenPose ou uma imagem de referência, e o modelo gera uma figura que corresponde àquela pose exata enquanto aplica o estilo do seu LoRA.
Isso é especialmente valioso para conteúdo NSFW em que a precisão anatômica é crítica. Em vez de torcer para o modelo interpretar corretamente "pose reclinada", você define a pose exata com uma referência e deixa o LoRA cuidar do estilo e dos detalhes da pele.
O SDXL ControlNet LoRA é a versão com um único ControlNet, um pouco mais rápida e suficiente para a maioria dos casos em que você só precisa de um sinal de condicionamento.
Erros comuns que matam a qualidade
Estes erros respondem por 90% dos maus resultados de fine-tuning.
1. Treinar com poucas imagens
Quinze imagens não são um dataset. São um ponto de partida. Com essa quantidade, seu modelo memoriza imagens específicas em vez de aprender o conceito. As saídas vão repetir diretamente suas imagens de treinamento em vez de generalizar a partir delas.
2. Taxa de aprendizado alta demais
O sintoma mais comum: sua saída fica exatamente igual a uma das suas imagens de treinamento em vez de uma mistura do conceito. Reduza a taxa de aprendizado em 10 vezes e treine de novo a partir do mesmo checkpoint base.
3. Ignorar o prompt negativo
Um prompt negativo forte remove artefatos de CGI, erros anatômicos e o vazamento de estilo do modelo base. Pular esse passo é abrir mão de qualidade em cada geração.
4. Não testar em múltiplos pesos de LoRA
Um peso de LoRA de 1,0 quase sempre é forte demais. Teste em 0,5, 0,7, 0,85 e 1,0 para encontrar o ponto ideal. A maioria dos LoRAs bem treinados atinge o pico entre 0,7 e 0,85.
5. Estilos misturados no dataset
Se metade das suas imagens de treinamento são fotos quentes na hora dourada e a outra metade são fotos frias de estúdio, o modelo não aprende nada coerente sobre iluminação. Escolha uma estética por LoRA e se comprometa com ela por completo.
💡 A regra das 48 horas: depois do treinamento, espere 48 horas antes de avaliar seu LoRA. Olhar para ele logo depois de uma sessão longa de treinamento cria impressões falsas. Olhos frescos percebem problemas reais que a empolgação mascara.
Como é um modelo com fine-tuning
Aqui está uma comparação concreta de antes e depois, a partir do mesmo modelo base:
Prompt do modelo base: beautiful woman in lingerie, soft lighting, photorealistic
Modelo com fine-tuning, mesmo prompt mais a palavra-gatilho: nvs_glamour, beautiful woman in ivory camisole, soft window light from left, 85mm f/1.4, film grain
Resultado: textura de pele específica, direção de luz coerente, anatomia correta, estética coerente.
A versão com fine-tuning não é apenas melhor. É uma categoria diferente de saída. Uma é uma foto de banco de imagens. A outra é um ensaio editorial. É isso que 40 imagens bem curadas e 2.000 passos de treinamento realmente produzem quando configurados corretamente.
O que mais importa nessa comparação não é a resolução nem a nitidez. É a especificidade. O modelo com fine-tuning tem opiniões sobre como sua saída deve parecer. O modelo base não tem. Essa opinião é o LoRA.
Pronto para criar o seu?
Agora você tem tudo o que precisa para começar a construir modelos com fine-tuning que produzem imagens que nenhum modelo base genérico consegue igualar. A distância entre um LoRA bem treinado e as saídas padrão não é sutil. É a diferença entre uma foto de banco de imagens e um ensaio editorial pessoal.
O caminho mais rápido é rodar seus primeiros prompts pelo Flux Dev LoRA ou pelo p-image-lora na PicassoIA para ver como é a qualidade de uma saída LoRA antes de investir tempo treinando o seu. Quando tiver um benchmark do que é bom, você pode iterar em direção a ela com rodadas de treinamento focadas.
A plataforma também dá acesso ao Realistic Vision v5.1, ao RealVisXL v3.0 Turbo e ao SDXL lado a lado. Esse tipo de teste A/B rápido é como você toma decisões informadas sobre em qual modelo base investir o poder de computação do seu fine-tuning, sem se comprometer com um treinamento de 90 minutos só para descobrir que o modelo era a escolha errada.
Comece com um dataset focado, uma palavra-gatilho e uma rodada de treinamento bem configurada. O primeiro LoRA ensina mais do que qualquer material escrito.