Cómo hacer ajuste fino de modelos de IA para contenido NSFW que de verdad parezca real
Un desglose detallado de cómo hacer ajuste fino de modelos de generación de imágenes con IA para contenido cercano al NSFW. Cubre la selección del modelo base, la curación del dataset con número de imágenes y descripciones, los parámetros de entrenamiento LoRA, las palabras de activación, la configuración de CFG y cómo ejecutar los modelos con ajuste fino en plataformas de IA para lograr imágenes fotorrealistas de glamour y artísticas.
Hacer ajuste fino de un modelo de IA para contenido NSFW es uno de esos temas que la mayoría de las plataformas no explican como es debido. Encuentras artículos vagos, tutoriales rotos y foros llenos de contradicciones. Este artículo lo aclara todo. Tanto si quieres fotos de glamour fotorrealistas, imágenes artísticas tipo boudoir o fotografía de moda sugerente que un modelo base genérico simplemente se niega a generar con la calidad que necesitas, el ajuste fino es la respuesta. Y es más accesible de lo que la mayoría cree. La diferencia entre un resultado mediocre y algo realmente publicable no está en mejores prompts. Está en un modelo bien entrenado que entiende tu estética en lo más profundo.
Por qué los modelos genéricos se quedan cortos
El problema de usar un modelo base tal cual para contenido de temática adulta es simple: se entrenó con todo. Eso significa que su comprensión de una figura humana está diluida entre millones de estilos, formas artísticas y contextos. Cuando le pides un look concreto, un tono de piel concreto o un ambiente concreto, el modelo promedia. Los resultados son técnicamente correctos, pero estéticamente genéricos.
El ajuste fino soluciona esto reentrenando los pesos del modelo con un dataset curado y enfocado. En lugar de promediar todo internet, el modelo aprende exactamente lo que quieres que produzca. La diferencia no es incremental. Es de categoría.
💡 Piénsalo así: un modelo base es un fotógrafo generalista que ha fotografiado bodas, fauna, deporte y comida. Un modelo con ajuste fino es un especialista en glamour que ha fotografiado 500 retratos editoriales. El especialista gana siempre.
También hay un ángulo de moderación de contenido. Muchos modelos base tienen sus resultados orientados durante el entrenamiento para reducir las imágenes explícitas. El ajuste fino en tu propio equipo, con tu propio dataset, te da control directo sobre lo que el modelo produce y lo que no.
Pesos preentrenados frente a personalizados
Los pesos de los modelos preentrenados son el punto de partida. Contienen miles de millones de asociaciones aprendidas entre tokens de texto y patrones visuales. El ajuste fino no borra esas asociaciones. Las empuja en una dirección concreta manteniendo la base.
Por eso el ajuste fino con 20 a 50 imágenes produce resultados sorprendentemente sólidos. No partes de cero. Estás orientando un sistema ya potente que ya sabe cómo es un ser humano, cómo se ve la textura de la piel y cómo se ve la luz suave. Tu trabajo es decirle qué versión concreta de esas cosas quieres.
El método LoRA
Low-Rank Adaptation (LoRA) es el método de ajuste fino más práctico para creadores individuales. En lugar de reentrenar todos los miles de millones de parámetros del modelo (lo que requiere hardware de nivel industrial y semanas de cómputo), LoRA entrena un pequeño conjunto de pesos adaptadores que se colocan sobre el modelo base.
Los resultados prácticos: el entrenamiento tarda de 30 a 90 minutos en una GPU de consumo, el archivo resultante suele pesar entre 50 y 200 MB, y el adaptador puede cambiarse sin tocar el modelo base. Incluso puedes combinar varios LoRA en una misma generación, mezclando estilos o conceptos distintos con una influencia ponderada. Esta flexibilidad es la razón por la que LoRA es hoy el estándar en los flujos de trabajo de ajuste fino NSFW.
DreamBooth es la alternativa, y produce archivos checkpoint completos en lugar de adaptadores. Los resultados suelen tener una fidelidad ligeramente superior, pero el tamaño de los archivos (de 2 a 7 GB cada uno) y sus requisitos de entrenamiento hacen que LoRA sea la opción práctica para la mayoría de flujos de trabajo.
Elegir el modelo base adecuado
La elección del modelo base marca el techo de lo posible. Estas son las principales opciones y en qué destaca cada una:
Flux Dev produce actualmente las figuras humanas más fotorrealistas de cualquier modelo disponible públicamente. Su comprensión de la anatomía, la textura de la piel y la respuesta a la iluminación es notablemente superior a la de las arquitecturas anteriores. Para el ajuste fino NSFW, esto importa muchísimo: uno de los fallos más comunes en la generación de contenido para adultos son las figuras anatómicamente incorrectas, y FLUX lo gestiona mejor que sus predecesores.
SDXL sigue siendo relevante por su enorme ecosistema de LoRA. Existen miles de LoRA de SDXL ya preparados para estéticas, tipos de cuerpo y estilos concretos. Si quieres combinar varios LoRA en una misma generación, el soporte multiadaptador de SDXL a través de SDXL Multi ControlNet LoRA no tiene rival.
Stable Diffusion 1.5 es la opción heredada. Es rápido y tiene la biblioteca de LoRA más extensa, pero su resolución máxima y su techo de realismo lo hacen inadecuado para el trabajo fotorrealista actual. Si empiezas desde cero hoy, descarta SD 1.5.
Por qué Realistic Vision gana en la piel
Realistic Vision v5.1 fue ajustado específicamente por sus creadores para producir resultados fotográficos. Gestiona la textura de la piel, los poros, las imperfecciones naturales y la caída de la luz sobre la piel humana mejor que el SDXL puro. Para contenido NSFW en el que la calidad de la piel es primordial, empezar tu propio ajuste fino sobre Realistic Vision te da una ventaja considerable.
RealVisXL v3.0 Turbo traslada la misma filosofía a la arquitectura XL, con resultados de mayor resolución y un realismo comparable. Para iterar rápido, su ventaja de velocidad lo convierte en el modelo base preferido para las pruebas de entrenamiento exploratorias.
Crear un dataset adecuado
Aquí es donde falla la mayoría. Un dataset mal curado produce un modelo que no se puede dirigir con prompts. El principio de “basura entra, basura sale” se aplica con más rigor en el ajuste fino que en casi cualquier otra parte del aprendizaje automático.
Reglas de número y calidad de las imágenes
El mínimo viable para un LoRA NSFW enfocado son 20 imágenes. El punto ideal está entre 40 y 80 imágenes. A partir de 200 imágenes empiezas a encontrar rendimientos decrecientes sin un aumento proporcional del tiempo de entrenamiento.
Cada imagen de tu dataset debe cumplir estos estándares:
Resolución: Mínimo 768x768 píxeles. Lo ideal es 1024x1024 o más.
Coherencia: Todas las imágenes deben compartir el tema que quieres ajustar. Si estás entrenando un estilo, todas las imágenes deben reflejar ese estilo.
Variedad dentro del enfoque: Distintas condiciones de iluminación, ángulos y distancias. Un dataset de 50 primeros planos casi idénticos con luz frontal produce un modelo que no sabe manejar nada más.
Cero marcas de agua: Sin collages, sin capturas de pantalla ni imágenes compuestas.
Enfoque nítido: Las imágenes de entrenamiento borrosas enseñan al modelo a producir resultados borrosos.
💡 Consejo profesional: incluye entre el 10 y el 15 % de tu dataset como imágenes de regularización, fotos de la categoría general que NO son tu tema específico. Esto evita el sobreajuste y ayuda al modelo a generalizar bien cuando recibe prompts nuevos.
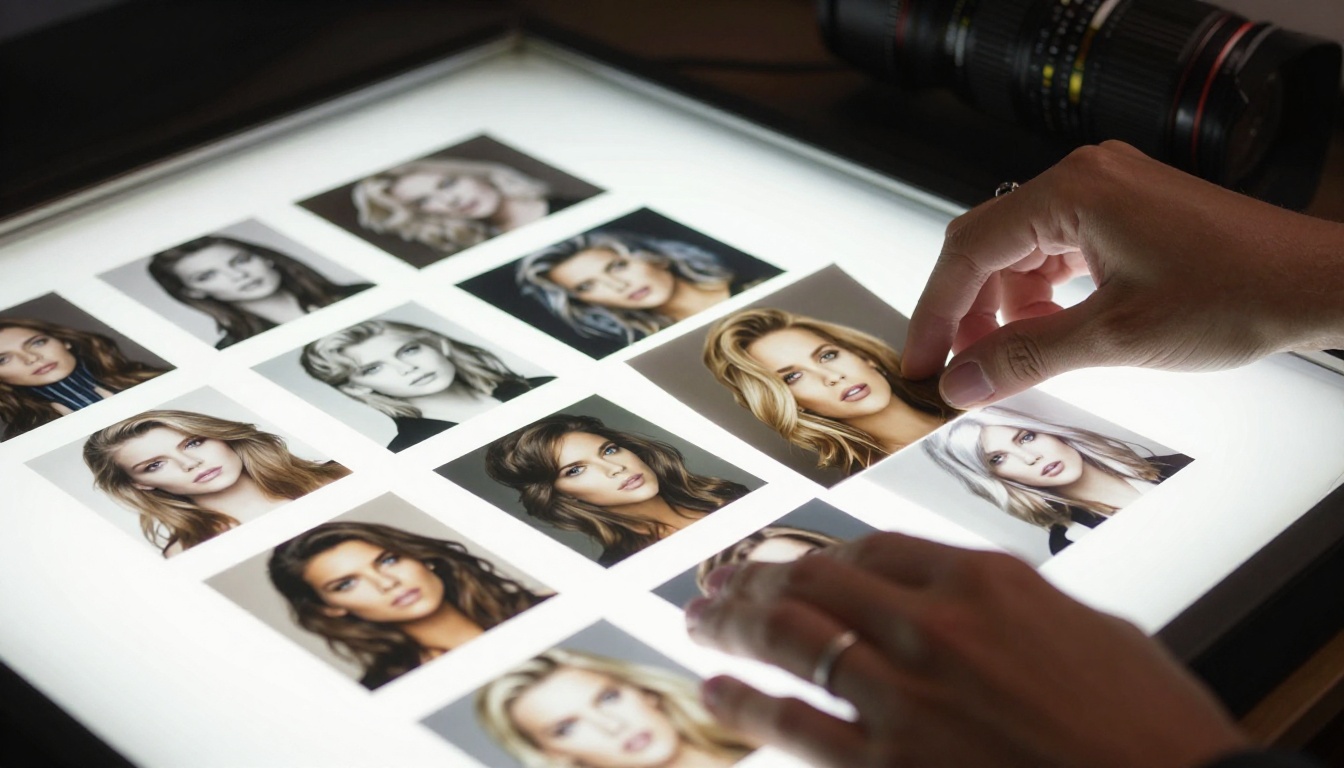
En el caso concreto del contenido de glamour y boudoir, tu dataset debe abarcar al menos tres configuraciones de luz distintas (ventana natural, softbox de estudio, luz ambiental tenue), dos o tres rangos de distancia (retrato en primer plano, plano medio, cuerpo entero) y al menos cuatro opciones distintas de vestuario o estilismo. Esta variedad es lo que hace que el modelo entrenado responda en lugar de ser rígido.
Descripciones que sí entrenan
Las herramientas de descripción automática como BLIP2 y WD Tagger generan descripciones técnicamente precisas. Pero para el ajuste fino NSFW, lo que necesitas son descripciones manuales que expliquen exactamente lo que quieres que el modelo asocie con tu palabra de activación.
Una buena descripción de entrenamiento:
[trigger_word], a woman with auburn hair wearing a sheer camisole,
sitting on a white bed, soft window light, photorealistic,
film grain, 85mm portrait photography
Una mala descripción de entrenamiento:
woman sitting on bed near window
La diferencia no es sutil. La descripción detallada enseña al modelo qué rasgos visuales pertenecen a tu concepto. La descripción mínima le enseña casi nada. Dedica entre 15 y 20 minutos a la descripción de cada imagen. Es la inversión de tiempo con mayor rentabilidad de todo el flujo de trabajo.
Entrenamiento LoRA paso a paso
Una vez preparado y descrito el dataset, el entrenamiento en sí es sencillo si sabes qué parámetros configurar. Herramientas como Kohya_ss, EveryDream 2 y SimpleTuner ofrecen interfaces gráficas que muestran los parámetros críticos sin necesidad de experiencia en línea de comandos.
Los parámetros que realmente importan
La mayoría de las herramientas de entrenamiento LoRA exponen decenas de parámetros. Estos son los que de verdad marcan la diferencia:
Tasa de aprendizaje: empieza en 1e-4 para la red LoRA. Si es demasiado alta, el modelo olvida su conocimiento base. Si es demasiado baja, el entrenamiento no converge en un número razonable de pasos.
Rango de red (r): controla el tamaño del adaptador LoRA. Para trabajo de detalle fino, como la textura de la piel y los rasgos faciales, usa rango 32 o 64. Los rangos más altos captan más matices, pero producen archivos más grandes y requieren más VRAM.
Pasos de entrenamiento: para un dataset de 40 imágenes, apunta a entre 1.500 y 2.500 pasos. Una fórmula sencilla: (number of images) x 30 = target steps.
Tamaño de lote: usa 1 si trabajas con una sola GPU de menos de 16 GB de VRAM. Los lotes más grandes son más rápidos, pero no son estrictamente necesarios para la calidad.
Parámetro
Valor recomendado
Efecto
Tasa de aprendizaje
1e-4
Controla la velocidad de adaptación
Rango de red
32 a 64
Capacidad del adaptador
Pasos de entrenamiento
1.500 a 2.500
Iteraciones totales de entrenamiento
Clip skip
2
Funciona con la arquitectura SDXL
Resolución
1024x1024
Igualar la resolución de salida
Scheduler
cosine with restarts
Evita los picos de pérdida
Palabras de activación y aislamiento del concepto
Una palabra de activación es un token de texto que activa tu LoRA cuando se incluye en un prompt. Sin una, la influencia del LoRA se filtra en cada generación de forma impredecible.
Elige algo que no exista ya en el vocabulario del modelo. Las palabras inventadas funcionan bien: xk3r_style, aur3lia_portrait, nvs_glamour. Si usas una palabra real como «glamour» o «retrato», los efectos del LoRA se activarán parcialmente aunque no lo quieras.
💡 La prueba de aislamiento: tras el entrenamiento, genera 10 imágenes SIN tu palabra de activación. Si el estilo o el tema del LoRA se ven en esas imágenes, tu palabra de activación es demasiado genérica o tu tasa de aprendizaje era demasiado alta.
Probar tu modelo con ajuste fino
El entrenamiento ha terminado. Ahora llega la validación, y aquí es donde la mayoría se precipita y pasa por alto problemas de calidad que habrían sido fáciles de corregir con un entrenamiento más.
Estructura del prompt para mejores resultados
Un prompt bien estructurado para un modelo NSFW con ajuste fino sigue esta plantilla:
El prompt negativo es tan importante como el prompt positivo:
cartoon, illustration, 3D render, CGI, painting,
watermark, blurry, deformed anatomy, extra limbs,
bad hands, low resolution, oversaturated
Escala CFG, pasos y muestreo
Estos tres parámetros controlan directamente el proceso de generación:
Escala CFG (guidance scale): entre 6 y 8 para resultados fotorrealistas. Indica cuánto se ajusta la imagen al prompt. Los valores bajos dan más libertad creativa al modelo. Los valores altos lo empujan con más fuerza hacia tu prompt, a menudo a costa de la naturalidad.
Pasos: entre 25 y 35 es el punto ideal. Por debajo de 20 aparecen artefactos de ruido visibles. Por encima de 50, los rendimientos caen bruscamente.
Muestreador: DPM++ 2M Karras es la opción fiable para el trabajo fotorrealista. Euler A produce algo más de variación si quieres explorar un concepto antes de decidir la composición final.
Ejecutar modelos LoRA en PicassoIA
Si no quieres gestionar una infraestructura de entrenamiento local, puedes trabajar directamente con modelos compatibles con LoRA disponibles en la plataforma, sin montar tu propio entorno de GPU.
Usar Flux Dev LoRA
Flux Dev LoRA es el modelo insignia para el trabajo de retratos fotorrealistas. Acepta pesos LoRA externos y los aplica en el momento de la inferencia. El flujo de trabajo:
Sube tu archivo LoRA .safetensors entrenado
Ajusta el peso del LoRA entre 0,6 y 0,8 (los valores más altos aplican el LoRA con más intensidad)
Escribe tu prompt incluyendo tu palabra de activación
Fija el CFG en 7,0, los pasos en 30 y el muestreador en DPM++ 2M
p-image-lora es la alternativa más rápida cuando necesitas iterar con rapidez. Ejecuta adaptadores LoRA a unas 2 veces la velocidad de Flux Dev, lo que importa cuando pruebas 20 variaciones de prompt distintas en una sola sesión.
Para editar imágenes después de generarlas, Qwen Image Edit Plus LoRA te permite aplicar ediciones basadas en instrucciones sobre los resultados generados, ajustando la iluminación, los detalles de la ropa o los elementos del fondo sin regenerar la imagen entera desde cero.
SDXL para el control de la pose
Cuando necesitas un control preciso de la posición del cuerpo y la composición, SDXL Multi ControlNet LoRA añade condicionamiento de pose sobre tus pesos con ajuste fino. Le proporcionas un esqueleto de OpenPose o una imagen de referencia, y el modelo genera una figura que coincide con esa pose exacta aplicando el estilo de tu LoRA.
Esto es especialmente valioso en contenido NSFW, donde la precisión anatómica es crítica. En lugar de confiar en que el modelo interprete bien «pose reclinada», defines la pose exacta con una referencia y dejas que el LoRA se encargue del estilo y el detalle de la piel.
SDXL ControlNet LoRA es la versión con un solo ControlNet, algo más rápida y suficiente para la mayoría de casos en los que solo necesitas una señal de condicionamiento.
Errores comunes que arruinan la calidad
Estos errores explican el 90 % de los malos resultados del ajuste fino.
1. Entrenar con muy pocas imágenes
Quince imágenes no son un dataset. Son un punto de partida. Con ese número, el modelo memoriza imágenes concretas en lugar de aprender el concepto. Los resultados repetirán directamente tus imágenes de entrenamiento en lugar de generalizar a partir de ellas.
2. Tasa de aprendizaje demasiado alta
El síntoma más común: tu resultado se parece exactamente a una de tus imágenes de entrenamiento en lugar de a una mezcla del concepto. Reduce la tasa de aprendizaje por un factor de 10 y vuelve a entrenar desde el mismo checkpoint base.
3. Ignorar el prompt negativo
Un prompt negativo sólido elimina los artefactos de CGI, los errores anatómicos y la filtración de estilo del modelo base. Omitirlo supone desaprovechar calidad en cada generación.
4. No probar varios pesos de LoRA
Un peso de LoRA de 1,0 es casi siempre demasiado fuerte. Prueba con 0,5, 0,7, 0,85 y 1,0 para encontrar el punto ideal. La mayoría de los LoRA bien entrenados rinden mejor entre 0,7 y 0,85.
5. Estilos mezclados en el dataset
Si la mitad de tus imágenes de entrenamiento son tomas cálidas de hora dorada y la otra mitad son tomas frías de estudio, el modelo no aprende nada coherente sobre la iluminación. Elige una estética por LoRA y comprométete con ella por completo.
💡 La regla de las 48 horas: tras el entrenamiento, espera 48 horas antes de evaluar tu LoRA. Mirarlo justo después de una sesión de entrenamiento larga crea impresiones falsas. Una mirada fresca detecta los problemas reales que el entusiasmo oculta.
Cómo es un modelo con ajuste fino
Aquí tienes una comparación concreta de antes y después, con el mismo modelo base:
Prompt del modelo base: beautiful woman in lingerie, soft lighting, photorealistic
Resultado: genérico, plano, anatómicamente incorrecto, con una iluminación indecisa.
Modelo con ajuste fino, mismo prompt más la palabra de activación: nvs_glamour, beautiful woman in ivory camisole, soft window light from left, 85mm f/1.4, film grain
Resultado: textura de piel específica, dirección de luz coherente, anatomía correcta, estética coherente.
La versión con ajuste fino no es solo mejor. Es una categoría de resultado distinta. Una es una foto de stock. La otra es un trabajo editorial. Esto es lo que produce de verdad un conjunto de 40 imágenes bien curadas y 2.000 pasos de entrenamiento cuando se configura correctamente.
Lo que más importa en esa comparación no es la resolución ni la nitidez. Es la especificidad. El modelo con ajuste fino tiene criterio sobre cómo debe ser su resultado. El modelo base no lo tiene. Ese criterio es el LoRA.
¿Listo para crear el tuyo?
Ya tienes lo necesario para empezar a construir modelos con ajuste fino que producen imágenes que ningún modelo base genérico puede igualar. La diferencia entre un LoRA bien entrenado y los resultados por defecto no es sutil. Es la diferencia entre la fotografía de stock y una sesión editorial propia.
La forma más rápida de avanzar es probar tus primeros prompts con Flux Dev LoRA o p-image-lora en PicassoIA, para ver cómo es un resultado LoRA de calidad antes de invertir tiempo en entrenar el tuyo. Cuando tengas una referencia de lo que es bueno, puedes iterar hacia ella con entrenamientos enfocados.
La plataforma también te da acceso a Realistic Vision v5.1, RealVisXL v3.0 Turbo y SDXL en paralelo. Ese tipo de pruebas A/B rápidas es la forma de tomar decisiones informadas sobre en qué modelo base invertir tu cómputo de ajuste fino, sin comprometerte a un entrenamiento de 90 minutos solo para descubrir que el modelo era el equivocado.
Empieza con un dataset enfocado, una palabra de activación y una sola sesión de entrenamiento bien configurada. El primer LoRA te enseña más que cualquier recurso escrito.