لا تحتاج إلى فريق تصوير، أو استوديو تسجيل، أو أي خبرة في تحرير الفيديو. مع الأدوات الذكية المناسبة، يمكنك أن تأخذ صورة واحدة لشخص حقيقي وتجعلها تنطق أي نص تكتبه، بشفاه متزامنة تمامًا وصوت طبيعي، في أقل من دقيقتين. لم تعد هذه التقنية تجريبية. إنها تعمل في المتصفحات الآن، ومتاحة لأي شخص.
ما هو الأفاتار الناطق بالذكاء الاصطناعي فعلًا
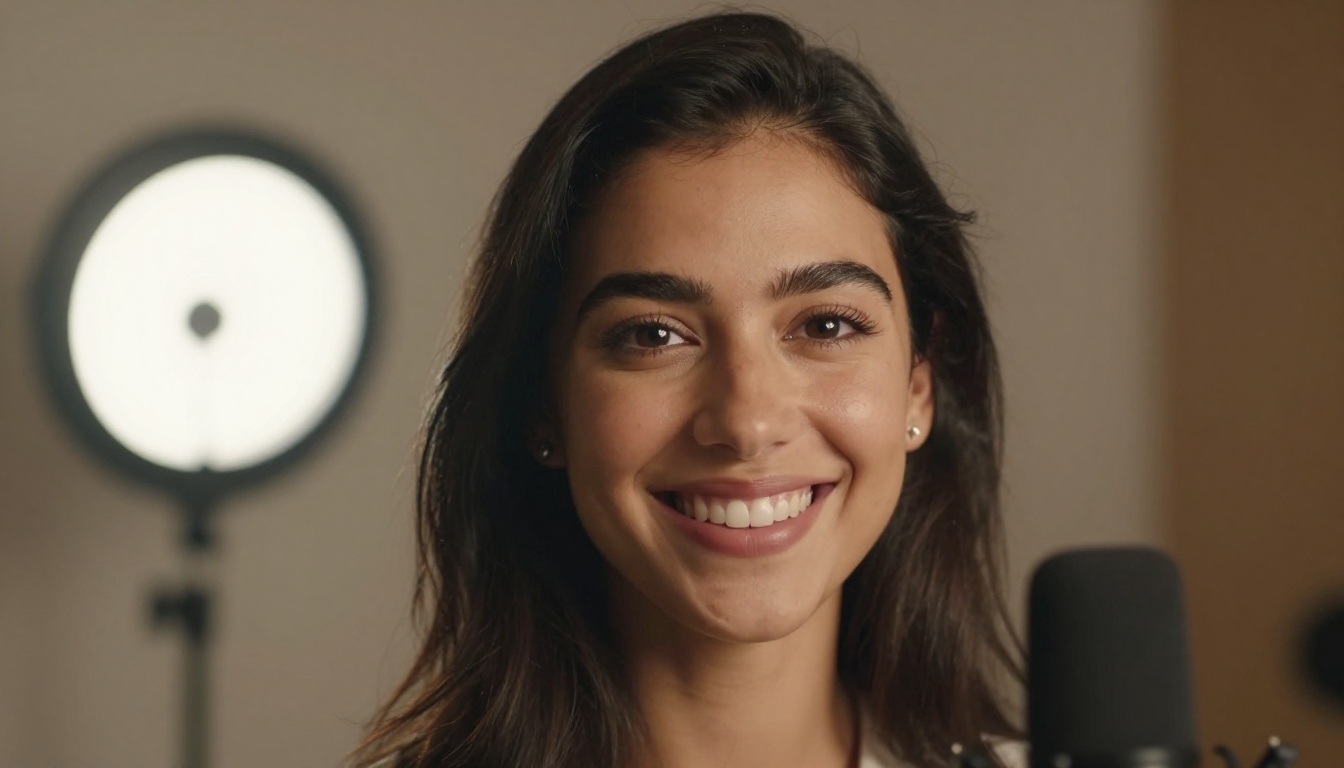
الأفاتار الناطق بالذكاء الاصطناعي هو فيديو يبدو فيه وجه شخص (من صورة ثابتة أو من لقطات فيديو موجودة) وهو ينطق كلمات مدفوعة بمسار صوتي منفصل. يحلل الذكاء الاصطناعي شكل الفم وحركة الفك والتعابير الدقيقة للوجه، ثم يولّد إطارات جديدة تطابق الفونيمات في الصوت. والنتيجة أن يبدو الشخص في الصورة وكأنه يتكلم فعلًا.
تغطي هذه التقنية حالتين استخداميتين مختلفتين. الأولى هي مزامنة الشفاه: أخذ وجه موجود ومزامنته مع صوت جديد. والثانية هي تحريك الجسم كاملًا: توليد لا يقتصر على حركة الشفاه، بل يشمل أيضًا حركة الرأس ولغة الجسد والرمش الطبيعي وحركات الكتفين من صورة شخصية واحدة.
الأجزاء الثلاثة التي تجعل ذلك ممكنًا
يعتمد كل خط إنتاج للأفاتار الناطق على ثلاثة مكونات، ويجب أن يكون كل منها متينًا حتى تبدو النتيجة حقيقية:
- مصدر الوجه: صورة واضحة للوجه من الأمام أو بزاوية خفيفة، مع إضاءة جيدة وبدون عوائق كبيرة (نظارات شمسية، كمامات، شعر يغطي الوجه بالكامل)
- مسار الصوت: صوت كلام نظيف، يُسجَّل أو يُولَّد بمعدل 44.1 كيلوهرتز أو أعلى، بدون ضوضاء خلفية أو صدى في الغرفة
- نموذج مزامنة الشفاه: الذكاء الاصطناعي الذي يقرأ الموجة الصوتية وتوقيتات الفونيمات، ثم يولّد حركة الشفاه والوجه المطابقة على الصورة المصدر
إذا كان أي من هذه العناصر الثلاثة ضعيفًا، تتدهور النتيجة بشكل ملحوظ. صورة مصدر غير واضحة مع ملف صوتي عالي الجودة ستنتج أفاتارًا غير واضح وغير مقنع. يجب أن تكون العناصر الثلاثة متينة.
الصورة الثابتة مقابل تحريك الجسم كاملًا
هناك فرق مهم بين النماذج التي تحرك منطقة الفم فقط والنماذج التي تحرك الرأس والجزء العلوي من الجسم بالكامل. النماذج التي تحرك الفم فقط، مثل Lipsync 2 أو React 1، أسرع وتعمل مع مجموعة أوسع من الصور المدخلة. أما نماذج تحريك الجسم كاملًا، مثل Omni Human 1.5، فتحرك إمالات الرأس والرمش وحركات الكتفين وإيماءات اليدين، مما ينتج نتيجة أكثر طبيعية تصمد على الشاشة لمدة أطول.
كيف تصنع أفاتارًا ناطقًا بالذكاء الاصطناعي خطوة بخطوة
العملية أبسط مما يتوقعه معظم الناس. هناك ثلاث خطوات، ولا يتطلب أي منها عتادًا خاصًا أو برامج مثبتة على جهازك.
الخطوة 1: اختر صورة المصدر
صورتك هي الأساس. كلما كانت الصورة أفضل، كان الأفاتار أفضل. إليك ما يعمل بشكل جيد:
- وجه أمامي أو بزاوية تصل إلى 45 درجة: أي زاوية أبعد من ذلك تبدأ في تشويه حركة الشفاه المولّدة
- وجه جيد الإضاءة: الإضاءة المسطحة والمتساوية (مثل ضوء النهار الغائم أو حلقة الإضاءة) تمنح النموذج أوضح بيانات الوجه للعمل عليها
- بدون عوائق كبيرة: النظارات عادةً مقبولة، لكن النظارات الشمسية الداكنة بالكامل أو الكمامات تسبب مشكلات
- دقة صورة شخصية 512 بكسل على الأقل: تقبل معظم النماذج دقة تصل إلى 1080p؛ كلما كانت دقة الإدخال أعلى، كان الناتج أكثر وضوحًا
- تعبير محايد أو خفيف: ابتسامة مفتوحة الفم تمامًا في الصورة المصدر قد تتعارض مع الحالة الأولية لنموذج مزامنة الشفاه
صور الاستوك، والصور الشخصية الاحترافية، والصور الشخصية العادية كلها مناسبة. لست مقيدًا بوجهك أنت.
الخطوة 2: ولّد صوت التعليق
ما لم تكن تسجل صوتك بنفسك، ستحتاج إلى أداة تحويل النص إلى كلام لإنشاء مسار الصوت. تحدد جودة هذا الصوت بشكل مباشر مدى طبيعية مزامنة الشفاه، لأن الذكاء الاصطناعي يقرأ توقيت الفونيمات من الموجة الصوتية نفسها.
للحصول على كلام يبدو طبيعيًا، يُعد ElevenLabs v3 من أقوى الخيارات على PicassoIA، مع خيارات صوتية معبّرة للغاية عبر عشرات الأساليب. وللسرعة عند الإنتاج الكبير، يقدم Flash v2.5 من ElevenLabs مخرجات سريعة دون التضحية بالوضوح. وإذا كنت تحتاج إلى مخرجات متعددة اللغات، يغطي v2 Multilingual أكثر من 30 لغة مع نبرة طبيعية في كل منها.
💡 نصيحة: ولّد الصوت أولًا واستمع إليه بعناية قبل تشغيل مزامنة الشفاه. أصلح أي أخطاء في النطق أو توقفات محرجة في مخرجات تحويل النص إلى كلام قبل أن تستهلك توليدة على الأفاتار.
الخطوة 3: طبّق مزامنة الشفاه على الصورة
مع صورة نظيفة وملف صوتي نهائي، افتح نموذج مزامنة الشفاه الذي تختاره على PicassoIA. ارفع الصورة كمصدر للوجه، وأرفق الصوت، ثم أرسل الطلب. حسب النموذج وطول الصوت، يستغرق التوليد من 30 ثانية إلى 3 دقائق.
للحصول على أدق مطابقة بين الفونيمات وحركة الشفاه، استخدم Lipsync 2 Pro. وللحصول على أفاتار متحرك بالكامل يبدو فيه الجزء العلوي من الجسم حيًا وحاضرًا، استخدم Omni Human 1.5.
أفضل نماذج مزامنة الشفاه المتاحة الآن
يستضيف PicassoIA 12 نموذجًا لمزامنة الشفاه، تتراوح بين أدوات الدبلجة السريعة ومحركات تحريك الجسم كاملًا. إليك تفصيل لأكثرها كفاءة:
Omni Human 1.5: واقعية الجسم كاملًا
Omni Human 1.5 من ByteDance هو الخيار الأغنى بالميزات لإنشاء أفاتار ناطق من صورة واحدة. فهو لا يحرك الفم فقط. بل يولّد إمالات طبيعية للرأس، ورمشًا، وتعابير دقيقة، وحركة للجزء العلوي من الجسم تتتبع طاقة الصوت المنطوق. كما تُحفظ إيماءات اليدين الظاهرة في الصورة المصدر، وتُحرَّك بشكل خفيف طوال المقطع.
يكون النموذج فعالًا بشكل خاص عندما تُظهر الصورة المصدر الشخص من الخصر فما فوق، لأن ذلك يمنح الذكاء الاصطناعي مساحة أكبر لتحريك الجسم بشكل طبيعي.
P Video Avatar: مصمم للأفاتار
P Video Avatar مصمم خصيصًا لحالة استخدام الأفاتار الناطق. يعالج صور البورتريه والملفات الصوتية معًا، ويُخرج فيديو بحركة شفاه متزامنة وحركة طبيعية للرأس. يعمل بسرعة أكبر من Omni Human 1.5، ويعمل جيدًا مع المقاطع القصيرة التي تقل عن 60 ثانية، ما يجعله خيارًا جيدًا لصناع المحتوى الذين يحتاجون إلى إنجاز سريع.
Fabric 1.0: أي صورة يمكنها أن تتكلم
يتبنى Fabric 1.0 من Veed نهجًا أكثر سهولة. ارفع أي صورة، وقدّم صوتًا أو نصًا، واحصل على فيديو ناطق. يتعامل مع مجموعة أوسع من أنواع الصور والاتجاهات مقارنةً بالنماذج المتخصصة أكثر، ما يجعله خيارًا جيدًا عندما لا تكون صورتك المصدر صورة شخصية مثالية.
الدقة مقابل السرعة في مزامنة الشفاه
للحالات التي تحتاج فيها إلى دبلجة فيديو موجود بسرعة، يعالج Lipsync Speed من HeyGen مزامنة الصوت والفيديو في ثوانٍ. وعندما تكون الدقة أهم من السرعة، ينتج Lipsync Precision محاذاة أدق للفونيمات، ويتعامل بشكل أفضل مع أنماط الكلام المعقدة، خاصة الكلام السريع أو الحروف الساكنة الثقيلة.
كيف تستخدم Omni Human 1.5 على PicassoIA
بما أن Omni Human 1.5 ينتج أكثر النتائج واقعية لتوليد الأفاتار من الصورة، إليك شرحًا كاملًا لاستخدامه على PicassoIA.
ارفع صورة البورتريه الخاصة بك
انتقل إلى صفحة نموذج Omni Human 1.5. في لوحة الإدخال، انقر على منطقة رفع الصور واختر صورة البورتريه المصدر. يجب أن يظهر الوجه بوضوح. إذا كان الشخص ظاهرًا بالكامل، فسيحرك النموذج المنطقة العلوية المرئية من الجسم بما فيها الذراعان والجذع.
متطلبات الصورة لهذا النموذج:
- بصيغة JPEG أو PNG، بدقة 720p على الأقل
- يجب أن يشغل الوجه 30% من الإطار على الأقل
- تجنب الصور التي يقع فيها الوجه في ظل عميق على أحد الجانبين
- وجه أمامي أو بزاوية خفيفة (حتى 45 درجة) يعطي أفضل النتائج
أضف ملف الصوت
يقبل النموذج ملفات الصوت بصيغة MP3 وWAV. ارفع مسار الصوت الذي ولّدته بأداة تحويل النص إلى كلام التي تختارها. إذا سجلت صوتك بنفسك، فصدّره بصيغة WAV نظيفة بمعدل 44.1 كيلوهرتز وبدون ضوضاء خلفية.
لا يوجد حد صارم لمدة الصوت، لكن المقاطع التي تتجاوز 2 دقيقتين قد تتطلب وقت معالجة أطول. في معظم حالات الاستخدام (محتوى وسائل التواصل الاجتماعي، وشروحات المنتجات، والمواد التعليمية)، يمنحك إبقاء المقاطع بين 30 و90 ثانية أوضح النتائج وأكثرها ثباتًا في الحركة.
اضبط الدقة وولّد
يدعم Omni Human 1.5 مخرجات بدقة 480p و720p. للمشاركة على منصات التواصل الاجتماعي أو للتضمين في صفحة ويب، تكون دقة 480p سريعة ونظيفة بصريًا. أما للعروض التقديمية أو للتشغيل على شاشات أكبر، فتستحق دقة 720p الانتظار الأطول قليلًا.
اضغط على توليد وانتظر. يستغرق مقطع مدته 30 ثانية عادةً من 60 إلى 90 ثانية للمعالجة. يعيد النموذج ملف MP4 قابلًا للتنزيل، وجاهزًا للاستخدام مباشرة دون معالجة لاحقة.
أدوات الصوت التي تتناسب جيدًا مع الأفاتار
جودة الصوت نصف المعركة. فالمخرجات الآلية أو غير الطبيعية لتحويل النص إلى كلام ستكسر الانغماس حتى مع أفاتار متزامن تمامًا. هذه هي الأدوات التي تستحق الاستخدام.
للكلام الطبيعي
يُعد ElevenLabs v3 حاليًا من أكثر نماذج تحويل النص إلى كلام تعبيرًا المتاحة في أي مكان، مع تحكم دقيق في العاطفة والإيقاع وأسلوب الإلقاء. ينتج باستمرار مخرجات يمكن أن تمرّ ككلام بشري عند سرعات الاستماع العادية.
يقدم Speech 2.8 HD من Minimax تعليقات صوتية بجودة استوديو مع تنوع نغمي ممتاز. للمحتوى الذي يحتاج إلى أن يبدو مصقولًا وجاهزًا للبث، فهذا خيار قوي. أما نظيره Speech 2.8 Turbo، فهو الخيار الأسرع، ومثالي عندما تكرّر العمل على المحتوى وتحتاج إلى معاينات سريعة قبل الاعتماد على التوليد النهائي.
يغطي Gemini 3.1 Flash TTS من Google أكثر من 70 لغة مع 30 صوتًا مميزًا، ويعمل بزمن استجابة منخفض، ما يجعله خيارًا متينًا وشاملًا للمحتوى الدولي.
لاستنساخ الصوت
إذا أردت أن يبدو الأفاتار الناطق شبيهًا بشخص بعينه (أنت، أو شخصية علامة تجارية، أو شخصية متخيلة)، فإن Chatterbox من Resemble AI يدعم استنساخ الصوت مع التحكم العاطفي. زوّده بمقطع صوتي مرجعي قصير، وسيطابق الخصائص الصوتية للمتحدث عبر أي نص جديد.
يذهب Chatterbox Pro إلى أبعد من ذلك بدقة استنساخ أعلى ومخرجات طويلة أكثر ثباتًا. للعلامات التجارية التي تحتاج إلى صوت اصطناعي متسق عبر أحجام كبيرة من محتوى الأفاتار، فهذه هي الأداة المناسبة.
يدعم Qwen3 TTS أيضًا تصميم الأصوات المخصصة. فبدلًا من رفع مقطع مرجعي، تصف الصوت الذي تريده، ويبنيه النموذج من الصفر.
للغات المتعددة
إذا كان الأفاتار الناطق يحتاج إلى التحدث بعدة لغات، فإن v2 Multilingual من ElevenLabs يغطي أكثر من 30 لغة مع نبرة طبيعية في كل منها. اجمعه مع Video Translate من HeyGen لإعادة مزامنة الشفاه مع الصوت المترجم، لينتج أفاتار ناطق مدبلج بالكامل بلغة ثانية دون إعادة تصوير أي شيء.
للمحتوى الذي يعتمد على الحوار بشكل كبير، يولّد Play Dialog من PlayHT صوت محادثة بين شخصين بقنوات صوتية منفصلة، وهو مفيد بشكل خاص لفيديوهات الأفاتار على طريقة المقابلات أو الأسئلة والأجوبة.
إذا احتجت إلى صوت مستنسخ مخصص على نطاق واسع، فإن Voice Cloning من Minimax يتيح لك تسجيل صوت مستنسخ وإعادة استخدامه عبر توليدات متعددة دون رفع مرجع جديد في كل مرة.
5 نصائح لأفاتارات ناطقة واقعية
تشغيل التقنية شيء، والحصول على نتائج تبدو مقنعة فعلًا شيء آخر، ويتطلب الانتباه إلى تفاصيل يغفل عنها معظم المبتدئين.
1. طابق مزاج الصورة مع طاقة الصوت
إذا كانت صورتك المصدر تُظهر الشخص بإضاءة هادئة ومحايدة وتعبير متزن، بينما صوتك عالي الطاقة ومتحمس، فإن عدم التطابق يبدو غريبًا. اختر أو ولّد صوت التعليق بمستوى طاقة يتناسب مع النبرة العاطفية للصورة.
2. قلّص الصمت في الصوت قبل الرفع
الصمت الطويل يربك نماذج مزامنة الشفاه. يتوقع الذكاء الاصطناعي أن يكون الفم ساكنًا أثناء التوقفات، لكن تظهر عيوب عند فجوات الصمت الممتدة. إذا كان نصك يحتوي على توقفات طبيعية، فقلّصها إلى أقل من 0.5 ثانية في محرر الصوت قبل الرفع.
3. ابدأ بصورة أمامية مباشرة
تعمل الزوايا الجانبية الخفيفة مع معظم النماذج، لكن في أول أفاتار لك، استخدم صورة يتجه فيها الوجه بزاوية لا تتجاوز 15 درجة عن الكاميرا. وبعد أن تعرف كيف يتعامل نموذج معين مع صورتك المصدر، يمكنك تجربة زوايا أكثر دراماتيكية.
4. استخدم نماذج تحريك الجسم كاملًا لأي شيء يتجاوز 15 ثانية
المقاطع القصيرة متسامحة. فرأس متحدث لمدة 5 ثوانٍ مع حركة الشفاه فقط يبدو طبيعيًا. أما أي شيء يتجاوز 15 ثانية فيبدأ في الظهور غريبًا إذا كان بقية الوجه ثابتًا تمامًا. تمنع نماذج تحريك الجسم كاملًا مثل Omni Human 1.5 أو Omni Human هذا التأثير، من خلال تحريك الرمش والتعابير الدقيقة وحركة الرأس الخفيفة باستمرار طوال المقطع.
5. استخدم نماذج مزامنة الشفاه الخاصة بالفيديو للقطات الموجودة
إذا كان لديك بالفعل فيديو لشخص يتكلم وتريد استبدال الصوت (للدبلجة أو لإعادة الصياغة الأسلوبية)، فاستخدم نماذج مصممة لعمل فيديو إلى فيديو بدلًا من تحويل الصورة إلى فيديو. يتعامل Kling Lip Sync و Pixverse Lipsync مع لقطات الفيديو الموجودة بتماسك زمني أفضل من النماذج المصممة للصور الثابتة، لأن لديهما بيانات حركة موجودة يبنيان عليها.
ماذا يمكنك أن تفعل بالأفاتار الناطق
الأفاتارات الناطقة بالذكاء الاصطناعي ليست مجرد شيء جديد. إليك أين يستخدمها صناع المحتوى والشركات الحقيقيون اليوم.
التواصل الاجتماعي والفيديو القصير
يلغي الأفاتار الناطق الحاجة إلى ظهورك أنت أمام الكاميرا. لصناع المحتوى الذين يتهيبون الكاميرا، أو غير المتاحين جسديًا، أو الذين يريدون ببساطة إنتاج محتوى أكثر وبسرعة أكبر، ينتج الأفاتار فيديو لشخص يتحدث في الوقت الذي تستغرقه كتابة النص.
محتوى الدورات التدريبية والتعلم الإلكتروني
تستخدم المنصات التعليمية بشكل متزايد أفاتارات الذكاء الاصطناعي كمدربين على الشاشة. اجمع الأفاتار مع نص منظم بوضوح، ومخرجات صوت ElevenLabs v3، وتحريك Omni Human 1.5، وستحصل على فيديو احترافي المظهر دون كاميرا واحدة أو استئجار استوديو.
محتوى متعدد اللغات دون إعادة التسجيل
أنشئ فيديو مرة واحدة بالإنجليزية، ثم استخدم Video Translate لإنتاج نسخ مدبلجة بالإسبانية والفرنسية والألمانية والبرتغالية وعشرات اللغات الأخرى. تتزامن شفاه الأفاتار مع كل لغة تلقائيًا.
توليد الفيديو المبني على الأفاتار أولًا
للمبدعين الذين يريدون تجاوز خط إنتاج تحويل الصورة إلى مزامنة الشفاه بالكامل، يولّد Avatar IV من HeyGen و Kling Avatar v2 فيديوهات أفاتار ناطقة كاملة مباشرة من صورة بورتريه، ويتعاملان مع توليد الصوت ومزامنة الشفاه معًا في خطوة واحدة. تقدم صورة ونصًا، ويتولى النموذج الباقي.
للحصول على أقصى قدر من التعبير في التحريك، يحرك Dreamactor M2.0 من ByteDance الشخصيات بلغة جسد غنية وديناميكيات حركة طبيعية انطلاقًا من صورة مرجعية واحدة، متجاوزًا مزامنة الشفاه القياسية نحو أداء شخصية متكامل.
شخصيات العلامات التجارية والمقدمون الافتراضيون
تبني الشركات أفاتارات ذكاء اصطناعي تحمل علامتها التجارية، بمظهر متسق، وصوت مستنسخ عبر Voice Cloning من Minimax، وشخصية قابلة للتكرار للاستخدام في العروض التوضيحية للمنتجات، وتهيئة العملاء، والتدريب الداخلي. ويجعل الجمع بين Chatterbox Pro للصوت و P Video Avatar لمخرجات بصرية متسقة هذا سير العمل قابلًا للتكرار على نطاق واسع.
أنشئ أفاتارك الأول الآن
صار حاجز الدخول إلى الأفاتارات الناطقة بالذكاء الاصطناعي أقل مما كان عليه في أي وقت مضى. صورة بورتريه نظيفة، ونص مكتوب، ودقيقتان إلى ثلاث دقائق من وقت المعالجة، هذا كل ما يلزم لإنتاج فيديو كان يتطلب فريق إنتاج محترفًا قبل بضع سنوات.
ابدأ مع Omni Human 1.5 للحصول على أكثر النتائج واقعية من صورة واحدة. اجمعه مع ElevenLabs v3 أو Gemini 3.1 Flash TTS للحصول على صوت يبدو طبيعيًا ويتناسب مع الحضور على الشاشة لأفاتارك. وإذا أردت تجاوز خط الإنتاج كليًا والانتقال من النص إلى الفيديو النهائي في خطوة واحدة، فإن Avatar IV يتولى الصوت والتحريك معًا.
يتيح لك PicassoIA الوصول إلى كل هذه النماذج دون اشتراكات منفصلة أو إعدادات API. كل شيء يعمل داخل متصفحك.
💡 تصفّح كل نماذج مزامنة الشفاه وتحويل النص إلى كلام وفيديو الأفاتار على picassoia.com/en/all-models وابدأ في توليد أول أفاتار ناطق لك اليوم.