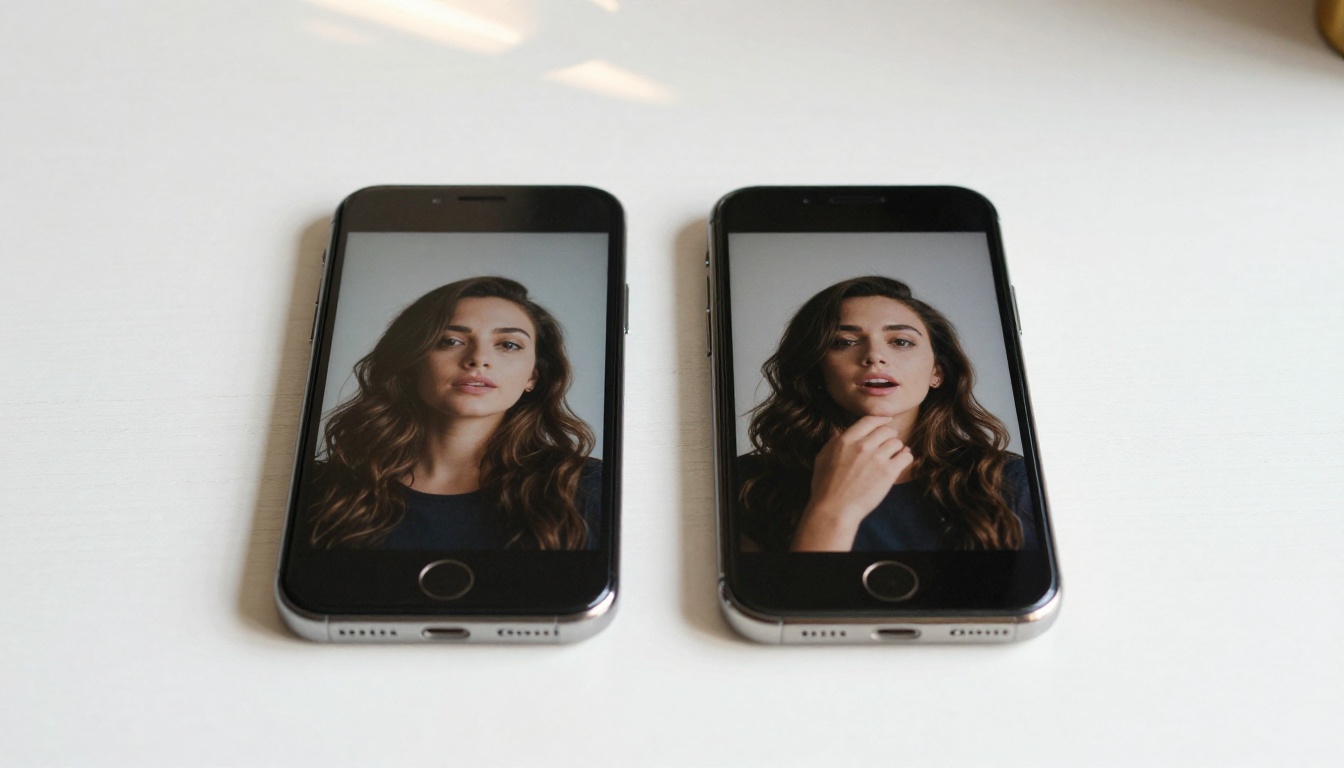
No necesitas un equipo de grabación, un estudio de sonido ni experiencia en edición de video. Con las herramientas de IA adecuadas, puedes tomar una sola foto de una persona real y hacer que diga cualquier texto que escribas, con los labios perfectamente sincronizados y una voz natural, en menos de dos minutos. Esta tecnología ya no es experimental. Funciona en el navegador ahora mismo y está al alcance de cualquiera.
Qué es realmente un avatar de IA parlante
Un avatar de IA parlante es un video en el que el rostro de una persona (a partir de una foto fija o de metraje de video existente) parece pronunciar palabras guiadas por una pista de audio separada. La IA analiza las formas de la boca, el movimiento de la mandíbula y las microexpresiones faciales, y luego genera nuevos fotogramas que coinciden con los fonemas del audio. El resultado hace que parezca que la persona de la imagen está hablando de verdad.
Esta tecnología cubre dos casos de uso distintos. El primero es la sincronización labial: tomar un rostro existente y sincronizarlo con un audio nuevo. El segundo es la animación de cuerpo completo: generar no solo el movimiento de los labios, sino también el movimiento de la cabeza, el lenguaje corporal, el parpadeo natural y los cambios de hombros a partir de un solo retrato fotográfico.
Las 3 partes que hacen que funcione
Cada flujo de creación de avatares parlantes se apoya en tres componentes, y cada uno debe estar bien resuelto para que el resultado parezca real:
- Una fuente de rostro: una foto nítida, de frente o con un ligero ángulo, con buena iluminación y sin obstrucciones fuertes (gafas de sol, mascarillas, cabello que cubra por completo el rostro)
- Una pista de audio: audio de voz limpio, idealmente grabado o generado a 44,1 kHz o más, sin ruido de fondo ni reverberación de la habitación
- Un modelo de sincronización labial: la IA que lee la forma de onda del audio y las marcas de tiempo de los fonemas, y luego genera el movimiento de los labios y del rostro sobre la imagen de origen
Si cualquiera de estos tres elementos es débil, el resultado se degrada de forma notable. Una foto de origen borrosa combinada con un archivo de audio de alta calidad seguirá produciendo un avatar borroso y poco convincente. Los tres deben estar bien resueltos.
Foto fija frente a animación de cuerpo completo
Hay una distinción importante entre los modelos que animan solo la zona de la boca y los que animan la cabeza completa y la parte superior del cuerpo. Los modelos que solo mueven la boca, como Lipsync 2 o React 1, son más rápidos y funcionan con una gama más amplia de fotos de entrada. Los modelos de cuerpo completo, como Omni Human 1.5, animan la inclinación de la cabeza, los parpadeos, los cambios de hombros y los gestos de las manos, con un resultado mucho más natural que se sostiene en pantalla durante más tiempo.
Cómo crear un avatar de IA parlante paso a paso
El proceso es más sencillo de lo que la mayoría espera. Hay tres pasos, y ninguno requiere hardware especial ni software instalado en tu equipo.
Paso 1: elige tu foto de origen
Tu foto es la base. Cuanto mejor sea la foto, mejor será el avatar. Esto es lo que funciona bien:
- De frente o con un ángulo de hasta 45 grados: cualquier ángulo mayor empieza a distorsionar el movimiento de los labios generado
- Rostro bien iluminado: una luz plana y uniforme (como la luz difusa del día nublado o un aro de luz) le da al modelo los datos faciales más claros con los que trabajar
- Sin obstrucciones fuertes: las gafas suelen ser aceptables, pero las gafas de sol totalmente oscuras o las mascarillas causan problemas
- Resolución mínima de retrato de 512 px: la mayoría de los modelos aceptan hasta 1080p; una resolución de entrada más alta produce un resultado más nítido
- Expresión neutra o ligera: una sonrisa con la boca completamente abierta en la foto de origen puede interferir con el estado inicial del modelo de sincronización labial
Sirven las fotos de banco de imágenes, los retratos profesionales y las fotos personales. No estás limitado a tu propio rostro.
Paso 2: genera el audio de voz
A menos que vayas a grabar tu propia voz, necesitas una herramienta de texto a voz para crear la pista de audio. La calidad de ese audio determina directamente lo natural que se ve la sincronización labial, porque la IA lee la temporización de los fonemas directamente de la forma de onda.
Para una voz de sonido natural, ElevenLabs v3 es una de las opciones más sólidas de PicassoIA, con opciones de voz muy expresivas en decenas de estilos. Para velocidad a gran escala, Flash v2.5 de ElevenLabs ofrece resultados rápidos sin sacrificar claridad. Si necesitas resultados en varios idiomas, v2 Multilingual cubre más de 30 idiomas con una prosodia natural en cada uno.
💡 Consejo: genera primero el audio y escúchalo con atención antes de ejecutar la sincronización labial. Corrige las pronunciaciones erróneas o las pausas incómodas en la salida de texto a voz antes de gastar una generación en el avatar.
Paso 3: aplica la sincronización labial a la foto
Con una foto limpia y un archivo de audio terminado, abre el modelo de sincronización labial que prefieras en PicassoIA. Sube la foto como fuente de rostro, adjunta el audio y envía. Según el modelo y la duración del audio, la generación tarda entre 30 segundos y 3 minutos.
Para la mayor precisión posible entre fonemas y movimiento de los labios, usa Lipsync 2 Pro. Para un avatar totalmente animado en el que toda la parte superior del cuerpo se vea viva y presente, usa Omni Human 1.5.
Los mejores modelos de sincronización labial disponibles ahora
PicassoIA alberga 12 modelos de sincronización labial, desde herramientas rápidas de doblaje hasta motores de animación de cuerpo completo. Este es el desglose de los más capaces:
Omni Human 1.5: realismo de cuerpo completo
Omni Human 1.5 de ByteDance es la opción con más funciones para crear un avatar parlante a partir de una sola foto. No solo mueve la boca. Genera inclinaciones naturales de la cabeza, parpadeos, microexpresiones y movimiento de la parte superior del cuerpo que sigue la energía del audio de la voz. Los gestos de las manos visibles en la foto de origen también se conservan y se animan con sutileza a lo largo del clip.
El modelo es especialmente eficaz cuando la foto de origen muestra a la persona desde la cintura hacia arriba, lo que le da a la IA más superficie para animar el movimiento natural del cuerpo.
P Video Avatar: creado para avatares
P Video Avatar está diseñado específicamente para el caso de uso del avatar parlante. Procesa fotos de retrato y archivos de audio juntos y genera un video con movimiento labial sincronizado y movimiento natural de la cabeza. Funciona más rápido que Omni Human 1.5 y da buenos resultados en clips cortos de menos de 60 segundos, así que es una buena opción para creadores de contenido que necesitan entregar rápido.
Fabric 1.0: cualquier foto puede hablar
Fabric 1.0 de Veed adopta un enfoque más accesible. Sube cualquier foto, aporta audio o texto y recibe un video parlante. Admite una gama más amplia de tipos de foto y orientaciones que los modelos más especializados, lo que lo convierte en una buena opción cuando tu imagen de origen no es un retrato perfecto.
Precisión frente a velocidad en la sincronización labial
Para los casos en los que necesitas doblar un video existente con rapidez, Lipsync Speed de HeyGen procesa la sincronización de audio y video en segundos. Cuando la precisión importa más que la velocidad, Lipsync Precision produce una alineación de fonemas más ajustada y maneja mejor los patrones de habla complejos, sobre todo con el habla rápida o las consonantes fuertes.
Cómo usar Omni Human 1.5 en PicassoIA
Dado que Omni Human 1.5 produce los resultados más realistas para generar avatares a partir de fotos, aquí tienes una guía completa para usarlo en PicassoIA.
Sube tu foto de retrato
Ve a la página del modelo Omni Human 1.5. En el panel de entrada, haz clic en el área de carga de imágenes y selecciona tu retrato de origen. La foto debe mostrar el rostro con claridad. Si la persona aparece de cuerpo entero, el modelo animará la zona visible de la parte superior del cuerpo, incluidos los brazos y el torso.
Requisitos de foto para este modelo:
- Formato JPEG o PNG, con una resolución mínima de 720p
- El rostro debe ocupar al menos el 30 % del encuadre
- Evita las fotos en las que el rostro está en sombra profunda en un lado
- Los ángulos frontales o ligeramente laterales (de hasta 45 grados) dan los mejores resultados
Añade el archivo de audio
El modelo acepta archivos de audio MP3 y WAV. Sube la pista de audio que generaste con la herramienta de texto a voz que hayas elegido. Si grabaste tu propia voz, expórtala como WAV limpio a 44,1 kHz y sin ruido de fondo.
No hay un límite fijo de duración del audio, pero los clips de más de 2 minutos pueden requerir más tiempo de procesamiento. En la mayoría de los casos de uso (contenido para redes sociales, explicaciones de productos, material de cursos), mantener los clips entre 30 y 90 segundos produce los resultados más nítidos y la animación más estable.
Configura la resolución y genera
Omni Human 1.5 admite salidas de 480p y 720p. Para compartir en redes sociales o insertar en una página web, 480p es rápido y visualmente limpio. Para presentaciones o reproducción en pantallas más grandes, 720p merece la espera un poco más larga.
Pulsa Generate y espera. Un clip de 30 segundos suele procesarse en 60-90 segundos. El modelo devuelve un MP4 descargable que está listo para usar directamente, sin posprocesado.
Herramientas de voz que combinan bien con los avatares
La calidad de la voz es la mitad de la batalla. Una salida de texto a voz robótica o poco natural romperá la inmersión incluso de un avatar perfectamente sincronizado. Estas son las herramientas que vale la pena usar.
Para una voz natural
ElevenLabs v3 es actualmente uno de los modelos de texto a voz más expresivos que existen, con un control preciso sobre la emoción, el ritmo y el estilo de entrega. Produce con regularidad una salida que se confunde con la voz humana a velocidades de escucha normales.
Speech 2.8 HD de Minimax ofrece locuciones de calidad de estudio con una excelente variedad tonal. Para contenido que debe sonar pulido y listo para emitir, es una opción sólida. Su versión hermana, Speech 2.8 Turbo, es la opción más rápida, ideal cuando estás probando versiones del contenido y necesitas vistas previas rápidas antes de hacer la generación final.
Gemini 3.1 Flash TTS de Google cubre más de 70 idiomas con 30 voces distintas y funciona con baja latencia, lo que lo convierte en una opción sólida y versátil para contenido internacional.
Para la clonación de voz
Si quieres que el avatar parlante suene como una persona concreta (tú mismo, un personaje de marca o un personaje de ficción), Chatterbox de Resemble AI admite la clonación de voz con control emocional. Aporta un breve clip de audio de referencia y reproduce las características vocales del hablante en cualquier texto nuevo.
Chatterbox Pro va más allá con una clonación de mayor fidelidad y una salida más estable en contenidos largos. Para las marcas que necesitan una voz sintética coherente en grandes volúmenes de contenido de avatares, esta es la herramienta adecuada.
Qwen3 TTS también admite el diseño de voces personalizadas. En lugar de subir un clip de referencia, describes la voz que quieres y el modelo la construye desde cero.
Para varios idiomas
Si tu avatar parlante necesita hablar en varios idiomas, v2 Multilingual de ElevenLabs cubre más de 30 idiomas con una prosodia natural en cada uno. Combínalo con Video Translate de HeyGen para volver a sincronizar los labios con el audio traducido, y obtendrás un avatar parlante doblado por completo en un segundo idioma sin volver a grabar nada.
Para contenido con mucho diálogo, Play Dialog de PlayHT genera audio de conversación entre dos personas con canales de voz separados, lo que resulta especialmente útil para videos de avatares en formato entrevista o de preguntas y respuestas.
Si necesitas una voz personalizada clonada a escala, Voice Cloning de Minimax te permite registrar y reutilizar una voz clonada en varias generaciones sin subir una nueva referencia cada vez.
5 consejos para avatares parlantes realistas
Que la tecnología funcione es una cosa. Conseguir resultados que de verdad parezcan convincentes requiere prestar atención a detalles que la mayoría de quienes lo prueban por primera vez pasan por alto.
1. Haz que el estado de ánimo de la foto coincida con la energía del audio
Si tu foto de origen muestra a la persona con una iluminación tranquila y neutra y una expresión serena, y tu audio es enérgico y entusiasta, la discordancia resulta extraña. Elige o genera tu audio de voz con un nivel de energía que encaje con el registro emocional de la foto.
2. Recorta los silencios de tu audio antes de subirlo
Los silencios largos confunden a los modelos de sincronización labial. La IA espera que la boca esté quieta durante las pausas, pero aparecen artefactos cuando hay huecos de silencio prolongados. Si tu guion tiene pausas naturales, recórtalas a menos de 0,5 segundos en tu editor de audio antes de subirlo.
3. Empieza con una foto de frente
Los ángulos de perfil ligeros funcionan en la mayoría de los modelos, pero para tu primer avatar usa una foto en la que el rostro mire a menos de 15 grados de la cámara. Cuando sepas cómo maneja un modelo concreto tu imagen de origen, puedes experimentar con ángulos más dramáticos.
4. Usa modelos de cuerpo completo para cualquier cosa de más de 15 segundos
Los clips cortos perdonan más. Una cabeza parlante de 5 segundos con solo movimiento de labios se ve natural. Cualquier cosa de más de 15 segundos empieza a resultar inquietante si el resto del rostro está completamente quieto. Los modelos de animación de cuerpo completo como Omni Human 1.5 u Omni Human evitan este efecto al animar de forma continua los parpadeos, las microexpresiones y el movimiento sutil de la cabeza durante todo el clip.
5. Usa modelos de sincronización labial para video en los casos de metraje existente
Si ya tienes un video de una persona hablando y quieres cambiar el audio (para doblaje o para reestilizarlo), usa modelos diseñados para trabajar de video a video en lugar de imagen a video. Kling Lip Sync y Pixverse Lipsync manejan metraje de video existente con mejor coherencia temporal que los modelos diseñados para fotos fijas, porque ya tienen datos de movimiento sobre los que construir.
Qué puedes hacer con un avatar parlante
Los avatares de IA parlantes no son una novedad. Estos son los usos que les dan hoy los creadores y las empresas reales.
Redes sociales y video de formato corto
Un avatar parlante elimina la necesidad de aparecer tú mismo frente a la cámara. Para los creadores que sienten timidez ante la cámara, que no pueden estar físicamente presentes o que simplemente quieren producir más contenido más rápido, un avatar genera un video de cabeza parlante en el tiempo que tarda en escribirse un guion.
Contenido para cursos y e-learning
Las plataformas educativas usan cada vez más avatares de IA como instructores en pantalla. Combina un avatar con un guion bien estructurado, la salida de voz de ElevenLabs v3 y la animación de Omni Human 1.5, y tendrás un video de aspecto profesional sin una sola cámara ni alquiler de estudio.
Contenido multilingüe sin volver a grabar
Crea un video una vez en inglés y luego usa Video Translate para producir versiones dobladas en español, francés, alemán, portugués y decenas de idiomas más. Los labios del avatar se vuelven a sincronizar automáticamente con cada idioma.
Generación de video directa con avatar
Para los creadores que quieren saltarse por completo el flujo de foto a sincronización labial, Avatar IV de HeyGen y Kling Avatar v2 generan videos completos de avatares parlantes directamente a partir de una imagen de retrato, gestionando la síntesis de voz y la sincronización labial en un solo paso. Aportas una foto y un guion de texto, y el modelo hace el resto.
Para una máxima expresividad en la animación, Dreamactor M2.0 de ByteDance anima a los personajes con un lenguaje corporal rico y una dinámica de movimiento natural a partir de una sola imagen de referencia, yendo más allá de la sincronización labial estándar hacia una interpretación completa del personaje.
Personajes de marca y presentadores virtuales
Las empresas están creando avatares de IA de marca con una apariencia coherente, una voz clonada mediante Voice Cloning de Minimax y una personalidad constante para usar en demostraciones de productos, incorporación de clientes y formación interna. La combinación de Chatterbox Pro para la voz y P Video Avatar para una salida visual coherente hace que este flujo de trabajo sea repetible a escala.
Crea tu primer avatar ahora
La barrera de entrada a los avatares de IA parlantes es ahora más baja que nunca. Una foto de retrato limpia, un guion escrito y entre dos y tres minutos de procesamiento bastan para producir un video que hace unos años habría requerido un equipo de producción profesional.
Empieza con Omni Human 1.5 para obtener el resultado más realista a partir de una sola foto. Combínalo con ElevenLabs v3 o Gemini 3.1 Flash TTS para una voz que suene natural y encaje con la presencia en pantalla de tu avatar. Si quieres saltarte todo el proceso y pasar del guion al video terminado en un solo paso, Avatar IV gestiona la voz y la animación juntas.
PicassoIA te da acceso a todos estos modelos sin suscripciones independientes ni configuraciones de API. Todo funciona en el navegador.
💡 Explora todos los modelos de sincronización labial, texto a voz y video de avatares en picassoia.com/en/all-models y empieza hoy a generar tu primer avatar parlante.