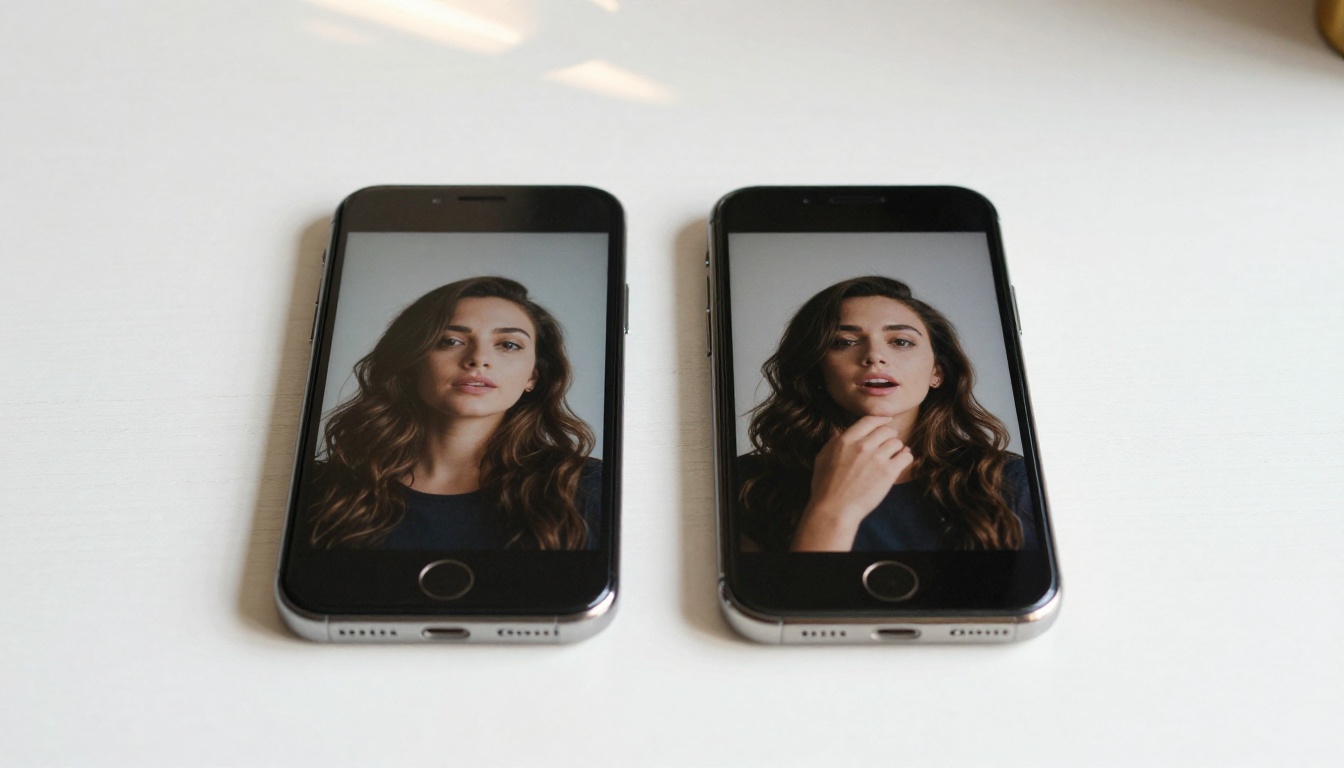
Vous n’avez besoin ni d’une équipe de tournage, ni d’un studio d’enregistrement, ni d’une expérience en montage vidéo. Avec les bons outils d’IA, vous pouvez prendre une seule photo d’une vraie personne et lui faire dire le texte de votre choix, avec des lèvres parfaitement synchronisées et une voix naturelle, en moins de deux minutes. Ce n’est plus une technologie expérimentale. Elle tourne dans les navigateurs dès maintenant, accessible à tous.
Ce qu’est vraiment un avatar IA parlant
Un avatar IA parlant est une vidéo dans laquelle le visage d’une personne (à partir d’une photo fixe ou d’une séquence vidéo existante) semble prononcer des mots issus d’une piste audio séparée. L’IA analyse la forme de la bouche, le mouvement de la mâchoire et les micro-expressions du visage, puis génère de nouvelles images qui correspondent aux phonèmes de l’audio. Le résultat donne l’impression que la personne sur l’image parle réellement.
Cette technologie couvre deux cas d’usage distincts. Le premier est le lipsync : prendre un visage existant et le synchroniser avec un nouvel audio. Le second est l’animation du corps entier : générer non seulement le mouvement des lèvres, mais aussi les mouvements de la tête, le langage corporel, les clignements naturels et les mouvements d’épaules à partir d’un seul portrait.
Les 3 éléments qui rendent le tout possible
Tout pipeline d’avatar parlant repose sur trois composants, et chacun doit être solide pour que le résultat paraisse réel :
- Une source de visage : une photo nette, de face ou légèrement de biais, avec un bon éclairage et sans obstacle important (lunettes de soleil, masques, cheveux qui recouvrent entièrement le visage)
- Une piste audio : une parole propre, idéalement enregistrée ou générée à 44,1 kHz ou plus, sans bruit de fond ni réverbération de pièce
- Un modèle de lipsync : l’IA qui lit la forme d’onde audio et les horodatages des phonèmes, puis génère les mouvements correspondants des lèvres et du visage sur l’image source
Si l’un de ces trois éléments est faible, le résultat se dégrade nettement. Une photo source floue combinée à un fichier audio de haute qualité produira toujours un avatar flou et peu convaincant. Les trois doivent être solides.
Photo fixe ou animation du corps entier
Il existe une distinction importante entre les modèles qui n’animent que la zone de la bouche et ceux qui animent toute la tête et le haut du corps. Les modèles limités à la bouche, comme Lipsync 2 ou React 1, sont plus rapides et fonctionnent avec un plus grand nombre de photos d’entrée. Les modèles à corps entier, comme Omni Human 1.5, animent l’inclinaison de la tête, les clignements, les mouvements d’épaules et les gestes des mains, pour un résultat bien plus naturel, qui tient mieux à l’écran sur des durées plus longues.
Le processus est plus simple que ce que l’on imagine en général. Il comporte trois étapes, et aucune ne nécessite de matériel spécial ni de logiciel installé sur votre machine.
Étape 1 : choisissez votre photo source
Votre photo est la base de tout. Plus la photo est bonne, meilleur sera l’avatar. Voici ce qui fonctionne bien :
- Visage de face ou angle allant jusqu’à 45 degrés : au-delà, le mouvement des lèvres généré commence à se déformer
- Visage bien éclairé : un éclairage uniforme et diffus (comme la lumière d’un jour couvert ou un anneau lumineux) donne au modèle les données faciales les plus claires à exploiter
- Pas d’obstacle important : les lunettes passent généralement, mais les lunettes de soleil entièrement teintées ou les masques posent problème
- Résolution de portrait d’au moins 512 px : la plupart des modèles acceptent jusqu’à 1080p ; une résolution d’entrée plus élevée donne une sortie plus nette
- Expression neutre ou légère : un large sourire bouche ouverte sur la photo source peut perturber l’état de départ du modèle de lipsync
Les photos de banques d’images, les portraits professionnels et les photos personnelles fonctionnent tous. Vous n’êtes pas limité à votre propre visage.
Étape 2 : générez l’audio de la voix
Sauf si vous enregistrez votre propre voix, vous avez besoin d’un outil de synthèse vocale pour créer la piste audio. La qualité de cet audio détermine directement le naturel du lipsync, car l’IA lit le timing des phonèmes directement dans la forme d’onde.
Pour une parole d’apparence naturelle, ElevenLabs v3 fait partie des options les plus performantes sur PicassoIA, avec des voix très expressives dans des dizaines de styles. Pour la rapidité à grande échelle, Flash v2.5 d’ElevenLabs livre une sortie rapide sans sacrifier la clarté. Si vous avez besoin d’une sortie multilingue, v2 Multilingual couvre plus de 30 langues avec une prosodie naturelle dans chacune d’elles.
💡 Astuce : générez d’abord votre audio et écoutez-le attentivement avant de lancer le lipsync. Corrigez les mauvaises prononciations ou les pauses maladroites dans la sortie de synthèse vocale avant de consacrer une génération à l’avatar.
Étape 3 : appliquez le lipsync à la photo
Avec une photo propre et un fichier audio finalisé, ouvrez le modèle de lipsync de votre choix sur PicassoIA. Importez la photo comme source de visage, joignez l’audio et lancez la génération. Selon le modèle et la durée de l’audio, la génération prend entre 30 secondes et 3 minutes.
Pour une précision maximale entre phonèmes et mouvements des lèvres, utilisez Lipsync 2 Pro. Pour un avatar entièrement animé dont tout le haut du corps paraît vivant et présent, utilisez Omni Human 1.5.
Les meilleurs modèles de lipsync disponibles aujourd’hui
PicassoIA héberge 12 modèles de lipsync, allant des outils de doublage rapide aux moteurs d’animation du corps entier. Voici une présentation des plus performants :
| Modèle | Idéal pour | Animation du corps | Vitesse |
|---|
| Omni Human 1.5 | Avatar réaliste du corps entier à partir d’une photo | Oui | Moyenne |
| P Video Avatar | Création d’avatar parlant dédiée | Partielle | Rapide |
| Lipsync 2 Pro | Précision maximale des lèvres | Bouche uniquement | Rapide |
| Fabric 1.0 | Faire parler n’importe quelle photo | Partielle | Rapide |
| Kling Lip Sync | Synchroniser la bouche sur l’audio d’une vidéo existante | Bouche uniquement | Rapide |
| Lipsync Precision | Doublage vidéo avec une grande précision | Bouche uniquement | Moyenne |
| Video Translate | Doublage en plus de 150 langues | Bouche uniquement | Moyenne |
| Lipsync Speed | Doublage vidéo le plus rapide | Bouche uniquement | Très rapide |
| Pixverse Lipsync | Synchronisation audio-vidéo instantanée | Bouche uniquement | Rapide |
Omni Human 1.5 : le réalisme du corps entier
Omni Human 1.5 de ByteDance est l’option la plus complète pour créer un avatar parlant à partir d’une seule photo. Il ne se contente pas de bouger la bouche. Il génère des inclinaisons naturelles de la tête, des clignements, des micro-expressions et des mouvements du haut du corps qui suivent l’énergie de l’audio. Les gestes des mains visibles sur la photo source sont également conservés et animés subtilement tout au long de la séquence.
Le modèle est particulièrement efficace lorsque la photo source montre la personne à partir de la taille, ce qui donne à l’IA davantage de surface à animer pour un mouvement corporel naturel.
P Video Avatar : conçu pour les avatars
P Video Avatar est spécialement conçu pour les avatars parlants. Il traite ensemble les photos de portrait et les fichiers audio, et produit une vidéo avec des mouvements de lèvres synchronisés et un mouvement naturel de la tête. Il est plus rapide qu’Omni Human 1.5 et convient bien aux clips de moins de 60 secondes, ce qui en fait un bon choix pour les créateurs de contenu qui ont besoin d’un délai de livraison court.
Fabric 1.0 : n’importe quelle photo peut parler
Fabric 1.0 de Veed adopte une approche plus accessible. Importez n’importe quelle photo, fournissez un audio ou un texte, et récupérez une vidéo parlante. Il gère une plus grande variété de types et d’orientations de photos que les modèles plus spécialisés, ce qui en fait un bon choix lorsque votre image source n’est pas un portrait parfait.
Précision ou vitesse pour le lipsync
Pour doubler rapidement une vidéo existante, Lipsync Speed de HeyGen traite la synchronisation de l’audio et de la vidéo en quelques secondes. Lorsque la précision compte davantage que la vitesse, Lipsync Precision produit un alignement des phonèmes plus serré et gère mieux les schémas de parole complexes, en particulier une parole rapide ou des consonnes marquées.
Puisque Omni Human 1.5 produit les résultats les plus réalistes pour la génération d’avatar à partir d’une photo, voici un guide complet pour l’utiliser sur PicassoIA.
Importez votre photo de portrait
Rendez-vous sur la page du modèle Omni Human 1.5. Dans le panneau de saisie, cliquez sur la zone d’import d’image et sélectionnez votre portrait source. La photo doit montrer le visage clairement. Si la personne apparaît en pied, le modèle animera la zone visible du haut du corps, y compris les bras et le torse.
Exigences photo pour ce modèle :
- Format JPEG ou PNG, résolution minimale de 720p
- Le visage doit occuper au moins 30 % du cadre
- Évitez les photos où le visage est plongé dans l’ombre d’un côté
- Un visage de face ou légèrement de biais (jusqu’à 45 degrés) donne les meilleurs résultats
Ajoutez le fichier audio
Le modèle accepte les fichiers audio MP3 et WAV. Importez la piste audio générée avec l’outil de synthèse vocale de votre choix. Si vous avez enregistré votre propre voix, exportez-la en WAV propre à 44,1 kHz, sans bruit de fond.
La durée de l’audio n’est pas strictement limitée, mais les clips de plus de 2 minutes peuvent demander un temps de traitement plus long. Pour la plupart des usages (contenus pour les réseaux sociaux, vidéos explicatives de produits, supports de cours), des clips de 30 à 90 secondes donnent les résultats les plus nets et l’animation la plus stable.
Réglez la résolution et générez
Omni Human 1.5 prend en charge les sorties en 480p et 720p. Pour un partage sur les réseaux sociaux ou une intégration dans une page web, le 480p est rapide et visuellement propre. Pour des présentations ou une lecture sur grand écran, le 720p vaut le temps d’attente un peu plus long.
Cliquez sur Générer et patientez. Un clip de 30 secondes est généralement traité en 60 à 90 secondes. Le modèle renvoie un fichier MP4 téléchargeable, prêt à l’emploi sans post-traitement.
Les outils vocaux qui s’associent bien aux avatars
La qualité de la voix représente la moitié de la réussite. Une sortie de synthèse vocale robotique ou peu naturelle brisera l’immersion, même d’un avatar parfaitement synchronisé. Voici les outils qui valent la peine d’être utilisés.
Pour une parole naturelle
ElevenLabs v3 est actuellement l’un des modèles de synthèse vocale les plus expressifs disponibles, avec un contrôle précis de l’émotion, du rythme et du style de diction. Il produit régulièrement une sortie qui passe pour une parole humaine à une vitesse d’écoute normale.
Speech 2.8 HD de Minimax offre des voix off de qualité studio avec une excellente variété tonale. Pour un contenu qui doit sonner soigné et prêt pour la diffusion, c’est un choix solide. Son équivalent, Speech 2.8 Turbo, est l’option la plus rapide, idéale lorsque vous itérez sur un contenu et avez besoin d’aperçus rapides avant de valider une génération finale.
Gemini 3.1 Flash TTS de Google couvre plus de 70 langues avec 30 voix distinctes et fonctionne avec une faible latence, ce qui en fait une option polyvalente pour les contenus internationaux.
Pour le clonage vocal
Si vous voulez que l’avatar parlant ressemble à une personne précise (vous-même, un personnage de marque ou un personnage fictif), Chatterbox de Resemble AI prend en charge le clonage vocal avec un contrôle émotionnel. Fournissez un court extrait audio de référence, et il reprend les caractéristiques vocales du locuteur sur n’importe quel nouveau texte.
Chatterbox Pro va plus loin avec un clonage à plus haute fidélité et une sortie plus stable sur les formats longs. Pour les marques qui ont besoin d’une voix de synthèse constante sur de gros volumes de contenus d’avatar, c’est l’outil adapté.
Qwen3 TTS prend aussi en charge la conception de voix personnalisées. Au lieu d’importer un extrait de référence, vous décrivez la voix souhaitée, et le modèle la construit de toutes pièces.
Pour plusieurs langues
Si votre avatar parlant doit s’exprimer en plusieurs langues, v2 Multilingual d’ElevenLabs couvre plus de 30 langues avec une prosodie naturelle dans chacune. Associez-le à Video Translate de HeyGen pour resynchroniser les lèvres sur l’audio traduit, et obtenez un avatar parlant entièrement doublé dans une seconde langue, sans refaire de tournage.
Pour les contenus riches en dialogues, Play Dialog de PlayHT génère un audio de conversation à deux voix avec des canaux vocaux distincts, ce qui est particulièrement utile pour les vidéos d’avatar de type interview ou questions-réponses.
Si vous avez besoin d’une voix personnalisée clonée à grande échelle, Voice Cloning de Minimax vous permet d’enregistrer et de réutiliser une voix clonée sur plusieurs générations, sans importer une nouvelle référence à chaque fois.
5 conseils pour des avatars parlants réalistes
Faire fonctionner la technologie est une chose. Obtenir un résultat qui paraît vraiment convaincant demande de l’attention aux détails que la plupart des débutants négligent.
1. Faites correspondre l’ambiance de la photo à l’énergie de l’audio
Si votre photo source montre la personne avec un éclairage calme et neutre et une expression posée, et que votre audio est très énergique et enthousiaste, le décalage paraît étrange. Choisissez ou générez votre audio avec un niveau d’énergie adapté à la tonalité émotionnelle de la photo.
2. Coupez les silences de votre audio avant l’import
Les longs silences perturbent les modèles de lipsync. L’IA s’attend à ce que la bouche reste immobile pendant les pauses, mais des artefacts apparaissent lorsque les silences se prolongent. Si votre script comporte des pauses naturelles, réduisez-les à moins de 0,5 seconde dans votre logiciel de montage audio avant l’import.
3. Commencez par une photo de face
Les angles de profil légers fonctionnent avec la plupart des modèles, mais pour votre premier avatar, utilisez une photo où le visage est orienté à moins de 15 degrés de la caméra. Une fois que vous savez comment un modèle précis gère votre image source, vous pouvez tester des angles plus marqués.
4. Utilisez des modèles à corps entier pour tout ce qui dépasse 15 secondes
Les clips courts sont indulgents. Une tête parlante de 5 secondes avec seulement le mouvement des lèvres paraît naturelle. Au-delà de 15 secondes, le rendu devient étrange si le reste du visage est totalement figé. Les modèles d’animation du corps entier comme Omni Human 1.5 ou Omni Human évitent cet effet en animant en continu les clignements, les micro-expressions et les légers mouvements de tête pendant toute la durée du clip.
5. Utilisez des modèles de lipsync vidéo pour les séquences existantes
Si vous disposez déjà d’une vidéo d’une personne qui parle et que vous souhaitez remplacer l’audio (pour du doublage ou une reformulation), utilisez des modèles conçus pour la vidéo vers vidéo plutôt que la photo vers vidéo. Kling Lip Sync et Pixverse Lipsync traitent les séquences vidéo existantes avec une meilleure cohérence temporelle que les modèles conçus pour les photos fixes, car ils disposent déjà de données de mouvement sur lesquelles s’appuyer.
Ce que vous pouvez faire avec un avatar parlant
Les avatars IA parlants ne sont pas une simple curiosité. Voici les usages que les créateurs et les entreprises réels font aujourd’hui.
Réseaux sociaux et vidéos courtes
Un avatar parlant vous évite d’apparaître vous-même devant la caméra. Pour les créateurs qui n’aiment pas être filmés, qui sont physiquement indisponibles ou qui veulent simplement produire plus de contenus, un avatar génère une vidéo de tête parlante le temps d’écrire un script.
Contenus pédagogiques et e-learning
Les plateformes éducatives utilisent de plus en plus les avatars IA comme formateurs à l’écran. Combinez un avatar avec un script clairement structuré, une sortie vocale ElevenLabs v3 et une animation Omni Human 1.5, et vous obtenez une vidéo d’allure professionnelle sans aucune caméra ni location de studio.
Contenus multilingues sans nouvel enregistrement
Créez une vidéo une fois en anglais, puis utilisez Video Translate pour produire des versions doublées en espagnol, en français, en allemand, en portugais et dans bien d’autres langues. Les lèvres de l’avatar se resynchronisent automatiquement sur chaque langue.
Génération de vidéos centrée sur l’avatar
Pour les créateurs qui veulent se passer entièrement du pipeline photo vers lipsync, Avatar IV de HeyGen et Kling Avatar v2 génèrent directement des vidéos d’avatar parlant complètes à partir d’une image de portrait, en gérant la synthèse vocale et le lipsync en une seule étape. Vous fournissez une photo et un script texte, et le modèle se charge du reste.
Pour une expressivité d’animation maximale, Dreamactor M2.0 de ByteDance anime les personnages avec un langage corporel riche et une dynamique de mouvement naturelle à partir d’une seule image de référence, en allant au-delà du lipsync standard vers une véritable interprétation du personnage.
Personnages de marque et présentateurs virtuels
Les entreprises créent des avatars IA de marque à l’apparence constante, avec une voix clonée via Voice Cloning de Minimax et une personnalité reproductible à utiliser dans les démonstrations de produits, l’accueil des clients et la formation interne. La combinaison de Chatterbox Pro pour la voix et de P Video Avatar pour un rendu visuel constant rend ce flux de travail reproductible à grande échelle.
Créez dès maintenant votre premier avatar
La barrière d’entrée pour les avatars IA parlants n’a jamais été aussi basse. Une photo de portrait propre, un script tapé et deux à trois minutes de traitement suffisent pour produire une vidéo qui aurait exigé une équipe de production professionnelle il y a quelques années.
Commencez avec Omni Human 1.5 pour le résultat le plus réaliste à partir d’une seule photo. Associez-le à ElevenLabs v3 ou Gemini 3.1 Flash TTS pour une voix naturelle qui correspond à la présence à l’écran de votre avatar. Si vous voulez vous passer complètement du pipeline et aller du script à la vidéo finale en une seule étape, Avatar IV gère à la fois la voix et l’animation.
PicassoIA vous donne accès à tous ces modèles sans abonnements séparés ni configuration d’API. Tout fonctionne dans votre navigateur.
💡 Parcourez tous les modèles de lipsync, de synthèse vocale et de vidéo d’avatar sur picassoia.com/en/all-models et commencez dès aujourd’hui à générer votre premier avatar parlant.