قد يكون ذلك الفيديو المنتشر على وسائل التواصل الاجتماعي ليس حقيقيًا. ليس ولو بقدر ضئيل. خلال السنتين الماضيتين، تجاوز الفيديو المولّد بالذكاء الاصطناعي عتبة لم يتوقعها معظم الناس: أصبحت الفيديوهات المزيفة مقنعة إلى حد يخدع صحفيين مدربين وجهات إنفاذ القانون، وأحيانًا حتى الأشخاص الذين يظهرون فيها. لكن الإقناع لا يعني الكمال. كل فيديو مُصطنع يترك آثارًا، وحين تعرف ما تبحث عنه، ستلاحظ الشقوق في كل مرة.
لماذا يصعب اكتشاف الفيديوهات المولّدة بالذكاء الاصطناعي اليوم
تقلّصت الفجوة بين اللقطات الحقيقية والفيديو المُصطنع بشكل كبير. يمكن لأدوات مثل Veo 3 وSora 2 وKling v2.6 إنتاج فيديو بصوت أصلي، وضبابية حركة واقعية، واستمرارية مشهد متماسكة، وكان ذلك سيتطلب ميزانية هوليوودية قبل خمس سنوات.
تُدرَّب النماذج على مليارات الإطارات الحقيقية
تُدرَّب نماذج تحويل النص إلى فيديو الحديثة على مجموعات بيانات ضخمة من لقطات العالم الواقعي، ما يعني أنها استوعبت المفردات البصرية للأصالة. تعرف كيف يتشتت الضوء عبر النافذة. وتعرف كيف تتجعد الملابس عندما يجلس شخص ما. المشكلة ليست أنها تخطئ في كل شيء، بل أنها تُصيب في كل شيء تقريبًا، وهذا ما يجعل الأخطاء المتبقية أصعب في الرصد إن لم تكن تعرف أين تنظر.
تقلّص وادي الغرابة
كانت عمليات التزييف العميق الأولى تحمل دلائل واضحة: ألوان بشرة غير متطابقة، وتعابير متجمدة، وخلفيات ممسوحة كأنها ألوان مائية. وقد زالت هذه الدلائل إلى حد كبير. ما يبقى هو مشكلات أدق وأكثر منهجية، جذورها في طريقة توليد هذه النماذج للحركة عبر الزمن.
💡 أهم ملاحظة: يُولي توليد الفيديو بالذكاء الاصطناعي اهتمامًا بالاتساق المكاني، لكنه كثيرًا ما يعاني من الاتساق الزمني، أي ثبات التفاصيل الدقيقة عبر ثوانٍ متعددة من اللقطات. وهنا تنهار معظم عمليات التزييف.
الوجه: شبه مثالي، لكنه ليس تمامًا
الوجه البشري هو أصعب ما يمكن تزييفه بإقناع، وما زال المكان الذي تنهار فيه معظم الفيديوهات المولّدة بالذكاء الاصطناعي عند الفحص الدقيق.
مشكلة ملمس الجلد
يحتوي الجلد البشري الحقيقي على آلاف الميزات الدقيقة: المسام، والشعيرات الناعمة، والشامات غير المتماثلة، والشعيرات الدموية، والتفاوتات اللونية الخفيفة الناتجة عن تدفق الدم تحت السطح. تحاكي نماذج الذكاء الاصطناعي ذلك بملمس إجرائي غالبًا ما يبدو ناعمًا أكثر من اللازم أو منتظمًا أكثر من اللازم.
عند فحص وجه في فيديو يُشتبه في توليده بالذكاء الاصطناعي، ابحث عن:
- تناسق المسام: للجلد الحقيقي أنماط مسام غير منتظمة. أما جلد الذكاء الاصطناعي فغالبًا ما يملك ملمسًا موحدًا يتكرر عبر الوجه.
- الانتقال بين الشعر والجلد: أين ينتهي خط الشعر وأين يبدأ الجلد؟ يعاني الذكاء الاصطناعي باستمرار مع هذا الحد.
- عدم تماثل الوجه: الوجوه البشرية غير متماثلة بطبيعتها، والملامح المتماثلة تمامًا علامة تحذير كبيرة.
- تغيّرات لون البشرة: هل يبقى اللون متطابقًا تمامًا تحت زوايا الإضاءة المختلفة؟ الوجوه الحقيقية تتغير بشكل طفيف مع تحرك الضوء.
الأسنان وداخل الفم
من أكثر الدلائل قيمةً في أي تحليل لعمليات التزييف العميق. عندما يتكلم الشخص، راقب داخل فمه بعناية. تنتج نماذج الذكاء الاصطناعي كثيرًا:
- أسنانًا تظهر وتختفي بين الإطارات
- خطوطًا للَّثة تتحرك من مكانها رغم أنها يجب أن تبقى ثابتة
- ألسنةً تتحرك في أقواس مستحيلة فيزيائيًا
- ظلالًا داخل الفم تتجاهل اتجاه مصدر الضوء الفعلي
انحراف الإكسسوارات على الوجه
النظارات والأقراط والحلقات المثبتة في الجسم من أصعب العناصر على الذكاء الاصطناعي في الحفاظ على ثباتها عبر الإطارات. راقب الأقراط التي تغيّر شكلها بين اللقطات، أو إطارات النظارات التي تتعوج عند الصدغين، أو المجوهرات التي تبدو وكأنها تطفو قليلًا عن الجلد بدلًا من أن تستقر عليه.
الرمش: الدليل الأقدم الذي ما زال يعمل
تبقى أنماط الرمش من أكثر المؤشرات موثوقية على الفيديو المُصطنع، رغم سنوات من البحث النشط لتصحيح هذه المشكلة.
معدلات الرمش الطبيعية مقابل الاصطناعية
يرمش البشر من 15 إلى 20 مرة في الدقيقة. كانت عمليات التزييف العميق الأولى تكاد لا ترمش على الإطلاق. وقد صححت النماذج الحديثة المعدل، لكن بطرق ما زالت قابلة للرصد عندما تعرف ما تراقبه:
| النمط | إنسان حقيقي | مولّد بالذكاء الاصطناعي |
|---|
| معدل الرمش | 15-20 في الدقيقة | غالبًا 10-18 في الدقيقة |
| مدة الرمشة | 150-400 ميلي ثانية، متغيرة | غالبًا موحدة عند نحو 200 ميلي ثانية |
| تماثل الجفنين | يتحرك الجفنان باستقلالية طفيفة | يتحرك الجفنان معًا بشكل متطابق غالبًا |
| الرمشات الدقيقة اللاإرادية | موجودة | نادرة أو غائبة تمامًا |
| التعديل بعد الرمشة | تعيد العينان التركيز قليلًا غالبًا | تعود العينان بحدة إلى الموضع السابق بالضبط |
راقب الرموش أثناء الرمش
هذه التقنية فعّالة للغاية ولا تحتاج إلى أدوات خاصة. في اللقطات الحقيقية، تنفصل شعيرات الرموش الفردية قليلًا، وتتكتل بشكل طبيعي، وتُنتج أنماط ظلال متفاوتة على الجفن السفلي في كل رمشة. أما في معظم الفيديوهات المولّدة بالذكاء الاصطناعي، فتتحرك الرموش كوحدة واحدة ناعمة دون أي سلوك فردي للشعيرات.
💡 نصيحة: شغّل الفيديو بسرعة 0.25x وركّز فقط على اللحظة التي يُغلق فيها الجفن. إذا تصرفت الرموش كشكل منحنٍ موحد واحد دون تمايز في الشعيرات، فاعتبرها علامة تحذير قوية.
الصوت: حين لا يطابق الصوت الوجه
يركّز كثير من الناس على الجانب البصري وحده عند تقييم أصالة الفيديو. وهذا خطأ. فالتزامن بين الصوت والصورة هو غالبًا المكان الذي تنهار فيه المواد المُصطنعة بوضوح أكبر.
انحراف مزامنة الشفاه
حتى مع أدوات مزامنة الشفاه المتخصصة، فإن الكلام المولّد بالذكاء الاصطناعي كثيرًا ما ينحرف عن التزامن بطرق دقيقة. ويبرز ذلك بشكل خاص مع أنواع معينة من الأصوات:
- الحروف الشفوية (أصوات P وB وM) التي تتطلب انغلاق الشفتين تمامًا
- الاحتكاكية (أصوات F وV) التي تتطلب وضع الأسنان العليا على الشفة السفلى
- نهايات الكلمات حيث تتوقف حركة الشفاه قبل انقطاع الصوت أو بعده بقليل
البيئة الصوتية لا تطابق المكان المرئي
في اللقطات الحقيقية، تطابق الخصائص الصوتية للمكان ما تراه على الشاشة. الشخص المصوَّر في حمام كبير مبلَّط يبدو صوته مختلفًا عن شخص في غرفة نوم مفروشة بالسجاد. يطبّق الفيديو المولّد بالذكاء الاصطناعي باستمرار مظهرًا صوتيًا مسطحًا ونظيفًا لا يتطابق مع البيئة الظاهرة. استمع إلى:
- غياب الصدى الطبيعي للغرفة أو الارتدادات الصوتية مقارنةً بالمساحة المرئية
- كلامًا نظيفًا بشكل غير طبيعي دون أي ضوضاء خلفية محيطة
- مستوى صوت ثابت بغض النظر عن بُعد الشخص عن الكاميرا أو زاوية رأسه
أنماط التنفس والإيقاع
الأشخاص الحقيقيون يتنفسون. ويمكنك غالبًا سماع ذلك في الصوت، خاصةً قبل الجمل الطويلة أو بين العبارات السريعة. يفتقر الكلام المولّد بالذكاء الاصطناعي إلى هذا تمامًا في كثير من الأحيان، فينتج إيقاعًا آليًا حتى عندما تكون جودة الصوت نفسها مقنعة. تتدفق الجمل بانتظام رتيب يبدو احترافيًا لكنه يبدو غير بشري عند الاستماع المتأني.
تشوهات الخلفية والحواف
غالبًا ما تكون خلفية الفيديو المولّد بالذكاء الاصطناعي أضعف عناصره، لأن النموذج يجب أن يحافظ على الاتساق المكاني عبر الزمن مع معالجة حركة معقدة في المقدمة.
هالات الحواف والتشبّح
حيث يلتقي الشخص المتحرك مع الخلفية، ينتج الفيديو المولّد بالذكاء الاصطناعي كثيرًا تشوهات مرئية:
- هالات ناعمة: إطار أفتح أو أغمق قليلًا حول خط حدود الشخص ينبض مع حركته
- التشبّح: نسخ شبه شفافة للشخص تظهر على الحواف، خاصةً أثناء الحركة السريعة
- تمييع الحدود: حواف الشعر أو الملابس تمتزج بالخلفية بطرق تتحدى الفيزياء
عدم استقرار الخلفية عبر الزمن
حتى في المقاطع التي تبدو فيها الكاميرا ثابتة، غالبًا ما تتحول الخلفيات المولّدة بالذكاء الاصطناعي بشكل خفي. وعند التنقل بين الإطارات واحدًا تلو الآخر ستكشف:
- حوافًا معمارية مستقيمة (أطر النوافذ، وأطر الأبواب، وخطوط الفواصل بين البلاط) بها اهتزاز أو انحناء طفيف جدًا
- أجسامًا في الخلفية تغيّر شكلها بين الإطارات
- نصوصًا على اللافتات أو الملصقات أو الشاشات تبدو غير مقروءة، أو تغيّر إملاءها، أو تستخدم تسلسلات حروف لا معنى لها
عمق ميدان لا يطابق أي عدسة حقيقية
تنتج الكاميرات الحقيقية ذات البعد البؤري والفتحة المعينة عمق ميدان متوقعًا. أما نماذج الذكاء الاصطناعي فكثيرًا ما تنتج تدرجات ضبابية لا تتوافق مع أي سلوك فيزيائي للعدسات. قد تكون الخلفية ضبابية أكثر من اللازم في منطقة وحادة أكثر من اللازم في منطقة مجاورة داخل الإطار نفسه.
💡 فحص سريع: ابحث عن أي نص في خلفية الفيديو. تلتقط الكاميرات الحقيقية النص بدقة حتى عندما يكون خارج التركيز قليلًا. أما الخلفيات المولّدة بالذكاء الاصطناعي فتنتج باستمرار سلاسل نصية مشوّهة ومختلقة تتغير بين الإطارات. هذا الفحص وحده يكشف نسبة كبيرة من المحتوى المُصطنع.
مقارنة النسخ جنبًا إلى جنب
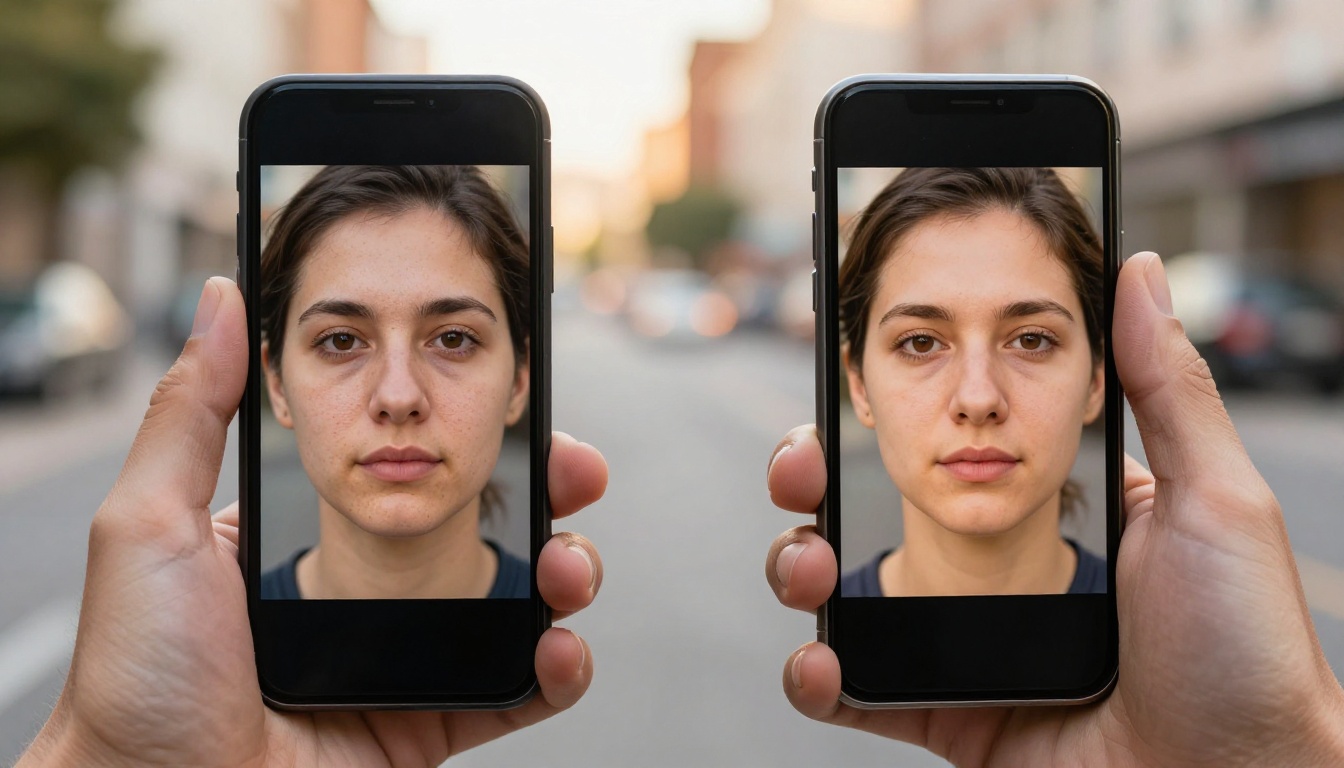
عندما تتوفر لديك نسخة من فيديو يُشتبه في توليده بالذكاء الاصطناعي ومقطع أصلي مرجعي للشخص نفسه، فإن المقارنة الجنبية بينهما تكشف كثيرًا. المجالات الرئيسية للمقارنة:
- مقارنة ملمس الجلد: هل تتغير جودة الملمس أو طابعه بين المقطعين؟
- توقيت التعابير الدقيقة: هل تأتي الاستجابات العاطفية في توقيت طبيعي، أم تصل متأخرة قليلًا؟
- الاستجابة للإضاءة: حين تتغير الإضاءة في المشهد، هل يستجيب جلد الشخص بتشتت تحت السطحي واقعي، أم يبقى اللون مسطحًا؟
- طابع الصوت: هل تحمل جودة الصوت الرنين نفسه والنَّفَس نفسه الموجودين في التسجيلات الأصلية الموثّقة؟
كيف تعمل نماذج توليد الفيديو الحديثة فعليًا
فهم طريقة توليد هذه الأدوات للفيديو يساعدك على معرفة ما الذي من المرجح أن تخطئ فيه. تشمل أقوى نماذج تحويل النص إلى فيديو اليوم، وكلها متاحة على Picasso IA:
- Veo 3 من Google: يُنتج فيديو بصوت متزامن أصلي من أوامر نصية، بمخرجات بدقة 1080p
- Sora 2 من OpenAI: يُنتج فيديو عالي الدقة باتساق زمني قوي عبر المقاطع الأطول
- Kling v2.6 من Kuaishou: يقدّم توليدًا للفيديو من النص بجودة سينمائية بدقة 1080p مع التحكم في الحركة
- Seedance 2.0 من ByteDance: توليد فيديو من النص مع تركيب صوتي مدمج
- Hailuo 02 من Minimax: توليد فيديو بدقة 1080p من أوصاف نصية مع تشغيل سريع للنموذج
- Wan 2.7 T2V من Wan Video: دقة حركة قوية بجودة مخرجات 1080p
- LTX 2 Pro من Lightricks: توليد فيديو بدقة 4K من النص مع الحفاظ على تفاصيل عالية
- Pixverse v5 من Pixverse: فيديو بدقة 1080p من أوامر نصية بسرعة توليد عالية
نماذج الانتشار وضعفها الزمني
تستخدم معظم أنظمة الذكاء الاصطناعي الحديثة للفيديو بنى قائمة على الانتشار. تبدأ هذه النماذج بضوضاء منظمة ثم تُحسّنها تدريجيًا لتصبح فيديو متماسكًا، إطارًا بعد إطار، بتوجيه من الأمر النصي والإطارات السابقة. ينتج هذا إطارات فردية مبهرة بصريًا، لكنه يخلق تحديات مستمرة في الحفاظ على الاتساق الدقيق عبر الزمن:
- تُعاد تفاصيل دقيقة مثل شكل الأذن وعدد الأصابع ونصوص الخلفية فعليًا في كل إطار، بدلًا من تثبيتها من الإطار الأول
- يوازن النموذج بين جعل كل إطار يبدو جيدًا بمفرده ومطابقة الإطارات المجاورة، وهذا التوازن هو تحديدًا المكان الذي تظهر فيه التشوهات
- الضبابية الحركية تُصطنع بدلًا من أن تكون حقيقية بصريًا، ما يعني أنها قد تظهر في اتجاهات مستحيلة فيزيائيًا بالنسبة للحركة
لماذا تبقى الأيدي دليلًا موثوقًا
رغم التحسينات الهائلة في كل جانب آخر، ما زال الفيديو المولّد بالذكاء الاصطناعي يعاني باستمرار مع الأيدي والأصابع. يظهر عدد الأصابع الصحيح ويختفي في منتصف المقطع. تنحني المفاصل في اتجاهات مستحيلة تشريحيًا. تتغير أشكال الأظافر بين الإطارات. وعندما ترى أيدي في فيديو تقيّمه، افحصها دائمًا بعناية، خاصةً أثناء الحركة.
البيانات الوصفية والبحث العكسي عن الفيديو
لا يكفي الفحص البصري وحده للتحقق عالي المخاطر. يضيف تحليل البيانات الوصفية التقنية طبقة ثانية من الثقة تعمل بشكل مستقل عن الجودة البصرية.
ما يجب فحصه في البيانات الوصفية للملف
تحتوي لقطات الفيديو الحقيقية على بيانات وصفية مدمجة يفتقر إليها المحتوى المُصطنع غالبًا، أو يملؤها بشكل غير صحيح. يمكن لأدوات مجانية مثل ExifTool أو MediaInfo أن تكشف:
- جهاز الإنشاء: تُظهر اللقطات الحقيقية طراز كاميرا محددًا وإصدار البرنامج الثابت. أما مخرجات الذكاء الاصطناعي فتُظهر عادةً أداة تصيير برمجية أو لا تحتوي على أي معلومات عن الجهاز.
- توقيعات الترميز: كثيرًا ما يستخدم الفيديو المولّد بالذكاء الاصطناعي توقيعات ترميز لا تتسق مع جهاز التسجيل المفترض أو المنصة المفترضة.
- بيانات GPS: تحتوي لقطات الكاميرات الحقيقية كثيرًا على إحداثيات الموقع. أما مخرجات الذكاء الاصطناعي فلا تحتويها أبدًا.
- طابع زمني للإنشاء مقابل تاريخ الحدث المدّعى: إذا كان الفيديو يُفترض أنه يُظهر حدثًا معينًا في تاريخ معين، فيجب أن يتسق الطابع الزمني لإنشاء الملف مع هذا الادعاء.
البحث العكسي عن الفيديو عمليًا
يُعد استخراج لقطات ثابتة للبحث العكسي عن الصور من أكثر تقنيات الكشف سهولة المتاحة دون أدوات متخصصة:
- استخرج من 3 إلى 5 إطارات من الفيديو في لحظات أساسية، خاصةً اللقطات المقرّبة للوجه
- ارفع كل إطار إلى Google Images أو TinEye للبحث العكسي
- ابحث عن صور شبه مكررة تظهر في سياقات مختلفة وغير مرتبطة
- تحقق من أقدم تاريخ ظهرت فيه الصورة على الإنترنت مقارنةً بتاريخ نشر الفيديو
أدوات الكشف الآلي
تقدم عدة منصات تحققًا من الفيديو قائمًا على الذكاء الاصطناعي:
| الأداة | الطريقة الأساسية | الاستخدام الأمثل |
|---|
| Hive Moderation | مصنِّف بالشبكات العصبية | فحص عام للتزييف العميق |
| Sensity | تحليل الاتساق الزمني | كشف تبديل الوجوه |
| Intel FakeCatcher | تحليل إشارات تدفق الدم | التحقق البيولوجي من الحيوية |
| Microsoft Video Authenticator | رصد التشوهات على مستوى الإطارات | التحقق في وسائل الإعلام الإخبارية |
هذه الأدوات ليست معصومة من الخطأ، إذ إنها مدرّبة على مخرجات النماذج الموجودة، وقد تفوتها مواد من أنظمة أحدث. لكنها تضيف ثقة معتبرة عند استخدامها إلى جانب الفحص البصري اليدوي، لا بديلًا عنه.
علامات تحذير حقيقية بدون أي أدوات
عند مشاهدة محتوى فيديو يُتداول على وسائل التواصل الاجتماعي، تملك علامات التحذير هذه أعلى قيمة تنبؤية:
- لا يوجد مصدر أصلي قابل للتحقق مرفق بالفيديو أو بوصفه
- يطلق الشخص ادعاءات مريحة بشكل مريب لرواية سياسية أو تجارية معينة
- المقطع قصير جدًا (أقل من 15 ثانية) دون أي سياق محيط
- لا يظهر إلا الوجه مع حركة جسدية أو تفاعل مع البيئة محدودين
- جودة الصوت أنظف بشكل ملحوظ من جودة الفيديو، أو العكس
- الفيديو مضغوط بشدة، ما يُخفي التشوهات التي كانت ستكون مرئية لولا ذلك
💡 الضغط يُخفي الدلائل: الفيديو المشارَك عبر تطبيقات المراسلة يُضغط غالبًا بنسب تمحو تشوهات التفاصيل الدقيقة التي كانت ستكشف أصله المُصطنع. اسعَ دائمًا إلى أعلى نسخة جودة متاحة قبل أن تُصدر حكمًا.
ماذا تعلّمك مشاهدة الفيديو المولّد بالذكاء الاصطناعي
هناك اختصار يبدو متناقضًا لبناء حدس كشف سريع: أنشئ فيديوهات بالذكاء الاصطناعي بنفسك. عندما تنتج قدرًا كافيًا من المواد المُصطنعة، تبدأ برؤية أنماط الفشل من الداخل. تلاحظ الأوامر النصية التي تنتج تشوهات أكثر. تلاحظ بنفسك كيف تتعامل النماذج مع الشعر والأيدي ونصوص الخلفية. وتطوّر إدراكًا حدسيًا لنمط "مظهر الذكاء الاصطناعي" يجعل الكشف الفوري أسرع وأكثر موثوقية بكثير من أي قائمة تحقق.
هذه هي القيمة الحقيقية للتجربة العملية مع هذه الأدوات. فالشك دون معرفة ليس إلا ريبة. أما الإلمام بكيفية صنع الفيديو المُصطنع فيخلق نوعًا من الإدراك المعايَر الذي يصمد في الظروف الواقعية، حين يكون لديك ثوانٍ لا دقائق لتقييم ما تشاهده.
ابدأ بالإنشاء لتبدأ بالكشف
أسرع طريقة لتدريب عينك هي أن تنتج فيديو مُصطنعًا بنفسك وتقارنه مباشرة بلقطات حقيقية. تجمع Picasso IA أقوى نماذج تحويل النص إلى فيديو في العالم في مكان واحد، ومنها Veo 3 وKling v2.6 وSora 2 وLTX 2 Pro، دون الحاجة إلى أي إعداد.
أنشئ مقطعًا لوجه يتكلم، ثم أبطئه إلى سرعة 0.25x ومرّ على كل بند في هذا المقال. تحقق من الرمش. تحقق من الأسنان. تحقق من نص الخلفية. تحقق من الأيدي. وخلال بضع تجارب، ستتشكل لديك حاسة معايرة لا يمكن أن تحققها أي كمية من القراءة.
تمنحك المنصة نفسها الوصول إلى مولّدات الصور وأدوات تبديل الوجوه ونماذج مزامنة الشفاه وميزات تحسين الفيديو، لتستكشف الطيف الكامل لإنشاء الوسائط المُصطنعة. تلك المعرفة من التجربة المباشرة هي أقوى أداة كشف يمكنك بناءها، ولا تكلّفك سوى الفضول.
كشف الفيديو المولّد بالذكاء الاصطناعي ليس قائمًا على الارتياب. إنه يتعلق بالحفاظ على التفكير النقدي الأساسي الذي تتطلبه بيئة الإعلام الحالية من كل من يشاهدها. الدلائل موجودة. والآن تعرف أين تنظر.


