Aquele vídeo que está circulando nas redes sociais pode não ser real. Nem um pouco. Nos últimos dois anos, o vídeo gerado por IA cruzou um limite que a maioria das pessoas não viu chegar: as falsificações agora são convincentes o bastante para enganar jornalistas treinados, autoridades policiais e, às vezes, até as pessoas que aparecem nelas. Mas convincente não significa perfeito. Todo vídeo sintético deixa rastros e, quando você sabe o que procurar, vai perceber as falhas todas as vezes.
Por que os vídeos de IA são tão difíceis de identificar hoje
A distância entre imagens reais e vídeos sintéticos diminuiu drasticamente. Ferramentas como o Veo 3, o Sora 2 e o Kling v2.6 conseguem produzir vídeos com áudio nativo, desfoque de movimento realista e continuidade de cena coerente, algo que exigiria um orçamento de Hollywood cinco anos atrás.
Os modelos são treinados com bilhões de quadros reais
Os modelos modernos de texto para vídeo são treinados com conjuntos de dados enormes de imagens do mundo real, o que significa que absorveram o vocabulário visual da autenticidade. Eles sabem como a luz se espalha por uma janela. Sabem como a roupa amassa quando alguém se senta. O problema não é que eles erram tudo, e sim que acertam quase tudo, o que torna os erros restantes mais difíceis de ver sem saber onde olhar.
O vale da estranheza diminuiu
Os primeiros deepfakes tinham sinais óbvios: tons de pele que não combinavam, expressões congeladas, fundos borrados como aquarela. Esses sinais quase desapareceram. O que resta são problemas mais sutis e sistêmicos, enraizados na forma como esses modelos geram movimento ao longo do tempo.
💡 Insight principal: O vídeo de IA é gerado com atenção à coerência espacial, mas muitas vezes tem dificuldade com a coerência temporal, ou seja, a consistência de detalhes finos ao longo de vários segundos de imagem. É aí que a maioria das falsificações se desfaz.
O rosto: quase perfeito, mas não totalmente
O rosto humano é a coisa mais difícil de falsificar de forma convincente, e continua sendo onde a maioria dos vídeos de IA se desfaz quando é examinada de perto.
O problema da textura da pele
A pele humana real tem milhares de microdetalhes: poros, pelos finos, pintas assimétricas, capilares e variações sutis de cor causadas pelo fluxo sanguíneo logo abaixo da superfície. Os modelos de IA aproximam isso com texturas procedurais que muitas vezes parecem levemente lisas demais ou levemente regulares demais.
Ao examinar um rosto em um vídeo suspeito de ser de IA, observe:
- Consistência dos poros: A pele real tem padrões de poros irregulares. A pele de IA costuma ter uma textura uniforme que se repete pelo rosto.
- Transição entre cabelo e pele: Onde termina a linha do cabelo e começa a pele? A IA tem dificuldade constante com essa fronteira.
- Assimetria facial: Os rostos humanos são naturalmente assimétricos. Traços perfeitamente simétricos são um sinal de alerta importante.
- Mudanças no tom da pele: O tom permanece exatamente igual sob diferentes ângulos de luz? Rostos reais mudam sutilmente conforme a luz se move.
Dentes e interior da boca
Um dos sinais de maior valor em qualquer análise de deepfake. Quando o sujeito fala, observe com atenção o interior da boca. Os modelos de IA costumam produzir:
- Dentes que aparecem e desaparecem entre os quadros
- Linhas da gengiva que mudam de posição quando deveriam permanecer fixas
- Línguas que se movem em arcos fisicamente impossíveis
- Sombras no interior da boca que ignoram a direção real da fonte de luz
Deriva dos acessórios do rosto
Óculos, brincos e piercings são notoriamente difíceis de manter estáveis entre os quadros para a IA. Fique atento a brincos que mudam de formato entre um corte e outro, armações de óculos que se deformam nas têmporas ou joias que parecem flutuar um pouco longe da pele, em vez de estar apoiadas nela.
Piscar: o sinal mais antigo que ainda funciona
Os padrões de piscar continuam sendo um dos indicadores mais confiáveis de vídeo sintético, apesar de anos de pesquisa ativa para corrigir o problema.
Taxas naturais e sintéticas de piscar
Os humanos piscam de 15 a 20 vezes por minuto. Os primeiros deepfakes quase não piscavam. Os modelos atuais corrigiram a taxa, mas de formas que ainda são detectáveis quando você sabe o que observar:
| Padrão | Humano real | Gerado por IA |
|---|
| Taxa de piscadas | 15-20 por minuto | Muitas vezes 10-18 por minuto |
| Duração da piscada | 150-400ms, variável | Muitas vezes uniforme, em torno de 200ms |
| Simetria das pálpebras | As pálpebras se movem levemente de forma independente | As duas pálpebras costumam se mover de forma idêntica |
| MicroPiscadas involuntárias | Presentes | Raras ou totalmente ausentes |
| Ajuste após a piscada | Os olhos costumam refocar levemente | Os olhos voltam exatamente à posição anterior |
Observe os cílios durante a piscada
Essa técnica é extremamente eficaz e não exige ferramentas especiais. Em imagens reais, os fios individuais dos cílios se separam levemente, se agrupam de forma natural e criam padrões de sombra variados na pálpebra inferior a cada piscada. Na maioria dos vídeos gerados por IA, os cílios se movem como uma unidade lisa, sem comportamento individual dos fios.
💡 Dica: Reproduza o vídeo em 0,25x de velocidade e concentre-se apenas no momento em que a pálpebra se fecha. Se os cílios se comportarem como um único formato curvo e uniforme, sem diferenciação entre os fios, trate isso como um forte sinal de alerta.
Muitas pessoas se concentram totalmente no visual ao avaliar a autenticidade de um vídeo. Isso é um erro. A sincronização entre áudio e imagem costuma ser onde o conteúdo sintético falha de forma mais evidente.
Deriva na sincronização labial
Mesmo com ferramentas dedicadas de sincronização labial, a fala gerada por IA frequentemente sai de sincronia de forma sutil. Isso é especialmente perceptível em alguns tipos de fonema:
- Consoantes bilabiais (sons de P, B, M), que exigem que os dois lábios se fechem por completo
- Fricativas (sons de F, V), que exigem os dentes superiores encostados no lábio inferior
- Final das palavras, quando o movimento dos lábios para um pouco antes ou depois do áudio ser cortado
O ambiente acústico não combina com o espaço visual
Em imagens reais, o caráter acústico de um espaço corresponde ao que você vê na tela. Uma pessoa filmada em um banheiro grande de azulejos soa diferente de alguém em um quarto com carpete. O vídeo gerado por IA costuma aplicar um perfil de áudio plano e limpo que não corresponde ao ambiente aparente. Preste atenção em:
- Ausência de reverberação ou eco natural do ambiente em relação ao espaço visível
- Fala excessivamente limpa, sem nenhum ruído de fundo do ambiente
- Volume de áudio constante, independentemente da distância do sujeito até a câmera ou do ângulo da cabeça
Padrões de respiração e cadência
Pessoas reais respiram. Dá para ouvir isso no áudio, principalmente antes de frases longas ou entre trechos rápidos. A fala gerada por IA costuma não ter nada disso, produzindo uma cadência robótica mesmo quando a qualidade da voz é convincente. As frases fluem com uma regularidade metronômica que soa profissional, mas parece não humana quando se ouve com atenção.
Artefatos no fundo e nas bordas
O fundo de um vídeo gerado por IA costuma ser seu elemento mais fraco, porque o modelo precisa manter a coerência espacial ao longo do tempo e, ao mesmo tempo, lidar com movimentos complexos em primeiro plano.
Halos e fantasmas nas bordas
Onde um sujeito em movimento encontra o fundo, o vídeo de IA frequentemente produz artefatos visíveis:
- Halos suaves: Uma franja levemente mais clara ou mais escura ao redor do contorno do sujeito que pulsa enquanto ele se move
- Efeito fantasma: Duplicatas semitransparentes do sujeito aparecendo nas bordas, principalmente durante movimentos rápidos
- Borrão nas fronteiras: Bordas de cabelo ou roupa que se misturam ao fundo de maneiras que desafiam a física
Instabilidade do fundo ao longo do tempo
Mesmo em clipes nos quais a câmera parece parada, os fundos gerados por IA costumam mudar sutilmente. Ao avançar o vídeo quadro a quadro, você percebe:
- Linhas arquitetônicas retas (molduras de janelas, batentes de portas, rejuntes de azulejos) com uma leve oscilação ou curvatura
- Objetos do fundo que mudam de formato entre os quadros
- Textos em placas, cartazes ou telas que aparecem ilegíveis, com grafia alterada ou sequências de letras sem sentido
Profundidade de campo que não corresponde a nenhuma lente real
Câmeras reais com determinada distância focal e abertura produzem uma profundidade de campo previsível. Os modelos de IA muitas vezes criam gradientes de desfoque que não correspondem a nenhum comportamento físico de lente. O fundo pode estar ao mesmo tempo desfocado demais em uma região e nítido demais em uma área vizinha, dentro do mesmo quadro.
💡 Verificação rápida: Encontre algum texto no fundo do vídeo. Câmeras reais capturam textos com precisão, mesmo quando estão levemente fora de foco. Fundos gerados por IA costumam produzir cadeias de letras desconexas e fictícias que mudam entre os quadros. Essa única verificação descarta uma grande porcentagem de conteúdo sintético.
Comparando versões lado a lado
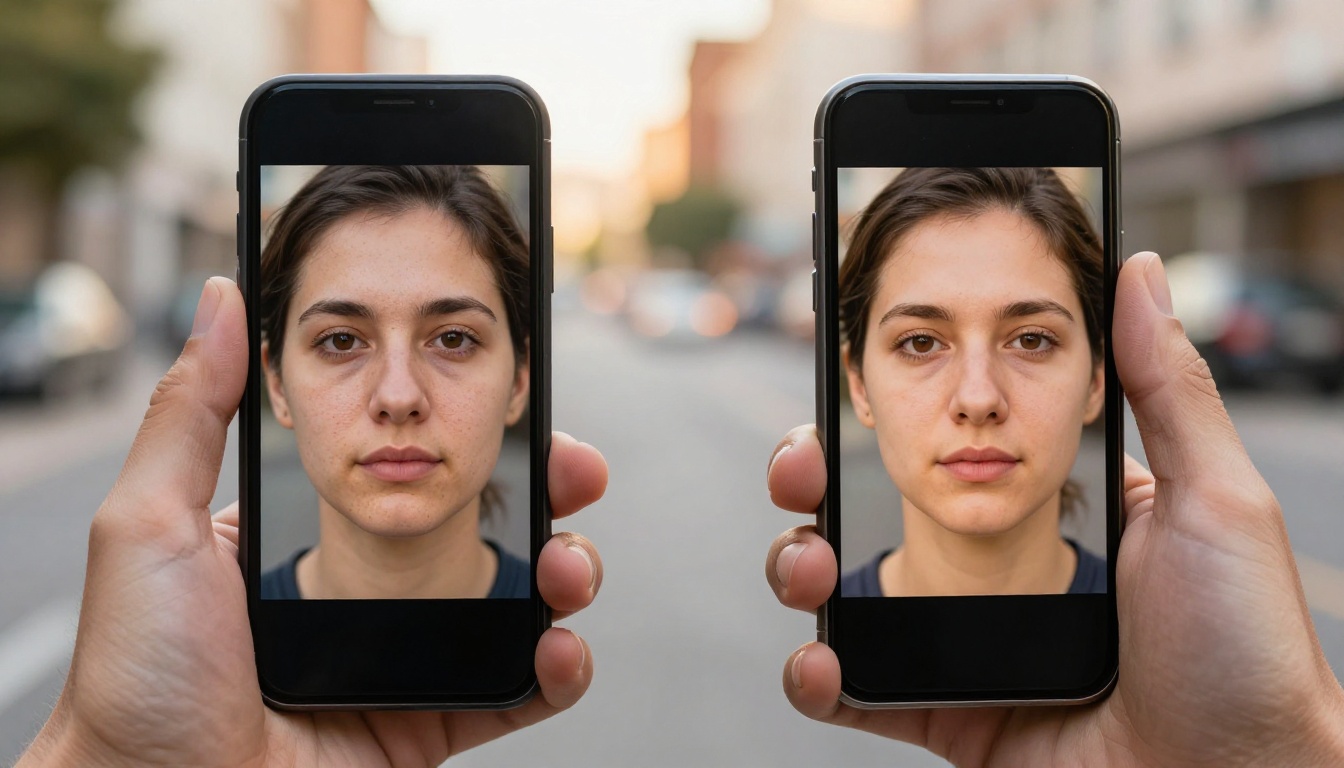
Quando você tem acesso a um vídeo suspeito de IA e a um clipe original de referência da mesma pessoa, a comparação lado a lado é extremamente reveladora. As principais áreas a comparar:
- Mapas de textura da pele: A qualidade ou o caráter da textura muda entre os dois clipes?
- Tempo das microexpressões: As reações emocionais chegam no momento natural ou aparecem um instante atrasadas?
- Resposta à iluminação: Quando a luz da cena muda, a pele do sujeito responde com dispersão subsuperficial realista, ou o tom permanece chapado?
- Timbre vocal: A qualidade da voz tem a mesma ressonância e o mesmo sopro dos registros autênticos confirmados?
Como os modelos modernos de vídeo de IA realmente funcionam
Entender como essas ferramentas geram vídeo ajuda você a saber o que elas têm mais chance de errar. Os modelos de texto para vídeo mais capazes de hoje, todos disponíveis no PicassoIA, incluem:
- Veo 3 do Google: Gera vídeo com áudio nativo sincronizado a partir de prompts de texto, com saída em 1080p
- Sora 2 da OpenAI: Produz vídeo em HD com forte consistência temporal em clipes mais longos
- Kling v2.6 da Kuaishou: Entrega texto para vídeo com qualidade cinematográfica em 1080p e controle de movimento
- Seedance 2.0 da ByteDance: Geração de vídeo a partir de texto com síntese de áudio integrada
- Hailuo 02 da Minimax: Geração de vídeo de IA em 1080p a partir de descrições de texto, com inferência rápida
- Wan 2.7 T2V da Wan Video: Forte fidelidade de movimento com qualidade de saída em 1080p
- LTX 2 Pro da Lightricks: Geração de vídeo em 4K a partir de texto, com alta retenção de detalhes
- Pixverse v5 da Pixverse: Vídeo de IA em 1080p a partir de prompts de texto, com velocidade de geração rápida
Modelos de difusão e sua fraqueza temporal
A maioria dos sistemas modernos de IA para vídeo usa arquiteturas baseadas em difusão. Eles partem de um ruído estruturado e o refinam gradualmente até formar um vídeo coerente, quadro a quadro, guiados pelo prompt de texto e pelos quadros anteriores. Isso produz quadros individuais visualmente impressionantes, mas cria desafios persistentes para manter a consistência de detalhes finos ao longo do tempo:
- Detalhes finos, como o formato da orelha, o número de dedos e o texto do fundo, são efetivamente redefinidos a cada quadro, em vez de serem fixados desde o primeiro
- O modelo equilibra entre fazer cada quadro ficar bom individualmente e combinar com os quadros vizinhos, e essa contrapartida é exatamente onde surgem os artefatos
- O desfoque de movimento é sintetizado, e não opticamente real, o que significa que ele pode aparecer em direções fisicamente impossíveis em relação ao movimento
Por que as mãos ainda são um sinal confiável
Apesar de grandes melhorias em todas as outras áreas, o vídeo de IA continua tendo dificuldade com mãos e dedos. O número correto de dedos aparece e desaparece no meio do clipe. As articulações se dobram em direções anatomicamente impossíveis. As unhas mudam de formato entre os quadros. Quando você vir mãos em um vídeo que está avaliando, examine-as sempre com cuidado, principalmente em movimento.
A inspeção visual sozinha não basta para verificações decisivas, em que há muito em jogo. A análise técnica de metadados adiciona uma segunda camada de confiança, que funciona independentemente da qualidade visual.
O que verificar nos metadados do arquivo
Imagens reais de vídeo contêm metadados incorporados que o conteúdo sintético muitas vezes não tem ou preenche de forma incorreta. Ferramentas gratuitas como o ExifTool ou o MediaInfo podem revelar:
- Dispositivo de criação: Imagens reais mostram um modelo específico de câmera e a versão do firmware. A saída de IA normalmente mostra um renderizador de software ou nenhuma informação de dispositivo.
- Assinaturas de codec: O vídeo gerado por IA costuma usar assinaturas de codec incompatíveis com o dispositivo ou a plataforma que supostamente o gravou.
- Dados de GPS: Imagens de câmeras reais frequentemente incorporam coordenadas de localização. A saída de IA nunca faz isso.
- Data de criação versus data do evento alegado: Se um vídeo supostamente mostra um evento específico em uma data específica, a data de criação do arquivo deve ser compatível com essa alegação.
Busca reversa de vídeo na prática
Extrair quadros fixos para a busca reversa de imagens é uma das técnicas de detecção mais acessíveis que existem sem ferramentas especializadas:
- Extraia de 3 a 5 quadros do vídeo em momentos-chave, principalmente closes do rosto
- Envie cada quadro para o Google Imagens ou o TinEye para uma busca reversa
- Procure imagens quase idênticas que apareçam em contextos diferentes e sem relação entre si
- Verifique a data mais antiga em que a imagem aparece on-line em comparação com a data de publicação do vídeo
Ferramentas automatizadas de detecção
Várias plataformas oferecem autenticação de vídeo baseada em IA:
| Ferramenta | Método principal | Melhor para |
|---|
| Hive Moderation | Classificador de rede neural | Triagem geral de deepfakes |
| Sensity | Análise de consistência temporal | Detecção de troca de rosto |
| Intel FakeCatcher | Análise de sinal do fluxo sanguíneo | Verificação de vida biológica |
| Microsoft Video Authenticator | Detecção de artefatos em nível de quadro | Verificação de mídia jornalística |
Essas ferramentas não são infalíveis, pois são treinadas com saídas de modelos já existentes e podem deixar passar conteúdo de sistemas mais novos. Mas elas dão confiança significativa quando usadas junto com a inspeção visual manual, e não como substituto dela.
Sinais de alerta do mundo real, sem nenhuma ferramenta
Ao assistir a conteúdo de vídeo compartilhado nas redes sociais, estes sinais de aviso têm o maior valor preditivo:
- Nenhuma fonte original verificável vinculada ao vídeo ou à sua descrição
- O sujeito faz afirmações convenientes demais para determinada narrativa política ou comercial
- O clipe é muito curto (menos de 15 segundos) e não tem nenhum contexto ao redor
- Só o rosto aparece, com pouco movimento corporal ou interação com o ambiente
- A qualidade do áudio é claramente mais limpa do que a qualidade do vídeo, ou o contrário
- O vídeo está muito comprimido, o que esconde artefatos que, de outra forma, estariam visíveis
💡 A compressão esconde os sinais: Vídeos compartilhados por aplicativos de mensagem costumam ser comprimidos em taxas que destroem os artefatos de detalhe fino que, de outra forma, denunciariam a origem sintética. Sempre procure a versão de maior qualidade disponível antes de formar uma opinião.
O que assistir a vídeos de IA ensina
Existe um atalho contraintuitivo para desenvolver rapidamente o instinto de detecção: gere você mesmo vídeos de IA. Quando você produz imagens sintéticas suficientes, começa a ver os padrões de falha por dentro. Percebe quais prompts geram mais artefatos. Observa, na prática, como os modelos lidam com cabelo, mãos e texto de fundo. Você desenvolve um reconhecimento intuitivo do "visual de IA" que torna a detecção em tempo real mais rápida e muito mais confiável do que qualquer checklist.
Esse é o valor real da experiência prática com essas ferramentas. Ceticismo sem conhecimento é apenas desconfiança. A familiaridade com a forma como o vídeo sintético é feito cria o tipo de percepção calibrada que se sustenta em condições reais, quando você tem segundos, e não minutos, para avaliar o que está assistindo.
Comece a criar para começar a identificar
A forma mais rápida de treinar o olhar é produzir vídeo sintético você mesmo e compará-lo diretamente com imagens reais. O PicassoIA reúne os modelos de texto para vídeo mais capazes do mundo em um só lugar, incluindo o Veo 3, o Kling v2.6, o Sora 2 e o LTX 2 Pro, sem nenhuma configuração necessária.
Gere um clipe de um rosto falando e depois reduza a velocidade para 0,25x e percorra cada item deste artigo. Verifique a piscada. Verifique os dentes. Verifique o texto do fundo. Verifique as mãos. Em poucos experimentos, sua percepção estará calibrada de uma forma que nenhuma quantidade de leitura consegue replicar.
A mesma plataforma dá acesso a geradores de imagem, ferramentas de troca de rosto, modelos de sincronização labial e recursos de melhoria de vídeo, para que você possa explorar todo o espectro da criação de mídia sintética. Esse conhecimento na prática é a ferramenta de detecção mais poderosa que você pode desenvolver, e custa apenas curiosidade.
Identificar vídeo gerado por IA não é sobre paranoia. É sobre manter o pensamento crítico básico que o ambiente atual de mídia exige de quem assiste a ele. Os sinais estão lá. Agora você sabe onde procurar.


