La vidéo qui circule sur les réseaux sociaux n’est peut-être pas réelle. Pas même un peu. Ces deux dernières années, la vidéo générée par IA a franchi un seuil que peu de gens avaient anticipé : les faux sont désormais assez convaincants pour tromper des journalistes formés, des forces de l’ordre et, parfois, les personnes qui y apparaissent. Mais être convaincant ne veut pas dire être parfait. Chaque vidéo de synthèse laisse des traces, et une fois que vous savez où regarder, vous repérez les failles à chaque fois.
Pourquoi les vidéos d’IA sont-elles si difficiles à repérer aujourd’hui ?
L’écart entre les images réelles et la vidéo de synthèse s’est considérablement réduit. Des outils comme Veo 3, Sora 2 et Kling v2.6 peuvent produire une vidéo avec audio natif, un flou de bougé réaliste et une continuité de scène cohérente, ce qui aurait exigé un budget hollywoodien il y a cinq ans.
Les modèles sont entraînés sur des milliards d’images réelles
Les modèles modernes de texte vers vidéo sont entraînés sur d’énormes jeux de données d’images tournées dans le monde réel, ce qui signifie qu’ils ont assimilé le vocabulaire visuel de l’authenticité. Ils savent comment la lumière se diffuse à travers une fenêtre. Ils savent comment un vêtement se plisse quand quelqu’un s’assoit. Le problème n’est pas qu’ils se trompent sur tout, c’est qu’ils réussissent presque tout, ce qui rend les erreurs restantes plus difficiles à voir si vous ne savez pas où regarder.
La vallée de l’étrange s’est rétrécie
Les premiers deepfakes présentaient des défauts évidents : des teintes de peau incohérentes, des expressions figées, des arrière-plans flous comme de l’aquarelle. Ces défauts ont largement disparu. Il reste des problèmes plus subtils et plus systémiques, liés à la façon dont ces modèles génèrent le mouvement dans le temps.
💡 Point clé : la vidéo générée par IA accorde de l’attention à la cohérence spatiale, mais elle peine souvent avec la cohérence temporelle, c’est-à-dire la constance des détails fins sur plusieurs secondes de séquence. C’est là que la plupart des faux finissent par se trahir.
Le visage : presque parfait, mais pas tout à fait
Le visage humain est ce qu’il y a de plus difficile à imiter de façon convaincante, et c’est toujours là que la plupart des vidéos d’IA craquent à un examen attentif.
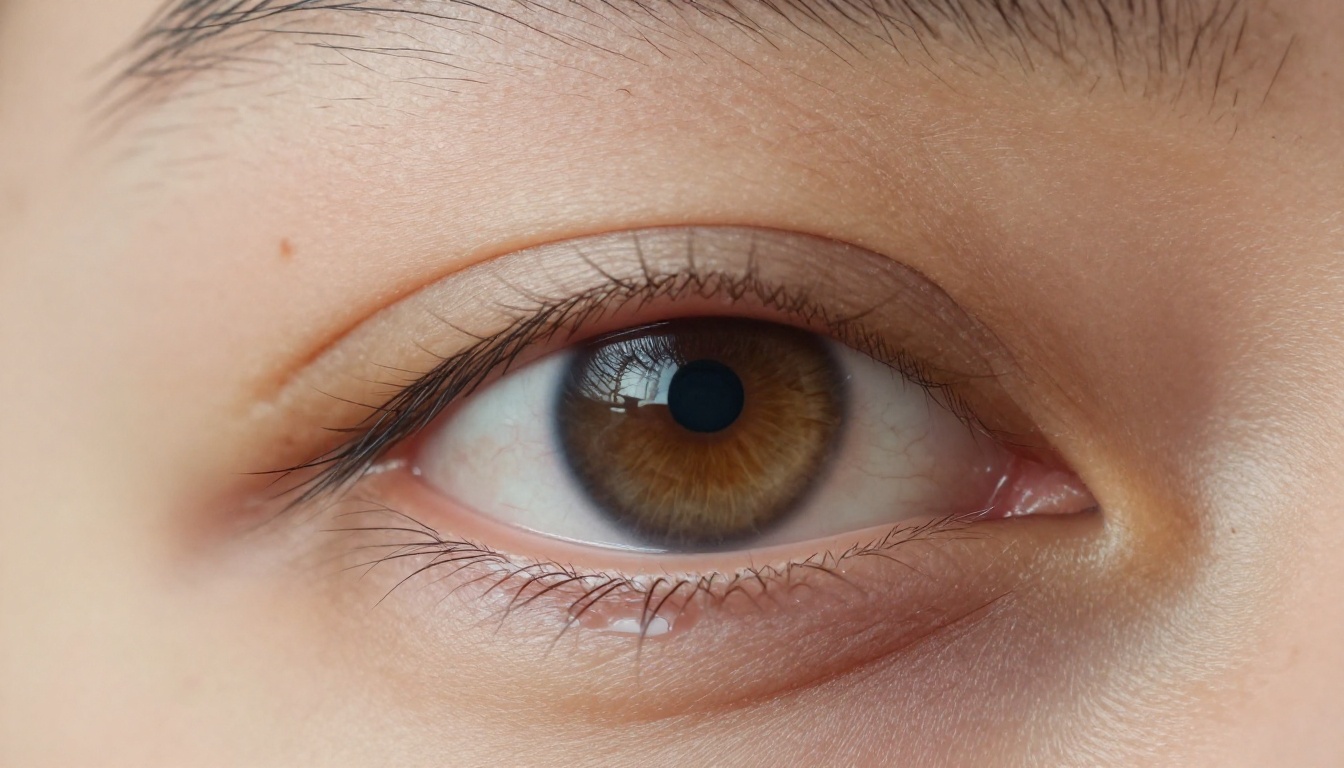
Le problème de la texture de la peau
La peau humaine réelle présente des milliers de micro-détails : pores, fins duvets, grains de beauté asymétriques, capillaires, ainsi que de subtiles variations de couleur liées à la circulation sanguine sous la surface de la peau. Les modèles d’IA reproduisent cela avec des textures procédurales qui paraissent souvent un peu trop lisses ou un peu trop régulières.
Lorsque vous examinez un visage dans une vidéo d’IA suspectée, recherchez :
- La cohérence des pores : la vraie peau présente des motifs de pores irréguliers. La peau générée par IA a souvent une texture uniforme qui se répète sur le visage.
- La transition cheveux-peau : où la ligne des cheveux s’arrête-t-elle et où commence la peau ? L’IA peine régulièrement à reproduire cette frontière.
- L’asymétrie faciale : les visages humains sont naturellement asymétriques. Des traits parfaitement symétriques constituent un signal d’alarme important.
- Les variations de teint : le teint reste-t-il exactement le même sous différents angles d’éclairage ? Les vrais visages changent subtilement quand la lumière bouge.
Les dents et l’intérieur de la bouche
L’un des indices les plus révélateurs dans toute analyse de deepfake. Quand un sujet parle, observez attentivement l’intérieur de sa bouche. Les modèles d’IA produisent fréquemment :
- Des dents qui apparaissent et disparaissent d’une image à l’autre
- Des lignes de gencive qui se déplacent alors qu’elles devraient rester fixes
- Des langues qui bougent selon des trajectoires physiquement impossibles
- Des ombres dans la bouche qui ignorent la direction réelle de la source lumineuse
La dérive des accessoires du visage
Les lunettes, les boucles d’oreilles et les piercings sont notoirement difficiles à stabiliser d’une image à l’autre pour l’IA. Surveillez les boucles d’oreilles qui changent de forme entre deux plans, les montures de lunettes qui se déforment au niveau des branches, ou les bijoux qui semblent flotter légèrement au-dessus de la peau au lieu de reposer dessus.
Le clignement des yeux : l’indice le plus ancien qui fonctionne encore
Les schémas de clignement restent l’un des indicateurs les plus fiables de vidéo synthétique, malgré des années de recherche active pour corriger le problème.
Fréquence de clignement naturelle ou synthétique
Un humain cligne des yeux 15 à 20 fois par minute. Les premiers deepfakes clignaient presque pas. Les modèles actuels ont corrigé la fréquence, mais de façons encore détectables quand on sait quoi observer :
| Critère | Humain réel | Généré par IA |
|---|
| Fréquence de clignement | 15 à 20 par minute | Souvent 10 à 18 par minute |
| Durée du clignement | 150 à 400 ms, variable | Souvent uniforme, vers 200 ms |
| Symétrie des paupières | Les paupières bougent légèrement de façon indépendante | Les deux paupières bougent presque toujours de manière identique |
| Micro-clignements involontaires | Présents | Rares, voire absents |
| Ajustement après le clignement | Les yeux se refocalisent souvent légèrement | Les yeux reviennent brusquement à leur position exacte d’avant |
Observez les cils pendant un clignement
Cette technique est extrêmement efficace et ne nécessite aucun outil spécial. Dans une vraie séquence, les cils se séparent légèrement, forment naturellement des paquets et projettent des ombres variables sur la paupière inférieure à chaque clignement. Dans la plupart des vidéos générées par IA, les cils bougent comme une seule masse lisse, sans comportement individuel des poils.
💡 Astuce : lisez la vidéo à 0,25x et concentrez-vous uniquement sur le moment où la paupière se ferme. Si les cils se comportent comme une forme courbe uniforme, sans différenciation des poils, considérez-le comme un signal d’alerte fort.
Audio : quand la voix ne correspond pas au visage
Beaucoup de gens se concentrent entièrement sur l’image pour évaluer l’authenticité d’une vidéo. C’est une erreur. La synchronisation audiovisuelle est souvent le point où le contenu synthétique se désagrège le plus clairement.
La dérive de la synchronisation labiale
Même avec des outils de synchronisation labiale dédiés, la parole générée par IA se désynchronise fréquemment, de façon subtile. C’est particulièrement visible sur certains types de phonèmes :
- Les consonnes bilabiales (sons P, B, M) qui exigent que les deux lèvres se referment complètement
- Les fricatives (sons F, V) qui exigent que les dents du haut touchent la lèvre inférieure
- Les fins de mots où le mouvement des lèvres s’arrête légèrement avant ou après la coupure du son
L’environnement acoustique ne correspond pas à l’espace visuel
Dans une vraie séquence, la qualité acoustique d’un lieu correspond à ce que vous voyez à l’écran. Une personne filmée dans une grande salle de bain carrelée ne sonne pas comme quelqu’un dans une chambre moquettée. La vidéo générée par IA applique couramment un profil audio plat et propre qui ne correspond pas à l’environnement apparent. Écoutez :
- L’absence de réverbération ou d’écho naturel de la pièce par rapport à l’espace visible
- Une parole anormalement propre, sans aucun bruit de fond ambiant
- Un volume sonore constant, quelle que soit la distance du sujet à la caméra ou l’orientation de sa tête
Respiration et rythme de la parole
Les locuteurs réels respirent. On l’entend souvent dans l’audio, en particulier avant les longues phrases ou entre des enchaînements rapides. La parole générée par IA en est fréquemment dépourvue, ce qui produit une cadence robotique, même lorsque la qualité vocale elle-même est convaincante. Les phrases s’enchaînent avec une régularité de métronome qui paraît professionnelle mais sonne non humaine à l’écoute attentive.
Artefacts d’arrière-plan et de contours
L’arrière-plan d’une vidéo générée par IA est souvent son élément le plus faible, car le modèle doit maintenir la cohérence spatiale dans le temps tout en gérant un mouvement complexe au premier plan.
Halos et effets fantômes sur les contours
Là où un sujet en mouvement rencontre l’arrière-plan, la vidéo d’IA produit fréquemment des artefacts visibles :
- Halos doux : une frange légèrement plus claire ou plus sombre autour du contour du sujet, qui pulse à mesure qu’il bouge
- Effet fantôme : des doublons semi-transparents du sujet apparaissant aux bords, surtout pendant les mouvements rapides
- Bavures aux limites : les contours des cheveux ou des vêtements se fondent dans l’arrière-plan d’une façon qui défie la physique
L’instabilité de l’arrière-plan dans le temps
Même dans les plans où la caméra paraît immobile, les arrière-plans générés par IA se déplacent souvent subtilement. En parcourant la vidéo image par image, on remarque :
- Des arêtes architecturales droites (cadres de fenêtres, chambranles de portes, joints de carrelage) qui présentent un très léger tremblement ou une courbure
- Des objets d’arrière-plan qui changent de forme d’une image à l’autre
- Du texte sur des panneaux, des affiches ou des écrans qui paraît illisible, change d’orthographe ou affiche des suites de lettres absurdes
Une profondeur de champ qui ne correspond à aucun objectif réel
Les vraies caméras, avec une focale et une ouverture données, produisent une profondeur de champ prévisible. Les modèles d’IA produisent souvent des dégradés de flou qui ne correspondent à aucun comportement physique d’objectif. L’arrière-plan peut être à la fois trop flou dans une zone et trop net dans une zone voisine du même cadre.
💡 Vérification rapide : repérez un texte quelconque dans l’arrière-plan de la vidéo. Les vraies caméras restituent correctement le texte, même légèrement hors mise au point. Les arrière-plans générés par IA produisent couramment des suites de caractères déformées et fictives, qui changent d’une image à l’autre. Ce seul contrôle écarte une grande part des contenus synthétiques.
Comparer les versions côte à côte
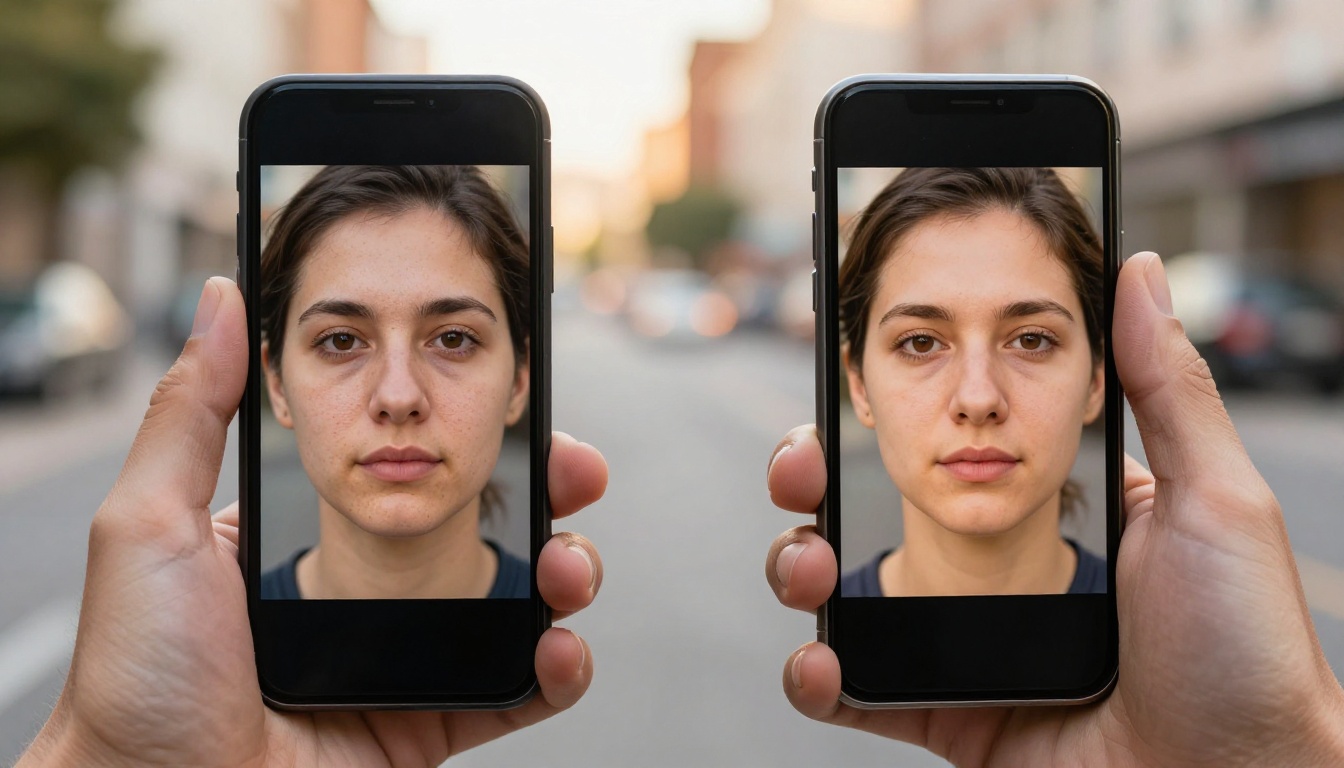
Lorsque vous disposez à la fois d’une vidéo d’IA suspectée et d’une séquence de référence originale de la même personne, la comparaison côte à côte est extrêmement révélatrice. Les points clés à comparer :
- La texture de la peau : la qualité ou le caractère de la texture change-t-il entre les deux séquences ?
- Le moment des micro-expressions : les réactions émotionnelles sont-elles synchronisées naturellement, ou arrivent-elles un temps trop tard ?
- La réaction à la lumière : quand l’éclairage de la scène change, la peau du sujet réagit-elle avec une diffusion sous-cutanée réaliste, ou le teint reste-t-il plat ?
- Le timbre de la voix : la qualité vocale présente-t-elle la même résonance et le même souffle que des enregistrements authentiques ?
Comprendre comment ces outils génèrent la vidéo vous aide à savoir ce qu’ils risquent de rater. Les modèles de texte vers vidéo les plus performants actuellement, tous disponibles sur Picasso IA, comprennent :
- Veo 3 de Google : génère une vidéo avec audio synchronisé natif à partir de prompts textuels, en sortie 1080p
- Sora 2 d’OpenAI : produit une vidéo HD avec une forte cohérence temporelle sur des séquences plus longues
- Kling v2.6 de Kuaishou : offre une génération texte vers vidéo de qualité cinématographique en 1080p, avec contrôle du mouvement
- Seedance 2.0 de ByteDance : génération texte vers vidéo avec synthèse audio intégrée
- Hailuo 02 de Minimax : génération de vidéos IA en 1080p à partir de descriptions textuelles, avec une inférence rapide
- Wan 2.7 T2V de Wan Video : une forte fidélité de mouvement avec une qualité de sortie en 1080p
- LTX 2 Pro de Lightricks : génération vidéo en 4K à partir de texte, avec une bonne conservation des détails
- Pixverse v5 de Pixverse : vidéo IA en 1080p à partir de prompts textuels, avec une génération rapide
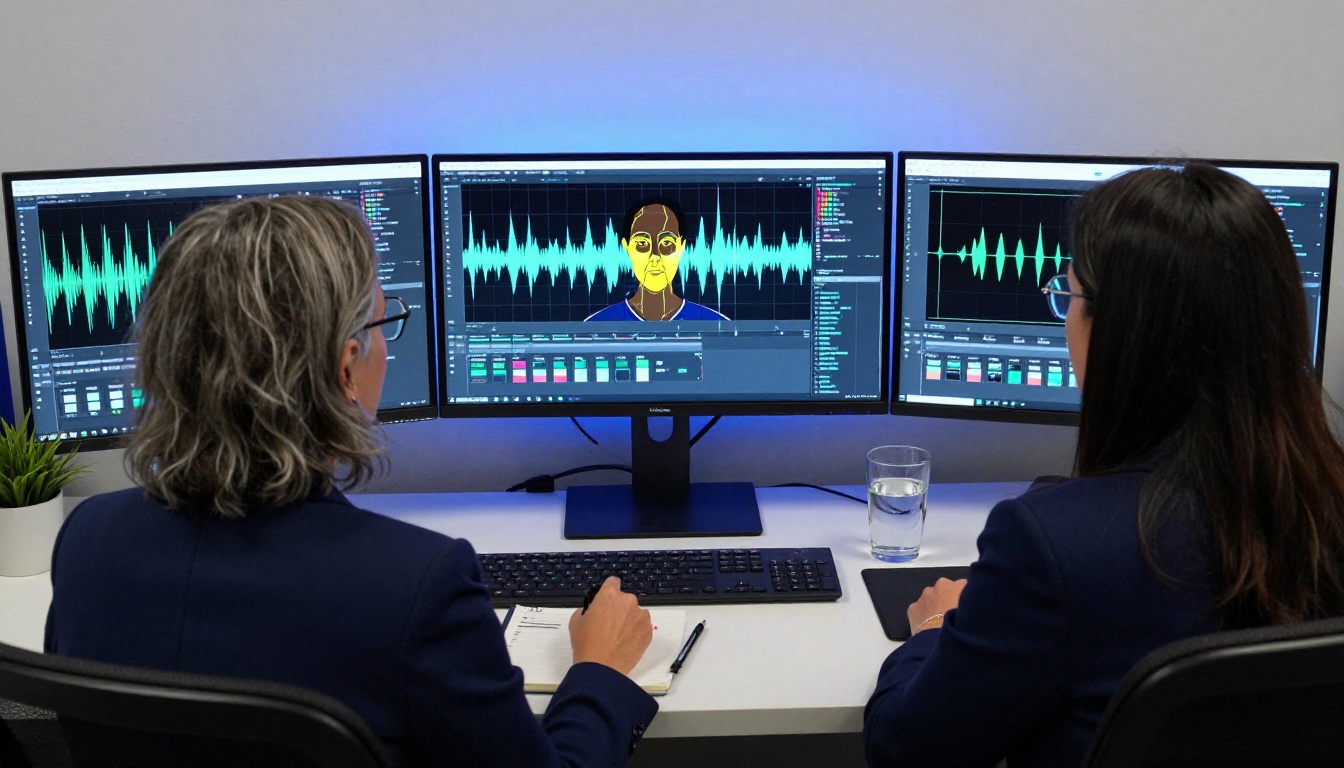
Les modèles de diffusion et leur faiblesse temporelle
La plupart des systèmes de vidéo IA modernes utilisent des architectures fondées sur la diffusion. Ils partent d’un bruit structuré et l’affinent progressivement pour obtenir une vidéo cohérente, image par image, guidés par le prompt textuel et les images précédentes. Cela produit des images individuelles visuellement impressionnantes, mais crée des difficultés persistantes pour maintenir une cohérence fine dans le temps :
- Les détails fins comme la forme de l’oreille, le nombre de doigts ou le texte d’arrière-plan sont en réalité redécidés à chaque image, au lieu d’être figés dès la première
- Le modèle arbitre entre rendre chaque image séduisante individuellement et correspondre aux images voisines, et c’est précisément dans ce compromis que surgissent les artefacts
- Le flou de bougé est synthétisé et non optiquement réel, ce qui peut apparaître dans des directions physiquement impossibles par rapport au mouvement
Pourquoi les mains restent un indice fiable
Malgré des progrès massifs dans tous les autres domaines, la vidéo d’IA peine systématiquement avec les mains et les doigts. Le bon nombre de doigts apparaît et disparaît en cours de plan. Les articulations se plient dans des directions anatomiquement impossibles. Les ongles changent de forme d’une image à l’autre. Quand vous voyez des mains dans une vidéo que vous évaluez, examinez-les toujours avec soin, surtout en mouvement.
L’inspection visuelle seule ne suffit pas pour une vérification à fort enjeu. L’analyse technique des métadonnées ajoute un second niveau de confiance, indépendant de la qualité visuelle.
Ce qu’il faut vérifier dans les métadonnées du fichier
Les séquences vidéo réelles contiennent des métadonnées intégrées que le contenu synthétique n’a souvent pas, ou qu’il renseigne de façon incorrecte. Des outils gratuits comme ExifTool ou MediaInfo peuvent révéler :
- Le périphérique de création : une vraie séquence affiche un modèle de caméra précis et une version de micrologiciel. La sortie d’IA affiche généralement un moteur de rendu logiciel ou aucune information sur l’appareil.
- Les signatures de codec : la vidéo générée par IA utilise souvent des signatures de codec incompatibles avec l’appareil ou la plateforme d’enregistrement supposés.
- Les données GPS : les images de caméra réelles intègrent fréquemment des coordonnées de localisation. La sortie d’IA n’en contient jamais.
- La date de création par rapport à la date de l’événement annoncé : si une vidéo est censée montrer un événement précis à une date précise, la date de création du fichier doit être cohérente avec cette affirmation.
La recherche inversée de vidéos en pratique
Extraire des images fixes pour une recherche d’image inversée est l’une des techniques de détection les plus accessibles, sans outils spécialisés :
- Extrayez 3 à 5 images de la vidéo à des moments clés, surtout des gros plans du visage
- Importez chaque image dans Google Images ou TinEye pour une recherche inversée
- Recherchez des images quasi identiques apparaissant dans des contextes différents et sans rapport
- Vérifiez la date la plus ancienne à laquelle l’image apparaît en ligne, et comparez-la à la date de publication de la vidéo
Les outils de détection automatisés
Plusieurs plateformes proposent une authentification vidéo par IA :
| Outil | Méthode principale | Idéal pour |
|---|
| Hive Moderation | Classifieur par réseau de neurones | Détection générale de deepfakes |
| Sensity | Analyse de la cohérence temporelle | Détection d’échange de visage |
| Intel FakeCatcher | Analyse du signal de flux sanguin | Vérification de la vivacité biologique |
| Microsoft Video Authenticator | Détection d’artefacts au niveau des images | Vérification des médias d’information |
Ces outils ne sont pas infaillibles, car ils sont entraînés sur les sorties de modèles existants et peuvent passer à côté des contenus issus de systèmes plus récents. Mais ils apportent une confiance réelle lorsqu’ils sont utilisés en complément d’une inspection visuelle manuelle, et non à sa place.
Signaux d’alerte concrets, sans aucun outil
Lorsque vous regardez une vidéo partagée sur les réseaux sociaux, ces signes d’alerte ont la plus grande valeur prédictive :
- Aucune source originale vérifiable rattachée à la vidéo ou à sa description
- Le sujet affirme des choses trop opportunes pour un récit politique ou commercial précis
- Le clip est très court (moins de 15 secondes) et ne comporte aucun contexte autour
- Seul le visage est montré, avec peu de mouvement corporel ou d’interaction avec l’environnement
- La qualité audio est nettement plus propre que la qualité vidéo, ou l’inverse
- La vidéo est fortement compressée, ce qui masque des artefacts qui seraient autrement visibles
💡 La compression masque les indices : une vidéo partagée via des applications de messagerie est souvent compressée à des taux qui détruisent les artefacts fins qui trahiraient autrement une origine synthétique. Recherchez toujours la version de meilleure qualité disponible avant de vous faire une opinion.
Ce que l’on apprend en regardant des vidéos d’IA
Il existe un raccourci contre-intuitif pour acquérir rapidement des réflexes de détection : générer vous-même des vidéos d’IA. Lorsque vous avez produit assez de séquences de synthèse, vous commencez à voir les schémas de défaillance de l’intérieur. Vous remarquez quels prompts produisent davantage d’artefacts. Vous observez de première main la façon dont les modèles gèrent les cheveux, les mains et le texte d’arrière-plan. Vous développez une reconnaissance de formes intuitive du « look IA », qui rend la détection en temps réel plus rapide et bien plus fiable que n’importe quelle liste de contrôle.
C’est là toute la valeur de l’expérience pratique avec ces outils. Le scepticisme sans connaissance n’est qu’une suspicion. La familiarité avec la façon dont une vidéo de synthèse est fabriquée crée une perception calibrée, capable de tenir dans des conditions réelles, lorsque vous disposez de secondes plutôt que de minutes pour évaluer ce que vous regardez.
Commencez à créer pour apprendre à repérer
La façon la plus rapide d’entraîner votre regard est de produire vous-même une vidéo de synthèse et de la comparer directement à des images réelles. Picasso IA réunit au même endroit les modèles de texte vers vidéo les plus performants au monde, dont Veo 3, Kling v2.6, Sora 2 et LTX 2 Pro, sans aucune configuration requise.
Générez une séquence d’un visage qui parle, puis ralentissez-la à 0,25x et passez en revue chaque point de cet article. Vérifiez le clignement. Vérifiez les dents. Vérifiez le texte d’arrière-plan. Vérifiez les mains. En quelques expériences, votre perception sera calibrée d’une façon qu’aucune lecture ne peut reproduire.
La même plateforme vous donne accès à des générateurs d’images, à des outils d’échange de visage, à des modèles de synchronisation labiale et à des fonctions d’amélioration vidéo, pour explorer tout le spectre de la création de médias synthétiques. Cette connaissance de première main est l’outil de détection le plus puissant que vous puissiez construire, et elle ne coûte que de la curiosité.
Repérer une vidéo générée par IA ne relève pas de la paranoïa. Il s’agit simplement de garder le sens critique élémentaire qu’exige aujourd’hui l’environnement médiatique de quiconque regarde des images. Les indices sont là. Vous savez désormais où regarder.


