كان تسجيل اجتماع مدته ساعة يعني قضاء ساعتين إضافيتين في كتابته. لقد غيّر تفريغ الصوت بالذكاء الاصطناعي هذا الأمر تمامًا. تستطيع الأدوات المعتمدة على النماذج الكبيرة للكلام تحويل ساعة الصوت نفسها إلى مستند نصي نظيف، يحدد المتحدثين، في أقل من دقيقتين، وبدقة تضاهي دقة مفرّغ بشري محترف.
إذا كانت لديك ملفات صوتية على القرص الصلب، أو كنت تسجّل الاجتماعات والبودكاست والمحاضرات والمقابلات بانتظام، فسيوضح لك هذا المقال بالتفصيل كيف تستفيد من الذكاء الاصطناعي في معالجتها.
لماذا يهدر التفريغ اليدوي وقتك؟
تحتاج كل ساعة من الصوت إلى ما يقارب أربع إلى ست ساعات من التفريغ اليدوي. وهذا ليس سير عمل مستدامًا لأي شخص ينتج محتوى صوتيًا بشكل منتظم، أو يعمل في مجالات تحتاج فيها المحادثات المسجّلة إلى توثيق.
التكلفة الزمنية الحقيقية
تخيّل ما يحدث حين تجري صحفية مقابلات مع ثلاثة مصادر في يوم واحد. مدة كل تسجيل 45 دقيقة. يستغرق التفريغ اليدوي هنا ما بين 10 و15 ساعة من الكتابة قبل أن تبدأ فعليًا في كتابة المقال. أما تفريغ الصوت بالذكاء الاصطناعي فيختصر ذلك إلى نحو 10 دقائق في المجموع، مع نص جاهز للنسخ والتحرير فورًا.
ينطبق الحساب نفسه تقريبًا على:
- محرّرو البودكاست الذين ينقّحون تسجيلات حلقات مدتها 60 دقيقة
- الفرق القانونية التي تحتاج إلى سجلات حرفية لجلسات الإفادة
- الباحثون الذين يجمعون بيانات المقابلات النوعية
- أقسام الموارد البشرية التي توثّق جلسات المقابلات الوظيفية
حين تتراجع الدقة
التفريغ اليدوي معرّض أيضًا لأخطاء تتراكم مع الوقت. يتسلل الإرهاق، وتُساء سماع الكلمات، ويصبح التنسيق غير متسق. أما التعرف التلقائي على الكلام بالذكاء الاصطناعي فلا يتعب. إنه يمنح آخر 30 ثانية من التسجيل القدر نفسه من الانتباه الذي يمنحه للدقائق الأولى.
كانت نقطة الضعف في أنظمة التعرف التلقائي القديمة على الكلام هي الكلام ذو اللكنات والمحادثات المتداخلة. وقد سدّت النماذج الحديثة مثل GPT-4o Transcribe وGemini 3 Pro معظم هذه الفجوة بفضل مجموعات بيانات تدريب تمتد عبر مئات اللغات واللهجات.
كيف يحوّل الذكاء الاصطناعي الكلام إلى نص؟
يعمل التعرف التلقائي على الكلام بتقسيم الصوت إلى مقاطع صغيرة تسمى الإطارات، مدة كل منها عادةً من 10 إلى 25 ميلي ثانية، ثم يُجري تحليلًا صوتيًا لتحديد الفونيمات، وهي وحدات الصوت الأساسية في اللغة. تُقارَن هذه الفونيمات بعد ذلك بنموذج لغوي يتنبأ بالكلمات والجمل الأكثر احتمالًا بالنظر إلى السياق المحيط.
ما الذي تختلف فيه نماذج الكلام الحديثة؟
اعتمدت أنظمة التعرف التلقائي القديمة على قواميس فونيمات جامدة قائمة على القواعد، وتدرّبت على مجموعات بيانات صوتية صغيرة نسبيًا ونظيفة. وكانت تنهار بسرعة أمام الضوضاء الخلفية، أو الكلام السريع، أو اللكنات الإقليمية.
تُدرَّب النماذج المتاحة اليوم على مجموعات بيانات متعددة اللغات ضخمة، تضم في كثير من الأحيان مئات الآلاف من ساعات الصوت الواقعي من بيئات متنوعة. وهي تستخدم بنى المحوّلات (transformers) التي تنظر إلى السياق الكامل للمقطع الكلامي بدلًا من المطابقة إطارًا بإطار، وهو ما ينتج مخرجات أكثر تماسكًا بشكل ملحوظ.
كيف تغيّرت الدقة؟
معدل خطأ الكلمات (WER) هو المقياس المعياري لجودة التفريغ. يعني معدل خطأ يبلغ 5% أن 5 كلمات من كل 100 كلمة خاطئة. ويحقق مفرّغون بشريون محترفون عادةً معدل خطأ يبلغ نحو 4 إلى 5% في التسجيلات الواضحة.
تضاهي أفضل نماذج الذكاء الاصطناعي الحالية، مثل GPT-4o Transcribe، هذا المعيار أو تتجاوزه في الصوت النظيف، وتظل تنافسية في التسجيلات ذات الضوضاء أو اللكنات أو الإيقاع السريع، وهي تسجيلات يجد المفرّغون البشريون صعوبة فيها كثيرًا.
💡 نصيحة: تؤثر جودة الصوت مباشرة في جودة النص. فالتسجيل الذي يُنجَز بميكروفون جيد وبحد أدنى من ضوضاء الخلفية سينتج دائمًا نصًا أدق من تسجيل على هاتف في غرفة مزدحمة.
أفضل 5 نماذج ذكاء اصطناعي لتفريغ الصوت
تتيح لك PicassoIA الوصول المباشر إلى خمسة نماذج جاهزة للإنتاج للكلام إلى نص، ولكل منها نقاط قوة مميزة. إليك مقارنة سريعة بينها.
| النموذج | الاستخدام الأنسب | اللغات | السرعة |
|---|
| GPT-4o Transcribe | الاستخدام العام، دقة عالية | 57+ | سريع |
| GPT-4o Mini Transcribe | حجم كبير، كفاءة في التكلفة | 57+ | سريع جدًا |
| Gemini 3 Pro | التسجيلات الطويلة، الصوت الغني بالسياق | 100+ | سريع |
| Granite Speech 4.1 2B | الاستخدام المؤسسي المنظّم | 6 | سريع جدًا |
| Granite Speech 3.3 8B | تفريغ مؤسسي عالي التفصيل | 6 | سريع |
GPT-4o Transcribe
GPT-4o Transcribe هو النموذج الرائد من OpenAI للكلام إلى نص. يتعامل مع الكلام ذي اللكنات والحديث المتداخل والصوت الصاخب بصورة أفضل من معظم الأنظمة المنافسة. وبالنسبة إلى صناع البودكاست والصحفيين ومنتجي المحتوى الذين يحتاجون إلى نتائج موثوقة عبر ظروف تسجيل متنوعة، فهذا هو الخيار الافتراضي.
يدعم التنقيط التلقائي وفواصل الفقرات، ويستطيع في كثير من الأحيان تحديد أسماء العلم والمصطلحات التقنية بشكل صحيح من السياق وحده، دون أي تدريب مسبق على مفرداتك الخاصة.
GPT-4o Mini Transcribe
GPT-4o Mini Transcribe إصدار أخف وأسرع مصمَّم للإنتاجية العالية. إذا كنت تعالج تراكمًا كبيرًا من التسجيلات أو تشغّل سير عمل يفرّغ الصوت شبه فوريًا، فإن هذا النموذج يقدم دقة ممتازة بجزء بسيط من تكلفة المعالجة. والفرق في الجودة مقارنةً بالنموذج الكامل ضئيل في التسجيلات النظيفة.
Gemini 3 Pro
يتفوق نموذج Gemini 3 Pro من Google في التعامل مع الصوت الطويل الغني بالسياق. وتجعله بنيته متعددة الوسائط بارعًا بشكل خاص في قراءة تدفق الحديث، وتحولات المواضيع، والصياغات الدقيقة. يدعم أكثر من 100 لغة، ما يجعله الخيار الأفضل لسير عمل التفريغ متعدد اللغات.
💡 نصيحة: استخدم Gemini 3 Pro لتسجيلات المؤتمرات، ونقاشات الحلقات الحوارية متعددة المتحدثين، أو أي صوت يكون فيه الفهم السياقي للمعنى مهمًا، لا دقة الكلمات وحدها.
Granite Speech 4.1 2B
صُمّم Granite Speech 4.1 2B من IBM كنموذج مدمج لعمليات النشر المؤسسية التي يكون فيها زمن الاستجابة حاسمًا. يدعم ست لغات ومُعدّ للكلام المؤسسي المنظّم، ما يجعله قويًا في اجتماعات الشركات، وتسجيلات مراكز الاتصال، وتوثيق الموارد البشرية.
Granite Speech 3.3 8B
Granite Speech 3.3 8B هو النموذج المؤسسي الأكبر من IBM. يضحّي بقدر من السرعة مقابل معالجة أفضل للبنى الجملية المعقدة والمفردات المتخصصة في المجال. وإذا كان صوتك يتعلق بمجالات تقنية مثل الطب أو القانون أو المالية، فهذا النموذج يتعامل مع المصطلحات المتخصصة بموثوقية أكبر من الإصدار 2B الأصغر.
أي نموذج يجب أن تختار؟
يعتمد الاختيار الصحيح على ثلاثة أمور: نوع الصوت الذي تعمل عليه، واللغات المعنية، ومقدار التحرير اللاحق الذي أنت مستعد للقيام به.
| الموقف | النموذج الموصى به |
|---|
| تسجيلات لمرة واحدة، ومحتوى عام | GPT-4o Transcribe |
| تفريغ دفعي لملفات كثيرة | GPT-4o Mini Transcribe |
| تعدد اللغات أو دعم أكثر من 100 لغة | Gemini 3 Pro |
| صوت مؤسسي سريع أو من مراكز الاتصال | Granite Speech 4.1 2B |
| صوت تقني أو متخصص في مجال معين | Granite Speech 3.3 8B |
بالنسبة إلى معظم من يبدأون، يكون GPT-4o Transcribe هو الاختيار الصحيح. فهو دقيق وسريع، ويتعامل مع أوسع تنوع من أنواع المدخلات دون الحاجة إلى إعداد.
كيف تستخدم GPT-4o Transcribe على PicassoIA؟
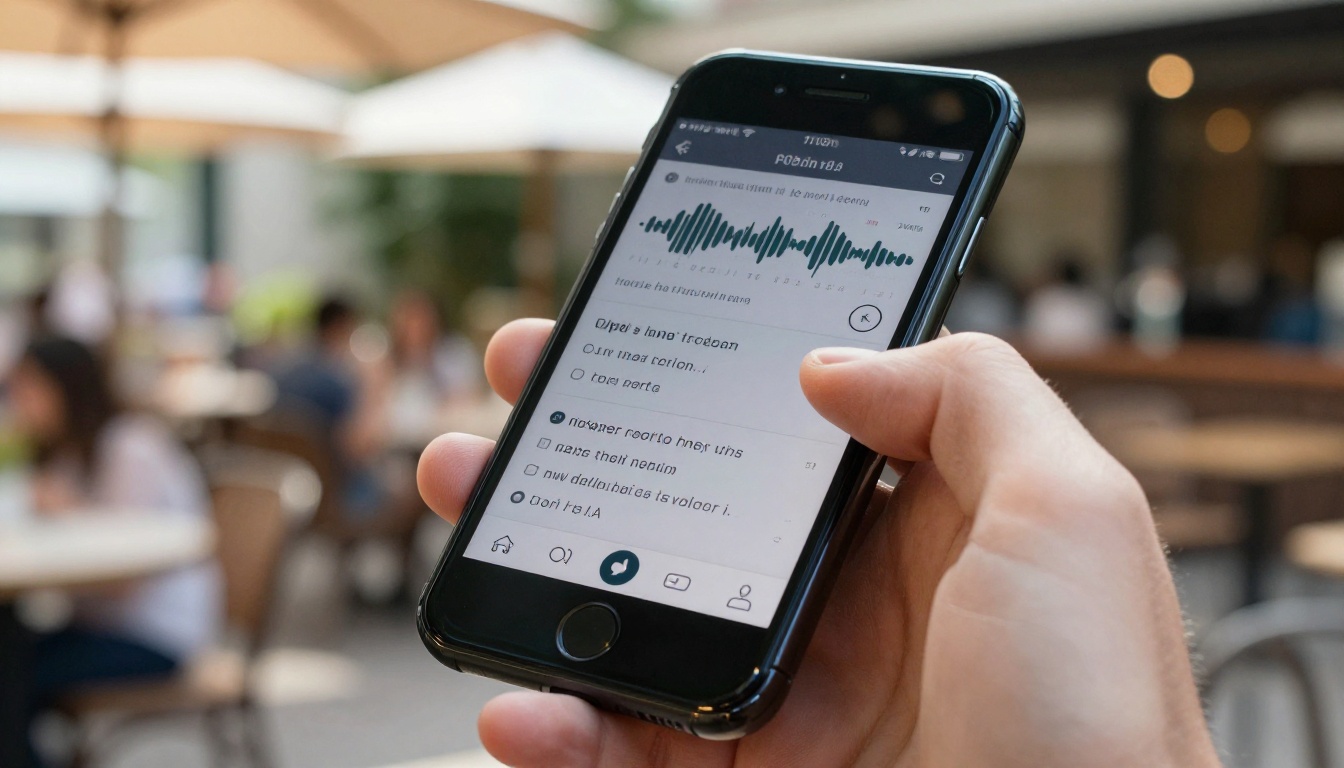
تتيح لك PicassoIA الوصول إلى النماذج الخمسة للكلام إلى نص من خلال واجهة واحدة واضحة. لا حاجة إلى إعداد واجهة برمجة التطبيقات (API)، ولا إلى كتابة أي كود، ولا إلى تثبيت محلي. إليك كيفية الحصول على أول نص مفرّغ لك في دقائق.
الخطوة 1: افتح صفحة النموذج
انتقل إلى صفحة نموذج GPT-4o Transcribe على PicassoIA. تظهر واجهة الإدخال فورًا دون الحاجة إلى التمرير.
الخطوة 2: ارفع ملف الصوت
انقر على منطقة الرفع أو اسحب ملف الصوت وأفلته مباشرة فوقها. تشمل الصيغ المدعومة MP3 وMP4 وWAV وM4A وFLAC وOGG وWebM. تعتمد حدود حجم الملف على خطتك، لكن معظم تسجيلات المقابلات والاجتماعات تُرفع دون الحاجة إلى ضغط.
الخطوة 3: اضبط المعاملات
قبل تشغيل التفريغ، اضبط هذه الخيارات:
- اللغة: حدّد لغة المصدر إذا كانت معروفة. ويعمل الخيار auto-detect جيدًا مع الصوت أحادي اللغة. أما التسجيلات متعددة اللغات فاختر auto.
- تنسيق الاستجابة: اختر بين النص العادي، أو JSON (مع الطوابع الزمنية)، أو SRT (للترجمات النصية)، أو VTT (لترجمات الفيديو على الويب).
- دقة الطوابع الزمنية: إذا كنت تحتاج إلى طوابع زمنية على مستوى الكلمة لمزامنة الترجمات أو لأغراض التحرير، ففعّل هذا الخيار قبل التشغيل.
الخطوة 4: شغّل التفريغ
انقر على زر التوليد. بالنسبة إلى بودكاست مدته 30 دقيقة، توقّع النتائج في أقل من 60 ثانية. يظهر الناتج مباشرة في الواجهة، ويمكن نسخه أو تنزيله بالتنسيق الذي تختاره.
الخطوة 5: راجع وحرّر
نصوص الذكاء الاصطناعي دقيقة لكنها ليست مثالية. فأسماء العلم، والكلام السريع جدًا، والضوضاء الخلفية الكثيفة قد تُدخل أخطاء. راجع النص بسرعة قبل استخدامه، خاصةً إذا كان سينشر حرفيًا.
💡 نصيحة: إذا احتجت إلى تسميات للمتحدثين (مثل "المتحدث 1:"، "المتحدث 2:")، فأضِف إلى نص التفريغ خطوة معالجة لاحقة باستخدام أحد النماذج اللغوية الكبيرة في PicassoIA، لإضافة تسميات تحديد المتحدثين تلقائيًا بناءً على أنماط تبادل الكلام في النص.
من يحتاج إلى هذا فعلًا؟
لم يعد تفريغ الصوت بالذكاء الاصطناعي أداة متخصصة ضيقة. إنه يحل مشكلة محددة تستهلك الوقت وتظهر عبر عشرات المهن.
صناع البودكاست ومنتجو المحتوى
تخدم نصوص البودكاست غرضين في آن واحد: فهي تحسّن إمكانية الوصول لجمهور الصم وضعاف السمع، وتنشئ نسخة نصية كاملة من كل حلقة يمكن لمحركات البحث فهرستها. ويستغرق تفريغ حلقة مدتها 45 دقيقة باستخدام GPT-4o Mini Transcribe نحو 30 ثانية، وبعدها يصبح لديك مسودة كاملة لملاحظات الحلقة جاهزة للتحرير.
فرق الأعمال والفرق القانونية
يُعد تفريغ الاجتماعات من أعلى التطبيقات قيمةً. فبدلًا من تكليف أحد أعضاء الفريق بمهمة تدوين الملاحظات، يُرسَل التسجيل مباشرة إلى GPT-4o Transcribe ويعود على شكل سجل نصي كامل. وتستخدم الفرق القانونية هذا في تسجيلات الإفادات، ومكالمات التفاوض على العقود، وتوثيق الاستشارات مع العملاء.
الباحثون والصحفيون
يتضمن البحث النوعي الكثير من المقابلات. فتفريغ 20 مقابلة مدة كل منها ساعة يدويًا يستغرق أسبوعًا كاملًا من العمل قبل أن يبدأ التحليل أصلًا. أما تفريغ الصوت بالذكاء الاصطناعي فيختصر ذلك إلى نحو ساعتين من وقت المعالجة الإجمالي، ليبقى للباحثين وقت أكبر للعمل الذي يتطلب فعلًا حكمًا بشريًا.
الطلاب والمعلمون
تتحول تسجيلات المحاضرات إلى مواد دراسية قابلة للبحث عند تفريغها. ويمكن للطلاب استخدام Gemini 3 Pro لتفريغ تسجيلات الصفوف، ثم إرسال النص الناتج إلى نموذج لغوي لتوليد ملخصات أو مواد دراسية.
الحصول على نصوص أنظف في كل مرة
يتحدد سقف الدقة لأي نموذج تفريغ إلى حد كبير بجودة الصوت المدخل. فأفضل نموذج متاح لا يستطيع استعادة الكلمات التي ابتلعتها ضوضاء الميكروفون أو الأصوات المتنافسة بموثوقية.
نصائح تسجيل تنفعك فعلًا
- استخدم ميكروفونًا اتجاهيًا: يلتقط الميكروفون المكثّف من نوع cardioid أو supercardioid ما أمامه ويرفض ضوضاء الغرفة. وحتى ميكروفون USB متوسط السعر بقيمة 80 دولارًا سيتفوق بوضوح على الميكروفون المدمج في الحاسوب المحمول.
- قلّل ضوضاء الخلفية: سجّل في غرفة مفروشة بأثاث ناعم. فالأسطح الصلبة تُنتج صدى يفسّره نموذج الكلام كأحداث صوتية منفصلة.
- متحدث واحد في كل مرة: التحدث المتداخل هو أكبر عامل يقلل الدقة. وفي المقابلات، انتظر حتى ينتهي المتحدث السابق قبل أن تردّ.
- حافظ على مسافة ثابتة: الكلام على بُعد 6 بوصات من الميكروفون ثم الابتعاد إلى 18 بوصة يخلق قفزات في مستوى الصوت تشوّه الإشارة الصوتية.
تحرير النتيجة بكفاءة
بعد أن تحصل على نص التفريغ، تكون للتحرير الفعّال أهمية:
- ابحث عن الكلمات الحشوية المتكررة ("يعني"، "آه"، "مثلًا") ونفّذ استبدالًا دفعيًا لإزالتها
- تحقّق من أسماء العلم أولًا لأنها أكثر أنواع الأخطاء شيوعًا في نصوص الذكاء الاصطناعي
- استخدم فواصل الفقرات للفصل بين المواضيع المختلفة، فذلك يجعل المستندات الطويلة مقروءة
- احتفظ بنسخة نظيفة قبل التحرير حتى تتمكن من الرجوع إلى المخرجات الأصلية عند الحاجة
التفريغ مجرد نقطة البداية
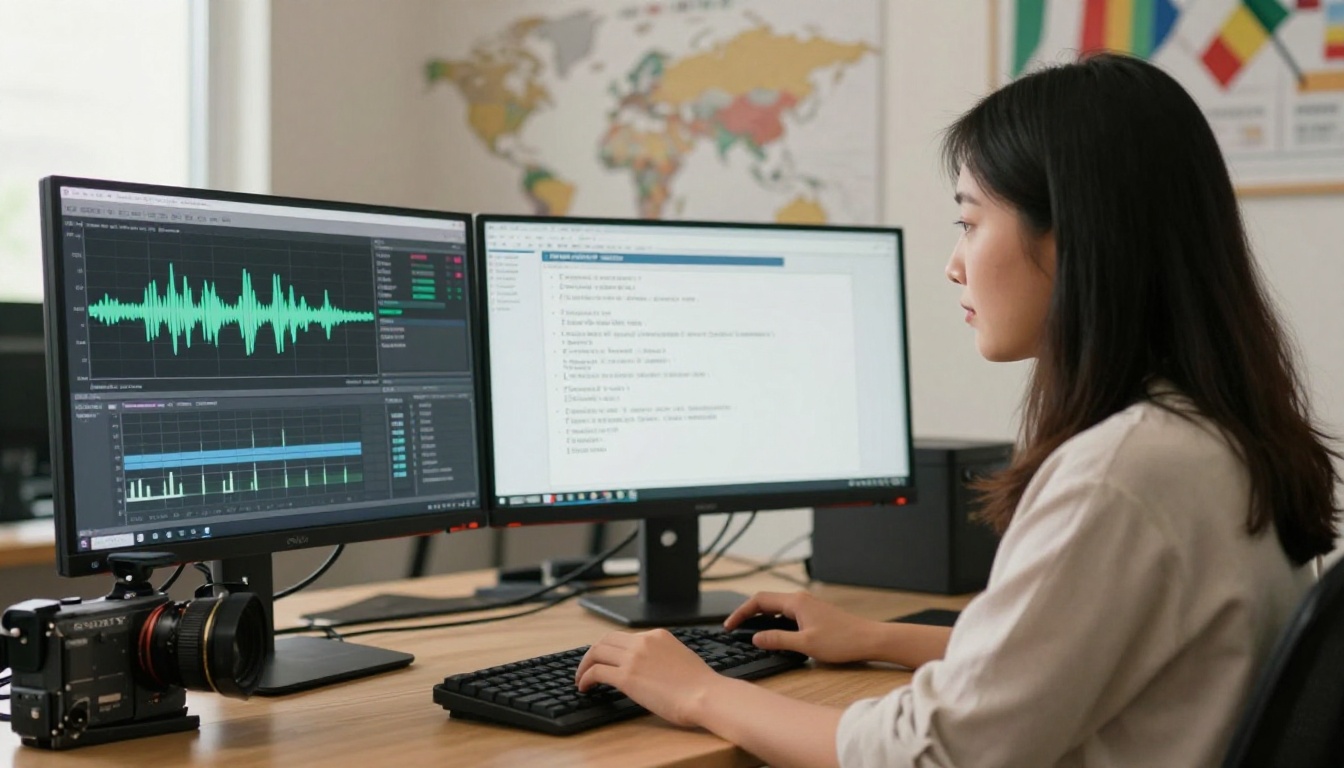
بمجرد أن تحصل على نص من صوت، يصبح لديك مادة خام يمكنك معالجتها بعشرات الطرق. الصق نص اجتماع في نموذج لغوي واطلب ملخصًا من خمس نقاط للإجراءات المطلوبة. أرسل نص مقابلة إلى نموذج لغوي كبير واطلب منه استخراج كل الاقتباسات التي تدعم حجة محددة. خذ نص بودكاست وحوّله إلى مسودة مقال مدوّن.
تقع النماذج اللغوية الكبيرة في PicassoIA إلى جانب أدوات الكلام إلى نص ضمن المنصة نفسها. يصبح سير العمل كالتالي: تفريغ الصوت باستخدام GPT-4o Transcribe أو Gemini 3 Pro، ثم معالجة النص الناتج بنموذج لغوي للتلخيص أو الترجمة أو الاستخراج. كل ذلك دون مغادرة المنصة أو التنقل بين عدة أدوات.
المكسب في الكفاءة كبير لأي شخص يعمل بانتظام مع التسجيلات الصوتية. فالمقابلة التي تستغرق ساعة تتحول إلى مستند قابل للبحث والتحرير والمشاركة في الوقت الذي يستغرقه إعداد فنجان قهوة.
خذ ملفاتك الصوتية إلى أبعد من ذلك
إذا كنت تؤجل تفريغ تراكم من التسجيلات لأن المهمة بدت أكبر من اللازم، فقد تغيّر هذا الحساب. ارفع ملفك الأول إلى GPT-4o Transcribe على PicassoIA وشاهد مدى سرعة الحصول على النتيجة. ابدأ بتسجيل قصير إذا أردت اختبار الدقة قبل أن تُقدم على ملفات أطول.
تتيح مجموعة PicassoIA للكلام إلى نص خمسة نماذج مختلفة بمستويات متفاوتة من السرعة والدقة، فيمكنك مطابقة الأداة المناسبة لكل مهمة محددة بدلًا من إجبار كل الملفات على المرور بحل واحد يناسب الجميع. سواء لجأت إلى GPT-4o Mini Transcribe من أجل مهمة دفعية سريعة، أو Granite Speech 3.3 8B للصوت في المجالات التقنية، أو Gemini 3 Pro للتسجيلات متعددة اللغات، فالنموذج المناسب بانتظارك بالفعل.
تحتوي تسجيلاتك بالفعل على المعلومات التي تحتاجها. ما كان ينقصها فقط هو وسيلة أسرع لاستخراجها على شكل نص.


