एक घंटे की मीटिंग रिकॉर्ड करने के बाद उसे टाइप करने में दो घंटे और लगते थे। AI ट्रांसक्रिप्शन ने यह पूरी तरह बदल दिया है। बड़े स्पीच मॉडल पर चलने वाले टूल उसी एक घंटे के ऑडियो को दो मिनट से कम समय में साफ़-सुथरे, स्पीकर-लेबल वाले टेक्स्ट दस्तावेज़ में बदल सकते हैं, और उनकी सटीकता पेशेवर मानव ट्रांसक्रिप्शनिस्ट के मुकाबले की होती है।
अगर आपके हार्ड ड्राइव पर ऑडियो फ़ाइलें पड़ी हैं, या आप नियमित रूप से मीटिंग, पॉडकास्ट, लेक्चर या इंटरव्यू रिकॉर्ड करते हैं, तो यह लेख आपको दिखाएगा कि उन पर AI से काम कैसे लें।
मैनुअल ट्रांसक्रिप्शन आपका दिन कैसे बर्बाद करता है
हाथ से ट्रांसक्रिप्शन करने पर हर घंटे के ऑडियो के लिए लगभग चार से छह घंटे लगते हैं। जो कोई नियमित रूप से ऑडियो कंटेंट बनाता है या ऐसे क्षेत्र में काम करता है जहाँ रिकॉर्ड की गई बातचीत का दस्तावेज़ीकरण ज़रूरी है, उसके लिए यह टिकाऊ वर्कफ़्लो नहीं है।
असली समय की लागत
सोचिए कि एक पत्रकार एक दिन में तीन सूत्रों का इंटरव्यू लेता है। हर रिकॉर्डिंग 45 मिनट की है। मैनुअल ट्रांसक्रिप्शन में लगभग 10 से 15 घंटे की टाइपिंग लगती है, उसके बाद ही वह असल लेख लिखना शुरू कर पाता है। AI ऑडियो ट्रांसक्रिप्शन इसे कुल मिलाकर लगभग 10 मिनट में समेट देता है, और ट्रांसक्रिप्ट तुरंत कॉपी और एडिट करने के लिए तैयार होता है।
यही हिसाब इन पर भी लागू होता है:
- पॉडकास्ट एडिटर जो 60 मिनट के एपिसोड की रिकॉर्डिंग साफ़ करते हैं
- लीगल टीमें जिन्हें डिपोज़िशन का वर्बैटिम रिकॉर्ड चाहिए
- शोधकर्ता जो गुणात्मक इंटरव्यू डेटा संकलित करते हैं
- HR विभाग जो इंटरव्यू सेशन का दस्तावेज़ीकरण करते हैं
जब सटीकता प्रभावित होती है
मैनुअल ट्रांसक्रिप्शन में ऐसी गलतियाँ भी होती हैं जो समय के साथ बढ़ती जाती हैं। थकान होती है, शब्द गलत सुने जाते हैं और फ़ॉर्मेटिंग में एकरूपता नहीं रहती। AI स्पीच रिकग्निशन थकता नहीं। वह रिकॉर्डिंग के आखिरी 30 सेकंड पर भी उतना ही ध्यान देता है जितना रिकॉर्डिंग की शुरुआत पर देता है।
पुराने ऑटोमैटिक स्पीच रिकग्निशन सिस्टम की कमज़ोरी उच्चारण में लहजे (accent) और एक साथ बोले जाने वाले वार्तालाप में थी। GPT-4o Transcribe और Gemini 3 Pro जैसे आधुनिक मॉडल सैकड़ों भाषाओं और बोलियों को कवर करने वाले ट्रेनिंग डेटासेट के साथ वह अंतर काफ़ी हद तक पाट चुके हैं।
AI स्पीच को टेक्स्ट में कैसे बदलता है
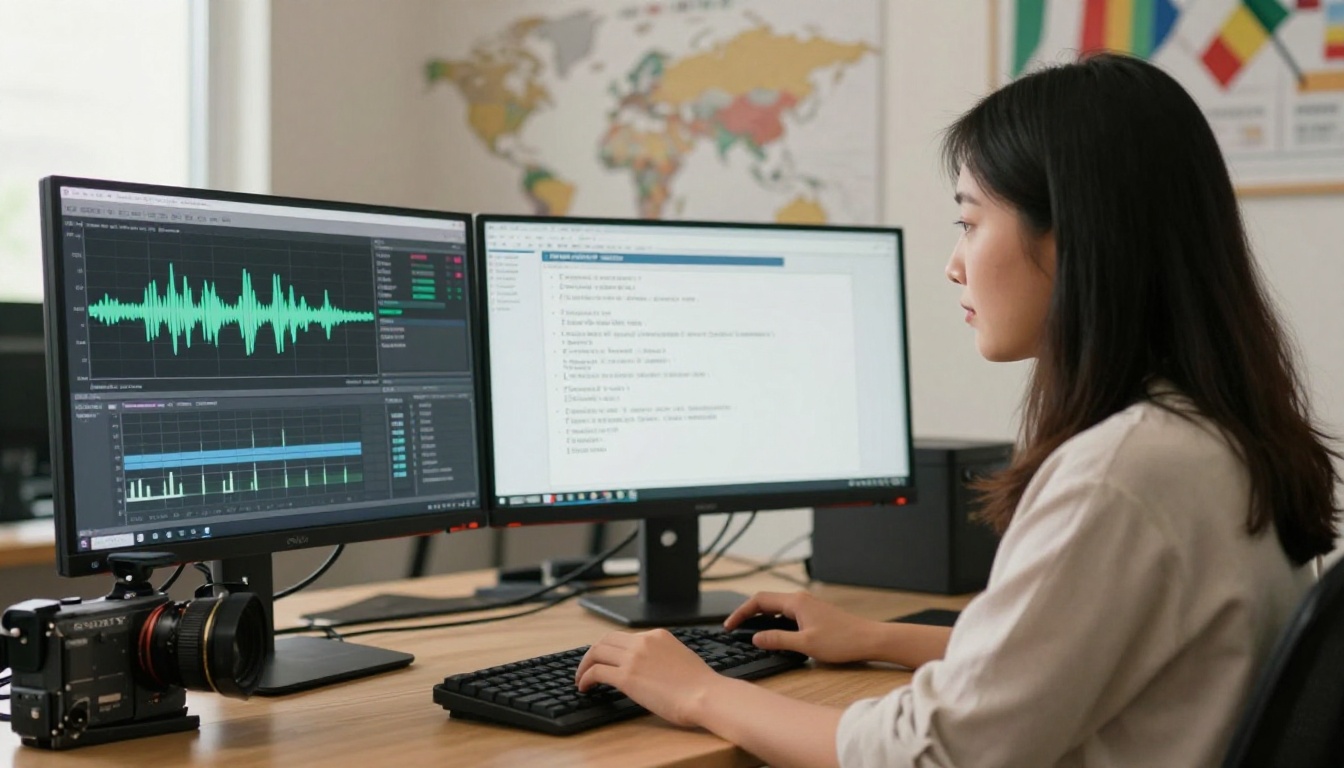
ऑटोमैटिक स्पीच रिकग्निशन ऑडियो को छोटे हिस्सों में तोड़ता है, जिन्हें फ़्रेम कहा जाता है, जिनमें से हर एक आम तौर पर 10 से 25 मिलीसेकंड का होता है। फिर वह एकॉस्टिक विश्लेषण चलाकर फ़ोनीम पहचानता है, जो भाषा की बुनियादी ध्वनि इकाइयाँ हैं। ये फ़ोनीम फिर एक लैंग्वेज मॉडल से मिलाए जाते हैं, जो आसपास के संदर्भ को देखते हुए बताता है कि कौन-से शब्द और वाक्य सबसे ज़्यादा संभावित हैं।
आज के स्पीच मॉडल अलग कैसे हैं
पुराने ऑटोमैटिक स्पीच रिकग्निशन सिस्टम कठोर, नियम-आधारित फ़ोनीम डिक्शनरी पर निर्भर थे और अपेक्षाकृत छोटे, साफ़ ऑडियो डेटासेट पर ट्रेन किए गए थे। बैकग्राउंड शोर, तेज़ बोलने या क्षेत्रीय लहजों के सामने वे जल्दी बिखर जाते थे।
आज के मॉडल विशाल बहुभाषी कॉर्पोरा पर ट्रेन किए गए हैं, जिनमें अक्सर विविध वातावरण की लाखों घंटों की असली दुनिया की ऑडियो शामिल होती है। वे ट्रांसफ़ॉर्मर आर्किटेक्चर इस्तेमाल करते हैं, जो फ़्रेम-दर-फ़्रेम मिलान के बजाय किसी उच्चारण के पूरे संदर्भ को देखते हैं। इससे आउटपुट कहीं ज़्यादा सुसंगत बनता है।
सटीकता कैसे बदली है
वर्ड एरर रेट (WER) ट्रांसक्रिप्शन की गुणवत्ता का मानक पैमाना है। 5% WER का मतलब है कि हर 100 शब्दों में से 5 शब्द गलत हैं। साफ़ रिकॉर्डिंग पर पेशेवर मानव ट्रांसक्रिप्शनिस्ट आम तौर पर लगभग 4 से 5% WER तक पहुँचते हैं।
GPT-4o Transcribe जैसे मौजूदा शीर्ष AI मॉडल साफ़ ऑडियो पर उस बेंचमार्क के बराबर या उससे बेहतर हैं, और शोर वाली, लहजे वाली या तेज़ रफ़्तार रिकॉर्डिंग पर भी प्रतिस्पर्धी बने रहते हैं, जहाँ मानव ट्रांसक्रिप्शनिस्ट अक्सर संघर्ष करते हैं।
💡 टिप: ऑडियो की गुणवत्ता सीधे ट्रांसक्रिप्ट की गुणवत्ता पर असर डालती है। अच्छे माइक्रोफ़ोन और कम बैकग्राउंड शोर वाली रिकॉर्डिंग हमेशा उस ट्रांसक्रिप्ट से ज़्यादा सटीक होगी जो भीड़भाड़ वाले कमरे में फ़ोन से रिकॉर्ड की गई हो।
ऑडियो ट्रांसक्रिप्ट करने के लिए 5 सबसे अच्छे AI मॉडल
PicassoIA आपको पाँच प्रोडक्शन-रेडी स्पीच-टू-टेक्स्ट मॉडल का सीधा एक्सेस देता है, और हर एक की अपनी अलग ताकत है। एक नज़र में देखें कि वे आपस में कैसे तुलना करते हैं।
| मॉडल | सबसे अच्छा किसके लिए | भाषाएँ | स्पीड |
|---|
| GPT-4o Transcribe | सामान्य उपयोग, उच्च सटीकता | 57+ | तेज़ |
| GPT-4o Mini Transcribe | ज़्यादा वॉल्यूम, लागत-दक्षता | 57+ | बहुत तेज़ |
| Gemini 3 Pro | लंबी रिकॉर्डिंग, संदर्भ-समृद्ध ऑडियो | 100+ | तेज़ |
| Granite Speech 4.1 2B | संरचित एंटरप्राइज़ उपयोग | 6 | बहुत तेज़ |
| Granite Speech 3.3 8B | उच्च-विवरण वाला एंटरप्राइज़ ट्रांसक्रिप्शन | 6 | तेज़ |
GPT-4o Transcribe
GPT-4o Transcribe OpenAI का फ़्लैगशिप स्पीच-टू-टेक्स्ट मॉडल है। यह लहजे वाली बोली, एक साथ बोलने (crosstalk) और शोर वाले ऑडियो को ज़्यादातर प्रतिस्पर्धी सिस्टम से बेहतर संभालता है। पॉडकास्टर, पत्रकारों और कंटेंट क्रिएटरों के लिए, जिन्हें अलग-अलग रिकॉर्डिंग परिस्थितियों में भरोसेमंद आउटपुट चाहिए, यह डिफ़ॉल्ट चुनाव है।
यह ऑटोमैटिक पंक्चुएशन और पैराग्राफ़ ब्रेक को सपोर्ट करता है, और अक्सर संदर्भ से ही सही संज्ञा (proper nouns) और तकनीकी शब्दावली पहचान लेता है, इसके लिए आपके खास शब्दों पर पहले से ट्रेनिंग की ज़रूरत नहीं पड़ती।
GPT-4o Mini Transcribe
GPT-4o Mini Transcribe एक हल्का और तेज़ वर्ज़न है, जो ज़्यादा थ्रूपुट के लिए बनाया गया है। अगर आप रिकॉर्डिंग्स का बड़ा बैकलॉग प्रोसेस कर रहे हैं या ऐसा वर्कफ़्लो चला रहे हैं जो ऑडियो को लगभग रियल-टाइम में ट्रांसक्रिप्ट करता है, तो यह मॉडल प्रोसेसिंग की बहुत कम लागत पर बेहतरीन सटीकता देता है। साफ़ रिकॉर्डिंग पर पूरे मॉडल की तुलना में गुणवत्ता का फ़र्क बहुत कम है।
Gemini 3 Pro
Google का Gemini 3 Pro मॉडल लंबी, संदर्भ-समृद्ध ऑडियो को संभालने में उत्कृष्ट है। इसका मल्टीमॉडल आर्किटेक्चर इसे बातचीत के प्रवाह, विषय के बदलावों और सूक्ष्म शब्द-प्रयोग को पढ़ने में खास तौर पर मज़बूत बनाता है। यह 100 से ज़्यादा भाषाओं को सपोर्ट करता है, जिससे यह बहुभाषी ट्रांसक्रिप्शन वर्कफ़्लो के लिए सबसे अच्छा विकल्प बन जाता है।
💡 टिप: कॉन्फ़्रेंस रिकॉर्डिंग, कई स्पीकर्स वाली पैनल चर्चा, या ऐसे किसी भी ऑडियो के लिए Gemini 3 Pro इस्तेमाल करें जहाँ सिर्फ़ शब्दों की सटीकता नहीं, बल्कि अर्थ की संदर्भगत व्याख्या भी मायने रखती है।
Granite Speech 4.1 2B
IBM का Granite Speech 4.1 2B एक कॉम्पैक्ट मॉडल है, जो उन एंटरप्राइज़ डिप्लॉयमेंट के लिए बना है जहाँ लेटेंसी बेहद अहम है। यह छह भाषाओं को सपोर्ट करता है और संरचित बिज़नेस स्पीच के लिए ट्यून किया गया है, इसलिए कॉर्पोरेट मीटिंग, कॉल सेंटर रिकॉर्डिंग और HR दस्तावेज़ीकरण के लिए यह मज़बूत विकल्प है।
Granite Speech 3.3 8B
Granite Speech 3.3 8B IBM का बड़ा एंटरप्राइज़ मॉडल है। यह जटिल वाक्य संरचनाओं और डोमेन-विशेष शब्दावली को बेहतर ढंग से संभालने के लिए कुछ गति की कीमत चुकाता है। अगर आपका ऑडियो मेडिसिन, लॉ या फ़ाइनेंस जैसे तकनीकी क्षेत्रों से जुड़ा है, तो यह मॉडल छोटे 2B वर्ज़न की तुलना में विशेष शब्दावली को ज़्यादा भरोसेमंद ढंग से संभालता है।
आपको कौन-सा मॉडल चुनना चाहिए
सही चुनाव तीन बातों पर निर्भर करता है: आप किस तरह का ऑडियो संभाल रहे हैं, उसमें कौन-सी भाषाएँ शामिल हैं, और आप पोस्ट-एडिटिंग में कितना समय लगाने को तैयार हैं।
| स्थिति | अनुशंसित मॉडल |
|---|
| एक-बार की रिकॉर्डिंग, सामान्य कंटेंट | GPT-4o Transcribe |
| कई फ़ाइलों का बैच ट्रांसक्रिप्शन | GPT-4o Mini Transcribe |
| बहु-भाषा या 100+ भाषा सपोर्ट | Gemini 3 Pro |
| तेज़ एंटरप्राइज़ या कॉल सेंटर ऑडियो | Granite Speech 4.1 2B |
| तकनीकी या विशेष डोमेन ऑडियो | Granite Speech 3.3 8B |
ज़्यादातर लोगों के लिए, जो अभी शुरुआत कर रहे हैं, GPT-4o Transcribe सही चुनाव है। यह सटीक है, तेज़ है, और बिना किसी कॉन्फ़िगरेशन के सबसे ज़्यादा तरह के इनपुट संभाल लेता है।
PicassoIA पर GPT-4o Transcribe कैसे इस्तेमाल करें
PicassoIA पाँचों स्पीच-टू-टेक्स्ट मॉडल एक ही साफ़ इंटरफ़ेस के ज़रिए उपलब्ध कराता है। न कोई API सेटअप, न कोड, न लोकल इंस्टॉलेशन। मिनटों में अपना पहला ट्रांसक्रिप्ट पाने का तरीका यह है।
स्टेप 1: मॉडल पेज खोलें
PicassoIA पर GPT-4o Transcribe मॉडल पेज पर जाएँ। इनपुट इंटरफ़ेस स्क्रॉल किए बिना ही तुरंत दिख जाता है।
स्टेप 2: अपनी ऑडियो फ़ाइल अपलोड करें
अपलोड एरिया पर क्लिक करें या अपनी ऑडियो फ़ाइल सीधे उस पर ड्रैग करें। समर्थित फ़ॉर्मेट में MP3, MP4, WAV, M4A, FLAC, OGG और WebM शामिल हैं। फ़ाइल आकार की सीमा आपके प्लान पर निर्भर करती है, लेकिन ज़्यादातर इंटरव्यू या मीटिंग रिकॉर्डिंग बिना कंप्रेशन के फ़िट हो जाती हैं।
स्टेप 3: अपने पैरामीटर सेट करें
ट्रांसक्रिप्शन चलाने से पहले ये विकल्प कॉन्फ़िगर करें:
- भाषा: अगर पता हो तो सोर्स भाषा सेट करें। सिंगल-लैंग्वेज ऑडियो के लिए auto-detect पर छोड़ना अच्छा काम करता है। बहुभाषी रिकॉर्डिंग के लिए auto चुनें।
- रिस्पॉन्स फ़ॉर्मेट: सादा टेक्स्ट, JSON (टाइमस्टैम्प के साथ), SRT (सबटाइटल के लिए) या VTT (वेब वीडियो कैप्शन के लिए) में से चुनें।
- टाइमस्टैम्प ग्रैन्युलैरिटी: अगर सबटाइटल सिंक या एडिटिंग के लिए वर्ड-लेवल टाइमस्टैम्प चाहिए, तो चलाने से पहले यह विकल्प चालू करें।
स्टेप 4: ट्रांसक्रिप्शन चलाएँ
जेनरेट बटन पर क्लिक करें। 30 मिनट के पॉडकास्ट के लिए नतीजे 60 सेकंड से कम में मिलने की उम्मीद करें। आउटपुट सीधे इंटरफ़ेस में दिखता है और आपके चुने हुए फ़ॉर्मेट में कॉपी या डाउनलोड किया जा सकता है।
स्टेप 5: समीक्षा करें और एडिट करें
AI ट्रांसक्रिप्ट सटीक होते हैं, पर परफ़ेक्ट नहीं। सही संज्ञाएँ, बहुत तेज़ बोलना और भारी बैकग्राउंड शोर अब भी गलतियाँ ला सकते हैं। इस्तेमाल करने से पहले आउटपुट पर एक हल्का पास लगाएँ, खासकर उस चीज़ के लिए जो शब्दशः प्रकाशित होने वाली है।
💡 टिप: अगर आपको स्पीकर लेबल चाहिए (जैसे "Speaker 1:", "Speaker 2:"), तो अपने ट्रांसक्रिप्ट के साथ PicassoIA के किसी लार्ज लैंग्वेज मॉडल का पोस्ट-प्रोसेसिंग स्टेप जोड़ें, जो टेक्स्ट में बोलने के बारी-बारी वाले पैटर्न के आधार पर स्पीकर डायराइज़ेशन लेबल अपने-आप जोड़ देगा।
इसकी असल में ज़रूरत किसे है
AI ट्रांसक्रिप्शन अब कोई सीमित उपयोग वाला टूल नहीं है। यह एक खास, समय खाने वाली समस्या हल करता है, जो दर्जनों पेशों में दिखती है।
पॉडकास्टर और कंटेंट क्रिएटर
पॉडकास्ट ट्रांसक्रिप्ट दोहरी भूमिका निभाते हैं: वे बधिर और कम सुनने वाले दर्शकों के लिए पहुँच बेहतर बनाते हैं, और हर एपिसोड का पूरा टेक्स्ट वर्शन बनाते हैं, जिसे सर्च इंजन इंडेक्स कर सकते हैं। GPT-4o Mini Transcribe से 45 मिनट के एपिसोड का ट्रांसक्रिप्शन लगभग 30 सेकंड लेता है, जिसके बाद आपके पास एडिट करने के लिए शो-नोट्स का पूरा ड्राफ़्ट तैयार होता है।
बिज़नेस और लीगल टीमें
मीटिंग ट्रांसक्रिप्शन सबसे ज़्यादा मूल्य देने वाले उपयोगों में से एक है। किसी एक टीम मेंबर को नोट-टेकर की ड्यूटी देने के बजाय रिकॉर्डिंग सीधे GPT-4o Transcribe पर जाती है और पूरे टेक्स्ट रिकॉर्ड के रूप में वापस आती है। लीगल टीमें इसे डिपोज़िशन रिकॉर्डिंग, कॉन्ट्रैक्ट नेगोशिएशन कॉल और क्लाइंट परामर्श के दस्तावेज़ीकरण के लिए इस्तेमाल करती हैं।
शोधकर्ता और पत्रकार
गुणात्मक शोध में बहुत सारे इंटरव्यू शामिल होते हैं। 20 घंटे-लंबे इंटरव्यू को हाथ से ट्रांसक्रिप्ट करना विश्लेषण शुरू होने से पहले ही पूरे हफ़्ते का काम है। AI ट्रांसक्रिप्शन इसे कुल प्रोसेसिंग समय में लगभग दो घंटे तक समेट देता है, जिससे शोधकर्ताओं के पास उस काम के लिए ज़्यादा समय बचता है जिसके लिए सच में मानवीय निर्णय चाहिए।
छात्र और शिक्षक
ट्रांसक्रिप्ट होने पर लेक्चर रिकॉर्डिंग खोजे जा सकने वाली स्टडी सामग्री बन जाती हैं। छात्र क्लास रिकॉर्डिंग ट्रांसक्रिप्ट करने के लिए Gemini 3 Pro इस्तेमाल कर सकते हैं और फिर उस टेक्स्ट को किसी लैंग्वेज मॉडल को भेजकर सारांश या स्टडी मटीरियल बनवा सकते हैं।
हर बार साफ़ ट्रांसक्रिप्ट कैसे पाएँ
किसी भी ट्रांसक्रिप्शन मॉडल की सटीकता की सीमा काफ़ी हद तक इनपुट ऑडियो की गुणवत्ता से तय होती है। दुनिया का सबसे अच्छा मॉडल भी माइक्रोफ़ोन के शोर या आपस में टकराती आवाज़ों में खो गए शब्दों को भरोसेमंद ढंग से वापस नहीं ला सकता।
रिकॉर्डिंग के वे टिप्स जो सच में मदद करते हैं
- दिशात्मक माइक्रोफ़ोन इस्तेमाल करें: कार्डियॉइड या सुपरकार्डियॉइड कंडेंसर माइक सामने की आवाज़ उठाता है और कमरे का शोर नकारता है। $80 का एक मध्य-श्रेणी USB माइक भी लैपटॉप के बिल्ट-इन माइक से काफ़ी बेहतर प्रदर्शन करेगा।
- बैकग्राउंड शोर कम करें: नरम सामान वाले कमरे में रिकॉर्ड करें। सख़्त सतहें रीवर्ब पैदा करती हैं, जिन्हें स्पीच मॉडल अलग ऑडियो इवेंट समझ लेते हैं।
- एक समय में एक स्पीकर: एक साथ बोलना सटीकता का सबसे बड़ा दुश्मन है। इंटरव्यू में पिछले स्पीकर के खत्म होने का इंतज़ार करें, फिर जवाब दें।
- माइक से दूरी एक जैसी रखें: माइक से 6 इंच दूर बोलना और फिर 18 इंच पीछे हट जाना वॉल्यूम में ऐसे उतार-चढ़ाव पैदा करता है जो ऑडियो सिग्नल को बिगाड़ देते हैं।
आउटपुट को कुशलता से एडिट करना
ट्रांसक्रिप्ट मिलने के बाद कुशल एडिटिंग मायने रखती है:
- बार-बार आने वाले फ़िलर शब्द खोजें ("उम", "अह", "जैसे") और उन्हें हटाने के लिए बैच रिप्लेस करें
- पहले सही संज्ञाएँ जाँचें, क्योंकि AI ट्रांसक्रिप्ट में यही सबसे आम गलती होती है
- अलग-अलग विषयों को अलग करने के लिए पैराग्राफ़ ब्रेक इस्तेमाल करें, जिससे लंबे दस्तावेज़ पढ़ने लायक बनते हैं
- एडिट करने से पहले एक साफ़ कॉपी रखें, ताकि ज़रूरत पड़ने पर मूल आउटपुट देख सकें
ट्रांसक्रिप्शन तो बस शुरुआत है
ऑडियो से टेक्स्ट मिलने के बाद आपके पास कच्चा माल है, जिसे दर्जनों तरीकों से प्रोसेस किया जा सकता है। मीटिंग ट्रांसक्रिप्ट को किसी लैंग्वेज मॉडल में डालें और पाँच बिंदुओं वाला एक्शन आइटम सारांश माँगें। इंटरव्यू ट्रांसक्रिप्ट को LLM को देकर वे सभी उद्धरण निकलवाएँ जो किसी खास तर्क का समर्थन करते हैं। पॉडकास्ट ट्रांसक्रिप्ट से ब्लॉग पोस्ट का ड्राफ़्ट बनाएँ।
PicassoIA के लार्ज लैंग्वेज मॉडल उसी प्लेटफ़ॉर्म पर स्पीच-टू-टेक्स्ट टूल्स के ठीक बगल में मौजूद हैं। वर्कफ़्लो कुछ ऐसा होता है: GPT-4o Transcribe या Gemini 3 Pro से ट्रांसक्रिप्शन करें, फिर टेक्स्ट आउटपुट को समरी, अनुवाद या जानकारी निकालने के लिए LLM से प्रोसेस करें। यह सब बिना प्लेटफ़ॉर्म छोड़े और कई टूल्स के बीच स्विच किए।
जो लोग नियमित रूप से रिकॉर्ड की गई ऑडियो के साथ काम करते हैं, उनके लिए कुशलता का फ़ायदा काफ़ी बड़ा है। एक घंटे का इंटरव्यू उतने ही समय में खोजने, एडिट करने और शेयर करने लायक दस्तावेज़ बन जाता है, जितने में एक कप कॉफ़ी बनती है।
अपनी ऑडियो फ़ाइलों को और आगे ले जाएँ
अगर आप रिकॉर्डिंग्स के बैकलॉग को इसलिए ट्रांसक्रिप्ट करना टालते रहे हैं क्योंकि काम बहुत बड़ा लगता था, तो वह हिसाब अब बदल चुका है। अपनी पहली फ़ाइल PicassoIA पर GPT-4o Transcribe में डालें और देखें कि नतीजा कितनी जल्दी मिलता है। अगर आप बड़ी फ़ाइलों पर काम शुरू करने से पहले सटीकता जाँचना चाहते हैं, तो एक छोटी रिकॉर्डिंग से शुरू करें।
PicassoIA का स्पीच-टू-टेक्स्ट कलेक्शन आपको पाँच अलग-अलग मॉडल देता है, जो अलग-अलग गति और सटीकता के स्तर पर हैं, ताकि हर खास काम के लिए सही टूल चुन सकें, बजाय इसके कि हर फ़ाइल को एक ही तरह के समाधान से गुज़ारा जाए। चाहे आप एक त्वरित बैच काम के लिए GPT-4o Mini Transcribe चुनें, तकनीकी डोमेन ऑडियो के लिए Granite Speech 3.3 8B, या बहुभाषी रिकॉर्डिंग के लिए Gemini 3 Pro, सही मॉडल पहले से तैयार है।
आपकी रिकॉर्डिंग में वह जानकारी पहले से मौजूद है जिसकी आपको ज़रूरत है। बस कमी इतनी थी कि उसे टेक्स्ट में निकालने का कोई पर्याप्त तेज़ तरीका नहीं था।


