Enregistrer une réunion d’une heure obligeait autrefois à passer deux heures de plus à la retranscrire. La transcription par IA a complètement changé la donne. Les outils fondés sur de grands modèles de parole peuvent convertir cette même heure d’audio en un document texte propre, avec les intervenants identifiés, en moins de deux minutes, avec des taux de précision qui rivalisent avec ceux d’un transcripteur professionnel.
Si vous avez des fichiers audio sur votre disque dur, ou si vous enregistrez régulièrement des réunions, des podcasts, des cours ou des entretiens, cet article vous montrera précisément comment mettre l’IA au service de ces fichiers.
Pourquoi la transcription manuelle vous fait perdre votre journée
Chaque heure d’audio demande environ quatre à six heures de transcription manuelle lorsqu’elle est faite à la main. Ce n’est pas un flux de travail durable pour quiconque produit régulièrement du contenu audio ou travaille dans des domaines où les conversations enregistrées doivent être documentées.
Le coût réel en temps
Prenons l’exemple d’une journaliste qui interroge trois sources dans la même journée. Chaque enregistrement dure 45 minutes. La transcription manuelle représente environ 10 à 15 heures de saisie avant qu’elle puisse seulement commencer à rédiger l’article. La transcription audio par IA réduit cela à environ 10 minutes au total, avec une transcription prête à être copiée et modifiée immédiatement.
Le calcul est similaire pour :
- Les monteurs de podcasts qui nettoient des enregistrements d’épisodes de 60 minutes
- Les équipes juridiques qui ont besoin de comptes rendus mot pour mot de dépositions
- Les chercheurs qui compilent des données d’entretiens qualitatifs
- Les services RH qui documentent les sessions d’entretiens
Quand la précision en souffre
La transcription manuelle est aussi sujette à des erreurs qui s’accumulent avec le temps. La fatigue s’installe, des mots sont mal entendus et la mise en forme devient incohérente. La reconnaissance vocale par IA ne se fatigue pas. Elle accorde la même attention aux 30 dernières secondes d’un enregistrement qu’à ses premières secondes.
Le point faible des anciens systèmes de reconnaissance automatique de la parole était la parole accentuée et les conversations qui se chevauchent. Des modèles récents comme GPT-4o Transcribe et Gemini 3 Pro ont comblé l’essentiel de cet écart grâce à des jeux de données d’entraînement couvrant des centaines de langues et de dialectes.
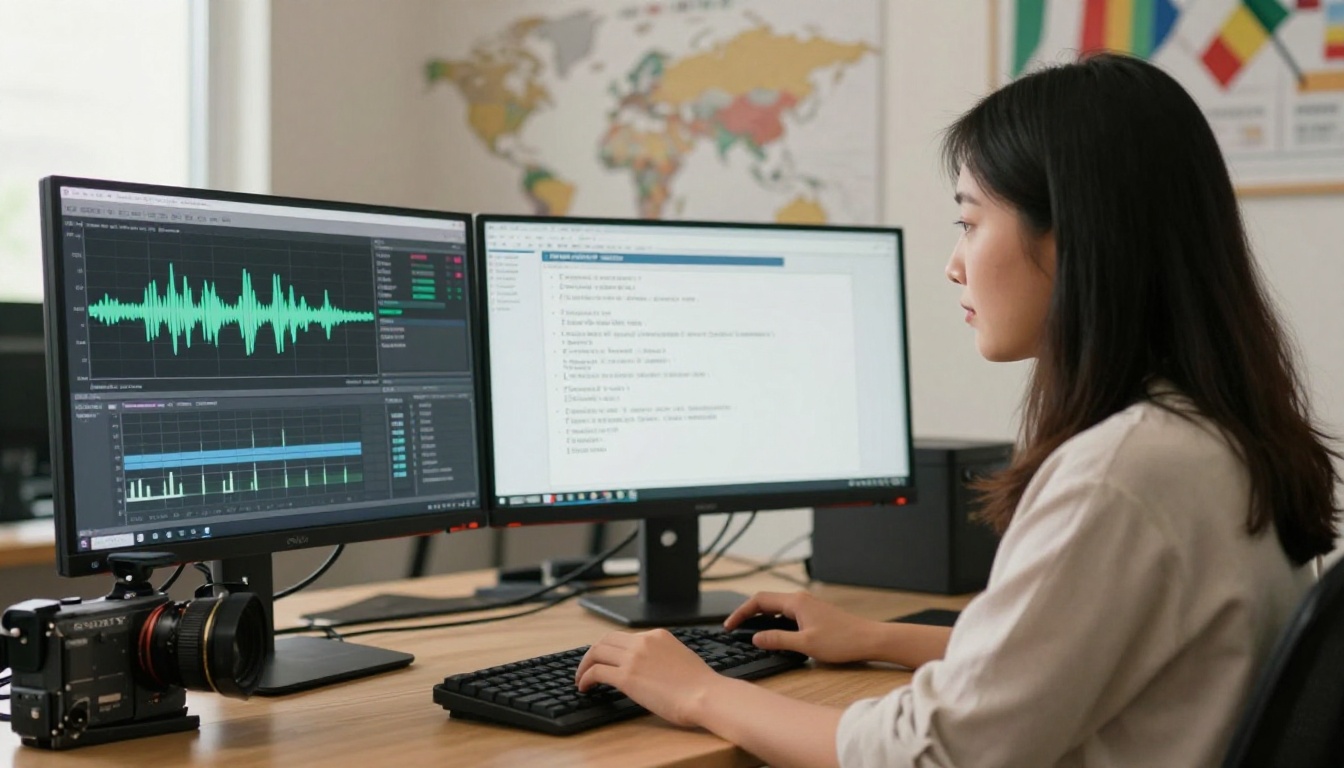
La reconnaissance automatique de la parole découpe l’audio en petits segments appelés trames, d’environ 10 à 25 millisecondes chacun, puis effectue une analyse acoustique pour identifier les phonèmes, les unités sonores de base du langage. Ces phonèmes sont ensuite comparés à un modèle de langage qui prédit les mots et les phrases les plus probables selon le contexte environnant.
Ce que les modèles de parole actuels font différemment
Les anciens systèmes de reconnaissance automatique de la parole reposaient sur des dictionnaires de phonèmes rigides, fondés sur des règles, et étaient entraînés sur des jeux de données audio relativement restreints et propres. Ils s’effondraient rapidement face au bruit de fond, à la parole rapide ou aux accents régionaux.
Les modèles disponibles aujourd’hui sont entraînés sur des corpus multilingues massifs, qui incluent souvent des centaines de milliers d’heures d’audio réel issu d’environnements variés. Ils utilisent des architectures transformer qui examinent le contexte complet d’un énoncé plutôt qu’une comparaison trame par trame, ce qui produit un résultat nettement plus cohérent.
Comment la précision a évolué
Le taux d’erreur sur les mots (WER, pour word error rate) est la mesure standard de la qualité d’une transcription. Un WER de 5 % signifie que 5 mots sur 100 sont faux. Les transcripteurs professionnels humains atteignent généralement un WER d’environ 4 à 5 % sur des enregistrements clairs.
Les modèles d’IA actuels les plus performants, comme GPT-4o Transcribe, égalent ou dépassent ce benchmark sur un audio propre, et restent compétitifs sur les enregistrements bruyants, accentués ou rapides, où les transcripteurs humains peinent souvent.
💡 Astuce : La qualité de l’audio influence directement la qualité de la transcription. Un enregistrement réalisé avec un bon microphone et un bruit de fond minimal donnera toujours une transcription plus précise qu’un enregistrement fait avec un téléphone dans une pièce bondée.
Les 5 meilleurs modèles d’IA pour transcrire un audio
PicassoIA vous donne un accès direct à cinq modèles de reconnaissance vocale prêts pour la production, chacun avec des atouts distincts. Voici un aperçu de leurs différences.
| Modèle | Idéal pour | Langues | Vitesse |
|---|
| GPT-4o Transcribe | Usage général, haute précision | 57+ | Rapide |
| GPT-4o Mini Transcribe | Gros volumes, rentabilité | 57+ | Très rapide |
| Gemini 3 Pro | Longs enregistrements, audio riche en contexte | 100+ | Rapide |
| Granite Speech 4.1 2B | Usage structuré en entreprise | 6 | Très rapide |
| Granite Speech 3.3 8B | Transcription d’entreprise très détaillée | 6 | Rapide |
GPT-4o Transcribe
GPT-4o Transcribe est le modèle phare de reconnaissance vocale d’OpenAI. Il gère mieux que la plupart des systèmes concurrents la parole accentuée, les conversations qui se chevauchent et les audios bruyants. Pour les podcasteurs, les journalistes et les créateurs de contenu qui ont besoin de résultats fiables dans des conditions d’enregistrement variées, c’est le choix par défaut.
Il prend en charge la ponctuation automatique et les sauts de paragraphe, et peut souvent identifier correctement les noms propres et la terminologie technique à partir du seul contexte, sans entraînement préalable sur votre vocabulaire spécifique.
GPT-4o Mini Transcribe
GPT-4o Mini Transcribe est une version plus légère et plus rapide, conçue pour le débit. Si vous traitez un important arriéré d’enregistrements ou si vous faites tourner un flux de travail qui transcrit l’audio presque en temps réel, ce modèle offre une excellente précision pour une fraction du coût de traitement. La différence de qualité avec le modèle complet est minime sur des enregistrements propres.
Gemini 3 Pro
Le modèle Gemini 3 Pro de Google excelle dans le traitement de longs audios riches en contexte. Son architecture multimodale le rend particulièrement performant pour saisir l’enchaînement des échanges, les changements de sujet et les formulations nuancées. Il prend en charge plus de 100 langues, ce qui en fait la meilleure option pour les flux de transcription multilingues.
💡 Astuce : Utilisez Gemini 3 Pro pour les enregistrements de conférences, les tables rondes à plusieurs intervenants ou tout audio où l’interprétation contextuelle du sens compte, pas seulement la justesse des mots.
Granite Speech 4.1 2B
Granite Speech 4.1 2B d’IBM est un modèle compact conçu pour des déploiements en entreprise où la latence est critique. Il prend en charge six langues et est optimisé pour la parole professionnelle structurée, ce qui le rend efficace pour les réunions d’entreprise, les enregistrements de centres d’appels et la documentation RH.
Granite Speech 3.3 8B
Granite Speech 3.3 8B est le modèle d’entreprise plus grand d’IBM. Il sacrifie un peu de vitesse pour mieux gérer les structures de phrases complexes et le vocabulaire spécialisé. Si votre audio touche à des domaines techniques comme la médecine, le droit ou la finance, ce modèle traite la terminologie spécialisée de façon plus fiable que la version 2B, plus petite.
Quel modèle choisir
Le bon choix dépend de trois éléments : le type d’audio que vous traitez, les langues concernées et la quantité de retouches que vous êtes prêt à faire.
| Situation | Modèle recommandé |
|---|
| Enregistrements ponctuels, contenu général | GPT-4o Transcribe |
| Transcription par lots de nombreux fichiers | GPT-4o Mini Transcribe |
| Multilingue ou prise en charge de plus de 100 langues | Gemini 3 Pro |
| Audio d’entreprise ou de centre d’appels, rapide | Granite Speech 4.1 2B |
| Audio technique ou de domaine spécialisé | Granite Speech 3.3 8B |
Pour la plupart des personnes qui débutent, GPT-4o Transcribe est le choix judicieux. Il est précis, rapide et gère la plus grande variété de types de fichiers sans configuration.
PicassoIA rend les cinq modèles de reconnaissance vocale accessibles depuis une interface unique et épurée. Aucune configuration d’API, aucun code, aucune installation locale. Voici comment obtenir votre première transcription en quelques minutes.
Étape 1 : Ouvrez la page du modèle
Rendez-vous sur la page du modèle GPT-4o Transcribe sur PicassoIA. L’interface de saisie est immédiatement visible sans avoir à faire défiler la page.
Étape 2 : Importez votre fichier audio
Cliquez sur la zone d’import ou glissez directement votre fichier audio à l’intérieur. Les formats pris en charge incluent MP3, MP4, WAV, M4A, FLAC, OGG et WebM. Les limites de taille de fichier dépendent de votre forfait, mais la plupart des enregistrements d’entretiens ou de réunions passent sans compression.
Étape 3 : Réglez vos paramètres
Avant de lancer la transcription, configurez les options suivantes :
- Langue : Indiquez la langue source si elle est connue. La laisser sur détection automatique fonctionne bien pour un audio monolingue. Pour les enregistrements multilingues, sélectionnez auto.
- Format de réponse : Choisissez entre texte brut, JSON (avec horodatages), SRT (pour les sous-titres) ou VTT (pour les sous-titres de vidéos web).
- Granularité des horodatages : Si vous avez besoin d’horodatages au niveau du mot pour la synchronisation des sous-titres ou pour l’édition, activez cette option avant de lancer la transcription.
Étape 4 : Lancez la transcription
Cliquez sur le bouton de génération. Pour un podcast de 30 minutes, comptez moins de 60 secondes pour obtenir le résultat. Le texte apparaît directement dans l’interface et peut être copié ou téléchargé dans le format de votre choix.
Étape 5 : Relisez et corrigez
Les transcriptions par IA sont précises, mais pas parfaites. Les noms propres, la parole très rapide et un bruit de fond important peuvent encore introduire des erreurs. Faites une relecture rapide du résultat avant de l’utiliser, surtout pour tout ce qui sera publié mot pour mot.
💡 Astuce : Si vous avez besoin d’étiquettes d’intervenants (par exemple, « Intervenant 1 : », « Intervenant 2 : »), associez votre transcription à une étape de post-traitement avec l’un des grands modèles de langage de PicassoIA pour ajouter automatiquement ces étiquettes de diarisation, en fonction de l’alternance des prises de parole dans le texte.
À qui cela profite vraiment
La transcription par IA n’est plus un outil de niche. Elle résout un problème précis et chronophage qui se retrouve dans des dizaines de professions.
Podcasteurs et créateurs de contenu
Les transcriptions de podcasts ont un double intérêt : elles améliorent l’accessibilité pour les publics sourds et malentendants, et elles génèrent une version textuelle complète de chaque épisode que les moteurs de recherche peuvent indexer. Transcrire un épisode de 45 minutes avec GPT-4o Mini Transcribe prend environ 30 secondes, après quoi vous disposez d’une ébauche complète de notes d’émission prête à être corrigée.
Équipes d’entreprise et juridiques
La transcription de réunions fait partie des applications les plus rentables. Au lieu de confier à un membre de l’équipe la prise de notes, l’enregistrement part directement vers GPT-4o Transcribe et revient sous la forme d’un compte rendu texte complet. Les équipes juridiques s’en servent pour les enregistrements de dépositions, les appels de négociation de contrats et la documentation des consultations clients.
Chercheurs et journalistes
La recherche qualitative repose en grande partie sur des entretiens. Transcrire à la main 20 entretiens d’une heure représente une semaine entière de travail avant même le début de l’analyse. La transcription par IA réduit cela à environ deux heures de traitement au total, ce qui laisse aux chercheurs plus de temps pour le travail qui exige réellement un jugement humain.
Étudiants et enseignants
Une fois transcrits, les enregistrements de cours deviennent des supports d’étude consultables. Les étudiants peuvent utiliser Gemini 3 Pro pour transcrire les enregistrements de cours, puis envoyer le texte obtenu à un grand modèle de langage pour générer des résumés ou des supports de révision.
Obtenir des transcriptions plus propres à chaque fois
Le plafond de précision de n’importe quel modèle de transcription est fixé en grande partie par la qualité de l’audio d’entrée. Le meilleur modèle disponible ne peut pas récupérer de manière fiable les mots noyés dans le bruit d’un micro ou dans des voix concurrentes.
Conseils d’enregistrement qui font vraiment la différence
- Utilisez un micro directionnel : Un micro à condensateur cardioïde ou supercardioïde capte ce qui se trouve devant lui et rejette le bruit de la pièce. Même un micro USB de milieu de gamme à 80 $ surpassera nettement le micro intégré d’un ordinateur portable.
- Réduisez le bruit de fond : Enregistrez dans une pièce dotée de tissus et de meubles rembourrés. Les surfaces dures créent une réverbération que les modèles de traitement de la parole interprètent comme des événements audio distincts.
- Une seule personne à la fois : Le chevauchement des voix est le principal facteur qui nuit à la précision. Lors d’un entretien, attendez que la personne précédente ait fini de parler avant de répondre.
- Gardez une distance constante : Parler à 6 pouces du micro, puis reculer à 18 pouces, crée des pics de volume qui déforment le signal audio.
Corriger le résultat efficacement
Une fois votre transcription obtenue, la manière de la corriger compte :
- Recherchez les mots parasites répétés (« euh », « bah », « genre ») et effectuez un remplacement groupé pour les supprimer
- Vérifiez d’abord les noms propres, car ce sont les erreurs les plus fréquentes dans les transcriptions par IA
- Utilisez des sauts de paragraphe pour séparer les sujets distincts, ce qui rend les longs documents plus lisibles
- Conservez une copie propre avant de corriger, pour pouvoir vous reporter au résultat d’origine si besoin
La transcription n’est que le point de départ
Une fois que vous avez du texte à partir d’un audio, vous disposez d’une matière première que vous pouvez traiter de dizaines de façons. Collez la transcription d’une réunion dans un grand modèle de langage et demandez-lui un résumé en cinq points d’actions à mener. Donnez la transcription d’un entretien à un LLM et demandez-lui d’extraire toutes les citations qui appuient un argument précis. Prenez la transcription d’un podcast et transformez-la en ébauche d’article de blog.
Les grands modèles de langage de PicassoIA se trouvent juste à côté des outils de reconnaissance vocale, sur la même plateforme. Le flux de travail devient le suivant : transcrire avec GPT-4o Transcribe ou Gemini 3 Pro, puis traiter le texte obtenu avec un LLM pour le résumer, le traduire ou en extraire des informations. Tout cela sans quitter la plateforme ni passer d’un outil à l’autre.
Le gain de temps est considérable pour quiconque travaille régulièrement avec des enregistrements audio. Un entretien d’une heure devient un document consultable, modifiable et partageable le temps de préparer un café.
Allez plus loin avec vos fichiers audio
Si vous repoussez la transcription de votre arriéré d’enregistrements parce que la tâche vous semblait trop lourde, ce calcul a changé. Importez votre premier fichier dans GPT-4o Transcribe sur PicassoIA et voyez à quelle vitesse vous obtenez un résultat. Commencez par un enregistrement court si vous voulez tester la précision avant de vous engager sur des fichiers plus longs.
La collection de reconnaissance vocale de PicassoIA vous offre cinq modèles distincts, à différents niveaux de vitesse et de précision, afin que vous puissiez associer le bon outil à chaque tâche plutôt que de passer chaque fichier par une solution unique. Que vous optiez pour GPT-4o Mini Transcribe pour un traitement rapide par lots, Granite Speech 3.3 8B pour un audio technique, ou Gemini 3 Pro pour des enregistrements multilingues, le bon modèle vous attend déjà.
Vos enregistrements contiennent déjà l’information dont vous avez besoin. Il ne manquait qu’un moyen assez rapide de la transformer en texte.


