ماذا لو استطعت أخذ أي فيديو، وتبديل لغته، وجعل فم المتحدث يتطابق تمامًا مع الصوت الجديد؟ هذا بالضبط ما تفعله مزامنة الشفاه بالذكاء الاصطناعي، وقد انتقلت في أقل من ثلاث سنوات من كونها فضولًا بحثيًا إلى أداة إنتاج عملية.
ما الذي تفعله مزامنة الشفاه بالذكاء الاصطناعي فعلًا
مزامنة الشفاه بالذكاء الاصطناعي هي عملية محاذاة حركة شفتي الشخص وفكّه المرئية في الفيديو تلقائيًا لتتوافق مع مسار صوتي جديد. قد يكون الصوت الأصلي بالإنجليزية والصوت المستهدف بالإسبانية، أو قد يكون التبديل من متحدث إلى آخر بالكامل. في كلتا الحالتين، يعدّل الذكاء الاصطناعي منطقة الوجه في كل إطار، بحيث يبدو الفم وكأنه ينطق الكلام الجديد بشكل طبيعي.
هذا يختلف عن الترجمة النصية، التي تكتفي بإضافة نص. ويختلف كذلك عن استنساخ الصوت، الذي يغيّر الصوت وحده. تغيّر مزامنة الشفاه بالذكاء الاصطناعي الفيديو نفسه، فتجعل وجه المتحدث يبدو وكأنه ينطق كلمات جديدة تمامًا.
الآليات الأساسية
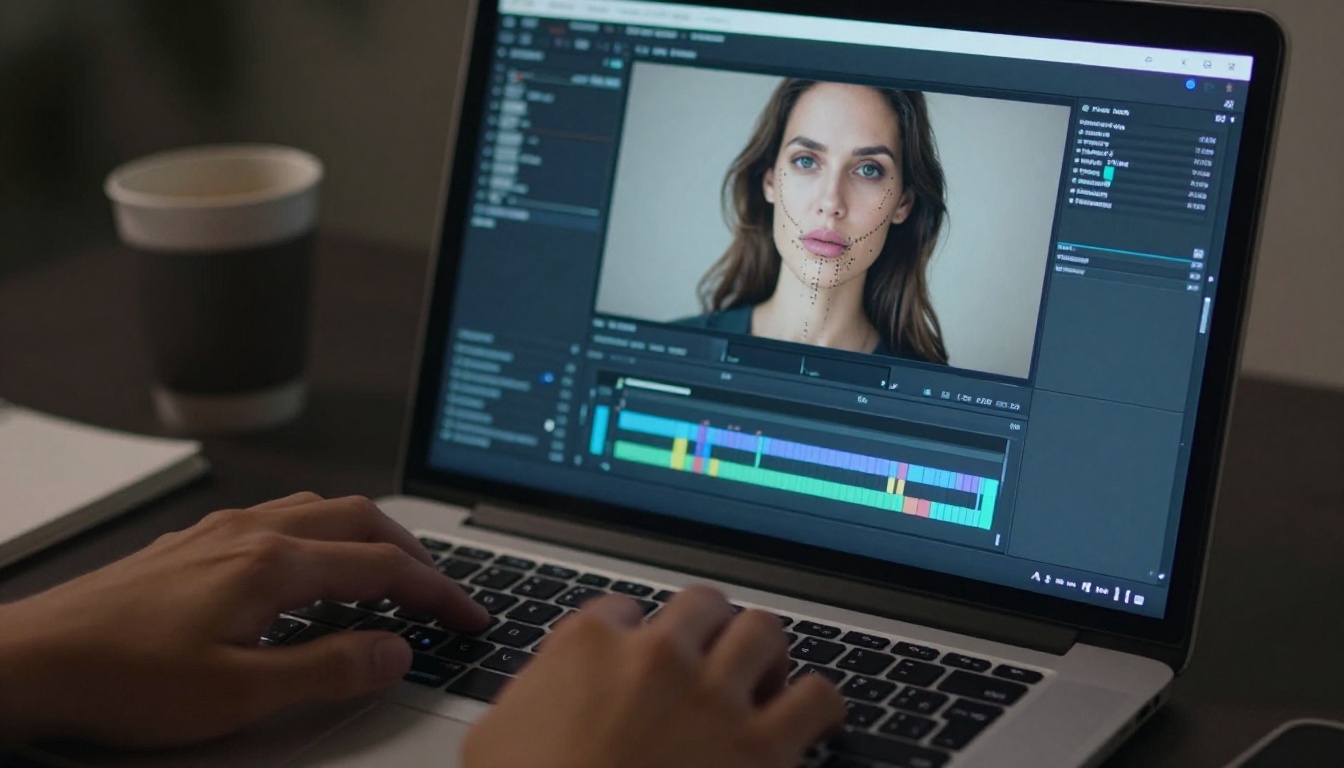
على المستوى التقني، تعمل معظم أنظمة مزامنة الشفاه بالذكاء الاصطناعي في ثلاث مراحل. أولًا، يكتشف النموذج الوجه ويعزل منطقة الفم باستخدام كشف النقاط المميزة للوجه، إذ يرسم عشرات النقاط حول الشفتين والفك والذقن. ثانيًا، يحلل الصوت المستهدف فونيمًا فونيمًا، لأن كل فونيم (أصغر وحدة صوتية في الكلام) ينتج شكلًا محددًا للفم يسمى viseme. ثالثًا، يولّد النموذج إطارات جديدة تطابق فيها منطقة الفم تسلسل viseme القادم من الصوت، ثم يدمج الهندسة المعدّلة مرة أخرى في الوجه الأصلي والخلفية.
النتيجة وجه يبدو وكأنه ينطق كلمات جديدة، حتى لو لم يقلها المتحدث الأصلي أبدًا.
المزامنة المدفوعة بالصوت مقابل المدفوعة بالنص
هناك نهجان أساسيان في مزامنة الشفاه بالذكاء الاصطناعي:
- مدفوعة بالصوت: يأخذ النموذج ملف صوت ويربطه مباشرة بأشكال viseme. لا يحتاج إلى معرفة اللغة، بل الأصوات فقط. وهذا يجعله مرنًا ومستقلًا عن اللغة.
- مدفوعة بالنص: يأخذ النموذج نصًا مكتوبًا، ويولّد الكلام داخليًا عبر تحويل النص إلى كلام، ثم يزامن الصوت الناتج مع الفيديو. يمنح هذا تحكمًا أكبر في التوقيت، لكنه يتطلب مخرجات تحويل نص إلى كلام عالية الجودة.
معظم أدوات الإنتاج اليوم مدفوعة بالصوت، أي أنك تحضر التعليق الصوتي الخاص بك ويتولى النموذج المزامنة.
لماذا تبدو النتائج واقعية الآن
قبل ثلاث سنوات، كانت مزامنة الشفاه بالذكاء الاصطناعي تحمل بوضوح طابع "الوجه المطاطي". كان الفم يتحرك، لكن الدمج لم يكن دقيقًا، والانتقالات كانت حادة، وكان الفك يتحرك بمعزل عن الخدّين. أما اليوم، فقد تقلّصت الفجوة بين مزامنة الشفاه بالذكاء الاصطناعي والتسجيل الاحترافي لإعادة الحوار ADR (استبدال الحوار الآلي، وهي التقنية السينمائية التقليدية لإعادة تسجيل الحوار في مرحلة ما بعد الإنتاج) بشكل ملحوظ.
التعلم العميق ورسم خريطة الوجه
تُدرَّب النماذج الحديثة على آلاف الساعات من الفيديو المقترن بنصوص مفرّغة للصوت. يمنحها ذلك معرفة غنية بكيفية حركة الوجوه البشرية أثناء الكلام: الانقباض الخفيف لزاويتي الفم قبل صامت شفوي مثل "p" أو "b"، ونسبة انخفاض الفك للصوائت المفتوحة، وطريقة تحرك الذقن مع الرقبة. هي لا تحرّك الشفتين فقط، بل تحرّك الوجه السفلي كله كنظام متناسق.
Omni Human 1.5، الذي طوّرته ByteDance، يوضح ذلك جيدًا. يولّد تحريك الوجه كاملًا انطلاقًا من صورة واحدة مقترنة بمدخل صوتي، ويُنتج حركة رأس متسقة زمنيًا ورمشًا طبيعيًا إلى جانب حركة الشفاه.
الاتساق الزمني مهم
أصعب مشكلة في مزامنة الشفاه بالذكاء الاصطناعي ليست إنتاج إطار جيد واحد، بل إنتاج 600 إطار جيد متتالية. إذا كان الدمج غير متسق ولو قليلًا بين الإطارات، تلتقطه العين البشرية فورًا بسبب التشويه الزمني (temporal aliasing). المشاهد لا يلاحظ ما الخطأ بوعي، لكنه يشعر أن شيئًا ما غير صحيح.
💡 نصيحة: النماذج التي تعالج الفيديو على شكل مقاطع زمنية (لا إطارًا إطارًا) تنتج نتائج أكثر سلاسة، لأنها تأخذ في الحسبان الحركة بين الإطارات، لا داخلها فقط.
5 حالات استخدام تنجح فيها فعلًا
مزامنة الشفاه بالذكاء الاصطناعي ليست حلًا لكل مشكلات الفيديو. لكنها في هذه الحالات الخمس تقدّم نتائج حقيقية فعلًا.
الدبلجة لجمهور عالمي
هذه أعلى حالة استخدام قيمةً من حيث الحجم. يمكن لفيديو توضيحي مدته 20 دقيقة باللغة الإنجليزية أن يصل إلى جماهير تتحدث الإسبانية والبرتغالية والفرنسية والألمانية، عبر نسخ مدبلجة تبدو وكأن المتحدث الأصلي يقدّم تلك اللغات فعلًا. يتعامل Video Translate من HeyGen مع 150+ لغة لهذا الغرض تحديدًا، ويغطي الترجمة ومزامنة الشفاه معًا في سير عمل واحد.
الحسابات الاقتصادية مقنعة. قد تكلّف الدبلجة الصوتية الاحترافية مع استوديو توطين ما بين $500 و$2,000 للغة الواحدة للفيديو الواحد. أما الدبلجة بالذكاء الاصطناعي فتجعل التكلفة المتغيرة قريبة من الصفر بعد إعداد سير العمل.
| طريقة الدبلجة | التكلفة للغة الواحدة | مدة التنفيذ |
|---|
| استوديو احترافي | من $500 إلى $2,000 | من 5 إلى 15 يوم عمل |
| مزامنة الشفاه بالذكاء الاصطناعي (دون مراجعة) | من $5 إلى $30 | أقل من ساعة واحدة |
| مزامنة الشفاه بالذكاء الاصطناعي (مع مراجعة) | من $50 إلى $200 | من 1 إلى 2 يوم |
إنشاء أفاتار متحدث
لا تحتاج إلى فيديو لشخص حقيقي لاستخدام تقنية مزامنة الشفاه. تتيح لك أدوات مثل P Video Avatar وFabric 1.0 من Veed رفع صورة شخصية وتحريكها بأي صوت تقدمه. والنتيجة أفاتار متحدث يمكنه تمثيل علامة تجارية أو شخصية خيالية أو متحدث مُولَّد بالذكاء الاصطناعي، دون الحاجة إلى توظيف ممثل أو حجز وقت في استوديو.
هذا مفيد بشكل خاص في:
- شروحات المنتجات التي تحتاج إلى وجه بشري دون ظهور شخص حقيقي أمام الكاميرا
- أفاتارات العلامات التجارية التي يمكن تحديثها بنصوص جديدة كلما تغيّرت الرسائل مع الوقت
- التواصل الداخلي الذي يحتاج إلى مقدّم ثابت الشخصية على نطاق واسع عبر مناطق متعددة
Omni Human يتعامل مع تحريك صورة فوتوغرافية واحدة مع حركة طبيعية للرأس وديناميكية للوجه، مما يجعل الأفاتار يبدو أقل جمودًا من أساليب تحريك الصور الشخصية الأقدم.
محتوى وسائل التواصل الاجتماعي على نطاق واسع
تكافئ منصات التواصل الاتساق: منشورات يومية، وسلاسل أسبوعية، وصيغ متكررة. عنق الزجاجة لدى صنّاع المحتوى الذين يظهرون أمام الكاميرا ليس الأفكار، بل وقت التسجيل. تتيح مزامنة الشفاه بالذكاء الاصطناعي لصانع المحتوى تسجيل نسخة أساسية من محتواه، ثم إعادة تسجيل صوته للغات مختلفة أو نبرات مختلفة أو شرائح جمهور مختلفة، دون إعادة تصوير اللقطات الأصلية.
Lipsync Speed من HeyGen مصمم لهذه الحالة، إذ يعطي الأولوية لسرعة المعالجة على أقصى درجات الدقة، حتى يتمكن صنّاع المحتوى من التكرار بسرعة بين النسخ.
💡 نصيحة: بالنسبة للمحتوى القصير الذي تقل مدته عن 90 ثانية، تحقق النماذج المحسّنة للسرعة نتائج لا يمكن تمييزها عن النماذج الأبطأ ذات الدقة الأعلى في معظم سياقات المشاهدة في الخلاصات.
فيديوهات التدريب المؤسسي
فرق التعلم والتطوير في الشركات تنتج كمًّا هائلًا من محتوى الفيديو: تدريبات الامتثال، ووحدات التأهيل للموظفين الجدد، وتحديثات المنتجات. وغالبًا ما تحتاج هذه الفيديوهات إلى تقديمها بلغات إقليمية متعددة عبر قوى عاملة عالمية. تحوّل مزامنة الشفاه بالذكاء الاصطناعي تسجيلًا أساسيًا واحدًا إلى نسخ مُعرَّبة، دون الحاجة إلى حجز المقدّم من جديد أو إدارة جداول استوديوهات متعارضة.
Lipsync Precision من HeyGen يركّز على الدقة أكثر من سرعة المعالجة، مما يجعله مناسبًا للمحتوى الاحترافي الطويل، حيث تكون أخطاء التوقيت في فيديو تدريب مدته 45 دقيقة مكلفة في تحديدها وإصلاحها.
إصلاحات ما بعد الإنتاج
هذه حالة استخدام مغفول عنها. يؤدي ممثل سطرًا حواريًا. استبدال الصوت من ADR أو من لقطة أخرى نظيف، لكن حركات الشفاه في الصورة لا تتطابق معه. في إنتاج الأفلام التقليدي، يعني ذلك إما قطع اللقطة وإعادة ترتيبها أو استدعاء الممثل مجددًا. مع مزامنة الشفاه بالذكاء الاصطناعي، يستطيع المونتير مزامنة الصوت البديل مع اللقطات الموجودة مباشرة، فيُبقي اللقطة التي نجحت بصريًا ويصلح طبقة الصوت وحدها.
React 1 من Sync وLipsync 2 من Sync كلاهما يستهدف سير عمل التحرير الدقيق هذا، ويقدّمان ضوابط دقيقة تتيح للمحررين العمل على مستوى الفونيم بدلًا من تخمين توقيت الكلمة بأكملها.
متى تواجه مزامنة الشفاه بالذكاء الاصطناعي صعوبات
معرفة الحالات التي تفشل فيها التقنية لا تقل أهمية عن معرفة الحالات التي تنجح فيها.
زوايا الرأس المتطرفة
تُدرَّب نماذج مزامنة الشفاه بالذكاء الاصطناعي أساسًا على وجوه تكون في وضعية أمامية أو قريبة من الأمامية. عندما يكون الشخص في منظور ثلاثي الأرباع، أو في منظر جانبي، أو ينظر بشكل ملحوظ لأعلى أو لأسفل، تنخفض جودة تخليق الفم بشدة. يملك النموذج مرجعًا هندسيًا أقل لإعادة بناء منطقة الفم، وتظهر تشوهات الدمج عند حدود الخد والذقن.
إذا كان فيديوك ينتقل كثيرًا إلى لقطات عريضة أو لقطات جانبية أثناء الحوار، فإن مزامنة الشفاه بالذكاء الاصطناعي ليست الحل المناسب لتلك اللقطات. طبّقها فقط على اللقطات الأمامية في مونتاجك.
مصدر فيديو منخفض الجودة
تشوهات الضغط، وضبابية الحركة، والدقة المنخفضة كلها تُضعف مخرجات مزامنة الشفاه بشكل كبير. يحتاج النموذج إلى كشف منطقة الفم وإعادة بنائها بدقة، إطارًا إطارًا، وإذا كانت لقطات المصدر أقل من 720p أو مضغوطة بشدة، فستعكس جودة المخرجات محدودية المصدر مباشرة.
💡 نصيحة: ابدأ دائمًا من أعلى ملف مصدر جودة متاح، ويفضل 1080p أو أعلى. إذا كان المصدر منخفض الجودة، شغّله عبر نموذج رفع الدقة (super-resolution) أولًا قبل تطبيق مزامنة الشفاه.
كيفية استخدام مزامنة الشفاه على PicassoIA
بما أن عدة نماذج لمزامنة الشفاه متاحة على المنصة، فإن سير العمل يصبح بسيطًا بمجرد أن تعرف النموذج المناسب لحالة استخدامك.
اختيار النموذج المناسب
استخدم إطار القرار السريع هذا:
خطوة بخطوة مع Lipsync 2 Pro
Lipsync 2 Pro من Sync هو أدق نموذج عام لمزامنة الشفاه متاح على المنصة. إليك طريقة استخدامه:
- جهّز الفيديو الخاص بك: استخدم لقطة أمامية نظيفة وجيدة الإضاءة بدقة 1080p أو أعلى. أزل موسيقى الخلفية من مسار الصوت الأصلي إن أمكن، حتى لا يتشوش كشف الوجه بترددات الكلام الأصلي.
- جهّز الصوت الخاص بك: سجّل أو أنشئ الصوت البديل بتردد 44.1kHz أو 48kHz. يُفضَّل تنسيق WAV على MP3 للحفاظ على نطاق الترددات الكامل الذي يستخدمه النموذج في كشف الفونيمات.
- ارفع الملفات إلى Lipsync 2 Pro: انتقل إلى Lipsync 2 Pro على المنصة. ارفع ملف الفيديو وملف الصوت في حقول الإدخال المخصصة.
- اضبط وضع المزامنة: اختر بين مزامنة "دقيقة" (تُعطي الأولوية للتطابق الدقيق للفونيم، وقد تُظهر تصلبًا طفيفًا في الوجه عند الكلام السريع)، أو مزامنة "طبيعية" (تُعطي الأولوية لتحريك سلس، مع انحراف طفيف في التوقيت مقبول لمعظم المحتوى).
- راجع المخرجات: شاهد المخرجات بالسرعة الكاملة أولًا، ثم انتقل إطارًا إطارًا عبر المقاطع المعقدة صوتيًا (الحروف الصفيرية (sibilants) والحروف الانفجارية (plosives)) حيث يكون ظهور التشوهات أكثر احتمالًا.
- أعد المعالجة للمقاطع المشكلة: إذا ظهرت تشوهات في كلمات محددة، اقطع الصوت عند تلك النقاط، وأعد تسجيل تلك الكلمات فقط، ثم أعد تشغيل النموذج على جزء المقطع هذا فقط.
أفضل النماذج في لمحة
5 نصائح لنتائج أفضل
الحصول على مخرجات جيدة من مزامنة الشفاه بالذكاء الاصطناعي يعتمد جزئيًا على النموذج، وإلى حد كبير على المدخلات. هذه الممارسات الخمس تُحدث فرقًا ملموسًا:
-
ثبّت الوجه في الفيديو المصدر. إذا كانت الكاميرا محمولة وكان الوجه يتحرك داخل الإطار، يضطر النموذج إلى إعادة كشف النقاط المميزة في كل إطار بشكل مستقل. اللقطة المثبّتة والثابتة تمنح النموذج هندسة متسقة، وتنتج دمجًا أنظف عند حدود الفم.
-
طابق مستوى الصوت مع الأصلي. إذا كان الصوت البديل أعلى أو أخفض بشكل ملحوظ من الضوضاء المحيطة في الفيديو الأصلي، يلاحظ دماغ المشاهد التفاوت حتى لو بدت الشفاه صحيحة. قبل المزامنة، وازن مستوى صوت الصوت البديل مع مستوى المسار الأصلي (مقاسًا بوحدة LUFS).
-
استخدم تسجيلات واضحة صوتيًا. الكلام المتمتم، أو المضغوط بشدة، أو ذو اللكنة الثقيلة ينتج غموضًا أكبر في أشكال viseme بالنسبة للنموذج. الكلام المنطوق بوضوح مع مسافة ميكروفون ثابتة يمنح كشف الفونيمات مدخلًا أكثر موثوقية للعمل عليه.
-
انتبه لتشوهات الرمش. الرمشات الطويلة التي تحدث في منتصف كلمة قد تجعل النموذج يولّد توليفة جزئية من الرمش وحركة الفم تبدو غير طبيعية. إذا لاحظت ذلك في المخرجات، اقتطع بضعة إطارات حول الرمشة، وأعد تشغيل ذلك المقطع بمعزل عن غيره.
-
اقتطع الصمت من الصوت البديل. إذا كان الصوت البديل يحتوي على فترات صمت ممتدة، قد يولّد النموذج وضعية فم خاملة تبدو "مشدودة" قليلًا. اقتطع الصمت بما يتناسب مع إيقاع التنفس الطبيعي للمتحدث الأصلي الظاهر في اللقطات.
أنشئ شيئًا جديدًا الآن
تجاوزت مزامنة الشفاه بالذكاء الاصطناعي مرحلة العرض التوضيحي المثير للإعجاب لتصبح أداة جاهزة للإنتاج. سواء كنت تُوطّن محتواك لثلاثة أسواق جديدة، أو تبني أفاتارًا متحدثًا لعلامتك التجارية، أو تصلح سطرًا في مرحلة ما بعد الإنتاج يزعجك منذ أسبوع، فإن سير العمل صار متاحًا الآن دون برامج متخصصة أو خبرة تقنية عميقة.
تغطي النماذج المتاحة على PicassoIA كل حالة استخدام رئيسية، من Lipsync Speed للمحتوى الاجتماعي السريع إلى Lipsync 2 Pro للعمل الاحترافي الدقيق. يمكنك البدء بفيديو لديك بالفعل، وتعليق صوتي سجّلته على هاتفك، والحصول على نتيجة متزامنة خلال دقائق.
أفضل طريقة لترى ما تستطيع هذه الأدوات فعله هي تشغيل لقطاتك الخاصة عبرها. اختر نموذجًا يناسب حالة استخدامك، وارفع مقطعًا، وشاهد شكل المخرجات. تكلفة التكرار منخفضة، والمكسب، إن كان يناسب سير عملك، كبير.


