Et si vous pouviez prendre n’importe quelle vidéo, changer la langue et faire correspondre parfaitement la bouche de l’orateur au nouvel audio ? C’est exactement ce que fait le lipsync IA, et il est passé du stade de simple curiosité de recherche à celui d’outil de production concret en moins de trois ans.
Ce que fait réellement le lipsync IA
Le lipsync IA consiste à aligner automatiquement les mouvements visibles des lèvres et de la mâchoire d’une personne dans une vidéo sur une nouvelle piste audio. La piste d’origine peut être en anglais et la piste cible en espagnol, ou bien le remplacement peut concerner entièrement un autre locuteur. Dans tous les cas, l’IA modifie la zone du visage dans chaque image afin que la bouche paraisse articuler naturellement la nouvelle parole.
Cela diffère du sous-titrage, qui se contente d’ajouter du texte. C’est aussi différent du clonage vocal, qui ne modifie que l’audio. Le lipsync IA modifie la vidéo elle-même, donnant l’impression que le visage de l’orateur prononce des mots entièrement nouveaux.
Les mécanismes de base
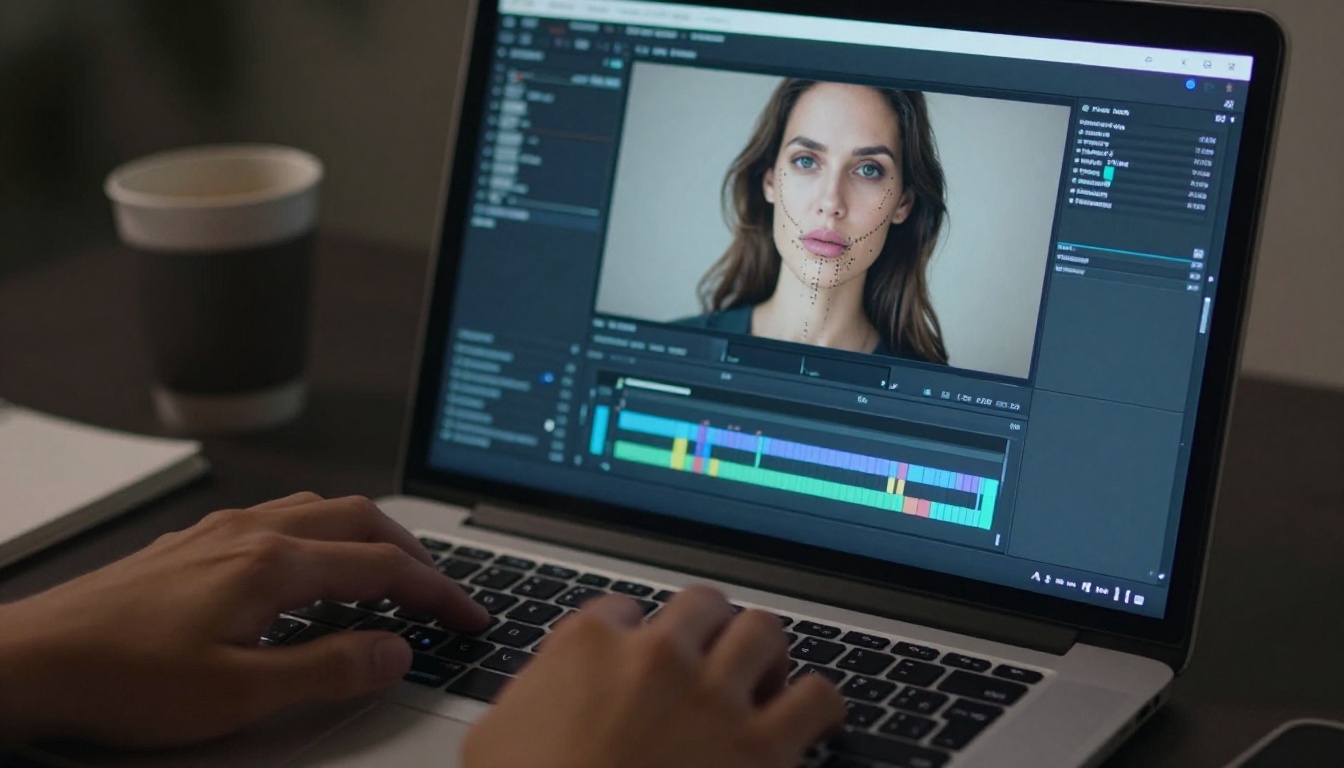
Sur le plan technique, la plupart des systèmes de lipsync IA fonctionnent en trois étapes. D’abord, le modèle détecte le visage et isole la zone de la bouche grâce à la détection de points de repère faciaux, en cartographiant des dizaines de points autour des lèvres, de la mâchoire et du menton. Ensuite, il analyse l’audio cible phonème par phonème, car chaque phonème (la plus petite unité sonore de la parole) produit une forme de bouche spécifique appelée visème. Enfin, le modèle génère de nouvelles images dans lesquelles la zone de la bouche correspond à la séquence de visèmes issue de l’audio, en fusionnant la géométrie modifiée avec le visage et l’arrière-plan d’origine.
Le résultat est un visage qui semble prononcer de nouveaux mots, même si la personne filmée ne les a jamais dits.
Synchronisation pilotée par l’audio ou par le texte
Il existe deux grandes approches du lipsync IA :
- Pilotée par l’audio : le modèle prend un fichier audio et le fait correspondre directement à des visèmes. Il n’a pas besoin de connaître la langue, seulement les sons. Cela le rend souple et indépendant de la langue.
- Pilotée par le texte : le modèle prend un script, génère la parole en interne via la synthèse vocale, puis synchronise la voix obtenue avec la vidéo. Cela offre davantage de contrôle sur le timing, mais exige une synthèse vocale de haute qualité.
La plupart des outils de production actuels sont pilotés par l’audio, ce qui signifie que vous apportez votre propre voix off et que le modèle se charge de la synchronisation.
Pourquoi les résultats paraissent désormais réalistes
Il y a trois ans, le lipsync IA avait un aspect « visage en caoutchouc » indéniable. La bouche bougeait, mais la fusion était imparfaite, les transitions brusques et la mâchoire bougeait indépendamment des joues. Aujourd’hui, l’écart entre le lipsync IA et l’ADR professionnel (Automated Dialogue Replacement, la technique traditionnelle du cinéma pour réenregistrer les dialogues en postproduction) s’est considérablement réduit.
Apprentissage profond et cartographie faciale
Les modèles modernes sont entraînés sur des milliers d’heures de vidéos associées à des transcriptions audio. Cela leur donne des connaissances approfondies sur la façon dont les visages humains bougent pendant la parole : le léger resserrement des coins de la bouche avant une consonne bilabiale comme « p » ou « b », l’amplitude d’ouverture de la mâchoire pour les voyelles ouvertes, la manière dont le menton suit le cou. Ils ne se contentent pas d’animer les lèvres. Ils animent l’ensemble du bas du visage comme un système coordonné.
Omni Human 1.5, développé par ByteDance, illustre bien cela. Il génère une animation du visage complet à partir d’une seule photo associée à un fichier audio, avec un mouvement de la tête cohérent dans le temps et des clignements naturels accompagnant les mouvements des lèvres.
La cohérence temporelle compte
Le problème le plus difficile du lipsync IA n’est pas de réussir une bonne image, mais 600 bonnes images d’affilée. Si la fusion est même légèrement incohérente d’une image à l’autre, l’œil humain le remarque immédiatement en raison de l’aliasing temporel. Le spectateur ne voit pas consciemment ce qui cloche. Il ressent simplement que quelque chose ne va pas.
💡 Astuce : les modèles qui traitent la vidéo par blocs temporels (et non image par image) produisent des résultats plus fluides, car ils tiennent compte du mouvement entre les images et pas seulement à l’intérieur de chacune.
5 cas d’usage où cela fonctionne vraiment
Le lipsync IA n’est pas une solution à tous les problèmes vidéo. Mais dans ces cinq situations, il tient vraiment ses promesses.
Doublage pour un public mondial
C’est le cas d’usage le plus rentable en volume. Une vidéo explicative de 20 minutes en anglais peut toucher des publics espagnols, portugais, français et allemands grâce à des versions doublées qui donnent l’impression que l’orateur d’origine s’exprime réellement dans ces langues. Video Translate de HeyGen prend en charge plus de 150 langues dans ce but précis, en couvrant à la fois la traduction et la synchronisation labiale dans un seul flux de travail.
L’équation économique est convaincante. Un doublage vocal professionnel avec un studio de localisation peut coûter entre 500 $ et 2 000 $ par langue et par vidéo. Le doublage par IA ramène ce coût variable à presque zéro une fois le flux de travail en place.
| Méthode de doublage | Coût par langue | Délai de livraison |
|---|
| Studio professionnel | 500 $ à 2 000 $ | 5 à 15 jours ouvrés |
| Lipsync IA (sans relecture) | 5 $ à 30 $ | Moins d’une heure |
| Lipsync IA (avec relecture) | 50 $ à 200 $ | 1 à 2 jours |
Créer des avatars parlants
Vous n’avez pas besoin d’une vidéo d’une vraie personne pour utiliser la technologie de lipsync. Des outils comme P Video Avatar et Fabric 1.0 de Veed vous permettent d’importer une image de portrait et de l’animer avec n’importe quel audio fourni. Le résultat est un avatar parlant qui peut représenter une marque, un personnage fictif ou un porte-parole synthétique, sans embaucher d’acteur ni réserver de studio.
Cela est particulièrement utile pour :
- Vidéos explicatives de produits qui nécessitent un visage humain sans qu’une vraie personne apparaisse à l’écran
- Avatars de marque qui peuvent être mis à jour avec de nouveaux scripts à mesure que les messages évoluent
- Communications internes qui exigent une figure de présentateur cohérente, déployé à grande échelle dans plusieurs régions
Omni Human gère l’animation à partir d’une seule photo avec des mouvements naturels de la tête et une dynamique faciale, ce qui rend l’avatar moins figé que les anciennes approches d’animation de portraits.
Contenu pour les réseaux sociaux à grande échelle
Les plateformes sociales récompensent la régularité : publications quotidiennes, séries hebdomadaires, formats récurrents. Pour les créateurs qui apparaissent à l’écran, le goulot d’étranglement n’est pas l’inspiration, mais le temps de tournage. Le lipsync IA permet à un créateur d’enregistrer une version maîtresse de son contenu et de le faire doubler de nouveau pour différentes langues, différents tons ou différents segments d’audience, sans retourner les images d’origine.
Lipsync Speed de HeyGen est conçu pour ce cas d’usage : il privilégie la vitesse de traitement à la précision maximale afin que les créateurs puissent itérer rapidement entre les versions.
💡 Astuce : pour les contenus courts de moins de 90 secondes, les modèles optimisés pour la vitesse donnent des résultats indiscernables de ceux des modèles plus lents et plus précis dans la plupart des contextes de visionnage dans le fil d’actualité.
Vidéos de formation en entreprise
Les équipes formation et développement (L&D) des entreprises produisent d’énormes volumes de contenus vidéo : formations de conformité, modules d’intégration, mises à jour produits. Ces vidéos doivent souvent être diffusées en plusieurs langues régionales auprès de collaborateurs répartis dans le monde. Le lipsync IA transforme un seul enregistrement maître en versions localisées, sans devoir reprogrammer le présentateur ni gérer des plannings de studio incompatibles.
Lipsync Precision de HeyGen privilégie la précision à la vitesse de traitement, ce qui le rend adapté aux contenus professionnels de longue durée, où une erreur de timing dans une vidéo de formation de 45 minutes serait coûteuse à identifier et à corriger.
Corrections en postproduction
C’est un cas d’usage sous-estimé. Un acteur prononce une réplique. Le remplacement audio issu de l’ADR ou d’une autre prise est propre, mais les mouvements des lèvres dans l’image ne correspondent pas. Dans la production cinématographique traditionnelle, cela implique soit de couper autour du plan, soit de faire revenir l’acteur. Avec le lipsync IA, le monteur peut synchroniser directement le nouvel audio sur les images existantes, en conservant le plan qui fonctionnait visuellement et en ne corrigeant que la couche audio.
React 1 de Sync et Lipsync 2 de Sync visent tous deux ce flux de montage de précision. Ils offrent des commandes fines qui permettent aux monteurs de travailler au niveau du phonème plutôt que d’approximer le timing à l’échelle du mot entier.
Les situations où le lipsync IA peine
Savoir où la technologie atteint ses limites est aussi important que de savoir où elle fonctionne.
Angles de tête extrêmes
Les modèles de lipsync IA sont entraînés principalement sur des visages de face ou presque de face. Lorsque le sujet est vu de trois quarts, de profil, ou regarde nettement vers le haut ou vers le bas, la qualité de la synthèse de la bouche chute fortement. Le modèle dispose de moins de géométrie de référence pour reconstruire la zone de la bouche, et des artefacts de fusion deviennent visibles au niveau de la limite entre la joue et le menton.
Si votre vidéo passe souvent à des plans larges ou de profil pendant les dialogues, le lipsync IA n’est pas la bonne solution pour ces plans. Appliquez-le uniquement aux plans de face de votre montage.
Vidéo source de faible qualité
Les artefacts de compression, le flou de bougé et la faible résolution dégradent tous fortement le rendu du lipsync. Le modèle doit détecter et reconstruire avec précision la zone de la bouche image par image, et si les rushes sont en dessous de 720p ou fortement compressés, la qualité du résultat reflétera directement ces limites.
💡 Astuce : travaillez toujours à partir du fichier source de la meilleure qualité disponible, idéalement en 1080p ou plus. Si votre source est de faible qualité, passez-la d’abord dans un modèle de super-résolution avant d’appliquer le lipsync.
Comme plusieurs modèles de lipsync sont disponibles sur la plateforme, le flux de travail est simple une fois que vous savez quel modèle correspond à votre cas d’usage.
Choisir le bon modèle
Utilisez ce cadre de décision rapide :
Pas à pas avec Lipsync 2 Pro
Lipsync 2 Pro de Sync est le modèle de lipsync à usage général le plus précis de la plateforme. Voici comment l’utiliser :
- Préparez votre vidéo : utilisez un plan de face net et bien éclairé, en 1080p ou plus. Si possible, supprimez la musique de fond de la piste audio source afin que la détection du visage ne soit pas perturbée par les fréquences de la parole d’origine.
- Préparez votre audio : enregistrez ou générez le nouvel audio en 44,1 kHz ou 48 kHz. Le format WAV est préférable au MP3 pour préserver toute la plage de fréquences que le modèle utilise pour la détection des phonèmes.
- Importez vers Lipsync 2 Pro : accédez à Lipsync 2 Pro sur la plateforme. Importez votre fichier vidéo et votre fichier audio dans les champs de saisie prévus à cet effet.
- Réglez le mode de synchronisation : choisissez entre une synchronisation « tight » (qui privilégie la correspondance exacte des phonèmes, mais peut donner une légère raideur du visage sur une parole rapide) ou une synchronisation « natural » (qui privilégie une animation fluide, avec une petite variation de timing acceptable pour la plupart des contenus).
- Vérifiez le résultat : regardez d’abord le résultat à vitesse normale, puis parcourez image par image les passages phonétiquement complexes (sifflantes, occlusives) où les artefacts risquent le plus d’apparaître.
- Itérez sur les passages problématiques : si le résultat présente des artefacts sur certains mots, coupez l’audio à ces endroits, réenregistrez uniquement ces mots et relancez le modèle sur ce segment du clip seulement.
Les meilleurs modèles en un coup d’œil
5 conseils pour de meilleurs résultats
Obtenir un bon résultat de lipsync IA dépend en partie du modèle, mais surtout de vos entrées. Ces cinq pratiques font une différence mesurable :
-
Stabilisez le visage dans la vidéo source. Si la caméra est tenue à la main et que le visage dérive dans le cadre, le modèle doit redétecter les points de repère sur chaque image indépendamment. Un plan stabilisé et fixe donne au modèle une géométrie cohérente et produit une fusion plus propre au niveau de la limite de la bouche.
-
Alignez le volume de l’audio sur l’original. Si le nouvel audio est nettement plus fort ou plus faible que le bruit ambiant de la vidéo d’origine, le cerveau du spectateur remarque l’écart, même lorsque les lèvres semblent correctes. Normalisez votre audio de remplacement sur le niveau de sonie de la piste d’origine (mesuré en LUFS) avant la synchronisation.
-
Utilisez des enregistrements phonétiquement clairs. Une parole marmonnée, trop compressée ou marquée par un fort accent produit davantage d’ambiguïtés de visèmes pour le modèle. Une élocution bien articulée, avec une distance constante au micro, donne à la détection des phonèmes des données plus fiables.
-
Surveillez les artefacts de clignement. Des clignements prolongés survenant au milieu d’un mot peuvent amener le modèle à générer une combinaison partielle clignement et mouvement de bouche qui paraît peu naturelle. Si vous voyez cela dans le résultat, coupez quelques images autour du clignement et relancez ce segment isolément.
-
Coupez les silences dans l’audio de remplacement. Si votre audio contient de longues pauses, le modèle peut générer une posture de bouche au repos qui paraît légèrement « figée ». Retirez les silences pour correspondre au rythme naturel de respiration de l’orateur d’origine, visible dans les images source.
Créez quelque chose de nouveau dès maintenant
Le lipsync IA a franchi le seuil qui sépare la démonstration impressionnante de l’outil prêt pour la production. Que vous localisiez des contenus pour trois nouveaux marchés, que vous construisiez un avatar parlant pour votre marque ou que vous corrigiez en postproduction une réplique qui vous trotte dans la tête depuis une semaine, le flux de travail est désormais accessible sans logiciel spécialisé ni expertise technique approfondie.
Les modèles disponibles sur PicassoIA couvrent tous les grands cas d’usage, de Lipsync Speed pour les contenus sociaux rapides à Lipsync 2 Pro pour un travail professionnel de précision. Vous pouvez partir d’une vidéo que vous avez déjà, d’une voix off enregistrée sur votre téléphone, et obtenir un résultat synchronisé en quelques minutes.
La meilleure façon de voir ce que ces outils peuvent faire est de passer vos propres rushes dedans. Choisissez le modèle qui correspond à votre cas d’usage, importez un extrait et regardez le résultat. Le coût d’itération est faible. Le gain, s’il s’intègre à votre flux de travail, est considérable.


