¿Y si pudieras tomar cualquier video, cambiar el idioma y lograr que la boca del hablante coincida perfectamente con el nuevo audio? Eso es exactamente lo que hace el lipsync con IA, y en menos de tres años ha pasado de ser una curiosidad de investigación a una herramienta de producción práctica.
Qué hace realmente el lipsync con IA
El lipsync con IA es el proceso de alinear automáticamente los movimientos visibles de los labios y la mandíbula de una persona en un video con una nueva pista de audio. El audio original puede estar en inglés y el audio nuevo en español, o el cambio puede ser de un hablante a otro por completo. En cualquier caso, la IA modifica la región facial de cada fotograma para que la boca parezca articular el nuevo discurso de forma natural.
Esto es distinto de los subtítulos, que solo añaden texto. También es distinto de la clonación de voz, que cambia únicamente el audio. El lipsync con IA cambia el propio video, haciendo que el rostro del hablante parezca decir palabras completamente nuevas.
Los mecanismos básicos
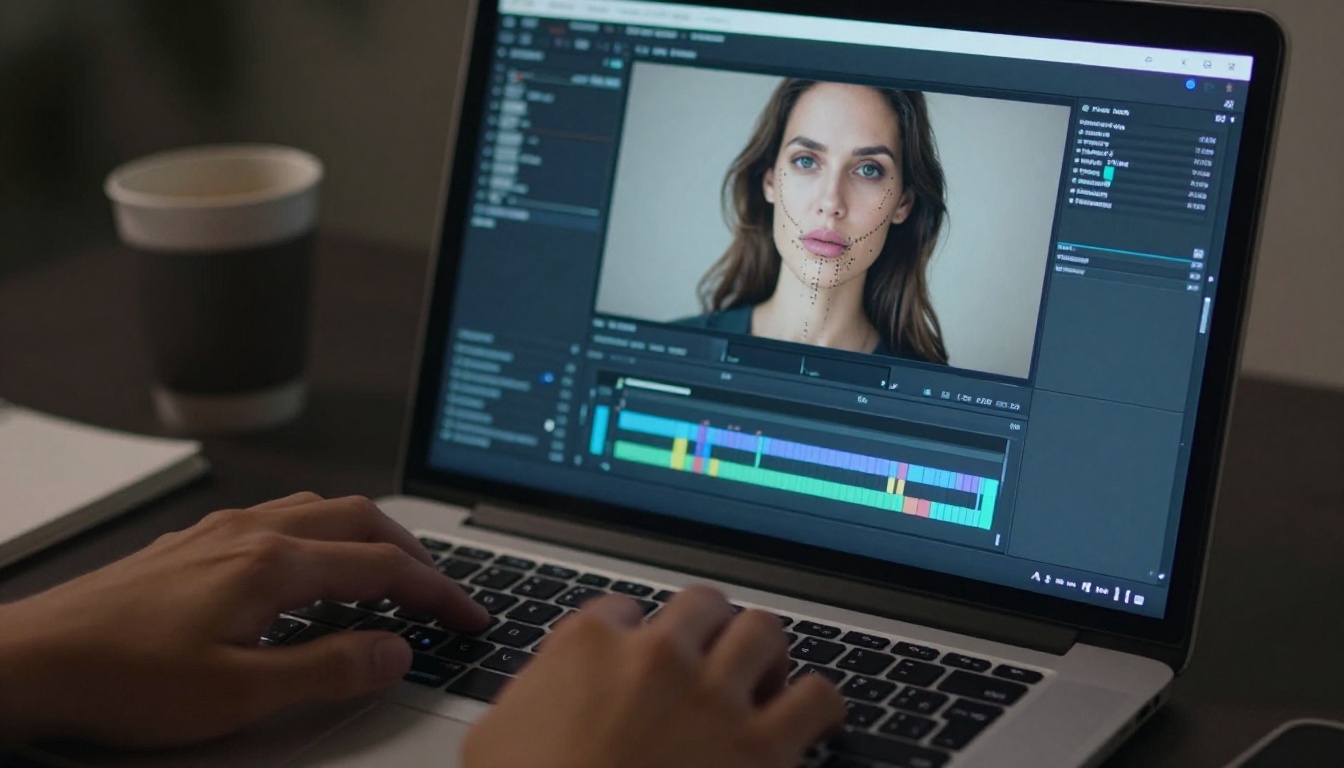
A nivel técnico, la mayoría de los sistemas de lipsync con IA funcionan en tres etapas. Primero, el modelo detecta el rostro y aísla la región de la boca mediante la detección de puntos de referencia faciales, mapeando decenas de puntos alrededor de los labios, la mandíbula y el mentón. Segundo, analiza el audio nuevo fonema por fonema, ya que cada fonema (la unidad más pequeña de sonido en el habla) produce una forma específica de boca llamada visema. Tercero, el modelo sintetiza nuevos fotogramas en los que la región de la boca coincide con la secuencia de visemas del audio, fusionando la geometría modificada de nuevo con el rostro y el fondo originales.
El resultado es un rostro que parece decir palabras nuevas, aunque el hablante original nunca las haya pronunciado.
Sincronización basada en audio frente a basada en texto
Hay dos enfoques principales en el lipsync con IA:
- Basada en audio: El modelo toma un archivo de audio y lo asigna directamente a visemas. No necesita conocer el idioma, solo los sonidos. Esto la hace flexible e independiente del idioma.
- Basada en texto: El modelo toma un guion de texto, genera el habla internamente mediante texto a voz y luego sincroniza la voz resultante con el video. Esto ofrece más control sobre el tiempo, pero requiere una salida de TTS de alta calidad.
La mayoría de las herramientas de producción actuales son basadas en audio, lo que significa que tú aportas tu locución y el modelo se encarga de la sincronización.
Por qué los resultados parecen reales ahora
Hace tres años, el lipsync con IA tenía una calidad de "cara de goma" inconfundible. La boca se movía, pero la fusión no era correcta, las transiciones resultaban bruscas y la mandíbula se movía de forma independiente a las mejillas. Hoy, la distancia entre el lipsync con IA y el ADR profesional (Automated Dialogue Replacement, la técnica tradicional del cine para regrabar diálogos en postproducción) se ha reducido de forma notable.
Aprendizaje profundo y mapeo facial
Los modelos actuales se entrenan con miles de horas de video emparejadas con transcripciones de audio. Esto les da un conocimiento amplio sobre cómo se mueven los rostros humanos al hablar: el ligero tensado de las comisuras de los labios antes de una consonante bilabial como "p" o "b", la proporción de apertura de la mandíbula para las vocales abiertas, la forma en que el mentón se mueve junto con el cuello. No solo animan los labios. Animan toda la parte inferior del rostro como un sistema coordinado.
Omni Human 1.5, desarrollado por ByteDance, lo demuestra bien. Genera animación de rostro completo a partir de una sola foto emparejada con una entrada de audio, con movimiento de cabeza temporalmente coherente y parpadeo natural junto con el movimiento de los labios.
La coherencia temporal importa
El problema más difícil del lipsync con IA no es lograr un buen fotograma, sino lograr 600 buenos fotogramas seguidos. Si la fusión es incluso ligeramente irregular entre fotogramas, el ojo humano lo detecta de inmediato por el aliasing temporal. El espectador no nota conscientemente qué está mal. Simplemente percibe que algo no encaja.
💡 Consejo: Los modelos que procesan el video en bloques temporales (no fotograma a fotograma) producen resultados más suaves, porque tienen en cuenta el movimiento entre fotogramas y no solo dentro de cada uno.
5 casos de uso en los que realmente funciona
El lipsync con IA no es la solución para todos los problemas de video. Pero en estas cinco situaciones, sí cumple.
Doblaje para audiencias globales
Este es el caso de uso de mayor valor por volumen. Un video explicativo de 20 minutos en inglés puede llegar a audiencias de habla hispana, portuguesa, francesa y alemana con versiones dobladas que parecen hechas por el hablante original en esos idiomas. Video Translate de HeyGen cubre más de 150 idiomas para este propósito, combinando la traducción y el lipsync en un único flujo de trabajo.
La economía es muy atractiva. El doblaje profesional con un estudio de localización puede costar entre 500 y 2000 dólares por idioma y por video. El doblaje con IA reduce ese costo variable a casi cero una vez configurado el flujo de trabajo.
| Método de doblaje | Costo por idioma | Tiempo de entrega |
|---|
| Estudio profesional | $500 a $2,000 | 5 a 15 días hábiles |
| Lipsync con IA (sin revisión) | $5 a $30 | Menos de 1 hora |
| Lipsync con IA (con revisión) | $50 a $200 | 1 a 2 días |
Crear avatares parlantes
No necesitas un video de una persona real para usar la tecnología de lipsync. Herramientas como P Video Avatar y Fabric 1.0 de Veed te permiten subir una imagen de retrato y animarla con cualquier audio que aportes. El resultado es un avatar parlante que puede representar a una marca, a un personaje de ficción o a un portavoz sintético, sin contratar a un actor ni reservar un estudio.
Esto resulta especialmente útil para:
- Explicaciones de producto que necesitan un rostro humano, pero no una persona real frente a la cámara
- Avatares de marca que pueden actualizarse con nuevos guiones a medida que cambia el mensaje
- Comunicaciones internas en las que se necesita un presentador coherente a gran escala en varias regiones
Omni Human se encarga de animar una sola foto con movimiento natural de cabeza y dinámica facial, lo que hace que el avatar parezca menos estático que con los enfoques más antiguos de animación de retratos.
Contenido para redes sociales a escala
Las redes sociales premian la constancia: publicaciones diarias, series semanales, formatos recurrentes. El cuello de botella para los creadores que aparecen frente a la cámara no es la falta de ideas, sino el tiempo de grabación. El lipsync con IA permite a un creador grabar una versión maestra de su contenido y volver a doblarla para distintos idiomas, distintos tonos o distintos segmentos de audiencia sin volver a rodar el material original.
Lipsync Speed de HeyGen está pensado para este caso de uso, y prioriza la velocidad de procesamiento sobre la máxima precisión para que los creadores puedan iterar rápido entre versiones.
💡 Consejo: En el contenido de formato corto de menos de 90 segundos, los modelos optimizados para la velocidad ofrecen resultados que, en la mayoría de los contextos de consumo en el feed, son indistinguibles de los modelos más lentos y de mayor precisión.
Videos de formación corporativa
Los equipos de formación y desarrollo corporativo producen enormes cantidades de video: formación en cumplimiento normativo, módulos de incorporación, novedades de producto. Estos videos suelen necesitar entregarse en varios idiomas regionales en equipos de todo el mundo. El lipsync con IA convierte una única grabación maestra en versiones localizadas sin tener que volver a reservar al presentador ni gestionar agendas de estudio que chocan entre sí.
Lipsync Precision de HeyGen se centra en la precisión por encima de la velocidad de procesamiento, lo que lo hace adecuado para contenido profesional de mayor duración, donde los errores de tiempo en un video de formación de 45 minutos serían costosos de identificar y corregir.
Correcciones en postproducción
Este es un caso de uso subestimado. Una actriz dice una línea. El audio de reemplazo, procedente de un ADR o de otra toma, está limpio, pero los movimientos de los labios en la imagen no coinciden. En la producción cinematográfica tradicional, eso significa cortar alrededor del plano o volver a llamar a la actriz. Con el lipsync con IA, el editor puede sincronizar el audio de reemplazo con el material existente directamente, conservando el plano que funcionaba visualmente y corrigiendo solo la capa de audio.
React 1 de Sync y Lipsync 2 de Sync están pensados para este flujo de edición de precisión, con controles detallados que permiten a los editores trabajar a nivel de fonema en lugar de adivinar la sincronización palabra por palabra.
Cuándo el lipsync con IA tiene dificultades
Saber dónde se rompe la tecnología es tan importante como saber dónde funciona.
Ángulos extremos de la cabeza
Los modelos de lipsync con IA se entrenan principalmente con rostros de frente o casi de frente. Cuando el sujeto está en un plano de tres cuartos, de perfil o mirando mucho hacia arriba o hacia abajo, la calidad de la síntesis de la boca cae de forma notable. El modelo tiene menos referencia geométrica para reconstruir la zona de la boca, y los artefactos de fusión se hacen visibles en el límite entre la mejilla y el mentón.
Si tu video corta con frecuencia a planos abiertos o de perfil durante el diálogo, el lipsync con IA no es la solución adecuada para esos planos. Aplícalo solo a la cobertura frontal de tu edición.
Video de origen de baja calidad
Los artefactos de compresión, el desenfoque por movimiento y la baja resolución degradan de forma notable el resultado del lipsync. El modelo necesita detectar y reconstruir con precisión la región de la boca fotograma a fotograma, y si el material original tiene menos de 720p o está muy comprimido, la calidad del resultado reflejará directamente esas limitaciones.
💡 Consejo: Trabaja siempre con el archivo de origen de mayor calidad disponible, idealmente de 1080p o más. Si tu origen es de baja calidad, pásalo primero por un modelo de superresolución antes de aplicar el lipsync.
Cómo usar el lipsync en PicassoIA
Como hay varios modelos de lipsync disponibles en la plataforma, el flujo de trabajo es sencillo una vez que sabes qué modelo encaja con tu caso de uso.
Elegir el modelo adecuado
Usa este esquema rápido de decisión:
Paso a paso con Lipsync 2 Pro
Lipsync 2 Pro de Sync es el modelo de lipsync de uso general más preciso de la plataforma. Así se usa, paso a paso:
- Prepara tu video: Usa un plano frontal limpio y bien iluminado, de 1080p o más. Si es posible, elimina la música de fondo de la pista de audio original para que la detección del rostro no se vea confundida por las frecuencias del habla original.
- Prepara tu audio: Graba o genera el audio de reemplazo a 44,1 kHz o 48 kHz. Es preferible el formato WAV frente a MP3, para conservar todo el rango de frecuencias que el modelo usa en la detección de fonemas.
- Sube el material a Lipsync 2 Pro: Ve a Lipsync 2 Pro en la plataforma. Sube tu archivo de video y tu archivo de audio en los campos de entrada correspondientes.
- Configura el modo de sincronización: Elige entre la sincronización "ajustada" (prioriza la coincidencia exacta de fonemas, puede mostrar cierta rigidez facial en el habla rápida) o la "natural" (prioriza una animación suave, con una pequeña variación de tiempo aceptable para la mayoría de los contenidos).
- Revisa el resultado: Mira primero la salida a velocidad normal y después avanza fotograma a fotograma por las secciones fonéticamente complejas (sibilantes y oclusivas), donde es más probable que aparezcan artefactos.
- Itera en las secciones problemáticas: Si el resultado tiene artefactos en palabras concretas, recorta el audio en esos puntos, vuelve a grabar solo esas palabras y vuelve a ejecutar el modelo solo en ese segmento del clip.
Los mejores modelos de un vistazo
5 consejos para mejores resultados
Obtener un buen resultado con el lipsync con IA depende en parte del modelo y, sobre todo, de los materiales de entrada. Estas cinco prácticas marcan una diferencia medible:
-
Estabiliza el rostro en el video original. Si la cámara va en mano y el rostro se desplaza por el encuadre, el modelo tiene que volver a detectar los puntos de referencia en cada fotograma de forma independiente. Un plano estabilizado y fijo da al modelo una geometría constante y produce una fusión más limpia en el límite de la boca.
-
Iguala el volumen del audio con el original. Si el audio de reemplazo es notablemente más alto o más bajo que el ruido ambiente del video original, el cerebro del espectador detecta la diferencia aunque los labios se vean bien. Normaliza el audio de reemplazo al volumen de la pista original (medido en LUFS) antes de sincronizar.
-
Usa grabaciones con dicción clara. El habla farfullada, muy comprimida o con mucho acento genera más ambigüedad de visemas para el modelo. Un habla bien articulada y con una distancia constante al micrófono da a la detección de fonemas una entrada más fiable.
-
Vigila los artefactos de parpadeo. Los parpadeos largos que ocurren a mitad de una palabra pueden hacer que el modelo genere una combinación parcial de parpadeo y movimiento de boca que resulta poco natural. Si lo ves en el resultado, recorta unos cuantos fotogramas alrededor del parpadeo y vuelve a ejecutar ese segmento de forma aislada.
-
Recorta los silencios del audio de reemplazo. Si el audio de reemplazo tiene pausas largas, el modelo puede generar una postura de boca inactiva que se ve ligeramente "congelada". Recorta los silencios para que coincidan con el ritmo natural de respiración del hablante original que se ve en el material.
Crea algo nuevo ahora mismo
El lipsync con IA ha cruzado el umbral que va de la demo impresionante a la herramienta lista para producción. Tanto si estás localizando contenido para tres mercados nuevos, creando un avatar parlante para tu marca o corrigiendo una línea en postproducción que te ha estado dando problemas durante una semana, el flujo de trabajo ya es accesible sin software especializado ni conocimientos técnicos avanzados.
Los modelos disponibles en PicassoIA cubren todos los casos de uso principales, desde Lipsync Speed para contenido rápido en redes sociales hasta Lipsync 2 Pro para trabajo profesional de precisión. Puedes empezar con un video que ya tienes y una locución grabada en tu teléfono, y tener un resultado sincronizado en minutos.
La mejor forma de ver lo que pueden hacer estas herramientas es probarlas con tu propio material. Elige un modelo que encaje con tu caso de uso, sube un clip y mira cómo queda el resultado. El costo de iterar es bajo. El beneficio, si encaja en tu flujo de trabajo, es significativo.


