La mayoría de los generadores de imágenes con IA ignoran tu foto de referencia en cuanto pulsas generar. Flux Kontext hace justo lo contrario. Trata esa imagen de referencia como un ancla estructural, toma la identidad, el estilo y la composición directamente de tu foto subida y los integra en el resultado. El resultado es algo que los prompts de texto por sí solos nunca han logrado: una coherencia visual real entre escenas, condiciones de luz y contextos distintos.
Qué es realmente Flux Kontext
Flux Kontext es una familia de modelos de generación de imágenes con IA desarrollada por Black Forest Labs, el equipo detrás de la arquitectura original de FLUX.1. Lanzado en 2025, Kontext se creó específicamente para resolver uno de los problemas más difíciles de la generación de imágenes con IA: mantener un sujeto, un personaje o un estilo visual coherente a lo largo de varias imágenes generadas.
Los modelos tradicionales de texto a imagen tratan cada generación como una hoja en blanco. Escribes un prompt, el modelo inventa una imagen y el personaje u objeto que apareció en tu resultado anterior no tiene ninguna influencia directa en el siguiente. Kontext rompe ese patrón al aceptar una o varias imágenes de referencia como entrada y condiciona la generación a lo que ve en ellas.
El problema para el que se creó
Cualquiera que haya intentado crear un personaje coherente para un cómic, una campaña de marca o una serie en redes sociales conoce la frustración. Generas un retrato precioso a la primera y luego pasas horas ajustando prompts para conseguir esa misma cara con otra ropa o en otro escenario. La cara cambia. El pelo cambia. Toda la identidad se desvía.
💡 Kontext se diseñó para exactamente este escenario. Le das tu imagen de referencia una vez y mantiene esa identidad visual en cada nueva generación, sin importar lo distinta que sea la nueva escena.
Esto no se limita a los personajes. La fotografía de producto, los renders de arquitectura, las sesiones de moda y cualquier flujo creativo que exija coherencia visual entre varios resultados se beneficia directamente del condicionamiento por imagen de referencia. El problema siempre ha sido que el lenguaje es un vehículo impreciso para describir una identidad visual. "Pelo castaño, pómulos altos, ojos almendrados" está muy poco especificado comparado con enseñarle al modelo una fotografía.
Quién lo creó y cuándo
Black Forest Labs lanzó la familia Kontext junto a su línea FLUX.1 existente a principios de 2025. Los modelos se entrenaron con grandes conjuntos de datos de imágenes emparejadas, lo que enseñó a la arquitectura a extraer y conservar atributos visuales concretos de las referencias y, a la vez, a responder con flexibilidad a las instrucciones del prompt de texto. Esta doble condición, texto más imagen, es lo que separa a Kontext de las herramientas simples de imagen a imagen, que solo mezclan tu entrada con un prompt nuevo. Kontext lee la referencia. No se limita a copiarla.
Cómo funciona la generación con imágenes de referencia
Los mecanismos de Kontext difieren de forma notable de la generación de imagen a imagen estándar. Entender la diferencia te ayuda a usarlo con más intención y a conseguir mejores resultados desde la primera generación.
Condicionamiento por imagen frente a prompts de texto
En un modelo estándar de texto a imagen, tu prompt es la única instrucción. El modelo interpreta las palabras y las asocia con conceptos visuales aprendidos durante el entrenamiento. En Kontext, tu imagen de referencia se convierte en un segundo canal de instrucciones que corre en paralelo con tu prompt de texto.
El modelo codifica tu imagen de referencia en una representación latente, es decir, la comprime en un resumen matemático denso de lo que contiene: geometría facial, paleta de colores, condiciones de luz, patrones de textura y cualidades estilísticas. Esta codificación se introduce en el proceso de generación junto con tus tokens de texto.
El efecto práctico: cuando escribes "pon a este personaje en una calle lluviosa de Tokio por la noche", el modelo ya tiene una representación interna detallada de quién es ese personaje. No tiene que adivinar. Usa la codificación de la referencia para mantener la identidad visual del personaje mientras responde a la descripción de tu nueva escena.
Qué ve el modelo cuando subes una referencia
Kontext no hace un simple copiar y pegar. No extrae píxeles de tu referencia para estamparlos en el resultado. En cambio, genera una imagen nueva que captura la esencia del original mientras responde a un contexto distinto.
Esta distinción importa porque los resultados se perciben coherentes y no como composiciones mal hechas. Piensa en qué cambia y qué se mantiene fijo:
- La iluminación se adapta automáticamente al contexto de la nueva escena
- La pose y la composición cambian según las instrucciones de tu prompt
- Los rasgos faciales y la identidad se mantienen incluso con distintos ángulos y expresiones
- La ropa y los accesorios se pueden cambiar mientras el rostro y la complexión se conservan en todas las generaciones
- El estilo y la estética pueden trasladarse a sujetos completamente nuevos si lo deseas
El modelo lee el significado de tu referencia, no copia píxeles. Por eso los resultados pueden mostrar al mismo personaje riendo en una cafetería y serio en un bosque, manteniendo la identidad en estados emocionales y entornos completamente distintos.
Por qué el texto solo no sirve para la coherencia
Describir un rostro con texto implica perder información. El lenguaje natural simplemente no tiene el vocabulario para captar las proporciones exactas, el tono preciso de los ojos de alguien o la manera concreta en que se disponen sus rasgos. "Pómulos altos" podría describir mil rostros distintos. Una fotografía de un rostro concreto describe exactamente uno.
Esta es la idea central de la generación con imágenes de referencia: la información visual es más densa que el texto. Una sola imagen de retrato contiene más información de identidad de la que jamás podría contener un párrafo descriptivo. Kontext está diseñado para aprovechar esa densidad y usarla como una restricción precisa del proceso de generación.
Entrada de una o de varias imágenes
Flux Kontext Max va un paso más allá al aceptar varias imágenes de referencia a la vez. Esto abre flujos de trabajo que antes simplemente no eran posibles:
- Sube dos fotos de retrato y pide al modelo que combine sus elementos visuales en un rostro nuevo
- Aporta una foto de personaje y una foto de fondo y pide un compuesto coherente con la escena
- Proporciona tres referencias de vestuario y genera un look nuevo que mezcle elementos de diseño de cada una
El condicionamiento con varias imágenes es especialmente potente para directores creativos, desarrolladores de videojuegos y equipos de marca que necesitan sintetizar referencias de varias fuentes en un único resultado coherente.
Flux Kontext Dev frente a Pro, Max y Fast
La familia Kontext incluye cuatro modelos, cada uno pensado para distintos casos de uso y con sus propias contrapartidas entre velocidad, calidad y flexibilidad.
Flux Kontext Fast omite parte del procesamiento de calidad para generar más rápido. Si estás probando prompts o ajustando la composición, aquí es donde empiezas. La ventaja de velocidad es lo bastante grande como para que hacer cinco generaciones Fast de exploración antes de confirmar un render Pro sea, de verdad, el flujo de trabajo más inteligente.
Flux Kontext Dev es la versión de pesos abiertos, lo que significa que sus pesos están disponibles públicamente para investigación y experimentación. Produce resultados de alta calidad con una fidelidad a la referencia notable y es ideal para desarrolladores que crean sobre la arquitectura Kontext. Si quieres personalizar el comportamiento de Kontext mediante ajuste fino, Flux Kontext Dev LoRA te permite entrenar adaptadores ligeros sobre el modelo base Dev para lograr coherencia específica de un dominio.
Flux Kontext Pro es el modelo de calidad comercial. Ofrece el mejor equilibrio entre fidelidad a la referencia, calidad de salida y respuesta al prompt. Para la mayoría de los flujos de trabajo profesionales, es la opción adecuada.
Flux Kontext Max es el modelo insignia, diseñado para la máxima calidad y el condicionamiento con varias imágenes. Cuando necesitas fusionar dos o más referencias o la coherencia más alta posible, Max es el modelo que buscas.
Qué puedes hacer con una imagen de referencia
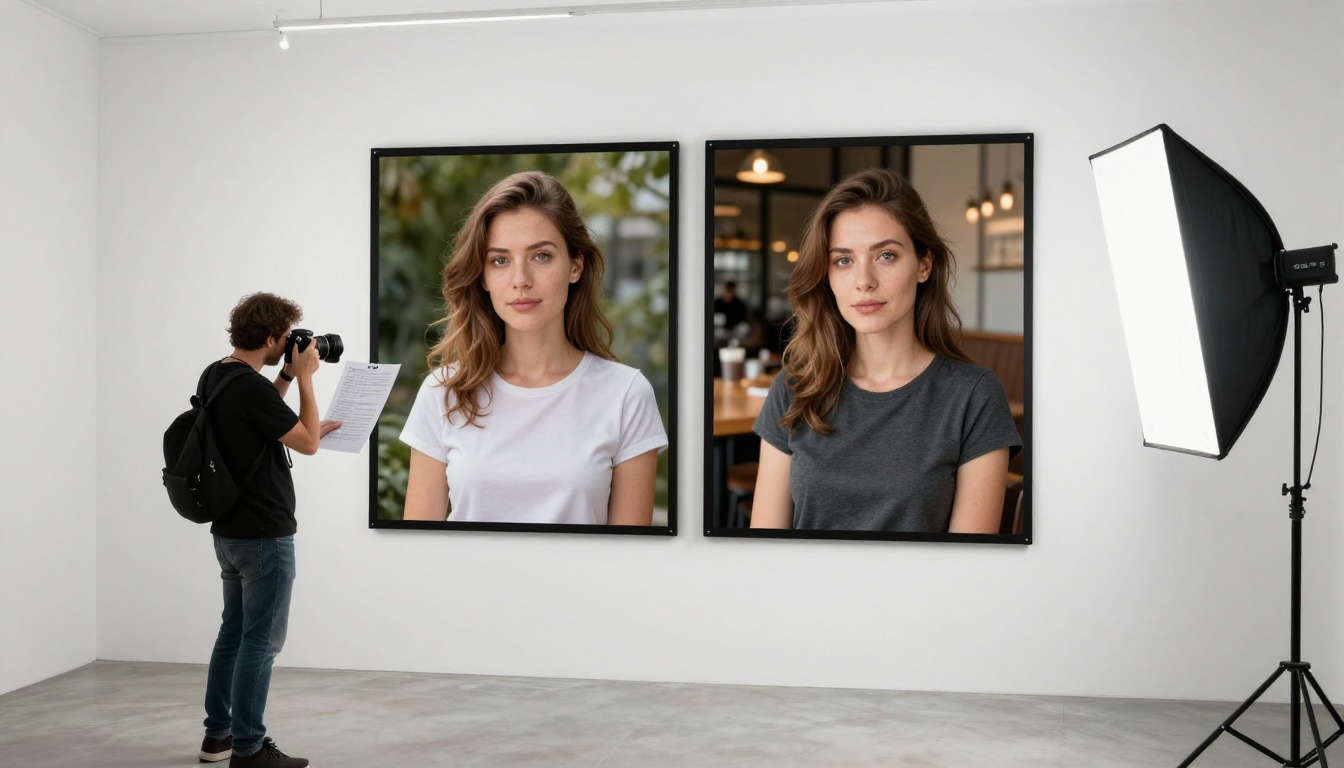
La gama de aplicaciones es más amplia de lo que la mayoría espera al principio. Estas son las cuatro categorías en las que la generación con imágenes de referencia aporta el valor más evidente.
Coherencia de personajes entre escenas
Este es el caso de uso más común. Tienes un personaje, real o imaginado, y necesitas que aparezca en varios escenarios sin dejar de parecerse a sí mismo. Con Flux Kontext Pro, subes un único retrato y pides distintas escenas:
- El personaje en un paisaje de montaña nevado
- El mismo personaje en una cafetería italiana bañada por el sol
- El mismo personaje en un callejón urbano oscuro de noche
En los tres resultados, el rostro, la estructura ósea, el color del pelo y la identidad general se mantienen fijos. Solo se adaptan el entorno y la iluminación.
Transferencia de estilo sin perder la identidad
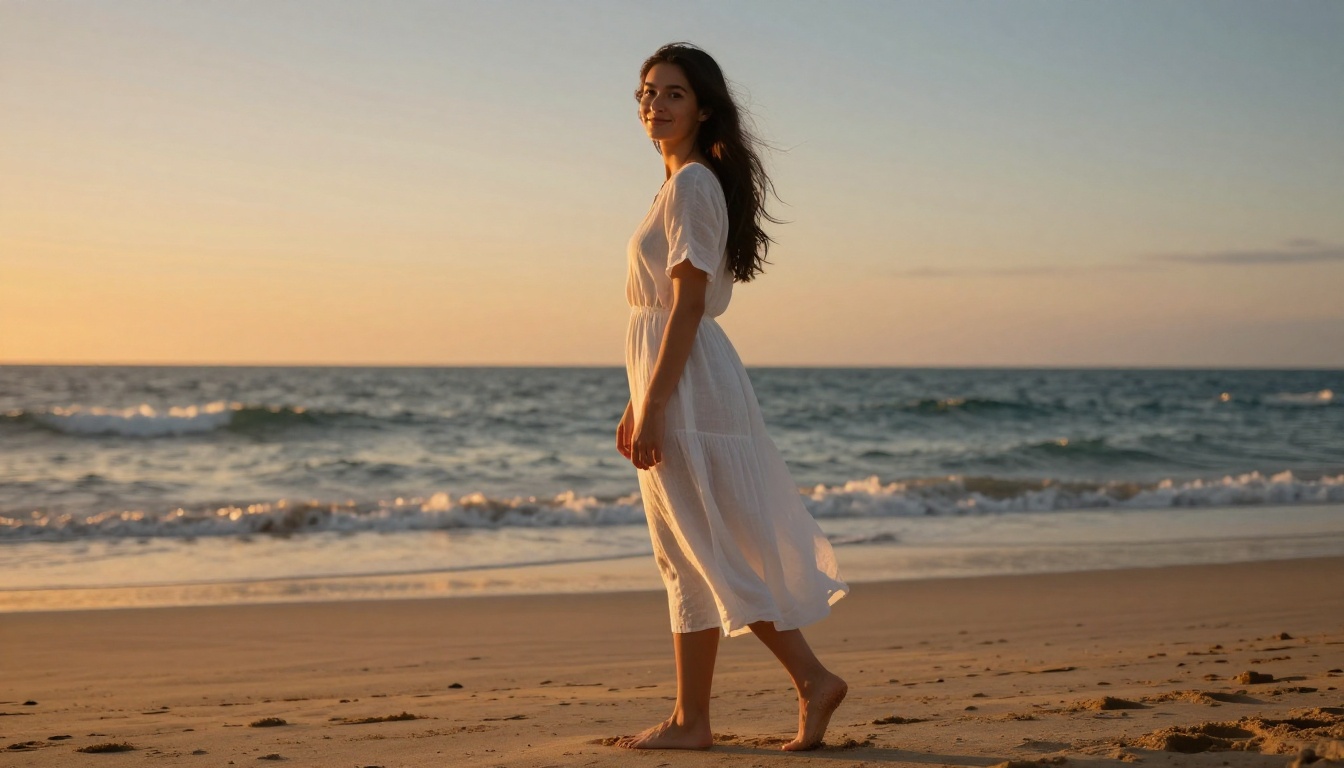
Kontext puede tomar la firma estilística de una imagen de referencia y aplicarla a contenido nuevo. Si subes una foto con una gradación de color, un aspecto de película o un enfoque compositivo concretos, el modelo puede generar imágenes nuevas que compartan esa estética y sean completamente originales en su contenido.
Esto es especialmente valioso para los fotógrafos de marca que han establecido un lenguaje visual y quieren generar contenido adicional que encaje con su portafolio existente sin volver a fotografiar.
💡 Para la transferencia de estilo, usa tu referencia sobre todo por sus cualidades estéticas y describe con detalle el nuevo contenido en tu prompt de texto. El modelo aplicará la gramática visual de tu referencia a la nueva escena descrita.
Tomas de objetos y productos
Los fotógrafos de producto pueden subir una toma de referencia de su producto y pedir nuevos fondos, escenarios de puesta en escena o contextos de estilo de vida. El producto se mantiene fotorrealista y coherente mientras el entorno cambia por completo. No hace falta repetir la sesión de fotos en exteriores.
Una sola toma de estudio limpia de un frasco de perfume se convierte en el frasco sobre una encimera de mármol en un baño al amanecer, luego en un claro del bosque con niebla matinal y después en una bandeja de hotel de lujo con flores frescas. Todo a partir de una imagen de referencia.
Series de retratos y generación para campañas
Flux Kontext Max facilita mucho generar series de retratos. Sube un primer plano y un tablero de inspiración con las estéticas deseadas, y genera una serie completa de retratos con una identidad de sujeto coherente en distintos looks. Para campañas publicitarias, contenido de marca o trabajos editoriales en los que hacer varias sesiones resulta prohibitivo, este flujo supone un cambio importante en lo que se puede conseguir.
Cómo usar Flux Kontext en PicassoIA
Los cuatro modelos Kontext están disponibles directamente en PicassoIA, listos para usar sin ninguna configuración local ni de API.
Paso a paso con Flux Kontext Pro
- Ve a Flux Kontext Pro en PicassoIA
- Sube tu imagen de referencia usando el campo de entrada de imagen. Usa la foto más nítida y de mayor resolución que tengas. Evita las imágenes muy filtradas o demasiado comprimidas.
- Escribe tu prompt describiendo la nueva escena o contexto. Sé específico con la iluminación, el entorno, el ambiente y los detalles estilísticos. No vuelvas a describir al sujeto: el modelo se encarga de eso a partir de la referencia.
- Fija la relación de aspecto según el uso previsto. 16:9 para contenido en redes sociales y web, 1:1 para perfiles y tomas de producto, 9:16 para formatos verticales.
- Lanza la generación y revisa el resultado. Ajusta tu prompt de texto para refinar los elementos de la escena sin tocar tu imagen de referencia.
Para flujos con varias imágenes, cambia a Flux Kontext Max y sube tus imágenes de referencia adicionales con la opción de entrada múltiple.
Consejos que de verdad funcionan
Estos ajustes son los que separan los resultados mediocres de los profesionales:
- Usa imágenes de referencia de alta resolución. Un mínimo de 1024x1024. El modelo necesita detalle con el que trabajar.
- Los retratos de frente funcionan mejor para la coherencia de personajes. Los perfiles le dan al modelo menos en lo que apoyarse.
- Sé específico en tu prompt de texto sobre lo que cambia. "En el interior de una cabaña alpina de invierno, luz cálida de chimenea, nieve visible por la ventana" le indica al modelo exactamente qué construir alrededor del sujeto conservado.
- Evita describir la apariencia del sujeto en el prompt. Si tu referencia muestra a una mujer de pelo oscuro, no describas el color del pelo en tu prompt. Las descripciones extra del sujeto crean instrucciones contradictorias.
- Para la transferencia de estilo, quita de la referencia los sujetos concretos. Usa una foto de paisaje o de arquitectura con la estética que quieres y describe un sujeto nuevo en el prompt. El modelo aplica el estilo de la referencia al contenido nuevo que genera.
- Empieza con Flux Kontext Fast para iterar el prompt y pasa a Pro o Max cuando estés satisfecho con la composición y la escena.
Errores comunes que perjudican los resultados
Sobrecargar el prompt
Cuando usas imágenes de referencia, cambia la función de tu prompt de texto. Ya no describes la imagen completa. Describes qué es nuevo en esta generación. Trata el prompt como instrucciones para el entorno, el ambiente y el contexto, no para el sujeto.
Describir demasiado al sujeto crea conflictos de prompt en los que el modelo intenta satisfacer a la vez la codificación de la referencia y tu descripción de texto, lo que produce resultados en los que ninguna de las dos gana del todo.
Prompt sobrecargado con referencia: "Una mujer hermosa de pelo rizado y oscuro, ojos castaños, piel aceitunada, con un blazer gris marengo, en un bosque al atardecer con luz dorada"
Prompt mejor con la misma referencia: "Bosque al atardecer, luz dorada y cálida, niebla baja sobre el suelo, pájaros al fondo"
Deja que la referencia cargue con el sujeto. Usa el prompt para pintar el mundo que lo rodea.
Usar imágenes de referencia de baja calidad
El modelo solo puede extraer lo que hay en la imagen. Una referencia pequeña, comprimida o muy filtrada le da al proceso de condicionamiento menos con qué trabajar, lo que se traduce en una conservación de la identidad más débil. Las referencias borrosas, a contraluz o tomadas desde ángulos extremos dificultan mantener la coherencia entre generaciones.
Para mejores resultados: iluminación limpia, ángulo directo, enfoque nítido, resolución mínima de 1024 px.
Ignorar las diferencias entre modelos
Usar Flux Kontext Max en cada tarea con una sola referencia desperdicia tiempo de generación. Usa Flux Kontext Fast para probar prompts, Flux Kontext Pro para el trabajo de producción con una sola referencia y Max solo cuando de verdad necesites condicionamiento con varias imágenes o la máxima fidelidad absoluta. La diferencia de rendimiento entre Fast y Pro en una tarea con una sola referencia suele ser mínima. Ajustar el modelo adecuado a cada tarea hace tu flujo de trabajo más rápido sin sacrificar la calidad del resultado.
Empieza a generar en PicassoIA
La generación con imágenes de referencia es una de esas capacidades que cobran mucho más sentido cuando la ves funcionar con tus propias imágenes. Las descripciones textuales de lo que hace Kontext solo llegan hasta cierto punto.
PicassoIA te da acceso a los cuatro modelos Kontext, Fast, Dev, Pro y Max, sin necesidad de configurar una API, instalar dependencias ni usar hardware local. Puedes subir un retrato que ya tengas y empezar a probar la coherencia de personajes en cuestión de minutos.
Si quieres una personalización más profunda, Flux Kontext Dev LoRA te permite hacer un ajuste fino del modelo base Dev con tu propio conjunto de datos, que es el camino hacia una coherencia propia para flujos comerciales en los que los resultados estándar no son lo bastante precisos.
El punto de partida más sencillo: toma una foto de retrato clara, ve a Flux Kontext Pro en PicassoIA y pide una escena completamente distinta. Mira cuánta identidad se traslada. Ese primer resultado suele hacer que todo el concepto encaje de inmediato y, a partir de ahí, los casos de uso se multiplican rápido.