La plupart des générateurs d’images par IA ignorent votre photo de référence dès que vous cliquez sur générer. Flux Kontext fait l’inverse. Il traite cette image de référence comme un point d’ancrage structurel, en reprenant directement l’identité, le style et la composition de votre photo importée pour les intégrer au résultat. Le résultat offre ce que les prompts textuels seuls n’ont jamais pu fournir : une véritable cohérence visuelle d’une scène, d’un éclairage et d’un contexte à l’autre.
Ce qu’est vraiment Flux Kontext
Flux Kontext est une famille de modèles de génération d’images par IA développée par Black Forest Labs, l’équipe à l’origine de l’architecture FLUX.1. Lancé en 2025, Kontext a été conçu pour résoudre l’un des problèmes les plus ardus de la génération d’images par IA : garder un sujet, un personnage ou un style visuel cohérent sur plusieurs images générées.
Les modèles texte vers image traditionnels traitent chaque génération comme une page blanche. Vous saisissez un prompt, le modèle invente une image, et le personnage ou l’objet apparu dans votre résultat précédent n’a aucune influence directe sur le suivant. Kontext rompt avec ce schéma : il accepte une ou plusieurs images de référence en entrée, puis conditionne la génération à ce qu’il voit sur ces images.
Le problème qu’il a été conçu pour résoudre
Quiconque a essayé de construire un personnage cohérent pour une bande dessinée, une campagne de marque ou une série sur les réseaux sociaux connaît cette frustration. Vous générez un beau portrait du premier coup, puis passez des heures à modifier vos prompts pour obtenir le même visage dans une autre tenue ou un autre décor. Le visage change. Les cheveux changent. Toute l’identité dérive.
💡 Kontext a été conçu précisément pour ce scénario. Fournissez-lui votre image de référence une seule fois, et il reporte cette identité visuelle sur chaque nouvelle génération, quelle que soit la différence avec la nouvelle scène.
Cela ne concerne pas uniquement les personnages. La photographie produit, les rendus architecturaux, les shootings de mode et tout flux de travail créatif exigeant une cohérence visuelle entre plusieurs résultats profitent directement du conditionnement par image de référence. Le problème a toujours été que le langage est un moyen imprécis pour décrire une identité visuelle. « Cheveux bruns, pommettes hautes, yeux en amande » est très insuffisant comparé à la présentation d’une photographie au modèle.
Qui l’a créé et quand
Black Forest Labs a lancé la famille Kontext aux côtés de sa gamme FLUX.1 existante au début de 2025. Les modèles ont été entraînés sur de grands jeux de données d’images appariées, pour apprendre à l’architecture à extraire et préserver des attributs visuels précis à partir des entrées de référence, tout en répondant avec souplesse aux instructions du prompt textuel. Ce double conditionnement, texte et image, est ce qui distingue Kontext des outils d’image vers image simples, qui se contentent de mélanger votre entrée avec un nouveau prompt. Kontext lit la référence. Il ne se contente pas de la copier.
Les mécanismes de Kontext diffèrent nettement de la génération classique d’image vers image. Comprendre cette différence vous aide à l’utiliser de façon plus réfléchie et à obtenir de meilleurs résultats dès la première génération.
Conditionnement par image ou prompts textuels
Dans un modèle texte vers image standard, votre prompt est la seule instruction. Le modèle interprète les mots et les associe à des concepts visuels appris pendant l’entraînement. Dans Kontext, votre image de référence devient un second canal d’instruction, fonctionnant en parallèle de votre prompt textuel.
Le modèle encode votre image de référence dans une représentation latente, en la compressant en un résumé mathématique dense de son contenu : géométrie du visage, palette de couleurs, conditions d’éclairage, motifs de texture et qualités stylistiques. Cet encodage est transmis au processus de génération en même temps que vos tokens textuels.
En pratique, lorsque vous saisissez « place ce personnage dans une rue de Tokyo sous la pluie, la nuit », le modèle dispose déjà d’une représentation interne riche de l’identité de ce personnage. Il n’a pas à deviner. Il s’appuie sur l’encodage de la référence pour conserver l’identité visuelle du personnage tout en répondant à votre nouvelle description de scène.
Ce que voit le modèle lorsque vous importez une référence
Kontext ne fait pas de simple copier-coller. Il n’extrait pas les pixels de votre référence pour les plaquer sur le résultat. Il génère plutôt une nouvelle image qui capture l’essence de l’original tout en répondant au nouveau contexte.
Cette distinction est importante, car les résultats paraissent cohérents au lieu de montages maladroits. Voici ce qui change et ce qui reste fixe :
- L’éclairage s’adapte automatiquement au nouveau contexte de la scène
- La pose et la composition changent selon les instructions de votre prompt
- Les traits du visage et l’identité restent cohérents, même selon des angles et des expressions différents
- Les vêtements et les accessoires peuvent être remplacés tandis que le visage et la morphologie persistent d’une génération à l’autre
- Le style et l’esthétique peuvent être transférés à des sujets entièrement nouveaux, si vous le souhaitez
Le modèle lit le sens de votre référence, il ne copie pas les pixels. C’est pourquoi les résultats peuvent montrer le même personnage riant dans un café et sérieux dans une forêt, en conservant son identité malgré des états émotionnels et des contextes environnementaux totalement différents.
Pourquoi le texte seul ne suffit pas à assurer la cohérence
Décrire un visage par écrit entraîne forcément une perte d’information. Le langage naturel ne dispose pas du vocabulaire nécessaire pour capturer les proportions précises, la nuance exacte des yeux d’une personne ou la disposition exacte de ses traits. « Pommettes hautes » peut décrire des milliers de visages différents. Une photographie d’un visage précis, elle, n’en décrit qu’un seul.
C’est le principe central de la génération à partir d’une image de référence : l’information visuelle est plus dense que le texte. Une seule image de portrait contient plus d’informations d’identité qu’un paragraphe de texte descriptif ne pourra jamais en contenir. Kontext est conçu pour exploiter cette densité, en s’en servant comme d’une contrainte précise sur le processus de génération.
Entrée à une image ou à plusieurs images
Flux Kontext Max va plus loin en acceptant simultanément plusieurs images de référence. Cela ouvre des flux de travail qui n’étaient tout simplement pas possibles auparavant :
- Fournissez deux photos de portrait et demandez au modèle de fusionner leurs éléments visuels en un nouveau visage
- Fournissez une photo de personnage et une photo d’arrière-plan, et demandez un montage cohérent avec la scène
- Fournissez trois références de tenues et générez un nouveau look qui combine des éléments de design issus de chacune
Le conditionnement multi-images est particulièrement puissant pour les directeurs artistiques, les développeurs de jeux et les équipes de marque qui doivent synthétiser des références provenant de sources multiples en un seul résultat cohérent.
Flux Kontext Dev, Pro, Max ou Fast
La famille Kontext comprend quatre modèles, chacun ciblant des cas d’usage différents et offrant des compromis distincts entre vitesse, qualité et souplesse.
Flux Kontext Fast renonce à une partie du traitement qualitatif pour une génération rapide. Si vous testez des prompts ou ajustez une composition, c’est par ici qu’il faut commencer. L’avantage en vitesse est suffisamment net pour que lancer cinq générations Fast pour explorer avant de générer un rendu Pro soit franchement le flux de travail le plus judicieux.
Flux Kontext Dev est la version à poids ouverts, ce qui signifie que ses poids sont publiquement disponibles pour la recherche et l’expérimentation. Il produit des résultats de haute qualité, avec une bonne fidélité à la référence, et convient parfaitement aux développeurs qui créent sur l’architecture Kontext. Si vous souhaitez personnaliser le comportement de Kontext par le fine-tuning, Flux Kontext Dev LoRA vous permet d’entraîner de légers adaptateurs sur le modèle Dev de base, pour une cohérence adaptée à un domaine précis.
Flux Kontext Pro est le modèle de qualité commerciale. Il offre le meilleur équilibre entre fidélité à la référence, qualité de rendu et réactivité aux prompts. Pour la plupart des flux de travail professionnels, c’est le bon choix.
Flux Kontext Max est le modèle phare, conçu pour une qualité maximale et un conditionnement multi-images. Lorsque vous devez fusionner deux références ou plus, ou obtenir la cohérence la plus élevée possible, Max est le modèle à choisir.
Ce que vous pouvez faire avec une image de référence
La gamme des applications est plus large que ce que la plupart des gens imaginent au départ. Voici les quatre catégories dans lesquelles la génération à partir d’une image de référence apporte la valeur la plus évidente.
Cohérence des personnages d’une scène à l’autre
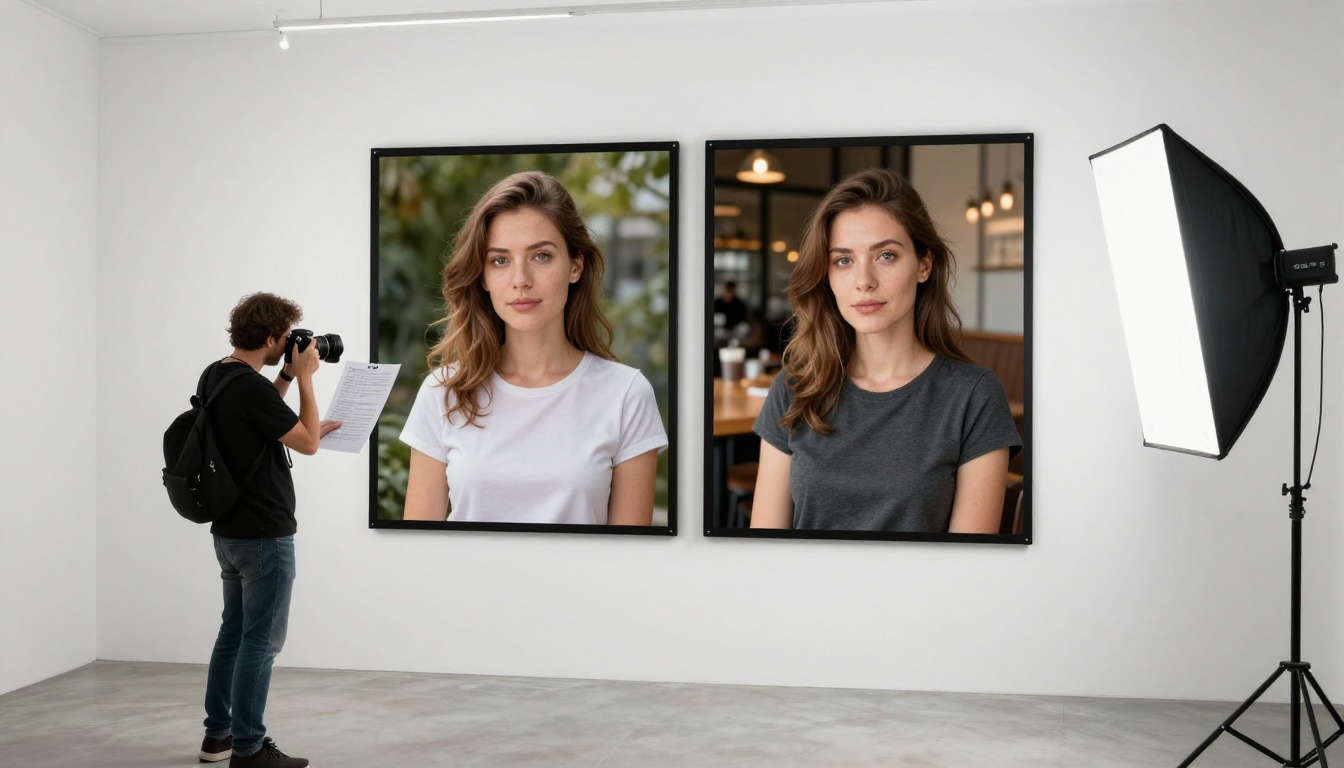
C’est le cas d’usage le plus courant. Vous avez un personnage, réel ou imaginaire, et vous voulez le faire apparaître dans plusieurs situations tout en lui gardant son apparence. Avec Flux Kontext Pro, vous importez un seul portrait et vous demandez différentes scènes :
- Le personnage dans un paysage de montagne en hiver
- Le même personnage dans un café italien baigné de soleil
- Le même personnage dans une ruelle urbaine sombre, la nuit
Dans les trois résultats, le visage, la structure osseuse, la couleur des cheveux et l’identité d’ensemble restent verrouillés. Seuls le décor et l’éclairage s’adaptent.
Transfert de style sans perdre l’identité
Kontext peut reprendre la signature stylistique d’une image de référence et l’appliquer à un nouveau contenu. Si vous importez une photo présentant un étalonnage colorimétrique, un rendu de film ou une approche de composition particulière, le modèle peut générer de nouvelles images qui partagent cette esthétique tout en étant entièrement originales quant au contenu.
C’est particulièrement utile pour les photographes de marque qui ont défini un langage visuel et veulent générer du contenu supplémentaire conforme à leur portfolio existant, sans refaire de séance.
💡 Pour le transfert de style, utilisez votre référence surtout pour ses qualités esthétiques, et décrivez pleinement le nouveau contenu dans votre prompt textuel. Le modèle appliquera la grammaire visuelle de votre référence à la scène nouvellement décrite.
Photos d’objets et de produits
Les photographes de produits peuvent importer une photo de référence de leur article et demander de nouveaux arrière-plans, des mises en scène ou des contextes de style de vie. Le produit reste photoréaliste et cohérent, tandis que l’environnement change complètement. Plus besoin de refaire une prise de vue sur place.
Une seule photo de studio épurée d’un flacon de parfum devient le flacon posé sur un plan de toilette en marbre à l’aube, puis dans une clairière de forêt dans la brume matinale, puis sur un plateau d’hôtel de luxe avec des fleurs fraîches. Le tout à partir d’une seule image de référence.
Séries de portraits et génération de campagnes
Flux Kontext Max rend la génération de séries de portraits simple. Importez un portrait et une planche d’inspiration des esthétiques souhaitées, puis générez une série complète de portraits avec une identité de sujet cohérente à travers différents looks stylisés. Pour les campagnes publicitaires, le contenu de marque ou les séries éditoriales où multiplier les séances de prise de vue coûte trop cher, ce flux de travail représente un changement significatif dans ce qui est réalisable.
Les quatre modèles Kontext sont disponibles directement sur PicassoIA, prêts à l’emploi, sans installation locale ni configuration d’API.
Étape par étape avec Flux Kontext Pro
- Rendez-vous sur Flux Kontext Pro sur PicassoIA
- Importez votre image de référence via le champ de saisie d’image. Utilisez la photo la plus nette et la plus haute résolution dont vous disposez. Évitez les images très filtrées ou trop compressées.
- Rédigez votre prompt en décrivant la nouvelle scène ou le nouveau contexte. Soyez précis sur l’éclairage, l’environnement, l’ambiance et les détails stylistiques. Ne redécrivez pas le sujet : le modèle s’en charge à partir de la référence.
- Réglez votre format en fonction de l’usage prévu. 16:9 pour les contenus sociaux et web, 1:1 pour les profils et les photos de produits, 9:16 pour les formats verticaux.
- Lancez la génération et examinez le résultat. Ajustez votre prompt textuel pour affiner les éléments de la scène sans toucher à votre image de référence.
Pour les flux de travail multi-images, passez sur Flux Kontext Max et importez vos images de référence supplémentaires via l’option de saisie multi-images.
Astuces qui fonctionnent vraiment
Ces réglages font la différence entre des résultats moyens et des résultats professionnels :
- Utilisez des images de référence en haute résolution. 1024 x 1024 au minimum. Le modèle a besoin de détails pour travailler.
- Les portraits de face fonctionnent mieux pour la cohérence des personnages. Les profils donnent moins de repères au modèle.
- Soyez précis dans votre prompt textuel sur ce qui change. « À l’intérieur d’un chalet alpin en hiver, lueur chaude du feu, neige visible par la fenêtre » indique au modèle exactement ce qu’il doit construire autour du sujet préservé.
- Évitez de décrire l’apparence du sujet. Si votre référence montre une femme aux cheveux bruns, ne décrivez pas la couleur des cheveux dans votre prompt. Une description supplémentaire du sujet crée des instructions contradictoires.
- Pour le transfert de style, retirez de la référence les sujets précis. Utilisez une photo de paysage ou d’architecture ayant l’esthétique souhaitée, puis décrivez un nouveau sujet dans le prompt. Le modèle applique le style de la référence au contenu nouvellement généré.
- Commencez avec Flux Kontext Fast pour itérer sur vos prompts, puis passez à Pro ou Max lorsque la composition et la scène vous satisfont.
Les erreurs courantes qui nuisent aux résultats
Surcharger le prompt
Lorsque vous utilisez des images de référence, le rôle de votre prompt textuel change. Vous ne décrivez plus l’image entière. Vous décrivez ce qui est nouveau dans cette génération. Considérez le prompt comme des instructions pour l’environnement, l’ambiance et le contexte, et non pour le sujet.
Trop décrire le sujet crée des conflits de prompt : le modèle tente de satisfaire à la fois l’encodage de la référence et votre description textuelle, ce qui donne des résultats où aucune des deux ne l’emporte vraiment.
Prompt surchargé avec une référence : « Une belle femme aux cheveux bruns bouclés, yeux marron, peau mate, vêtue d’un blazer anthracite, dans une forêt au coucher du soleil avec une lumière dorée »
Prompt plus adapté avec la même référence : « Forêt au coucher du soleil, lumière dorée et chaude, brume basse au sol, oiseaux à l’arrière-plan »
Laissez la référence porter le sujet. Utilisez le prompt pour peindre le monde autour de lui.
Utiliser des images de référence de mauvaise qualité
Le modèle ne peut extraire que ce qui est présent. Une image de référence petite, compressée ou très filtrée donne moins de matière au processus de conditionnement, ce qui affaiblit la préservation de l’identité. Les références floues, à contre-jour ou prises sous des angles extrêmes rendent la cohérence plus difficile à maintenir d’une génération à l’autre.
Pour de meilleurs résultats : un éclairage net, un angle direct, une mise au point nette, une résolution minimale de 1024 px.
Ignorer les différences entre modèles
Utiliser Flux Kontext Max pour chaque tâche à référence unique fait perdre du temps de génération. Utilisez Flux Kontext Fast pour tester les prompts, Flux Kontext Pro pour la production à référence unique, et Max uniquement lorsque vous avez réellement besoin d’un conditionnement multi-images ou d’une fidélité maximale absolue. La différence de performance entre Fast et Pro sur une tâche à référence unique est souvent minime. Associer le bon modèle à la bonne tâche accélère votre flux de travail sans sacrifier la qualité du résultat.
Commencer à générer sur PicassoIA
La génération à partir d’une image de référence est l’une de ces capacités qui prennent tout leur sens une fois que vous la voyez fonctionner sur vos propres images. Les descriptions textuelles de ce que fait Kontext ne suffisent qu’à un certain point.
PicassoIA vous donne accès aux quatre modèles Kontext, Fast, Dev, Pro et Max, sans avoir à configurer une API, installer des dépendances ou utiliser du matériel local. Vous pouvez importer un portrait que vous possédez déjà et commencer à tester la cohérence d’un personnage en quelques minutes.
Si vous voulez une personnalisation plus poussée, Flux Kontext Dev LoRA vous permet d’effectuer un fine-tuning du modèle Dev de base sur votre propre jeu de données, ce qui constitue la voie vers une cohérence véritablement propriétaire pour les flux de travail commerciaux dont les résultats standard ne sont pas assez précis.
Le point de départ le plus simple : prenez un portrait net, rendez-vous sur Flux Kontext Pro sur PicassoIA et demandez une scène totalement différente. Voyez combien d’identité se transfère. Ce premier résultat fait généralement tout comprendre immédiatement, et à partir de là, les cas d’usage se multiplient rapidement.