A maioria dos geradores de imagem por IA ignora sua foto de referência assim que você clica em gerar. O Flux Kontext faz o oposto. Ele trata essa imagem de referência como uma âncora estrutural, extraindo identidade, estilo e composição diretamente da foto enviada e incorporando tudo ao resultado. O resultado é algo que apenas prompts de texto nunca conseguiram entregar: consistência visual real entre cenas, condições de iluminação e contextos diferentes.
O que é o Flux Kontext de fato
O Flux Kontext é uma família de modelos de geração de imagens por IA desenvolvida pela Black Forest Labs, a equipe por trás da arquitetura original do FLUX.1. Lançado em 2025, o Kontext foi criado especificamente para resolver um dos problemas mais difíceis da geração de imagens por IA: manter um sujeito, personagem ou estilo visual consistente entre várias imagens geradas.
Os modelos tradicionais de texto para imagem tratam cada geração como uma folha em branco. Você digita um prompt, o modelo alucina uma imagem, e o personagem ou objeto que apareceu na sua última saída não tem nenhuma influência sobre a próxima. O Kontext quebra esse padrão ao aceitar uma ou mais imagens de referência como entrada e condicionar o processo de geração ao que vê nessas imagens.
O problema para o qual ele foi criado
Quem já tentou construir um personagem consistente para uma história em quadrinhos, uma campanha de marca ou uma série nas redes sociais conhece a frustração. Você gera um retrato lindo na primeira tentativa e depois passa horas ajustando prompts para conseguir o mesmo rosto com outra roupa ou em outro cenário. O rosto muda. O cabelo muda. A identidade inteira se desfaz.
💡 O Kontext foi projetado exatamente para esse cenário. Envie sua imagem de referência uma vez, e ele leva essa identidade visual para cada nova geração, não importa o quanto a nova cena seja diferente.
Isso vale além dos personagens. Fotografia de produtos, renderizações arquitetônicas, ensaios de moda e qualquer fluxo criativo que exija consistência visual entre vários resultados se beneficiam diretamente do condicionamento por imagem de referência. O problema sempre foi que a linguagem é um veículo impreciso para descrever identidade visual. "Cabelo castanho, maçãs do rosto altas, olhos amendoados" é muito pouco específico se comparado a mostrar ao modelo uma fotografia.
Quem criou e quando
A Black Forest Labs lançou a família Kontext junto com a linha FLUX.1 já existente no início de 2025. Os modelos foram treinados com grandes conjuntos de dados de imagens pareadas, ensinando a arquitetura a extrair e preservar atributos visuais específicos das entradas de referência e, ao mesmo tempo, responder de forma flexível às instruções do prompt de texto. Esse condicionamento duplo, texto mais imagem, é o que separa o Kontext de ferramentas simples de imagem para imagem, que apenas misturam sua entrada com um novo prompt. O Kontext lê a referência. Ele não apenas a copia.
A mecânica por trás do Kontext é bem diferente da geração padrão de imagem para imagem. Entender a diferença ajuda você a usá-lo de forma mais intencional e a obter melhores resultados já na primeira geração.
Condicionamento por imagem versus prompts de texto
Em um modelo padrão de texto para imagem, seu prompt é a única instrução. O modelo interpreta as palavras e as associa aos conceitos visuais aprendidos durante o treinamento. No Kontext, sua imagem de referência se torna um segundo canal de instrução, rodando em paralelo com o prompt de texto.
O modelo codifica sua imagem de referência em uma representação latente, essencialmente comprimindo-a em um resumo matemático denso do que ela contém: geometria do rosto, paleta de cores, condições de iluminação, padrões de textura e qualidades estilísticas. Essa codificação é alimentada no processo de geração junto com os tokens do seu texto.
O efeito prático: quando você escreve "coloque este personagem em uma rua chuvosa de Tóquio à noite", o modelo já tem uma representação interna rica de quem é esse personagem. Ele não precisa adivinhar. Usa a codificação da referência para manter a identidade visual do personagem enquanto responde à descrição da nova cena.
O que o modelo vê quando você envia uma referência
O Kontext não faz um simples copiar e colar. Ele não extrai pixels da sua referência e os carimba na saída. Em vez disso, gera uma nova imagem que captura a essência do original enquanto responde a um novo contexto.
Essa distinção importa porque os resultados parecem coerentes, e não como montagens ruins. Veja o que muda e o que permanece fixo:
- A iluminação se adapta automaticamente ao novo contexto da cena
- A pose e a composição mudam conforme as instruções do seu prompt
- Os traços faciais e a identidade permanecem consistentes, mesmo com ângulos e expressões diferentes
- Roupas e acessórios podem ser trocados enquanto rosto e tipo de corpo se mantêm em todas as gerações
- Estilo e estética podem ser transferidos para sujeitos totalmente novos, se você quiser
O modelo lê significado da sua referência, não copia pixels. É por isso que os resultados podem mostrar o mesmo personagem rindo em um café e com expressão séria em uma floresta, mantendo a identidade em estados emocionais e ambientes completamente diferentes.
Por que o texto sozinho não garante consistência
Descrever um rosto em texto sempre perde informação. A linguagem natural simplesmente não tem vocabulário para capturar as proporções específicas, o tom exato dos olhos de alguém ou a maneira precisa como seus traços estão dispostos. "Maçãs do rosto altas" poderia descrever mil rostos diferentes. Uma fotografia de um rosto específico descreve exatamente um.
Esse é o cerne da geração com imagem de referência: a informação visual é mais densa que o texto. Uma única imagem de retrato contém mais informação de identidade do que um parágrafo de texto descritivo jamais poderia conter. O Kontext foi projetado para aproveitar essa densidade, usando-a como uma restrição precisa no processo de geração.
Entrada única versus múltiplas imagens
O Flux Kontext Max vai além ao aceitar várias imagens de referência simultaneamente. Isso abre fluxos de trabalho que antes simplesmente não eram possíveis:
- Envie duas fotos de retrato e peça ao modelo para combinar seus elementos visuais em um novo rosto
- Forneça a foto de um personagem e a foto de um cenário e peça uma composição consistente com a cena
- Envie três referências de roupa e gere um novo visual que misture elementos de design de cada uma
O condicionamento com múltiplas imagens é especialmente poderoso para diretores de criação, desenvolvedores de jogos e equipes de marca que precisam sintetizar referências de várias fontes em um único resultado consistente.
Flux Kontext Dev, Pro, Max ou Fast: qual escolher
A família Kontext inclui quatro modelos, cada um voltado a casos de uso diferentes e oferecendo contrapartidas distintas entre velocidade, qualidade e flexibilidade.
O Flux Kontext Fast deixa de lado parte do processamento extra ligado à qualidade para gerar com rapidez. Se você está testando prompts ou ajustando a composição, é por aqui que começa. A vantagem de velocidade é grande o bastante para que fazer cinco gerações Fast para explorar antes de optar por uma renderização Pro seja, de fato, o fluxo mais inteligente.
O Flux Kontext Dev é a versão de pesos abertos, o que significa que seus pesos estão disponíveis publicamente para pesquisa e experimentação. Ele produz resultados de alta qualidade com forte aderência à referência e é ideal para desenvolvedores que constroem sobre a arquitetura do Kontext. Se você quer personalizar o comportamento do Kontext por meio de fine-tuning, o Flux Kontext Dev LoRA permite treinar adaptadores leves sobre o modelo Dev base para obter consistência específica de um domínio.
O Flux Kontext Pro é o modelo de nível comercial. Ele oferece o melhor equilíbrio entre fidelidade à referência, qualidade do resultado e resposta ao prompt. Para a maioria dos fluxos profissionais, essa é a escolha certa.
O Flux Kontext Max é o carro-chefe, projetado para qualidade máxima e condicionamento com múltiplas imagens. Quando você precisa fundir duas ou mais referências ou quer a maior consistência absoluta possível, o Max é o modelo.
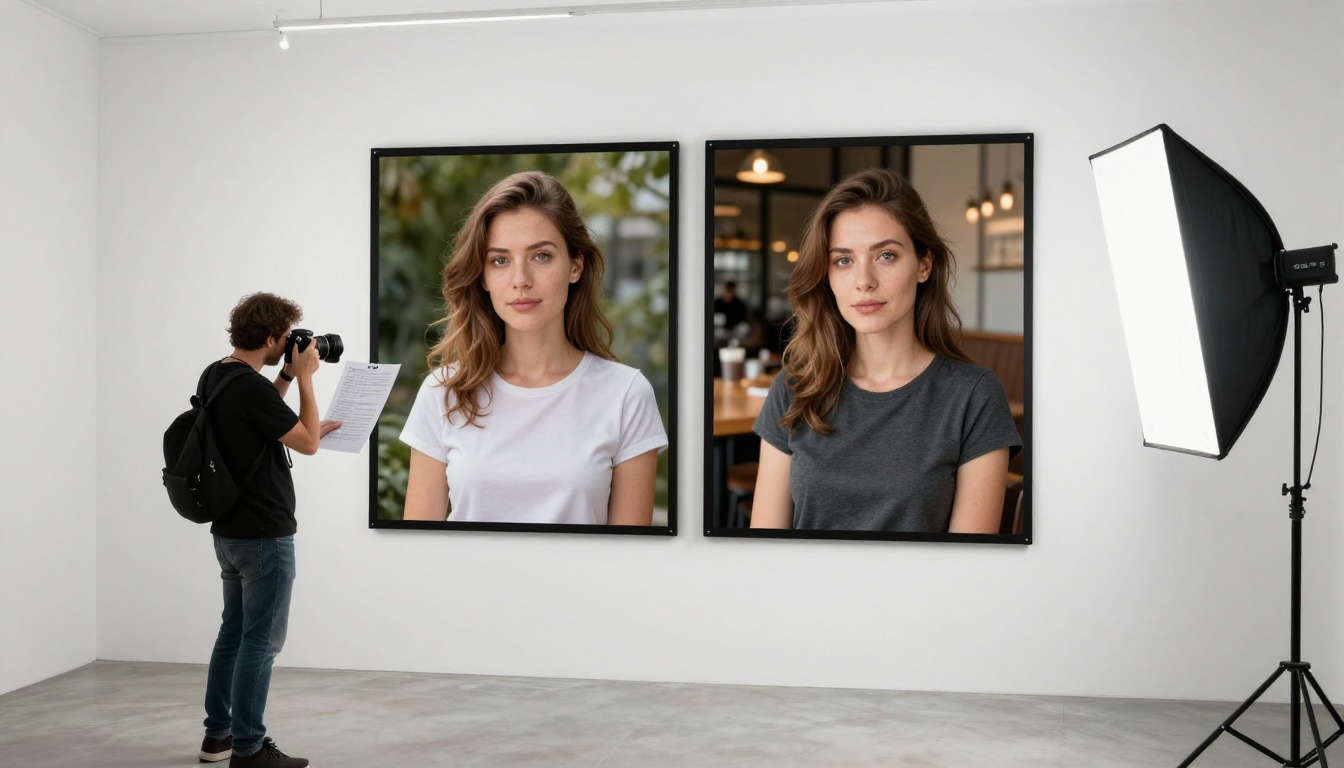
A gama de aplicações é mais ampla do que a maioria das pessoas imagina no início. Estas são as quatro categorias em que a geração com imagem de referência entrega o valor mais evidente.
Consistência de personagem entre cenas
Este é o caso de uso mais comum. Você tem um personagem, real ou imaginado, e precisa que ele apareça em vários cenários sem deixar de parecer ele mesmo. Com o Flux Kontext Pro, você envia um único retrato e pede cenas diferentes:
- O personagem em um cenário de montanha no inverno
- O mesmo personagem em um café italiano banhado de sol
- O mesmo personagem em um beco urbano escuro à noite
Nos três resultados, o rosto, a estrutura óssea, a cor do cabelo e a identidade geral permanecem fixos. Apenas o ambiente e a iluminação se adaptam.
Transferência de estilo sem perder a identidade
O Kontext pode pegar a assinatura estilística de uma imagem de referência e aplicá-la a um novo conteúdo. Se você enviar uma foto com uma gradação de cor específica, um visual de filme ou uma abordagem de composição própria, o modelo pode gerar novas imagens que compartilham essa estética, mas com conteúdo totalmente original.
Isso é especialmente valioso para fotógrafos de marca que já estabeleceram uma linguagem visual e querem gerar conteúdo adicional que combine com o portfólio existente, sem refazer as sessões de fotos.
💡 Para transferência de estilo, use sua referência principalmente por suas qualidades estéticas e descreva o novo conteúdo por completo no prompt de texto. O modelo aplicará a gramática visual da sua referência à cena recém-descrita.
Fotos de objetos e produtos
Fotógrafos de produto podem enviar uma foto de referência do produto e pedir novos fundos, cenografias ou contextos de estilo de vida. O produto continua fotorrealista e consistente, enquanto o ambiente muda por completo. Não é preciso refazer a sessão em um local.
Uma foto única de estúdio de um frasco de perfume vira o frasco sobre uma bancada de mármore de banheiro ao amanhecer, depois em uma clareira de floresta com névoa da manhã, depois em uma bandeja de hotel de luxo com flores frescas. Tudo a partir de uma única imagem de referência.
Séries de retratos e geração para campanhas
O Flux Kontext Max torna a geração de séries de retratos simples. Envie um retrato de busto e um painel de inspiração com as estéticas desejadas, depois gere uma série inteira de retratos com a identidade do sujeito consistente em diferentes looks estilizados. Para campanhas publicitárias, conteúdo de marca ou séries editoriais em que fazer várias sessões de fotos é caro demais, esse fluxo representa uma mudança significativa no que é possível alcançar.
Como usar o Flux Kontext no PicassoIA
Os quatro modelos Kontext estão disponíveis diretamente no PicassoIA, prontos para uso sem nenhuma configuração local ou de API.
Passo a passo com o Flux Kontext Pro
- Acesse o Flux Kontext Pro no PicassoIA
- Envie sua imagem de referência usando o campo de entrada de imagem. Use a foto mais nítida e de maior resolução que você tiver. Evite imagens com filtros pesados ou muito comprimidas.
- Escreva seu prompt descrevendo a nova cena ou contexto. Seja específico sobre iluminação, ambiente, clima e detalhes de estilo. Não descreva novamente o sujeito, o modelo cuida disso a partir da referência.
- Defina sua proporção de acordo com o uso pretendido. 16:9 para conteúdo de redes sociais e web, 1:1 para perfis e fotos de produto, 9:16 para formatos verticais.
- Execute a geração e revise o resultado. Ajuste seu prompt de texto para refinar elementos da cena sem mexer na imagem de referência.
Para fluxos com múltiplas imagens, mude para o Flux Kontext Max e envie as imagens de referência adicionais usando a opção de entrada de múltiplas imagens.
Dicas que realmente funcionam
Estes ajustes separam resultados medíocres de resultados profissionais:
- Use imagens de referência em alta resolução. No mínimo 1024x1024. O modelo precisa de detalhes para trabalhar.
- Retratos de frente funcionam melhor para consistência de personagem. Fotos de perfil dão ao modelo menos pontos de apoio.
- Seja específico no prompt sobre o que muda. "Interior de uma cabana alpina de inverno, luz quente de lareira, neve visível pela janela" diz ao modelo exatamente o que construir em torno do sujeito preservado.
- Evite descrever a aparência do sujeito no prompt. Se sua referência mostra uma mulher de cabelo escuro, não descreva a cor do cabelo no prompt. Descrição extra do sujeito cria instruções conflitantes.
- Para transferência de estilo, tire da referência os sujeitos específicos. Use uma foto de paisagem ou de arquitetura com a estética desejada e depois descreva um novo sujeito no prompt. O modelo aplica o estilo da referência ao conteúdo recém-gerado.
- Comece com o Flux Kontext Fast para iterar o prompt e depois mude para Pro ou Max quando estiver satisfeito com a composição e a cena.
Erros comuns que prejudicam os resultados
Sobrecarregar o prompt
Ao usar imagens de referência, a função do prompt de texto muda. Você não está mais descrevendo a imagem inteira. Está descrevendo o que é novo nesta geração. Trate o prompt como instruções para o ambiente, o clima e o contexto, não para o sujeito.
Descrever demais o sujeito cria conflitos de prompt, em que o modelo tenta atender ao mesmo tempo à codificação da referência e à sua descrição textual, produzindo resultados em que nenhuma das duas se impõe por completo.
Prompt sobrecarregado com referência: "Uma mulher linda de cabelo escuro e cacheado, olhos castanhos, pele oliva, usando um blazer cinza-carvão, em uma floresta ao pôr do sol com luz dourada"
Prompt melhor com a mesma referência: "Floresta ao pôr do sol, luz dourada e quente, neblina baixa no chão, pássaros ao fundo"
Deixe a referência carregar o sujeito. Use o prompt para pintar o mundo ao redor dele.
Usar imagens de referência de baixa qualidade
O modelo só consegue extrair o que está ali. Uma referência pequena, comprimida ou com filtros pesados dá ao processo de condicionamento menos material para trabalhar, resultando em preservação de identidade mais fraca. Referências borradas, com contraluz ou fotografadas em ângulos extremos dificultam manter a consistência entre gerações.
Para melhores resultados: iluminação limpa, ângulo direto, foco nítido, resolução mínima de 1024 px.
Ignorar as diferenças entre os modelos
Recorrer ao Flux Kontext Max para toda tarefa com uma única referência desperdiça tempo de geração. Use o Flux Kontext Fast para testar prompts, o Flux Kontext Pro para produção com uma única referência e o Max apenas quando você realmente precisar de condicionamento com múltiplas imagens ou da máxima fidelidade absoluta. A diferença de desempenho entre Fast e Pro em uma tarefa com uma única referência costuma ser mínima. Escolher o modelo certo para cada tarefa torna seu fluxo mais rápido sem sacrificar a qualidade do resultado.
Comece a gerar no PicassoIA
A geração com imagem de referência é uma dessas capacidades que faz muito mais sentido quando você a vê funcionando com as suas próprias imagens. Descrições em texto do que o Kontext faz só chegam até certo ponto.
O PicassoIA dá acesso aos quatro modelos Kontext, Fast, Dev, Pro e Max, sem precisar configurar uma API, instalar dependências ou usar hardware local. Você pode enviar uma foto de retrato que já tem e começar a testar a consistência de personagem em minutos.
Se você quer uma personalização mais profunda, o Flux Kontext Dev LoRA permite fazer fine-tuning do modelo Dev base com o seu próprio conjunto de dados, que é o caminho para uma consistência verdadeiramente proprietária em fluxos comerciais em que os resultados prontos não são precisos o bastante.
O ponto de partida mais simples: pegue uma foto de retrato nítida, vá até o Flux Kontext Pro no PicassoIA e peça uma cena completamente diferente. Veja quanta identidade é transferida. Esse primeiro resultado geralmente faz o conceito inteiro ficar claro de imediato, e a partir daí os casos de uso se multiplicam rápido.