Si alguna vez has intentado crear un video con sincronización labial y la herramienta que pagaste te ha marcado, difuminado o bloqueado directamente, ya conoces el problema. La mayoría de las plataformas gratuitas de lipsync prometen libertad, pero entregan una lista de temas prohibidos, marcas de agua obligatorias y filtros de contenido que rechazan cualquier cosa mínimamente sugerente. La buena noticia es que las cosas han cambiado rápido. Hay una nueva generación de modelos de lipsync con IA disponible ahora mismo, gratis o casi gratis, sin muros de contenido ocultos, y todos son accesibles en un solo lugar.
Por qué las herramientas de sincronización labial siguen bloqueándote
La censura en las herramientas de video con IA no es aleatoria. Procede de tres lugares: las restricciones de entrenamiento del propio modelo, la capa de moderación que la plataforma añade encima y las condiciones del proveedor de la API, que están debajo de todo. Cuando chocas contra un muro, rara vez sabes qué capa te está bloqueando.
El resultado es que los creadores que hacen contenido perfectamente legal, como videos de fitness en bikini, comedia para adultos, narrativa sugerente o incluso simplemente un rostro con un escote, son bloqueados constantemente. Algunas plataformas te marcan por el audio, no por el video. Otras, por la imagen. Y otras pasan ambos por un clasificador antes incluso de empezar la generación.
Lo que realmente necesitas es una plataforma donde los modelos funcionen sin una capa de contenido paranoica añadida encima. Eso es exactamente lo que ofrece PicassoIA, con más de una docena de modelos de lipsync dedicados disponibles en picassoia.com/en/all-models.
Los mejores modelos de lipsync gratis en este momento
No son opciones teóricas. Cada modelo que aparece a continuación está activo, probado y accesible a través de la colección de lipsync de PicassoIA, sin necesidad de suscripción para empezar.
Sync React 1: precisión a nivel de fotograma con la máxima velocidad
React 1 de Sync está pensado para ser rápido sin sacrificar precisión. Analiza el audio entrante fotograma a fotograma y remodela la boca del sujeto casi en tiempo real. El resultado resulta natural porque no se limita a superponer una forma de boca: ajusta como un conjunto la tensión de la mandíbula, las comisuras de los labios y el movimiento del mentón.
Ideal para: clips cortos en los que el tiempo de entrega importa, contenido para redes sociales y videos de reacción.
💡 React 1 maneja especialmente bien el habla rápida. Si tu audio incluye diálogos acelerados o palabras superpuestas, este modelo se defiende mejor que la mayoría de las alternativas.
Kling Lip Sync: realismo cinematográfico
Kling Lip Sync de Kwaivgi ofrece una calidad de nivel cinematográfico al lipsync gratuito con IA. Construido sobre la misma base que el conjunto más amplio de generación de video de Kling, maneja matices emocionales sutiles del habla, como la leve compresión al final de una respiración o la forma en que los labios se separan antes de una vocal, de modo que el resultado parece genuinamente humano.
Ideal para: videos de retrato, contenido de influencers y videos de persona hablando a cámara en los que el realismo es innegociable.
Lipsync 2 Pro: sincronización de nivel profesional
Lipsync 2 Pro de Sync es la versión mejorada del modelo Lipsync 2 estándar, con un mejor tratamiento de los acentos, el audio susurrado y las posiciones del rostro fuera de eje. Donde el modelo base flaquea cuando el sujeto no mira de frente, Lipsync 2 Pro compensa con una pasada de geometría facial en 3D.
También combina bien con Lipsync 2 como opción más ligera si quieres una ejecución más rápida en clips sencillos.
Ideal para: contenido de alta producción, ensayos en video y entrevistas dobladas en las que la persona se mueve con naturalidad.
Omni Human 1.5: de foto a video hablado
Omni Human 1.5 de ByteDance va más allá del lipsync estándar. Dale una sola foto fija y una pista de audio, y genera un video hablado completo con movimiento corporal sincronizado, giros naturales de cabeza y parpadeo. No es solo movimiento de boca sobre una imagen estática: crea desde cero un retrato animado que habla.
Su predecesor Omni Human también está disponible si prefieres una versión algo más ligera.
Ideal para: crear videos de avatares parlantes a partir de fotografías, portavoces virtuales y contenido en el que solo tienes una imagen de origen.
Pixverse Lipsync: ediciones creativas rápidas
Pixverse Lipsync es el punto de entrada más accesible de la colección. Sube un clip de video, adjunta una pista de audio y obtén el resultado sincronizado en minutos. Prioriza la facilidad de uso y maneja con regularidad una gran variedad de tipos de rostro, tonos de piel e iluminaciones.
Ideal para: usuarios que empiezan, creación de contenido en lote y prototipado rápido de flujos de trabajo de lip sync gratis con IA.
Avatares parlantes frente a lipsync puro: cuál es la diferencia
Estas dos categorías se confunden a menudo, pero sirven para flujos de trabajo totalmente distintos.
El lipsync puro toma un clip de video existente y remodela la boca para que coincida con un audio nuevo. El cuerpo, el fondo y el ángulo de cámara se mantienen exactamente como en el material original. Lo que haces es corregir o reemplazar lo que dice el sujeto.
Las herramientas de avatar parlante toman una imagen de origen (a veces solo una foto de rostro) y generan un video hablado desde cero. El resultado es un video nuevo, no uno modificado.
| Característica | Lipsync puro | Avatar parlante |
|---|
| Material necesario | Clip de video | Imagen fija o video |
| Movimiento corporal | Sin cambios respecto al original | Generado desde cero |
| Fondo | Se conserva | Se conserva o se genera |
| Ideal para | Doblaje, cambio de voz | Crear contenido nuevo |
| Velocidad | Rápida | Moderada |
P Video Avatar: crea un personaje parlante
P Video Avatar de PrunaAI es el modelo de avatar parlante propio de PicassoIA. Dale una imagen de retrato, proporciona una grabación de voz o la salida de texto a voz, y construirá un video hablado de ese personaje con movimiento natural. La calidad del resultado es lo bastante alta para publicar en redes sociales sin posproducción.
Fabric 1.0: haz que las fotos cobren vida
Fabric 1.0 de Veed se especializa en animar fotografías fijas hasta convertirlas en clips hablados. Admite una gama de estilos de imagen más amplia que la mayoría de las herramientas de avatar, incluidas ilustraciones, retratos generados con IA y fuentes no fotográficas. Si quieres animar un personaje a partir de una imagen que creaste con un modelo de texto a imagen, Fabric 1.0 es la opción adecuada.
Cómo usar Omni Human 1.5 en PicassoIA
Omni Human 1.5 es el modelo estrella para generar videos hablados completos a partir de fotos, y PicassoIA simplifica el flujo de trabajo.
Paso 1: prepara tu imagen de origen
Usa un retrato de frente o de tres cuartos, con rasgos faciales nítidos y buena iluminación. Si primero generas la imagen con las herramientas de texto a imagen de PicassoIA, un recorte de 512x512 o 1024x1024 funciona bien.
Paso 2: prepara tu audio
Exporta tu audio como archivo WAV o MP3 limpio. Omni Human 1.5 lee directamente la temporización de los fonemas, así que cuanto más limpio sea el audio, más precisos serán los movimientos de los labios. Si usas voz generada con IA, las herramientas de texto a voz de PicassoIA producen un resultado compatible directamente.
Paso 3: abre el modelo
Ve a Omni Human 1.5 en PicassoIA. Sube tu imagen en el campo de imagen y tu archivo de audio en el campo de audio.
Paso 4: configura los parámetros
- Resolución: elige 720p o superior para obtener un resultado con calidad de publicación.
- Intensidad de movimiento: los valores más altos crean un movimiento de cabeza más expresivo. Para contenido de persona hablando a cámara, un ajuste medio resulta lo más natural.
- Duración: el modelo ajusta automáticamente la duración a la longitud de tu pista de audio.
Paso 5: genera y revisa
Ejecuta el modelo y revisa el resultado. Fíjate en el movimiento de las comisuras de los labios en la primera y la última sílaba. Son los fotogramas que más suelen mostrar artefactos. Si ves alguno, una segunda ejecución con una intensidad de movimiento ligeramente distinta suele corregirlo.
💡 Omni Human 1.5 también admite movimiento de la parte superior del cuerpo, no solo del rostro. En clips más largos, esto evita el aspecto antinatural de hombros rígidos que es habitual en herramientas de avatar parlante más económicas.
Doblar videos en varios idiomas
El doblaje multilingüe es uno de los usos más prácticos de las herramientas de lipsync con IA, y uno que las plataformas convencionales gestionan mal. El doblaje de video estándar cambia la pista de audio, pero deja el movimiento labial original, lo que crea una discordancia evidente. El lipsync con IA corrige esto regenerando el movimiento de los labios para que coincida con los patrones fonéticos del nuevo idioma.
Video Translate: 150 idiomas
Video Translate de HeyGen gestiona el doblaje en más de 150 idiomas con resincronización labial automática. Sube un video de origen, selecciona el idioma de destino y la herramienta transcribe, traduce, genera una voz doblada y remodela la boca en un solo proceso.
En qué se diferencia del doblaje simple: tiene en cuenta las diferencias de temporización de fonemas entre idiomas. Las vocales del español, por ejemplo, tienen posiciones de boca distintas a las del inglés, y Video Translate lo ajusta en lugar de pegar una animación genérica de boca sobre el audio traducido.
Lipsync Precision frente a Lipsync Speed
HeyGen ofrece dos modelos de sincronización independientes para los casos en los que ya tienes el audio traducido y solo necesitas recolocar los labios.
Lipsync Precision prioriza la exactitud, con varias pasadas para alinear los detalles fonéticos finos. Tarda más, pero el resultado es más ajustado, sobre todo en idiomas con grupos de consonantes complejos.
Lipsync Speed sacrifica algo de precisión a cambio de rendimiento. Si produces contenido de gran volumen y la sincronización no necesita ser perfecta fotograma a fotograma, Speed reduce mucho el tiempo de generación.
| Modelo | Ideal para | Velocidad de generación |
|---|
| Lipsync Precision | Entrevistas, contenido formal | Más lenta |
| Lipsync Speed | Redes sociales, producción en lote | Rápida |
| Video Translate | Flujo completo de doblaje | Moderada |
Combinar el lipsync con la generación de video con IA
El lipsync no tiene por qué ser el último paso de tu flujo de trabajo. Puede ser el paso intermedio.
Genera primero tu video base con un modelo de texto a video y luego pasa ese resultado a una herramienta de lipsync para añadir una voz. Esto resulta especialmente útil en contenidos en los que quieres un control creativo total del aspecto visual antes de comprometerte con el diálogo.
Algunos modelos que merece la pena combinar con el lipsync:
- Seedance 2.5 genera video de alto movimiento en 1080p con sincronización de audio nativa, que puedes reemplazar con diálogo personalizado usando un modelo de lipsync.
- Kling v2.6 produce video cinematográfico de texto a video en 1080p. Usa su resultado como base para el lipsync cuando quieras un personaje parlante totalmente generado con IA.
- P Video crea videos tanto a partir de prompts de texto como de imágenes, lo que te da un clip de origen listo para cualquiera de los modelos de lipsync mencionados.
El flujo de trabajo es así:
- Genera el elemento visual con un modelo de texto a video o de imagen a video.
- Graba o genera la pista de voz con una herramienta de texto a voz.
- Sincroniza el audio con el video usando un modelo de lipsync.
- Publica el resultado final directamente desde PicassoIA.
Esta canalización de tres pasos sustituye lo que antes requería suscripciones independientes a tres plataformas distintas.
💡 Para contenido de avatar parlante con una apariencia de personaje concreta, genera primero la imagen del personaje con un modelo de texto a imagen y luego pásala por Omni Human 1.5 o Fabric 1.0 con tu audio. Mantienes el control creativo total sobre el aspecto del personaje, mientras el lipsync se encarga de la animación.
Qué significa realmente "gratis" aquí
La palabra "gratis" en las herramientas de IA suele ser engañosa. Algunas plataformas anuncian niveles gratuitos que quedan tras muros de inicio de sesión, otras te dan tres generaciones antes de pedir una tarjeta de crédito y otras ponen marcas de agua en todo hasta que pagas.
En PicassoIA, varios modelos de lipsync funcionan de forma genuinamente gratuita, sin marcas de agua ni límites de generación. Los modelos que sí requieren créditos se cobran por generación en lugar de por suscripción, lo que significa que solo pagas cuando generas algo.
La distinción clave es acceso gratuito ilimitado frente a limitado:
- Modelos gratuitos ilimitados incluyen Pixverse Lipsync y Lipsync Speed para trabajos que necesitan entrega rápida.
- Modelos basados en créditos, como Lipsync 2 Pro y Omni Human 1.5, ofrecen mayor calidad con un costo por generación que aun así resulta más conveniente que la mayoría de los servicios por suscripción.
No hay muros de pago por filtros de contenido. No pagas más por acceder a modelos que manejan contenido para adultos o sugerente.
4 errores que arruinan la calidad del lipsync
La mayoría de los fallos de lipsync vienen de la entrada, no del modelo. Esto es lo que conviene corregir antes de abrir la herramienta:
1. Mala calidad de audio
El audio comprimido, el ruido de fondo o la saturación confunden la detección de fonemas. Usa siempre una grabación limpia a 44,1 kHz o superior. Si tu audio tiene ruido, pásalo primero por una reducción de ruido.
2. Boca oculta en el material de origen
Una mano, un micrófono o el pelo que tapa parcialmente la boca en la imagen o el video de origen obliga al modelo a adivinar qué hay debajo. Suele adivinar mal. Mantén la zona de la boca completamente visible.
3. Ángulos extremos de la cabeza
La mayoría de los modelos de lipsync se entrenan sobre todo con rostros de frente y de tres cuartos leves. Los perfiles o los ángulos muy picados producen resultados claramente peores. Mantente dentro de unos 45 grados respecto al centro.
4. Idioma del audio y datos de entrenamiento del rostro no coincidentes
Algunos modelos funcionan significativamente mejor con determinados idiomas. Si doblas a un idioma con un corpus de entrenamiento pequeño, prueba con otro modelo. Video Translate maneja mejor los idiomas distintos del inglés que un modelo de lipsync genérico que solo recibe audio traducido.
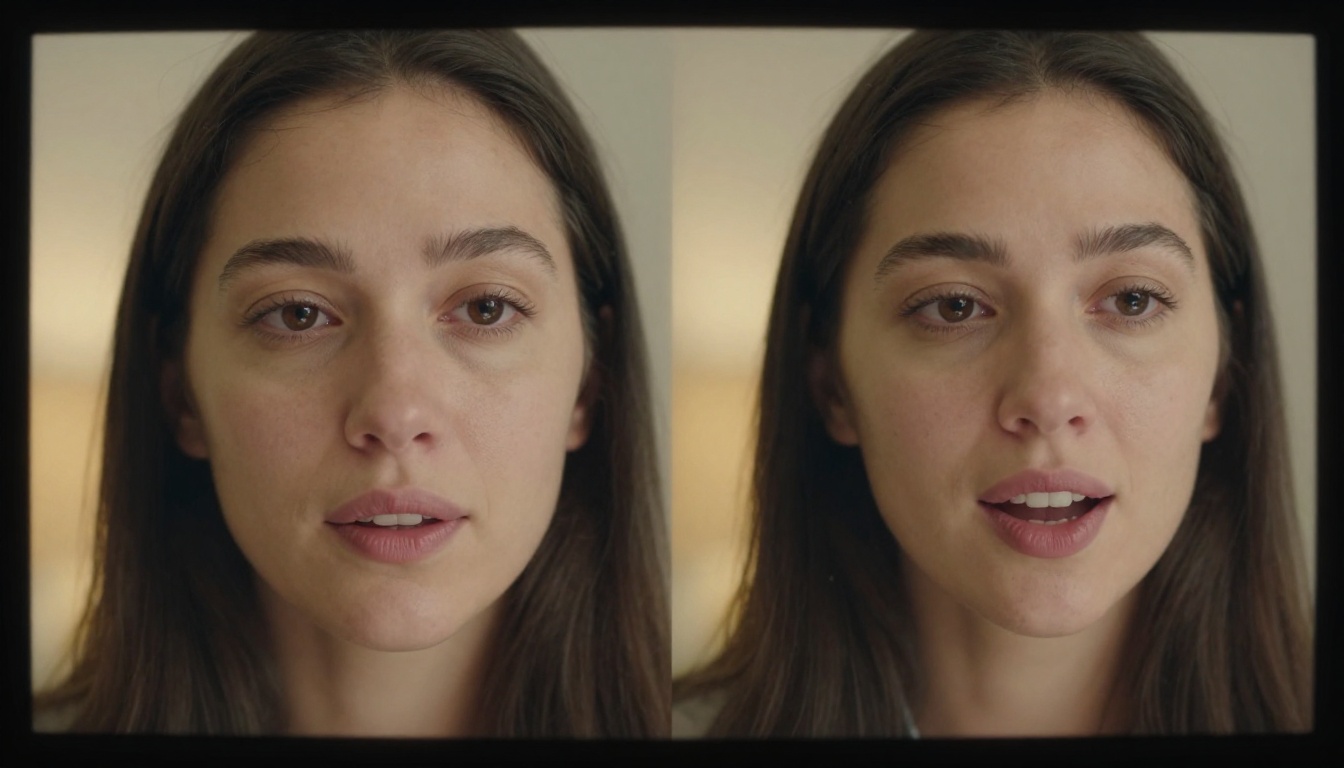
Lipsync e intercambio de rostros: una combinación poderosa
El lipsync controla lo que dice la boca. El intercambio de rostros controla quién parece decirlo. Juntos te dan un control total sobre un personaje que habla en video, sin necesidad de que esa persona esté delante de la cámara.
Las herramientas de intercambio de rostros de PicassoIA te permiten reemplazar el rostro de cualquier video o imagen por un rostro de referencia de una foto. Pasa el resultado por un modelo de lipsync con tu pista de audio y tendrás un video con voz completa y un rostro personalizado en tres pasos.
Esto resulta especialmente útil para:
- Proteger la privacidad en contenido de testimonios o entrevistas.
- Crear portavoces con una apariencia coherente y controlada.
- Producir varias versiones en distintos idiomas del mismo video con un presentador adaptado a cada idioma.
La combinación de herramientas de doblaje con IA gratuitas, modelos de avatar parlante y animación facial abre un flujo de producción que hace solo dos años habría requerido un equipo de producción completo. Ahora funciona en el navegador.
Empieza a crear con PicassoIA ahora
Todos los modelos de este artículo están disponibles ahora mismo en picassoia.com/en/all-models. No necesitas suscripción para empezar. Abre la colección de lipsync, elige el modelo que mejor se adapte a tu caso de uso entre los de este desglose y lanza tu primera generación.
Ahí está el conjunto completo de herramientas de lipsync: sincronización de precisión para doblaje profesional, animación de avatares a partir de fotos, herramientas de flujo multilingüe y opciones de alta velocidad para producción en lote. Combínalas con las bibliotecas de texto a video y de texto a imagen de PicassoIA y tendrás un flujo de producción de video completo, no solo una herramienta suelta.
Si tienes una pista de voz y un rostro, lo demás ya está resuelto. Elige tu modelo, sube tus archivos y descubre cómo resulta el lipsync con IA sin restricciones.


