Si vous avez déjà essayé de créer une vidéo synchronisée sur les lèvres pour la voir signalée, floutée ou carrément bloquée par l’outil que vous payiez, vous connaissez déjà le problème. La plupart des plateformes gratuites de synchronisation labiale promettent la liberté mais livrent une liste de sujets interdits, des filigranes obligatoires et des filtres de contenu qui rejettent tout ce qui est tant soit peu suggestif. La bonne nouvelle est que les choses ont vite changé. Une nouvelle génération de modèles de synchronisation labiale par IA est disponible dès maintenant, gratuits ou presque, sans murs de contenu cachés, et ils sont tous accessibles au même endroit.
Pourquoi les outils de synchronisation labiale vous bloquent-ils sans cesse ?
Le problème de censure dans les outils de vidéo IA n’est pas aléatoire. Il vient de trois endroits : les restrictions d’entraînement propres au modèle, la couche de modération que la plateforme ajoute par-dessus, et les conditions du fournisseur d’API qui se trouvent sous le tout. Quand vous vous heurtez à un mur, vous ne savez que rarement quelle couche vous bloque.
Le résultat : les créateurs qui réalisent des contenus parfaitement légaux, comme des vidéos fitness en bikini, de la comédie pour adultes, des récits suggestifs, ou simplement un visage dans une tenue décolletée, se font bloquer en permanence. Certaines plateformes vous signalent l’audio, pas la vidéo. D’autres signalent l’image. D’autres encore passent les deux dans un classifieur avant même de lancer la génération.
Ce qu’il vous faut vraiment, c’est une plateforme où les modèles tournent sans couche de contrôle paranoïaque ajoutée par-dessus. C’est exactement ce que propose PicassoIA, avec plus d’une douzaine de modèles de synchronisation labiale dédiés, disponibles sur picassoia.com/en/all-models.
Les meilleurs modèles gratuits de synchronisation labiale aujourd’hui
Ce ne sont pas des options théoriques. Chaque modèle ci-dessous est en ligne, testé et accessible via la collection de synchronisation labiale de PicassoIA, sans abonnement obligatoire pour commencer.
Sync React 1 : la précision image par image la plus rapide
React 1 by Sync est conçu pour la vitesse sans sacrifier la précision. Il analyse l’audio entrant image par image et remodèle la bouche du sujet en quasi temps réel. Le rendu paraît naturel parce qu’il ne se contente pas de superposer une forme de bouche : il ajuste ensemble la tension de la mâchoire, les commissures des lèvres et le mouvement du menton.
Idéal pour : Les clips courts où le délai de livraison compte, les contenus pour les réseaux sociaux, les vidéos de réaction.
💡 React 1 gère particulièrement bien la parole rapide. Si votre audio contient des dialogues rapides ou des mots qui se chevauchent, ce modèle suit mieux que la plupart des alternatives.
Kling Lip Sync : le réalisme cinématographique
Kling Lip Sync by Kwaivgi apporte une qualité de niveau cinéma à la synchronisation labiale gratuite par IA. Construit sur les mêmes fondations que la suite plus large de génération de vidéos de Kling, il gère les indices émotionnels subtils de la parole, comme la légère compression en fin de souffle ou la façon dont les lèvres s’entrouvrent avant une voyelle, de sorte que le résultat paraisse vraiment humain.
Idéal pour : Les vidéos en portrait, les contenus d’influenceurs, les vidéos face caméra où le réalisme n’est pas négociable.
Lipsync 2 Pro : une synchronisation de niveau professionnel
Lipsync 2 Pro by Sync est la version améliorée du modèle Lipsync 2 standard, avec une meilleure gestion des accents, des audios chuchotés et des positions de visage hors axe. Là où le modèle de base peine lorsqu’un sujet n’est pas parfaitement de face, Lipsync 2 Pro compense grâce à une passe de géométrie faciale en 3D.
Il se marie aussi bien avec Lipsync 2, une option plus légère si vous voulez un traitement plus rapide sur des clips simples.
Idéal pour : Les contenus de haute production, les essais vidéo, les interviews doublées où l’intervenant bouge naturellement.
Omni Human 1.5 : de la photo à la vidéo parlante
Omni Human 1.5 by ByteDance va plus loin que la synchronisation labiale classique. Donnez-lui une photo fixe unique et une piste audio, et il génère une vidéo parlante complète, avec mouvement corporel synchronisé, mouvements naturels de la tête et clignements des yeux. Il ne s’agit pas seulement de mouvements de bouche sur une image statique : il crée un portrait parlant entièrement animé à partir de rien.
Son prédécesseur Omni Human est également disponible si vous préférez une version un peu plus légère.
Idéal pour : Créer des vidéos d’avatars parlants à partir de photos, des porte-parole virtuels, les contenus pour lesquels vous ne disposez que d’une image source.
Pixverse Lipsync : des modifications créatives rapides
Pixverse Lipsync est le point d’entrée le plus accessible de la collection. Importez un clip vidéo, joignez une piste audio, et obtenez une sortie synchronisée en quelques minutes. Il privilégie la facilité d’utilisation et gère de façon constante une grande variété de types de visages, de teints et de conditions d’éclairage.
Idéal pour : Les utilisateurs qui débutent, la création de contenus en série, le prototypage rapide de flux de travail de synchronisation labiale gratuite par IA.
Avatars parlants ou synchronisation labiale pure : quelle différence ?
Ces deux catégories sont souvent confondues, mais elles servent des flux de travail entièrement différents.
La synchronisation labiale pure prend un clip vidéo existant et remodèle la bouche pour correspondre à un nouvel audio. Le corps, l’arrière-plan et l’angle de caméra restent exactement tels qu’ils sont dans la séquence source. Vous corrigez ou remplacez ce que dit le sujet.
Un avatar parlant prend une image source (parfois seulement une photo de visage) et génère une vidéo parlante à partir de rien. Le résultat est une nouvelle vidéo, et non une vidéo modifiée.
| Caractéristique | Synchronisation labiale pure | Avatar parlant |
|---|
| Source requise | Clip vidéo | Image fixe ou vidéo |
| Mouvement du corps | Inchangé par rapport à la source | Généré de toutes pièces |
| Arrière-plan | Conservé | Conservé ou généré |
| Idéal pour | Doublage, nouvelle voix | Création de nouveaux contenus |
| Vitesse | Rapide | Modérée |
P Video Avatar : créer un personnage parlant
P Video Avatar by PrunaAI est le modèle d’avatar parlant propre à PicassoIA. Donnez-lui un portrait, fournissez un enregistrement vocal ou une sortie de synthèse vocale, et il construit une vidéo parlante de ce personnage avec des mouvements naturels. La qualité du résultat est suffisante pour une publication sur les réseaux sociaux sans post-traitement.
Fabric 1.0 : donner vie aux photos
Fabric 1.0 by Veed se spécialise dans l’animation de photos fixes en clips parlants. Il gère une gamme de styles d’image plus large que la plupart des outils d’avatar, y compris les illustrations, les portraits générés par IA et les sources non photographiques. Si vous voulez animer un personnage à partir d’une image créée avec un modèle de texte vers image, Fabric 1.0 est le bon choix.
Omni Human 1.5 est le modèle phare pour générer des vidéos parlantes complètes à partir de photos, et PicassoIA simplifie le flux de travail.
Étape 1 : préparez votre image source
Utilisez un portrait de face ou aux trois quarts, avec des traits du visage nets et un bon éclairage. Si vous générez d’abord l’image avec les outils de texte vers image de PicassoIA, un recadrage en 512x512 ou 1024x1024 fonctionne bien.
Étape 2 : préparez votre audio
Exportez votre audio en fichier WAV ou MP3 propre. Omni Human 1.5 lit directement le calage temporel des phonèmes, donc plus l’audio est propre, plus le mouvement des lèvres est précis. Si vous utilisez une parole générée par IA, les outils de synthèse vocale de PicassoIA produisent directement une sortie compatible.
Étape 3 : ouvrez le modèle
Rendez-vous sur Omni Human 1.5 sur PicassoIA. Importez votre image dans le champ image et votre fichier audio dans le champ audio.
Étape 4 : réglez les paramètres
- Résolution : choisissez 720p ou plus pour une qualité de publication.
- Intensité du mouvement : des valeurs élevées créent des mouvements de tête plus expressifs. Pour les contenus face caméra, un réglage moyen paraît le plus naturel.
- Durée : le modèle s’aligne automatiquement sur la longueur de votre piste audio.
Étape 5 : générez et vérifiez
Lancez le modèle et examinez le résultat. Faites attention au mouvement des commissures des lèvres sur la première et la dernière syllabe. Ce sont les images qui présentent le plus souvent des artefacts. Si vous en voyez, une deuxième exécution avec une intensité de mouvement légèrement différente les corrige généralement.
💡 Omni Human 1.5 gère aussi le mouvement du haut du corps, pas seulement celui du visage. Pour les clips plus longs, cela évite l’effet d’épaules figées et peu naturelles fréquent dans les outils d’avatars parlants moins chers.
Doublage de vidéos en plusieurs langues
Le doublage multilingue est l’un des usages les plus pratiques des outils de synchronisation labiale par IA, et l’un de ceux que les plateformes grand public gèrent mal. Le doublage vidéo classique modifie la piste audio mais laisse le mouvement des lèvres d’origine, ce qui crée un décalage évident. La synchronisation labiale par IA règle ce problème en régénérant le mouvement des lèvres pour correspondre aux schémas phonétiques de la nouvelle langue.
Video Translate : plus de 150 langues
Video Translate by HeyGen gère le doublage dans plus de 150 langues avec une resynchronisation labiale automatique. Importez une vidéo source, sélectionnez la langue cible, et l’outil transcrit, traduit, génère une voix doublée et remodèle la bouche en un seul pipeline.
Ce qui le distingue d’un simple doublage : il tient compte des différences de durée des phonèmes entre les langues. Les voyelles espagnoles, par exemple, ont des positions de bouche différentes de celles de l’anglais, et Video Translate s’y adapte au lieu de simplement plaquer une animation de bouche générique sur l’audio traduit.
Lipsync Precision ou Lipsync Speed
HeyGen propose deux modèles de synchronisation autonomes, pour les cas où vous disposez déjà de l’audio traduit et n’avez besoin que du remodelage des lèvres.
Lipsync Precision privilégie la précision, en effectuant plusieurs passes pour aligner les détails phonétiques fins. Il prend plus de temps, mais le résultat est plus serré, notamment pour les langues aux groupes de consonnes complexes.
Lipsync Speed sacrifie un peu de précision au profit du débit. Si vous produisez des contenus en grand volume et que la synchronisation n’a pas besoin d’être parfaite image par image, Speed réduit nettement le temps de génération.
| Modèle | Idéal pour | Vitesse de génération |
|---|
| Lipsync Precision | Interviews, contenus formels | Plus lent |
| Lipsync Speed | Réseaux sociaux, production en volume | Rapide |
| Video Translate | Pipeline complet de doublage | Modérée |
Associer la synchronisation labiale à la génération de vidéos IA
La synchronisation labiale n’a pas à être la dernière étape de votre flux de travail. Elle peut être l’étape intermédiaire.
Générez d’abord votre vidéo de base avec un modèle de texte vers vidéo, puis injectez ce résultat dans un outil de synchronisation labiale pour ajouter une voix. C’est particulièrement utile pour les contenus où vous voulez un contrôle créatif total sur l’aspect visuel avant de vous engager sur les dialogues.
Quelques modèles à associer à la synchronisation labiale :
- Seedance 2.5 génère une vidéo 1080p à mouvement intense avec une synchronisation audio native, que vous pouvez ensuite remplacer par des dialogues personnalisés grâce à un modèle de synchronisation labiale.
- Kling v2.6 produit du texte vers vidéo cinématographique en 1080p. Utilisez sa sortie comme base pour la synchronisation labiale lorsque vous voulez un personnage parlant entièrement généré par IA.
- P Video crée des vidéos à partir de prompts textuels et d’images, ce qui vous fournit un clip source prêt à l’emploi pour n’importe lequel des modèles de synchronisation labiale ci-dessus.
Le flux de travail ressemble à ceci :
- Générez le visuel avec un modèle de texte vers vidéo ou d’image vers vidéo.
- Enregistrez ou générez la piste vocale avec un outil de synthèse vocale.
- Synchronisez l’audio sur la vidéo avec un modèle de synchronisation labiale.
- Publiez le résultat final directement depuis PicassoIA.
Ce pipeline en trois étapes remplace ce qui exigeait autrefois des abonnements distincts à trois plateformes différentes.
💡 Pour un contenu d’avatar parlant avec une apparence de personnage spécifique, générez d’abord l’image de votre personnage avec un modèle de texte vers image, puis passez-la dans Omni Human 1.5 ou Fabric 1.0 avec votre audio. Vous gardez un contrôle créatif total sur l’apparence du personnage, tandis que la synchronisation labiale gère l’animation.
Ce que « gratuit » veut vraiment dire ici
Le mot « gratuit » dans les outils d’IA est souvent trompeur. Certaines plateformes annoncent des offres gratuites derrière des murs de connexion, d’autres vous accordent trois générations avant de demander une carte bancaire, et d’autres encore apposent un filigrane sur tout jusqu’à ce que vous payiez.
Sur PicassoIA, plusieurs modèles de synchronisation labiale fonctionnent sur une base réellement gratuite, sans filigrane ni plafond de génération. Les modèles qui demandent des crédits sont facturés à la génération plutôt qu’à l’abonnement, ce qui signifie que vous ne payez que lorsque vous générez effectivement quelque chose.
La distinction clé est celle entre accès gratuit illimité et accès gratuit limité :
- Les modèles gratuits illimités incluent Pixverse Lipsync et Lipsync Speed pour les travaux à livraison rapide.
- Les modèles à crédits comme Lipsync 2 Pro et Omni Human 1.5 offrent une qualité supérieure à un coût par génération qui reste inférieur à celui de la plupart des services d’abonnement.
Il n’existe aucun mur payant lié aux filtres de contenu. Vous ne payez pas plus pour accéder aux modèles qui gèrent les contenus pour adultes ou suggestifs.
4 erreurs qui ruinent la qualité de la synchronisation labiale
La plupart des échecs de synchronisation labiale viennent des données d’entrée, pas du modèle. Voici ce qu’il faut corriger avant même d’ouvrir l’outil :
1. Mauvaise qualité audio
Un audio compressé, du bruit de fond ou un écrêtage perturbe la détection des phonèmes. Utilisez toujours un enregistrement propre à 44,1 kHz ou plus. Si votre audio contient du bruit, passez-le d’abord dans une étape de réduction de bruit.
2. Bouche masquée dans la source
Une main, un micro ou des cheveux qui cachent en partie la bouche dans l’image ou la vidéo source obligent le modèle à deviner ce qui se trouve dessous. Il devine généralement mal. Gardez la zone de la bouche entièrement visible.
3. Angles de tête extrêmes
La plupart des modèles de synchronisation labiale sont entraînés principalement sur des visages de face et légèrement aux trois quarts. Les photos de profil ou les angles fortement plongeants donnent des résultats nettement moins bons. Restez dans un angle d’environ 45 degrés par rapport au centre.
4. Langue audio et données d’entraînement du visage mal adaptées
Certains modèles fonctionnent nettement mieux avec certaines langues. Si vous doublez dans une langue disposant d’un petit corpus d’entraînement, essayez un autre modèle. Video Translate gère mieux les langues autres que l’anglais qu’un modèle de synchronisation labiale générique auquel on ne fournit que l’audio traduit.
Synchronisation labiale et échange de visage : une combinaison puissante
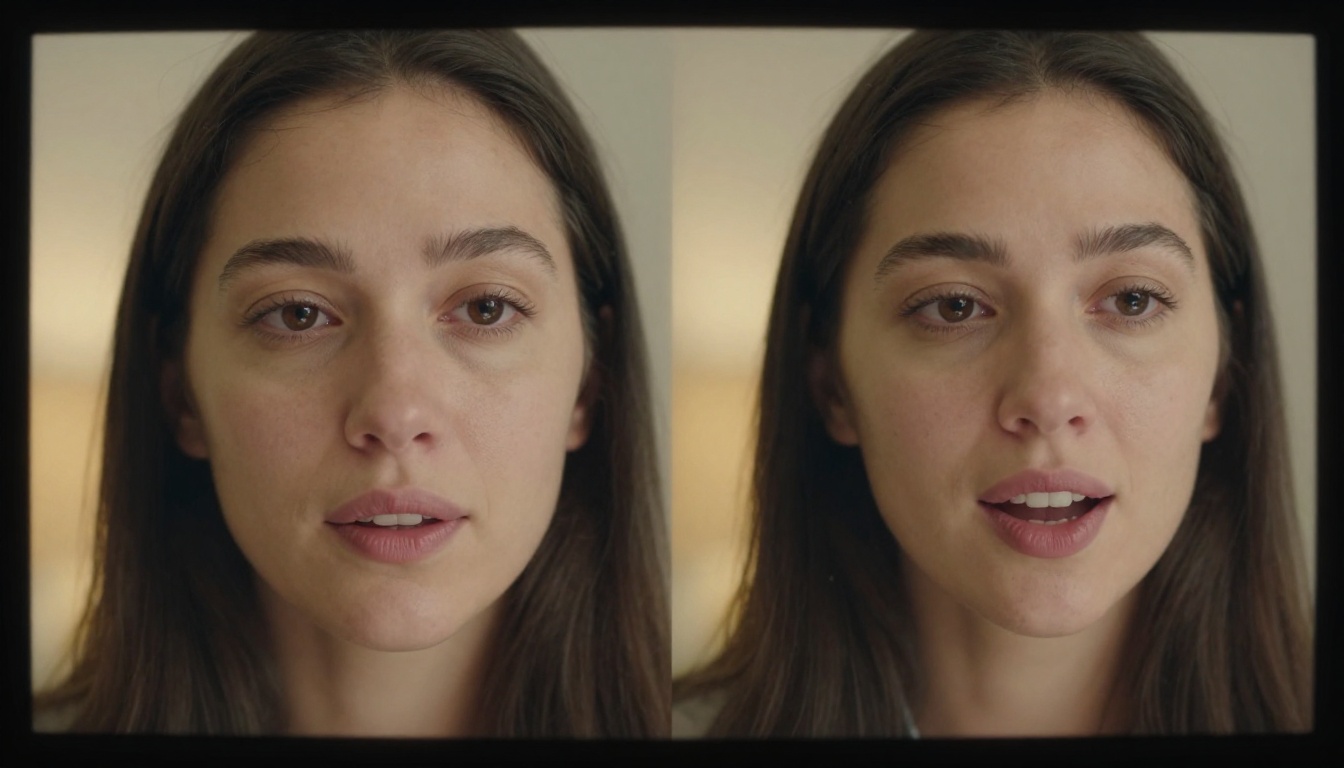
La synchronisation labiale contrôle ce que dit la bouche. L’échange de visage contrôle qui semble le dire. Ensemble, ils vous donnent un contrôle total sur un personnage parlant dans une vidéo, sans jamais avoir besoin de cette personne devant la caméra.
Les outils d’échange de visage de PicassoIA vous permettent de remplacer le visage dans n’importe quelle vidéo ou image par un visage de référence issu d’une photo. Passez le résultat dans un modèle de synchronisation labiale avec votre piste audio, et vous obtenez une vidéo entièrement doublée, avec un visage personnalisé, en seulement trois étapes.
C’est particulièrement utile pour :
- Protéger la vie privée dans les témoignages ou les contenus d’interview.
- Créer des porte-parole à l’apparence cohérente et maîtrisée.
- Produire plusieurs versions linguistiques de la même vidéo avec un présentateur adapté à chaque langue.
La combinaison d’outils de doublage IA gratuits, de modèles d’avatars parlants et d’animation de visages ouvre un flux de production qui aurait exigé une équipe de production complète il y a seulement deux ans. Aujourd’hui, tout se fait dans un navigateur.
Commencez à créer avec PicassoIA dès maintenant
Chaque modèle de cet article est disponible dès maintenant sur picassoia.com/en/all-models. Vous n’avez pas besoin d’abonnement pour commencer. Ouvrez la collection de synchronisation labiale, choisissez le modèle qui correspond à votre cas d’usage dans la présentation ci-dessus, et lancez votre première génération.
Toute la boîte à outils de synchronisation labiale est là : synchronisation de précision pour le doublage professionnel, animation d’avatars à partir de photos, outils de pipeline multilingue et options haute vitesse pour la production en volume. Associez-les aux bibliothèques de texte vers vidéo et de texte vers image de PicassoIA, et vous disposez d’un pipeline complet de production vidéo, et non d’un simple outil isolé.
Si vous avez une piste vocale et un visage, le reste est déjà pris en charge. Choisissez votre modèle, importez vos fichiers, et voyez ce que donne vraiment la synchronisation labiale par IA sans restriction.


