Los avatares parlantes exigían antes un estudio de producción, un actor real y un equipo de posproducción. Ahora puedes tomar una foto generada con IA, darle un clip de voz y tener un avatar parlante convincente en menos de dos minutos. La barrera se derrumbó rápido. Lo que más sorprende a la gente es cuántas de estas herramientas son completamente gratuitas o están disponibles con planes gratuitos, y la diferencia de calidad entre lo gratis y lo de pago se ha reducido mucho en 2027. Este artículo repasa el flujo de trabajo exacto, los modelos gratuitos más potentes y los errores que conviene evitar antes de perder tiempo con una entrada mala.
Por qué los avatares parlantes están en todas partes ahora
El auge del contenido con avatares parlantes no es casualidad. Tres cosas coincidieron a la vez: los generadores de imágenes con IA ya producen retratos humanos creíbles, los modelos de texto a voz empezaron a sonar genuinamente humanos y la sincronización labial con IA aprendió a relacionar el audio con el movimiento facial con una precisión de fotograma. Juntos, estos tres avances hacen posible crear un video de cabeza parlante completo a partir de una sola foto y un guion de texto, totalmente gratis y desde el navegador.
Los casos de uso reales
Los casos de uso reales son más amplios de lo que la mayoría espera:
- Contenido para redes sociales donde una persona virtual coherente narra los videos sin mostrar un rostro real
- Aprendizaje en línea donde un instructor avatar imparte el material del curso en cualquier idioma
- Videos de marketing que necesitan un portavoz sin tener que contratar a uno
- Doblaje multilingüe donde un avatar basado en una foto habla con una pista doblada y movimiento labial acorde
- Marca personal para creadores que quieren una versión de IA estilizada de sí mismos frente a la cámara
- Videos explicativos para startups que necesitan resultados de video profesionales con un presupuesto de cero dólares
💡 El caso de uso más práctico ahora mismo: combinar un retrato de IA de alta calidad con una voz clonada o sintética para producir videos explicativos en cualquier idioma, sin costo. El resultado es indistinguible de un clip de portavoz grabado profesionalmente a la distancia habitual de visionado.
Qué hace que uno resulte convincente
Tres factores separan a un avatar parlante convincente de una falsificación evidente:
- Calidad de audio: El audio comprimido con artefactos rompe la ilusión de inmediato. La voz tiene que sonar genuinamente humana, no sintetizada.
- Precisión del contorno labial: La forma de la boca tiene que coincidir con el fonema, no solo aproximarse a él. Las formas de boca difuminadas o genéricas se perciben como incorrectas incluso para quienes no saben explicar por qué.
- Micromovimientos de ojos y cabeza: Los ojos completamente congelados resultan antinaturales. Los modelos que añaden parpadeos sutiles y ligeros balanceos de cabeza reducen enseguida el valle inquietante.
Las mejores herramientas gratuitas disponibles en 2027 manejan bien los tres factores. La pregunta es cuáles conviene usar primero.
Paso 1: crea la voz
Antes de que pueda ocurrir cualquier sincronización labial, necesitas audio. La calidad de ese audio determina el techo del resultado final. Una voz turbia o robótica producirá un avatar turbio y robótico, sin importar lo bueno que sea el modelo de sincronización labial. Este paso es donde la mayoría de los principiantes dedican menos tiempo, y se nota en el resultado.
Modelos TTS gratuitos que de verdad suenan humanos
PicassoIA alberga varios modelos de texto a voz que producen audio lo bastante convincente para alimentar un flujo de sincronización labial. Estos son los que merecen la pena para avatares parlantes:
ElevenLabs v3 es el benchmark actual en síntesis de voz expresiva. Maneja bien la gama emocional, las variaciones de ritmo y las pausas naturales mejor que cualquier competidor de su nivel. Si el guion tiene algo de peso emocional, aquí conviene empezar. El modelo también respeta la puntuación como lo haría un hablante humano, con pausas naturales en las comas y algo más largas en los puntos, en lugar de una entrega plana y monótona.
MiniMax Speech 2.8 HD ofrece resultados con calidad de estudio y una síntesis más rápida que el tiempo real. La textura de la voz es densa y cálida, no la calidad fina y ligeramente hueca que delata a los modelos más baratos. Maneja guiones largos sin la deriva que a veces se nota hacia el minuto dos, cuando el ritmo de las frases empieza a aplanarse. Para contenido corporativo o didáctico, es la opción que suena más profesional sin costo.
Resemble AI Chatterbox es la mejor opción si quieres control de emoción con clonación de voz. Puedes aportar un clip de referencia de cualquier voz y Chatterbox la clonará conservando la inflexión emocional. Es útil para crear un avatar parlante que suene como una persona concreta, una voz de marca o incluso un personaje ficticio con una personalidad vocal definida. El control deslizante de emoción es una función que la mayoría de los modelos gratuitos de la competencia no ofrece.
Qwen3 TTS es la carta comodín. En lugar de clonar voces existentes, puede diseñar voces completamente nuevas a partir de una descripción en texto, y maneja bien las cadencias no estándar. Va bien para personajes de ficción o avatares que necesitan una firma vocal distintiva y algo inusual que ningún humano real tenga.
ElevenLabs Flash v2.5 es la opción optimizada para velocidad cuando necesitas iterar rápido. Si pruebas varios guiones o ajustas la entrega, el tiempo de render más corto te permite probar opciones sin esperar.
| Modelo | Ideal para | Clonación de voz | Idiomas |
|---|
| ElevenLabs v3 | Narración expresiva | Sí | 30+ |
| MiniMax Speech 2.8 HD | Guiones largos de calidad de estudio | No | Multi |
| Chatterbox | Clonación con control de emoción | Sí | Principalmente inglés |
| Qwen3 TTS | Diseño de voces nuevas | Sí | Multi |
| ElevenLabs Flash v2.5 | Iteración rápida y pruebas | Sí | 32 |
El formato de salida importa: la mayoría de los modelos de sincronización labial esperan un archivo WAV o MP3 limpio, con poco ruido de fondo. Genera primero el audio, escúchalo y recorta el silencio del principio y del final antes de subirlo al paso de sincronización. El silencio al inicio del archivo hace que los modelos de sincronización labial empiecen con una boca cerrada y estática que parece un fallo de carga.
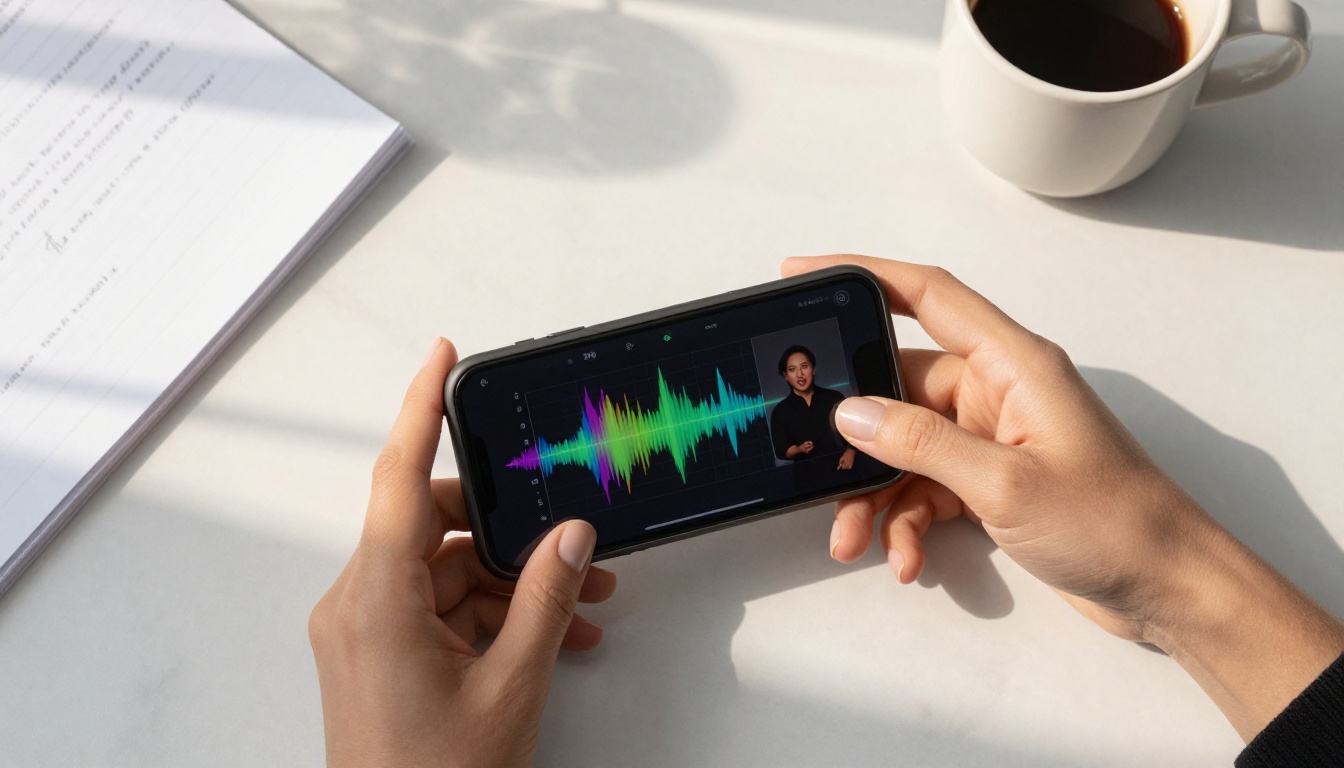
Paso 2: sincroniza la voz con un rostro
La sincronización labial con IA recibe dos entradas: un rostro (una imagen fija o un clip de video corto) y un archivo de audio. Genera un video de ese rostro hablando en sincronía con el audio. El reto técnico es hacer coincidir la forma de la boca en cada fotograma con el fonema correspondiente de la pista de audio, con la regularidad suficiente para que el resultado parezca habla humana natural.
Qué hace de verdad la sincronización labial con IA
Los modelos modernos de sincronización labial usan redes de correspondencia audiovisual entrenadas con miles de horas de grabaciones de cabezas parlantes. Predicen la forma exacta de la boca, la posición de la mandíbula y la visibilidad de los dientes para cada fotograma de audio, y después lo integran en el rostro original conservando los rasgos faciales circundantes y las condiciones de iluminación.
Los mejores modelos también gestionan:
- Oclusiones (pelo o manos que tapan parcialmente la boca en la imagen original)
- Coherencia de iluminación (para que la zona animada de la boca coincida en color y brillo con el resto del rostro)
- Movimiento de la cabeza (asentimientos y giros sutiles que se sincronizan con el ritmo del habla en lugar de quedarse robóticamente quietos)
- Parpadeo (inserción automática de parpadeos para evitar el efecto de ojos muertos que enseguida se percibe como artificial)
Los mejores modelos gratuitos de sincronización labial en PicassoIA
PicassoIA alberga 12 modelos de sincronización labial en su plataforma. No todos sirven para fotos de IA como entrada, porque algunos están diseñados para doblaje de video y no para animar retratos fijos. Los que aparecen a continuación son los de mejor rendimiento específicamente para convertir un retrato fijo de IA en un avatar parlante.
Omni Human 1.5
Omni Human 1.5 de ByteDance es ahora mismo el de mejor rendimiento en esta categoría. Acepta una sola foto de retrato y cualquier clip de audio, y produce un video con sincronización labial precisa, movimiento natural de la cabeza y microexpresiones que hacen que el resultado parezca genuinamente vivo. El modelo se diseñó específicamente para animar fotos realistas, no solo para doblaje de video, y esa es la distinción clave.
Lo que lo diferencia de los modelos anteriores es que no produce el efecto de animación solo en la boca, en el que todo lo que no son los labios permanece congelado. Todo el rostro participa en el habla. El movimiento de las cejas, la tensión de la mandíbula y la actividad sutil de las mejillas responden al audio de una forma que los modelos previos simplemente no lograban.
Su predecesor, Omni Human, sigue valiendo la pena para clips más cortos en los que un movimiento algo más estilizado encaja mejor con la estética.
P Video Avatar
P Video Avatar de PrunaAI está optimizado para la velocidad sin sacrificar demasiada calidad. Es la opción práctica cuando necesitas producir varios clips de avatar en una sola sesión en lugar de renderizar un video perfecto. La precisión de sincronización labial es buena en retratos de frente, que es exactamente el resultado que dan la mayoría de los generadores de imágenes con IA.
Fabric 1.0
Fabric 1.0 de VEED aborda el reto de hacer hablar a las fotos con especial atención a los dientes y a la zona interior de la boca. Muchos modelos de sincronización labial producen una mancha oscura y borrosa donde deberían estar los dientes. Fabric 1.0 genera una geometría dental real basada en el fonema del audio, lo que se nota en tomas de primer plano en las que la boca ocupa una parte grande del encuadre.
Kling Lip Sync
Kling Lip Sync de KwaiVGI es la mejor opción para audio que no está en inglés. Si la voz que generaste en el Paso 1 está en un idioma con combinaciones de fonemas poco habituales, Kling gestiona la geometría de la boca con más precisión que los modelos entrenados sobre todo con inglés. También funciona bien con inglés con acento, donde los patrones de acentuación difieren del habla estándar estadounidense o británica.
React 1 y Lipsync 2 Pro
React 1 de Sync está diseñado específicamente para añadir sincronización labial realista a contenido de video existente, pero también funciona igual de bien con fotos fijas animadas. Es el modelo más preciso para agrupaciones densas de consonantes y habla muy rápida.
Lipsync 2 Pro de Sync es el nivel de refinamiento sobre Lipsync 2, con mayor precisión en los bordes del contorno labial, lo que reduce el artefacto de fantasmas que a veces aparece en el borde de la boca con sonidos oclusivos.
💡 Para el mejor resultado posible con un retrato de IA de frente, el flujo de trabajo es: generar el audio con ElevenLabs v3 y después introducirlo en Omni Human 1.5. Esta combinación supera siempre a cualquier otra pareja gratuita en movimiento natural y precisión labial.
Modelos de video para avatares parlantes que merecen una prueba
Más allá de la categoría dedicada a la sincronización labial, PicassoIA alberga varios modelos de generación de video creados específicamente para crear avatares. Funcionan de otra manera: en lugar de sincronizar audio con una foto fija, generan un video completo de cabeza parlante a partir de una sola imagen de entrada y un prompt de texto o un clip de audio, con el movimiento integrado en el propio proceso de generación y no aplicado como posprocesado.
HeyGen Avatar V y Avatar IV
HeyGen Avatar V está pensado exclusivamente para generar video de avatares parlantes. Aportas una foto y un guion, y produce un video pulido de esa persona hablando. El resultado se parece siempre a contenido de portavoz profesional y no a una sincronización labial en bruto, con contacto visual natural, balanceo de cabeza controlado y una composición limpia de la boca.
HeyGen Avatar IV es la generación anterior, pero gestiona mejor ciertas condiciones de iluminación, sobre todo la iluminación de alto contraste o dramática en la foto de origen, donde el modelo más nuevo a veces suaviza en exceso.
Kling Avatar v2
Kling Avatar v2 de KwaiVGI anima cualquier rostro en un video con una fidelidad de movimiento notable. Es especialmente bueno para conservar la identidad visual exacta de un rostro generado con IA, algo que puede ser un reto con modelos que aplican su propio sesgo estético durante la generación y alteran sutilmente el aspecto del personaje entre fotogramas.
Dreamactor M2.0
Dreamactor M2.0 de ByteDance lleva la animación de personajes más allá al admitir personajes no estándar, incluidos rostros estilizados o parcialmente idealizados. Si la foto de IA de la que partes tiene rasgos exagerados o acentuados, Dreamactor gestiona la animación con más delicadeza que los modelos de sincronización labial estándar, entrenados sobre todo con fotografía naturalista.
Cómo usar Omni Human 1.5 en PicassoIA
Como Omni Human 1.5 es la herramienta gratuita más potente para esta tarea concreta, este es el flujo de trabajo exacto desde un retrato de IA sin procesar hasta un video final de avatar parlante.
Prepara la imagen de origen
La foto de origen necesita un rostro claramente visible, con los ojos abiertos y la boca en una posición neutra o ligeramente abierta. Los perfiles y los ángulos extremos producen resultados más débiles. La entrada ideal es un retrato de frente o de tres cuartos, con iluminación uniforme y sin filtros de belleza intensos.
Si no tienes una, genera un retrato con cualquier modelo de imagen de PicassoIA y luego recorta de cerca el rostro antes de subirlo a Omni Human 1.5. Cuanto más ajustado sea el recorte, más precisa tiende a ser la geometría de la sincronización labial, porque el modelo no tiene que resolver detalles espaciales finos en un encuadre amplio.
Genera el audio
Ve a ElevenLabs v3 en PicassoIA. Escribe el guion que quieres que diga el avatar. Elige una voz que coincida con el carácter de tu retrato. Descarga el MP3 generado.
Escucha el resultado completo antes de seguir. Revisa lo siguiente:
- Pausas poco naturales en los signos de puntuación que crean un ritmo irregular
- Cualquier artefacto robótico en consonantes duras como la T, la K o la P
- Silencio al principio o al final (recórtalo antes de subir el archivo)
Un archivo de audio limpio marca una diferencia medible en la calidad de la sincronización labial.
Ejecuta la sincronización labial
Abre Omni Human 1.5 en PicassoIA:
- Sube la foto del retrato como entrada del rostro de origen
- Sube el archivo de audio como audio de guía
- Fija la resolución en 720p para lograr un buen equilibrio entre calidad y velocidad de render
- Envía el trabajo
El tiempo de render suele ser de 30 a 90 segundos, según la duración del audio. El resultado es un archivo MP4 con el rostro completamente animado para coincidir con el audio, incluido el movimiento de la cabeza.
Ajusta si hace falta
Si el primer resultado tiene fotogramas borrosos o fonemas desajustados en palabras concretas:
- Vuelve a recortar el audio para eliminar el segmento problemático y repite el proceso
- Prueba Lipsync 2 Pro de Sync como segunda pasada sobre el clip exportado
- Ajusta el ritmo en el paso de texto a voz para que las sílabas acentuadas caigan con más claridad en los tiempos naturales del habla
Gratis frente a pago: qué obtienes realmente
Una pregunta frecuente es si las herramientas gratuitas son de verdad utilizables o si el nivel gratuito es solo una muestra que te empuja a una suscripción. La respuesta honesta en 2025: el nivel gratuito de la mayoría de estos modelos produce resultados publicables. Los niveles de pago añaden:
| Función | Nivel gratuito | Nivel de pago |
|---|
| Resolución | Hasta 720p normalmente | 1080p+ |
| Duración del clip | De 15 a 30 segundos | 2+ minutos |
| Trabajos simultáneos | 1 a la vez | Varios |
| Marca de agua | A veces presente | Eliminada |
| Prioridad en la cola | Estándar | Más rápida |
| Clonación de voz personalizada | Generaciones limitadas | Acceso completo |
Para la mayoría de los casos de uso, 720p y clips de 30 segundos son perfectamente adecuados. Un clip para redes sociales, un reel de demostración breve o un video explicativo de producto no necesitan más que eso. Un video de curso completo o una serie con portavoz profesional es donde el nivel de pago empieza a tener sentido económico.
💡 Construye primero el flujo de trabajo con herramientas gratuitas. Comprueba que el resultado cumple tus estándares y luego decide si pasar a un plan de pago se justifica para el volumen que necesitas. La mayoría de las personas que empiezan directamente con pago descubren que, de todos modos, tenían que corregir algo en su flujo de trabajo de entrada.
4 errores que arruinan el resultado
Incluso con las herramientas adecuadas, ciertas decisiones de entrada producen de forma constante malos resultados. Estos son los más habituales:
1. Usar una foto de origen muy filtrada o retocada. Los filtros de piel suave y los retoques de belleza crean superficies que se ven mal cuando el modelo de sincronización labial genera el movimiento de la boca. La composición se rompe en el borde de la zona animada. La textura natural de la piel se integra mucho mejor.
2. Ruido de fondo en el audio. El zumbido ambiental, el ruido del aire acondicionado o la reverberación en la salida de texto a voz se oirán en el video final y también pueden desajustar la detección de fonemas. Regenera el audio en una pasada limpia o aplica un paso de reducción de ruido antes de subirlo.
3. Duración no coincidente. Si el audio dura 60 segundos pero el video de origen dura 10, el modelo tiene que repetir el origen, lo que crea costuras visibles y repeticiones que resultan artificiales. Ajusta la duración del origen a la del audio antes de enviarlo, o usa una foto fija como origen para que no haya restricción de duración.
4. Retratos de perfil. Los modelos de sincronización labial necesitan ver ambos lados de la boca para generar una geometría de fonemas precisa. Los perfiles producen un movimiento de boca asimétrico o difuminado. Las vistas de frente o de tres cuartos dan sistemáticamente mejores resultados en todos los modelos probados.
Crea tu primer avatar parlante en PicassoIA
Todo lo que se describe en este artículo está disponible ahora mismo en PicassoIA, sin necesidad de cuenta para empezar a experimentar. La plataforma aloja todos los modelos mencionados en un solo lugar: Omni Human 1.5, ElevenLabs v3, HeyGen Avatar V, Kling Avatar v2, Fabric 1.0 y MiniMax Speech 2.8 HD.
La forma más rápida de empezar: toma cualquier retrato de IA que ya tengas, escribe un guion de dos frases, genera la voz con MiniMax Speech 2.8 HD y sube ambos archivos a Omni Human 1.5. Todo el proceso dura unos cinco minutos. El resultado te dirá enseguida si la calidad cumple lo que necesitas, sin más inversión que tiempo.
Si quieres comparar modelos lado a lado, explora las categorías completas de sincronización labial y de texto a voz en picassoia.com/en/all-models y ejecuta la misma entrada en tres modelos distintos. Las diferencias de calidad entre Omni Human 1.5, Fabric 1.0 y Kling Lip Sync son reales, pero también dependen del contexto. La herramienta adecuada varía según el tipo de retrato, el idioma del audio y la resolución de salida objetivo.
La barrera para un avatar parlante pulido ya no es tu presupuesto, sino tu guion.


